Limite 1B a résolu 27 problèmes de concours de maths sur 30 avec une seule RTX 4090, tant qu'on ne lui demande que des maths
Le modèle de maths de 2,1 GB de Paradigma a résolu 27 des 30 problèmes de l'AIME 2026 en un essai chacun sur une RTX 4090, et tourne sur une carte de 16 GB.
Le fichier pèse 2,1 GB. L'examen, c'est l'AIME 2026, le concours américain sur invitation réservé aux meilleurs lycéens. Nous avons donné les 30 problèmes à Limite 1B Violetto, le nouveau modèle de maths de Paradigma, sur une seule RTX 4090 de notre cloud, un essai par problème. Il en a résolu 27. Une vraie carte de station de travail de 16 GB l'a aussi fait tourner. Si vous déployez des modèles, cela veut dire que des maths de niveau concours n'exigent plus une grosse carte : en lançant les 30 problèmes d'un coup, le lot a coûté environ 22 centimes d'euro de temps GPU. Le modèle est sous Apache 2.0, vous pouvez donc le mettre dans un produit. La contrepartie est tout aussi nette : il fait des maths et rien que des maths, une question par conversation, et il réfléchit longtemps avant chaque réponse. Si vous avez une pile de problèmes avec une seule réponse finale chacun, il vaut la peine d'être essayé.
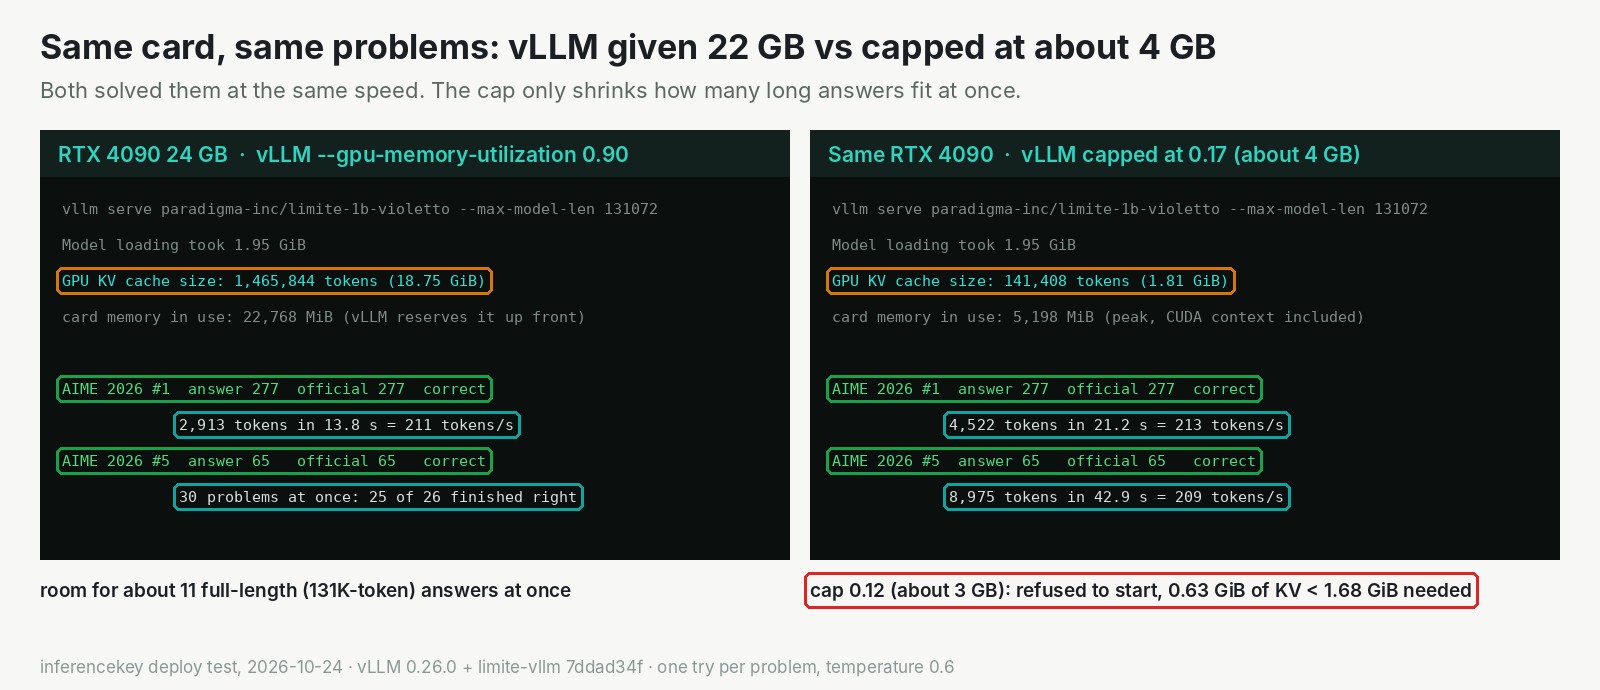
Même carte, mêmes problèmes. Un plafond de mémoire plus bas n'a ralenti aucune réponse ; il réduit seulement le nombre de longues réponses qui tiennent en même temps.
Un petit modèle avec un seul métier
Limite 1B Violetto est le premier modèle de Paradigma. Il a environ un milliard de paramètres, les nombres qu'un modèle apprend pendant l'entraînement, et l'équipe l'a entraîné de zéro en six semaines environ. Dans le propre tableau de Paradigma, il obtient 94,01 % à l'AIME 2026. Son argument phare porte sur une deuxième série de problèmes de concours, BeyondAIME, où il annonce 74,25 % contre 70 % pour MUSE-Glimmer-30B, un modèle trente fois plus gros.
Il n'est pas en tête partout dans ce tableau. BeyondAIME est le seul de ses sept tests où il a le meilleur score annoncé. Ce n'est pas le meilleur modèle de maths qui existe. C'est un modèle tout petit, assis au milieu de modèles des dizaines de fois plus gros, et c'est justement sa petite taille qui le rend bon marché à vérifier.
Le mérite revient à ceux qui l'ont construit : Prignano, Cirillo, Morosini, Cerovaz, Bartolocci, Rodolà, Starace et Pappone. Ils ont publié les poids sous Apache 2.0 avec leur code d'évaluation, et écrit un plugin pour que vLLM, le programme open source qui sert les modèles, puisse le faire tourner. Les problèmes que nous avons corrigés viennent de MathArena. Nous avons repéré Limite dans une vidéo d'actualité d'AI Search. Notre part : empaqueter le plugin pour qu'il se déploie, le faire tourner sur deux cartes et corriger chaque réponse.
27 sur 30 en un essai, ce qui le place dans la fourchette de Paradigma
Nous avons repris la configuration d'évaluation de Paradigma : les mêmes 30 problèmes dans la version du dataset que fixe leur évaluateur, la même consigne, les mêmes réglages d'échantillonnage, le même budget d'écriture d'un peu moins de 127 000 tokens. Notre script comparait la dernière réponse encadrée avec la réponse officielle.
| Résultat | Problèmes |
|---|---|
| Juste | 27 |
| Faux | 2 (n° 9 et n° 15) |
| Pas de réponse | 1 (le n° 28 s'est arrêté en pleine phrase après environ 111 000 tokens) |
Cela fait 90 % sur une seule passe. Les 94,01 % de Paradigma sont une moyenne sur 32 essais par problème, donc notre chiffre confirme la fourchette, pas la décimale.
Chaque réponse arrive après des pages de calcul
Un modèle comme celui-ci travaille sur papier, comme vous le feriez. Il essaie une approche, la vérifie, revient en arrière et en essaie une autre, et vous attendez chaque mot. La réponse juste la plus courte a pris 3 203 tokens. La plus longue, environ 101 000. La moitié des problèmes en ont demandé moins d'environ 21 000.
Seul, il produit une réponse à environ 211 tokens par seconde sur la 4090. Un problème typique prend quand même moins de deux minutes, et le plus long huit. Sur la RTX 2000 Ada de 16 GB, il a tourné 2,5 fois plus lentement, avec les deux mêmes problèmes de test justes.
La bonne façon de l'utiliser, c'est donc en lot. Avec les 30 problèmes d'un coup, la 4090 a écrit à son pic environ 17 fois plus vite qu'avec une seule réponse. Le lot entier a pris 16 minutes, tenu ouvert par la seule réponse la plus longue. À environ 0,80 euro de l'heure pour la carte, cela a fait environ 22 centimes d'euro pour 25 réponses justes, moins d'un centime d'euro par problème résolu. Ce calcul ne compte que le temps où la carte travaillait, pas le démarrage ni le temps d'inactivité.
Il transforme tout en maths
Limite répond à une question de maths par conversation, avec une consigne d'ouverture fixe. Son format d'entrée refuse une consigne d'ouverture personnalisée ou des outils. Demandez-lui autre chose et il répond quand même avec des maths. Dans le blog de Paradigma lui-même, "What is photosynthesis?" est revenu sous la forme d'un problème de division cellulaire. C'est charmant pour un modèle de maths et rédhibitoire pour tout le reste. Ce n'est pas un assistant de chat ni un outil pour un agent.
Notre code de déploiement supprime toute consigne d'ouverture qui n'est pas la consigne standard, pour qu'une application conçue pour un modèle de chat ne voie pas sa requête rejetée.
À qui ça s'adresse
- Les équipes qui ont besoin de solutions détaillées à des problèmes de type concours avec une seule réponse finale : ça vaut le coup. Vérifiez la réponse encadrée avant de vous y fier.
- Les équipes avec une petite carte : une vraie carte de 16 GB a fonctionné, et plafonner vLLM à environ 4 GB de la 4090 a quand même donné deux problèmes courts justes. De vraies cartes de 8 GB et de 12 GB n'ont pas été testées.
- Ceux qui ont besoin de réponses rapides pour une seule personne, d'un assistant de chat ou d'outils : cherchez ailleurs.
Sur InferenceKey, il a tourné comme backend personnalisé, un court fichier Python qui installe les versions exactes vérifiées par Paradigma et lance vLLM avec leur plugin. Avec tout déjà chargé sur la carte, un redémarrage était prêt en 31 secondes. Un point reste ouvert : notre SDK publié ne sait pas encore répondre aux requêtes de chat, et le contournement en attendant la prochaine version est dans l'article Research.
La limite honnête : nous avons corrigé un essai par problème sur une série publique avant l'entraînement, donc ce résultat est cohérent avec le chiffre de Paradigma, mais ne prouve pas que le modèle gère des maths qu'il n'a jamais vues.
Lisez le test complet, avec l'échelle de mémoire, la longueur de chaque réponse et les étapes de déploiement, dans notre article Research.