Limite 1B acertó 27 de 30 problemas de matemáticas de competición en una sola RTX 4090, siempre que solo le pidas matemáticas
El modelo de matemáticas de 2,1 GB de Paradigma acertó 27 de 30 problemas del AIME 2026 a un intento en una RTX 4090, y funcionó en una tarjeta de 16 GB.
El fichero pesa 2,1 GB. El examen es el AIME 2026, el examen de invitación estadounidense para los mejores estudiantes de bachillerato. Le dimos a Limite 1B Violetto, el nuevo modelo de matemáticas de Paradigma, los 30 problemas en una sola RTX 4090 de nuestra nube, con un intento por problema. Acertó 27. Una tarjeta de estación de trabajo real de 16 GB también lo ejecutó. Si despliegas modelos, esto significa que las matemáticas de nivel de competición ya no necesitan una tarjeta grande: con los 30 problemas a la vez, el lote costó unos 22 céntimos de euro de tiempo de GPU. El modelo es Apache 2.0, así que puedes meterlo en un producto. La pega está igual de clara: hace matemáticas y solo matemáticas, una pregunta por conversación, y piensa mucho rato antes de cada respuesta. Si tienes un montón de problemas con una única respuesta final cada uno, merece la pena probarlo.
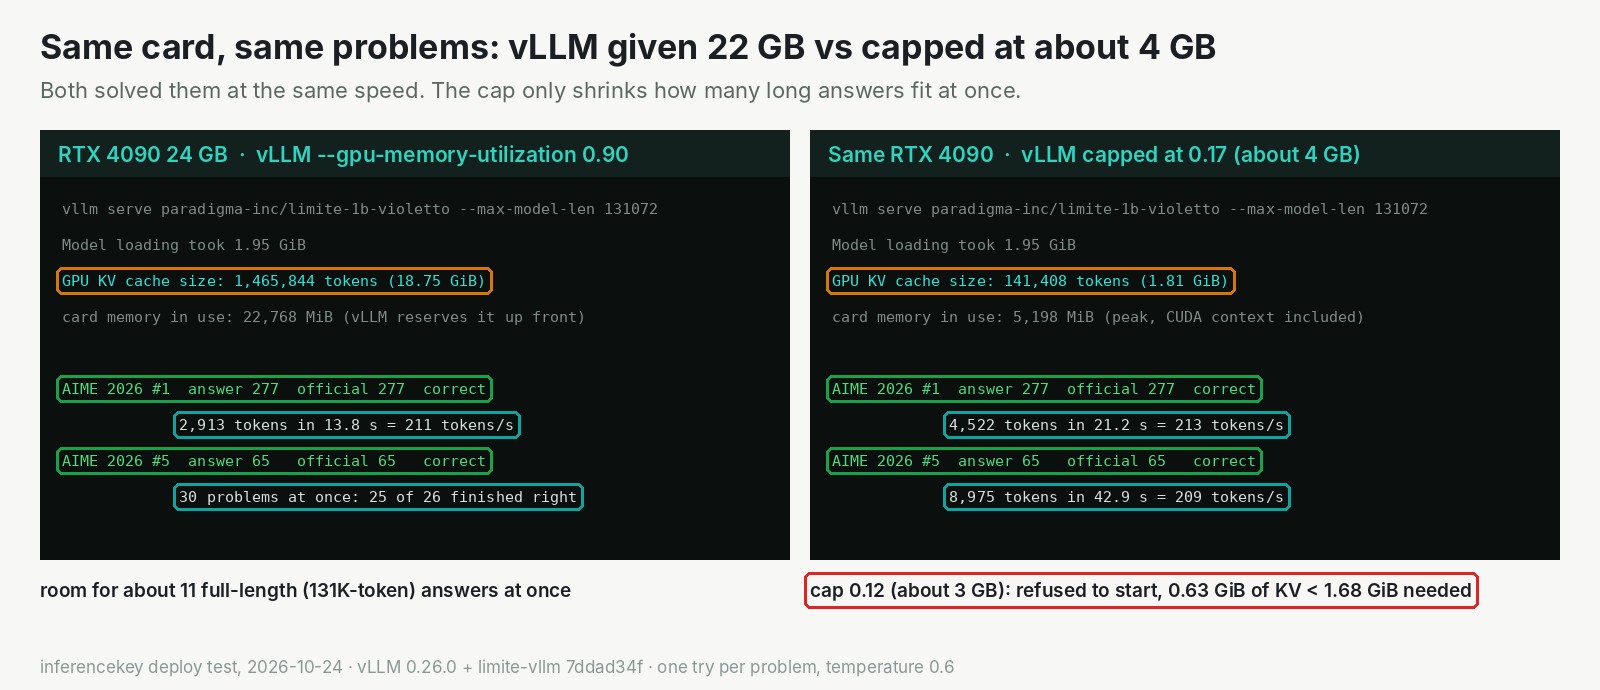
Misma tarjeta, mismos problemas. Un límite de memoria más pequeño no hizo más lenta ninguna respuesta; solo reduce cuántas respuestas largas caben a la vez.
Un modelo pequeño con un solo trabajo
Limite 1B Violetto es el primer modelo de Paradigma. Tiene unos 1B parámetros, los números que un modelo aprende durante el entrenamiento, y el equipo lo entrenó desde cero en unas seis semanas. En la tabla de la propia Paradigma saca un 94,01 % en AIME 2026. Su afirmación estrella es otro conjunto de problemas de competición, BeyondAIME, donde declara un 74,25 % frente al 70 % de MUSE-Glimmer-30B, un modelo treinta veces más grande.
No encabeza esa tabla en todo. BeyondAIME es la única de sus siete pruebas en la que tiene la puntuación más alta declarada. No es el mejor modelo de matemáticas que existe. Es uno muy pequeño rodeado de modelos decenas de veces mayores, y ser pequeño es justo lo que hace barato comprobarlo.
El mérito es de quienes lo construyeron: Prignano, Cirillo, Morosini, Cerovaz, Bartolocci, Rodolà, Starace y Pappone. Publicaron los pesos con licencia Apache 2.0 junto con su código de evaluación, y escribieron un plugin para que vLLM, el programa de código abierto que sirve modelos, pueda ejecutarlo. Los problemas que corregimos salen de MathArena. Vimos Limite en un vídeo de noticias de AI Search. Lo nuestro fue empaquetar el plugin para que se pueda desplegar, ejecutarlo en dos tarjetas y corregir cada respuesta.
27 de 30 a un intento, dentro del rango de Paradigma
Copiamos la configuración de evaluación de Paradigma: los mismos 30 problemas en la versión del dataset que fija su evaluador, la misma instrucción, los mismos ajustes de muestreo y el mismo presupuesto de escritura de algo menos de 127.000 tokens. Nuestro script comparó la última respuesta enmarcada con la oficial.
| Resultado | Problemas |
|---|---|
| Correctos | 27 |
| Incorrectos | 2 (#9 y #15) |
| Sin respuesta | 1 (#28 se cortó a mitad de frase tras unos 111.000 tokens) |
Eso es un 90 % en una sola tanda. El 94,01 % de Paradigma es la media de 32 intentos por problema, así que nuestra cifra confirma el rango, no el decimal.
Cada respuesta llega tras páginas de desarrollo
Un modelo así trabaja sobre el papel, como lo harías tú. Prueba un enfoque, lo comprueba, da marcha atrás y prueba otro, y tú esperas cada palabra. La respuesta correcta más corta necesitó 3.203 tokens. La más larga, unos 101.000. La mitad de los problemas necesitó menos de unos 21.000.
En solitario, una respuesta va a unos 211 tokens por segundo en la 4090. Aun así, un problema típico tarda menos de dos minutos, y el más largo ocho. En la RTX 2000 Ada de 16 GB fue 2,5 veces más lento, con los mismos dos problemas de prueba acertados.
Así que la forma de usarlo es por lotes. Con los 30 problemas a la vez, la 4090 escribió en su pico unas 17 veces más rápido que con una sola respuesta. El lote entero tardó 16 minutos, alargado por la respuesta más larga. A unos 0,80 euros la hora por la tarjeta, salió por unos 22 céntimos de euro para 25 respuestas correctas, menos de un céntimo por problema resuelto. Eso cuenta solo el tiempo en que la tarjeta estuvo ocupada, no el arranque ni el tiempo parado.
Todo lo convierte en matemáticas
Limite responde una pregunta de matemáticas por conversación, con una instrucción inicial fija. Su formato de entrada rechaza una instrucción inicial personalizada o herramientas. Pregúntale cualquier otra cosa y te contesta con matemáticas igualmente. En el propio blog de Paradigma, "What is photosynthesis?" volvió convertido en un problema sobre células que se dividen. En un modelo de matemáticas tiene su gracia; para cualquier otra cosa lo descarta. No es un asistente de chat ni una herramienta para un agente.
Nuestro código de despliegue descarta cualquier instrucción inicial que no sea la estándar, para que una app hecha para un modelo de chat no vea su petición rechazada.
A quién le importa
- Equipos que necesitan soluciones desarrolladas de problemas tipo competición con una única respuesta final: merece la pena ejecutarlo. Comprueba la respuesta enmarcada antes de fiarte.
- Equipos con una tarjeta pequeña: una tarjeta real de 16 GB funcionó, y limitar vLLM a unos 4 GB de la 4090 aún acertó dos problemas cortos. No probamos tarjetas reales de 8 GB ni de 12 GB.
- Quien necesite respuestas rápidas para una persona, un asistente de chat o herramientas: que busque en otra parte.
En InferenceKey funcionó como backend personalizado, un fichero Python corto que instala las versiones exactas que verificó Paradigma y arranca vLLM con su plugin. Con todo ya cargado en la tarjeta, un reinicio estuvo listo en 31 segundos. Queda un detalle por pulir: nuestro SDK publicado todavía no puede atender peticiones de chat, y la solución provisional hasta la próxima versión está en el post de Research.
El límite honesto: corregimos un intento por problema en un conjunto que era público antes del entrenamiento, así que esto es coherente con la cifra de Paradigma, no una prueba de que el modelo resuelva matemáticas que nunca ha visto.
Lee la prueba completa, con la escalera de memoria, la longitud de cada respuesta y los pasos de despliegue, en nuestro post de Research.