Ming-Image Design dibuja pantallas llenas de texto en 7 segundos, con una tarjeta de 80 GB
El modelo de diseño de 6B de inclusionAI usó 64,4 GiB en una A100 80GB, dibujó una pantalla de 1024 en 6 a 7 s y logró un PNG transparente en seis intentos.
Un salto de línea decidió si nuestra pegatina del zorro salía como un recorte limpio o como un cuadrado blanco. Esa es la parte más quisquillosa de Ming-Image-0.1-Design, el nuevo modelo abierto de inclusionAI para pantallas de apps, dashboards, diapositivas y carteles llenos de texto. La cifra que importa es la memoria. Se vende como un modelo de 6B, y eso suena a tarjeta de 12 GB. En una NVIDIA A100 de 80 GB de nuestra nube llegó a un pico de 64,4 GiB. Si despliegas modelos de imagen, eso cambia la tarjeta que alquilas. En esa tarjeta dibujó una pantalla de app de 1024 x 1024 en 6 a 7 segundos y un cartel de 2048 x 2048 en 36. Las palabras que pones entre comillas salieron casi siempre bien escritas. Tiene licencia MIT, así que puedes usar comercialmente lo que genera. Para maquetas con texto real en tu propio hardware, cuenta con una tarjeta de 80 GB y comprueba en código cada recurso transparente.
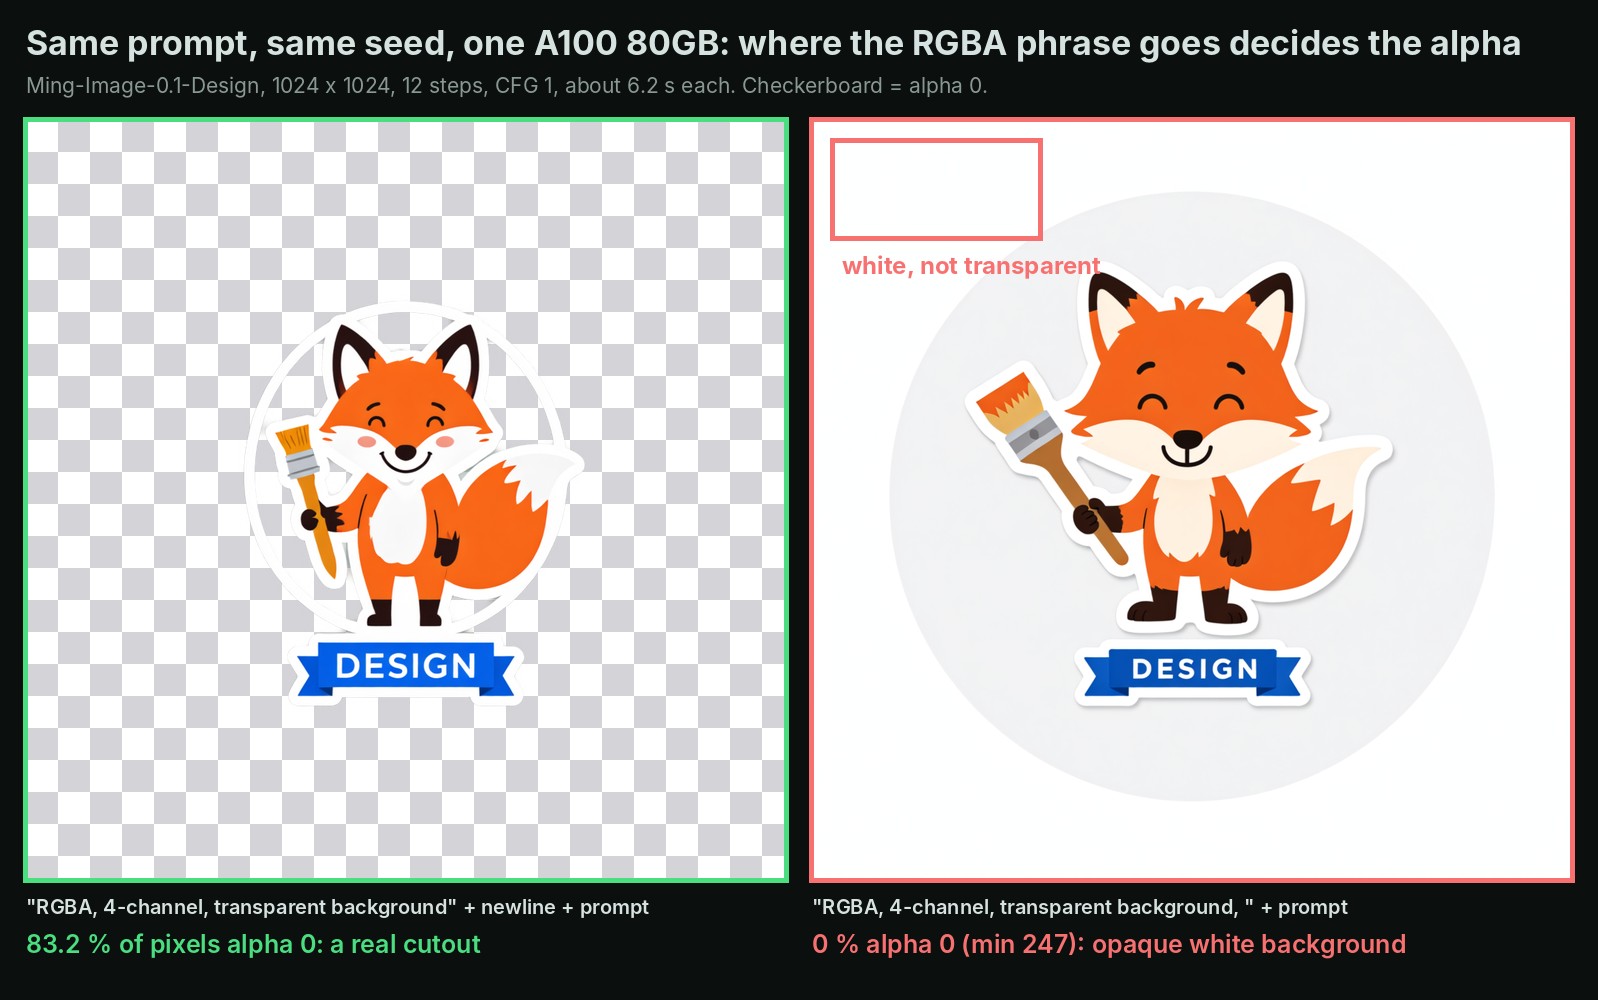
Mismo prompt, mismo punto de partida aleatorio. El salto de línea es la única diferencia.
El 6B es solo un miembro de la banda
El cartel de un concierto anuncia al cantante. La furgoneta sigue cargando la batería, los amplis y al bajista. Ming-Image Design funciona igual. La parte de 6B parámetros, la que dibuja, ocupa 12,3 GB en disco. Detrás hay un modelo de lenguaje de 34 GB que lee tu prompt, un conector de 6,2 GB y un decodificador pequeño. En total, el repo pesa 52,9 GB.
Los autores lo dicen en su README: la configuración mínima validada es "one GPU with at least 80 GiB of memory" (una GPU con al menos 80 GiB de memoria). Lo que se repitió fue el número de parámetros. Vimos el modelo en un vídeo de noticias de AI Search, que hablaba de 12 gigabytes, y nuestro propio catálogo copió esa cifra. Queríamos la real, así que lo ejecutamos.
Bastante rápido para iterar un diseño, por una fracción de céntimo por pantalla
Mantuvimos la configuración validada por los autores: modelo sin comprimir, 12 pasadas por imagen, una petición cada vez y su propio código Python por debajo. Generamos 15 imágenes con prompts nuestros, un intento por prompt.
| Tamaño | Tiempo de tarjeta por imagen | Pico de memoria de la tarjeta |
|---|---|---|
| 1024 x 1024 | 6,2 a 7,4 s | 50,45 GiB |
| 2048 x 2048 | 35,8 s | 64,4 GiB |
Cuatro veces más píxeles cuestan unas cinco veces más tiempo. Trabajando sin parar, una tarjeta haría unas 400 a 500 pantallas por hora a 1024. Una A100 de 80 GB se alquila por unos 1,4 a 1,8 dólares la hora, así que una pantalla de 1024 cuesta entre un cuarto y medio céntimo, y un cartel de 2048 unos 2 céntimos. Es una estimación a partir de imágenes sueltas, no de una ejecución sostenida.
Las palabras entre comillas salen bien, el resto es decoración
El texto corto que escribes entre comillas suele ser el texto que obtienes. Un cartel de concierto sacó bien el nombre del grupo y las fechas en tres ciudades. Una diapositiva titulada "Q3 GPU spend" sacó bien todas las etiquetas de las barras. Las tres tarjetas de cifras de un dashboard salieron perfectas. El texto entre comillas salió bien en 5 de 7 maquetas.
El texto que dejas en manos del modelo es otra historia. Los ejes de los gráficos, los subtítulos y las tarjetas de funciones que no escribimos nosotros salieron como pseudopalabras convincentes. Las listas largas también fallaron: el menú de 12 líneas de una cafetería salió con dos precios mal y una línea de café que nunca pedimos.
La transparencia funcionó en una de seis variantes del prompt
Cada imagen sale como un PNG con canal alfa, la capa que indica cuánto se ve a través de cada píxel. Ese es el número estrella del modelo: una pegatina o un logo que cae sobre una diapositiva sin un recuadro blanco alrededor.
En la práctica funcionó en una variante de seis. Los autores publican diez frases de activación. Con "RGBA, 4-channel, transparent background" sola en la primera línea, el zorro salió con el 83,2 % de los píxeles totalmente transparentes, dos veces. Con una coma en lugar del salto de línea, blanco sólido. Un icono de app con la frase en su propia línea también salió opaco, igual que otras tres combinaciones de frase y tema.
A quién le importa
- Equipos que hacen maquetas, diapositivas o carteles con un texto que pueden escribir de antemano: pon entre comillas cada palabra que necesites.
- Quien necesite menús, listas de precios o tablas: lee cada línea antes de publicarla.
- Quien necesite recursos transparentes: pon la frase en su propia línea y comprueba la capa alfa en código. Nuestro backend devuelve con cada imagen el porcentaje de píxeles transparentes, así que esa comprobación es una línea.
- Equipos con tarjetas de menos de 80 GB: por ahora, cuenta con una tarjeta de 80 GB. Planeamos una emulación con 24 GB y nunca llegó a ejecutarse.
En InferenceKey, Ming viene como un script de Python, no como un servidor, así que lo envolvimos en un backend propio: un pequeño programa que carga el modelo una vez y responde a las peticiones. Un programa que ya pide imágenes a OpenAI puede llamar a esta tarjeta en su lugar. Un reinicio tras una actualización tardó 29 segundos. Las versiones exactas de las librerías que indican los autores no funcionan tal cual en Python 3.11. Unas algo más nuevas lo arreglan, y el ejemplo del SDK trae esas.
El límite, con honestidad: es una comprobación de comportamiento con un intento por prompt en un solo tipo de tarjeta, no un benchmark de calidad.
Gracias a inclusionAI por construir Ming-Image-0.1-Design y publicarlo con licencia MIT, junto con el código de inferencia y las frases de transparencia, y a AI Search, donde lo vimos. Lo nuestro fue el backend propio, el despliegue en InferenceKey, los arreglos de dependencias y las mediciones.
Lee la prueba completa, con todas las imágenes, las cifras de memoria y los pasos de despliegue, en nuestro post de Research.