Flint arregla un bug sembrado en seis segundos con una tarjeta gaming de 24 GB
Flint, el modelo abierto de Recursive, corrió su bucle de agente en una RTX 4090 con 16K de contexto, a 167 tokens/s, y arregló nuestro bug en 7 de 7 pruebas.
Cinco turnos, tres tests en verde, menos de seis segundos. Eso hizo Flint, un nuevo modelo abierto de programación de Recursive, en una RTX 4090 de 24 GB, una tarjeta pensada para jugar. Le dimos un proyecto pequeño con un bug sembrado y cuatro herramientas, y en las siete pruebas encontró el bug, lo arregló y demostró que el arreglo funcionaba. La pega es la memoria. En la 4090 solo entra con un contexto corto (el texto que tiene presente a la vez): 16K tokens. Con 32K se quedó sin sitio antes de atender una sola petición. En una RTX 5090 de 32 GB funcionó con 64K y escribió unos 210 tokens por segundo. Si sirves agentes de programación en tus propias GPU, es un modelo entrenado desde cero, con licencia Apache 2.0, que puedes ejecutar y modificar en una tarjeta que alquilas por horas. Para tareas cortas de agente, hoy basta con una tarjeta de 24 GB.
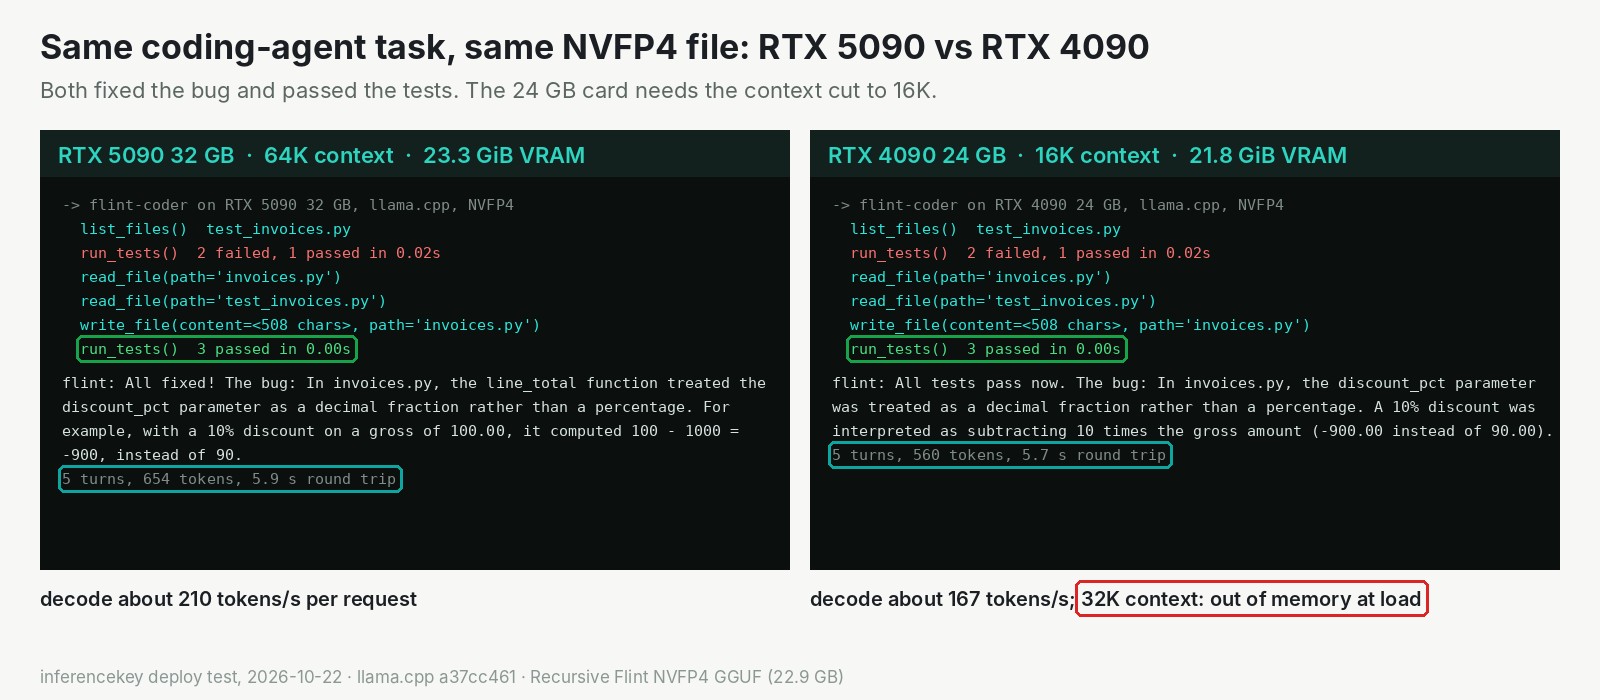
Misma tarea, mismo fichero, misma respuesta en las dos tarjetas. El recuadro rojo marca dónde se queda corta la tarjeta pequeña.
Un modelo grande que trabaja al coste de uno pequeño
Flint tiene 39,8B parámetros (los números que forman un modelo). Cada fragmento de palabra que escribe usa solo unos 2,5B. El truco se llama mezcla de expertos (mixture of experts). Imagina una banda de sesión con 256 músicos en plantilla: para cada fragmento de palabra, el director llama a los 6 que mejor encajan, más un batería de la casa que toca en todas las canciones. El resto espera en el camerino. Pero tienen que estar en el edificio, así que el modelo entero debe caber en memoria aunque la mayor parte descanse.
A diferencia de los modelos de programación que probamos hace poco, Flint no está construido sobre el modelo de otra empresa. Recursive lo entrenó desde el primer paso, con conocimiento hasta junio de 2026. Recursive declara un 74,2 % en SWE-bench Verified, una prueba que solo cuenta un arreglo cuando pasan los tests del propio proyecto real. Son cifras de Recursive, no nuestras, y no corresponden al fichero comprimido que ejecutamos.
La vía oficial es pesada: el kit de servidor de Recursive para el modelo completo pide una tarjeta de centro de datos con 141 GB o más. Hay una vía más barata, un fichero comprimido de 22,9 GB que corre en llama.cpp, el motor que usamos. Recursive recomienda al menos 48 GB para él, lo que cubre el contexto completo de Flint, 262.144 tokens. Queríamos saber cuánto por debajo de eso puede bajar un equipo pequeño.
La 4090 hizo el trabajo en el mismo tiempo, un 20 % más lenta al escribir
El soporte de Flint llegó a llama.cpp justo a tiempo. alexey-rsi escribió el cambio que enseña al motor la estructura de Flint, y se mergeó el 21 de octubre. Empezamos a la mañana siguiente.
La tarea era la que hace un agente de programación todo el día. Un módulo de facturas diminuto trataba un porcentaje como una fracción, y fallaban dos tests. Flint podía listar ficheros, leer un fichero, escribir un fichero y ejecutar los tests. Todas las pruebas siguieron el mismo camino: listar, ejecutar los tests, leer los dos ficheros, escribir el arreglo, volver a ejecutar los tests y explicar el error. Nunca tocó los tests para que pasaran, y todas las llamadas a herramientas que envió eran válidas.
| RTX 5090, 32 GB | RTX 4090, 24 GB | |
|---|---|---|
| Contexto que puede tener presente | 64K tokens | 16K tokens (32K no entró) |
| Memoria de la tarjeta usada | unos 23,3 de 32 GiB | unos 21,8 de 24 GiB |
| Velocidad de escritura | unos 210 tokens/s | unos 167 tokens/s |
| Bug sembrado arreglado | sí, 5 turnos, 5,9 s | sí, 5 turnos, 5,7 s |
En la 5090, 210 tokens por segundo son unas 150 palabras por segundo. Una respuesta de programación de 374 tokens volvió en tres segundos. En la 4090, Flint escribió un 20 % más lento, y en una tarea corta de agente no lo notarías. Doblar su contexto a 32K lo rompió: el modelo cargó y luego no pudo reservar el último trocito de memoria de trabajo, menos de 0,1 GiB.
Por debajo de 24 GB solo emulamos tarjetas más pequeñas, moviendo parte del modelo a la memoria principal de la máquina. Cerca de 16 GB escribió 4,6 tokens por segundo. Para uso interactivo, lo contamos como un fallo.
A quién le importa
- Un equipo que corre agentes de programación en su propio hardware: una RTX 4090 de 24 GB se apaña con tareas cortas, y una RTX 5090 de 32 GB tiene sitio para las medianas.
- Sesiones largas sobre un código grande: cuenta con más memoria. Con 16K o 64K de contexto, Flint no está preparado para cientos de llamadas a herramientas.
- Quien lo despliegue esta semana: usa la release b11803 de llama.cpp o una posterior. La versión por defecto de nuestro worker es anterior a Flint y aún tenemos que actualizarla.
En InferenceKey, el worker (el pequeño programa de la máquina con GPU que descarga el modelo y arranca el motor) sirvió el fichero oficial en su modo llama.cpp integrado, sin código propio. El primer arranque en una máquina limpia tardó unos nueve minutos, siete de ellos compilando llama.cpp. Un reinicio en caliente estuvo listo en 13,5 segundos. Queda un detalle por pulir: el razonamiento de Flint llega dentro del texto de la respuesta en lugar de en su propio campo, y cuenta contra tu presupuesto de tokens.
El límite, con honestidad: siete pruebas sobre un único bug sembrado en un proyecto de juguete son una prueba de humo, no un benchmark, y todas las peticiones se ejecutaron de una en una.
Gracias a Recursive por construir Flint, y a alexey-rsi por su soporte en llama.cpp. Lo vimos en un hilo de r/LocalLLaMA. Lo nuestro fue el despliegue en InferenceKey, el ejemplo del SDK y las mediciones.
Lee la prueba completa, con la escalera de memoria, las cifras de velocidad y los pasos de despliegue, en nuestro post de Research.