Flint corrige un bug piégé en six secondes sur une carte gaming de 24 GB
Flint, le modèle de code ouvert de Recursive, a tourné en agent sur une RTX 4090 à 16K de contexte, 167 tokens/s, et a corrigé notre bug 7 fois sur 7.
Cinq tours, trois tests au vert, moins de six secondes. Voilà ce qu'a fait Flint, un nouveau modèle de code ouvert de Recursive, sur une RTX 4090 de 24 GB, une carte conçue pour le jeu vidéo. Nous lui avons donné un petit projet avec un bug placé exprès et quatre outils, et il a trouvé le bug, l'a corrigé et a prouvé la correction dans les sept essais. Le hic, c'est la mémoire. Sur la 4090, il ne tient qu'avec un contexte court (la quantité de texte qu'il garde en tête) : 16K tokens. À 32K, il a manqué de place avant de servir la moindre requête. Sur une RTX 5090 de 32 GB, il a tourné avec 64K et écrit environ 210 tokens par seconde. Si vous servez des agents de code sur vos propres GPU, c'est un modèle entraîné de zéro, sous Apache 2.0, que vous pouvez faire tourner et modifier sur une carte louée à l'heure. Pour des tâches d'agent courtes, une carte de 24 GB suffit dès aujourd'hui.
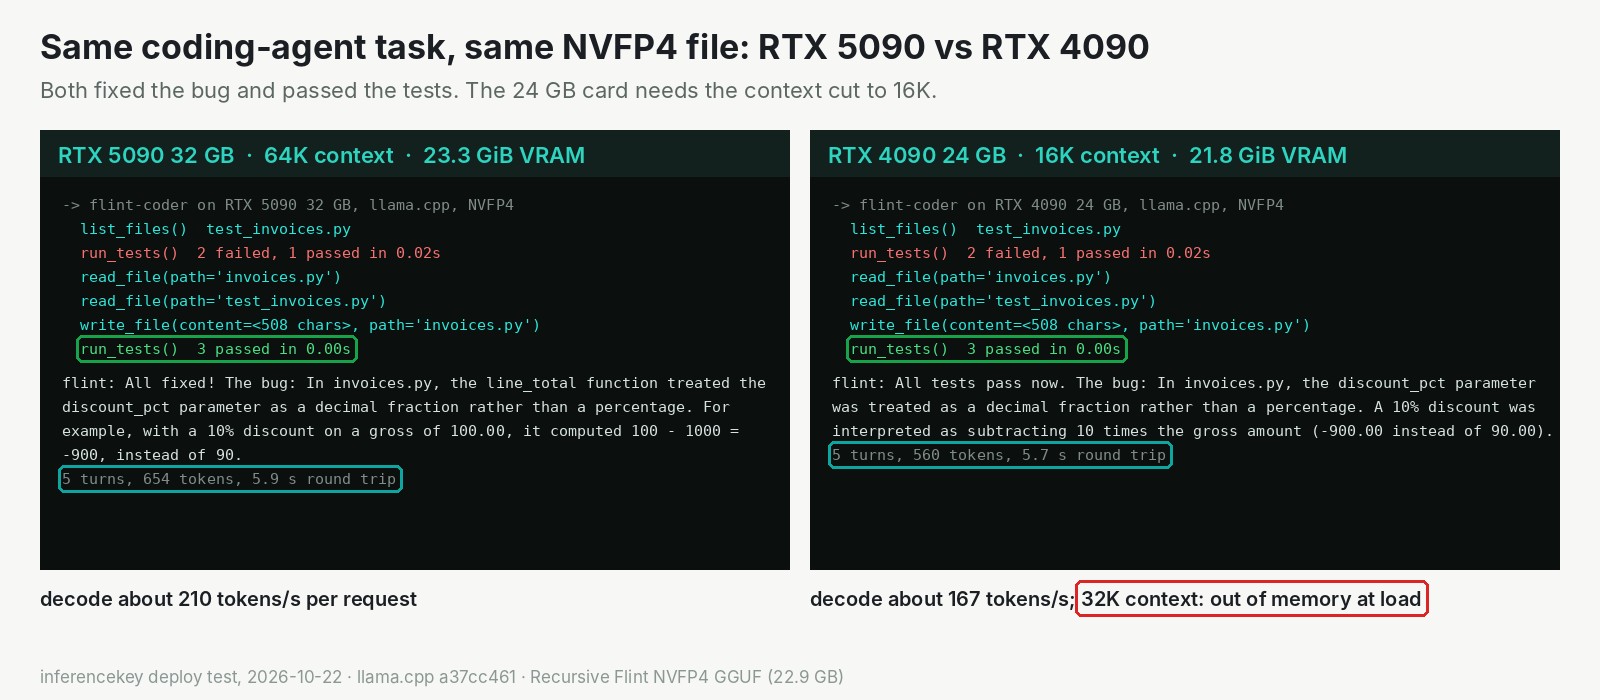
Même tâche, même fichier, même réponse sur les deux cartes. Le cadre rouge marque l'endroit où la plus petite carte s'arrête.
Un gros modèle qui travaille au prix d'un petit
Flint compte 39,8 milliards de paramètres (les nombres qui composent un modèle). Chaque morceau de mot qu'il écrit n'en utilise qu'environ 2,5 milliards. L'astuce s'appelle un mélange d'experts. Imaginez un groupe de musiciens de studio avec 256 noms sur la liste : pour chaque morceau de mot, le chef d'orchestre appelle les 6 qui conviennent le mieux, plus un batteur maison qui joue sur tous les titres. Les autres attendent en coulisses. Ils doivent quand même être dans le bâtiment, donc le modèle entier doit tenir en mémoire même si la plus grande partie se repose.
Contrairement aux modèles de code que nous avons testés récemment, Flint n'est pas construit sur le modèle d'une autre entreprise. Recursive l'a entraîné depuis la toute première étape, avec des connaissances qui vont jusqu'à juin 2026. Recursive annonce 74,2 % sur SWE-bench Verified, un test qui ne compte une correction que si les propres tests d'un vrai projet passent. Ce sont les chiffres de Recursive, pas les nôtres, et ce ne sont pas des scores pour le fichier compressé que nous avons fait tourner.
La voie officielle est lourde : le kit serveur de Recursive pour le modèle complet demande une carte de datacenter de 141 GB ou plus. Il existe une voie moins chère, un fichier compressé de 22,9 GB qui tourne sur llama.cpp, le moteur que nous avons utilisé. Recursive recommande au moins 48 GB pour lui, ce qui couvre le contexte complet de Flint, 262 144 tokens. Nous voulions savoir jusqu'où une petite équipe peut descendre en dessous.
La 4090 a fait le travail dans à peu près le même temps, 20 % plus lente à écrire
Le support de Flint est arrivé dans llama.cpp juste à temps. alexey-rsi a écrit la modification qui apprend au moteur l'architecture de Flint, et elle a été fusionnée le 21 octobre. Nous avons commencé le lendemain matin.
La tâche était celle qu'un agent de code fait toute la journée. Un minuscule module de facturation traitait un pourcentage comme une fraction, et deux tests échouaient. Flint pouvait lister les fichiers, lire un fichier, écrire un fichier et lancer les tests. Chaque essai s'est déroulé de la même façon : lister, lancer les tests, lire les deux fichiers, écrire la correction, relancer les tests, expliquer l'erreur. Il n'a jamais modifié les tests pour les faire passer, et chaque appel d'outil qu'il a envoyé était valide.
| RTX 5090, 32 GB | RTX 4090, 24 GB | |
|---|---|---|
| Contexte qu'il peut garder en tête | 64K tokens | 16K tokens (32K ne tenait pas) |
| Mémoire de la carte utilisée | environ 23,3 sur 32 GiB | environ 21,8 sur 24 GiB |
| Vitesse d'écriture | environ 210 tokens/s | environ 167 tokens/s |
| Bug piégé corrigé | oui, 5 tours, 5,9 s | oui, 5 tours, 5,7 s |
Sur la 5090, 210 tokens par seconde, c'est à peu près 150 mots par seconde. Une réponse de code de 374 tokens est revenue en trois secondes. Sur la 4090, Flint a écrit environ 20 % plus lentement, et pour une tâche d'agent courte vous ne le remarqueriez pas. Doubler son contexte à 32K l'a cassé : le modèle s'est chargé, puis n'a pas pu réserver son dernier petit bout de mémoire de travail, moins de 0,1 GiB.
En dessous de 24 GB, nous avons seulement émulé des cartes plus petites, en déplaçant une partie du modèle dans la mémoire principale de la machine. Vers 16 GB, il écrivait 4,6 tokens par seconde. Pour un usage interactif, nous comptons cela comme un échec.
À qui ça s'adresse
- Une équipe qui fait tourner des agents de code sur son propre matériel : une RTX 4090 de 24 GB gère les tâches courtes, et une RTX 5090 de 32 GB a de la place pour les tâches moyennes.
- Les longues sessions sur une grosse base de code : prévoyez plus de mémoire. Avec 16K ou 64K de contexte, Flint n'est pas configuré pour des centaines d'appels d'outils.
- Quiconque le déploie cette semaine : utilisez la release b11803 de llama.cpp ou plus récente. La version par défaut de notre worker est antérieure à Flint et doit encore être mise à jour de notre côté.
Sur InferenceKey, le worker (le petit programme sur la machine GPU qui récupère le modèle et démarre le moteur) a servi le fichier officiel dans son mode llama.cpp intégré, sans code sur mesure. Le premier démarrage sur une machine neuve a pris environ neuf minutes, dont sept pour compiler llama.cpp. Un redémarrage à chaud était prêt en 13,5 secondes. Un point reste à polir : le raisonnement de Flint arrive dans le texte de la réponse au lieu de son propre champ, et il est décompté de votre budget de tokens.
La limite, honnêtement : sept essais sur un seul bug piégé dans un projet jouet, c'est un test de fumée, pas un benchmark, et les requêtes ont tourné une par une.
Merci à Recursive d'avoir construit Flint, et à alexey-rsi pour son support dans llama.cpp. Nous l'avons repéré dans un fil sur r/LocalLLaMA. Notre part, c'est le déploiement sur InferenceKey, l'exemple du SDK et les mesures.
Lisez le test complet, avec l'échelle de mémoire, les chiffres de vitesse et les étapes de déploiement, dans notre article Research.