Flint behebt einen eingebauten Bug in sechs Sekunden auf einer 24-GB-Gaming-Karte
Recursives offenes Coding-Modell Flint lief als Agent auf einer RTX 4090 mit 16K Kontext und 167 Tokens/s und behob unseren Bug in 7 von 7 Läufen.
Fünf Runden, drei bestandene Tests, unter sechs Sekunden. Das schaffte Flint, ein neues offenes Coding-Modell von Recursive, auf einer RTX 4090 mit 24 GB, einer Karte, die fürs Gaming gebaut ist. Wir gaben ihm ein kleines Projekt mit einem absichtlich eingebauten Bug und vier Werkzeugen, und es fand den Bug, behob ihn und bewies die Korrektur in allen sieben Läufen. Der Haken ist der Speicher. Auf die 4090 passt es nur mit einem kurzen Kontext (wie viel Text es im Kopf behält): 16K Tokens. Bei 32K ging ihm der Platz aus, bevor es eine einzige Anfrage beantwortet hatte. Auf einer RTX 5090 mit 32 GB lief es mit 64K und schrieb etwa 210 Tokens pro Sekunde. Wenn Sie Coding-Agenten auf eigenen GPUs betreiben, ist das ein von Grund auf trainiertes Modell unter Apache 2.0, das Sie auf einer stundenweise gemieteten Karte betreiben und verändern können. Für kurze Agenten-Aufgaben reicht heute eine 24-GB-Karte.
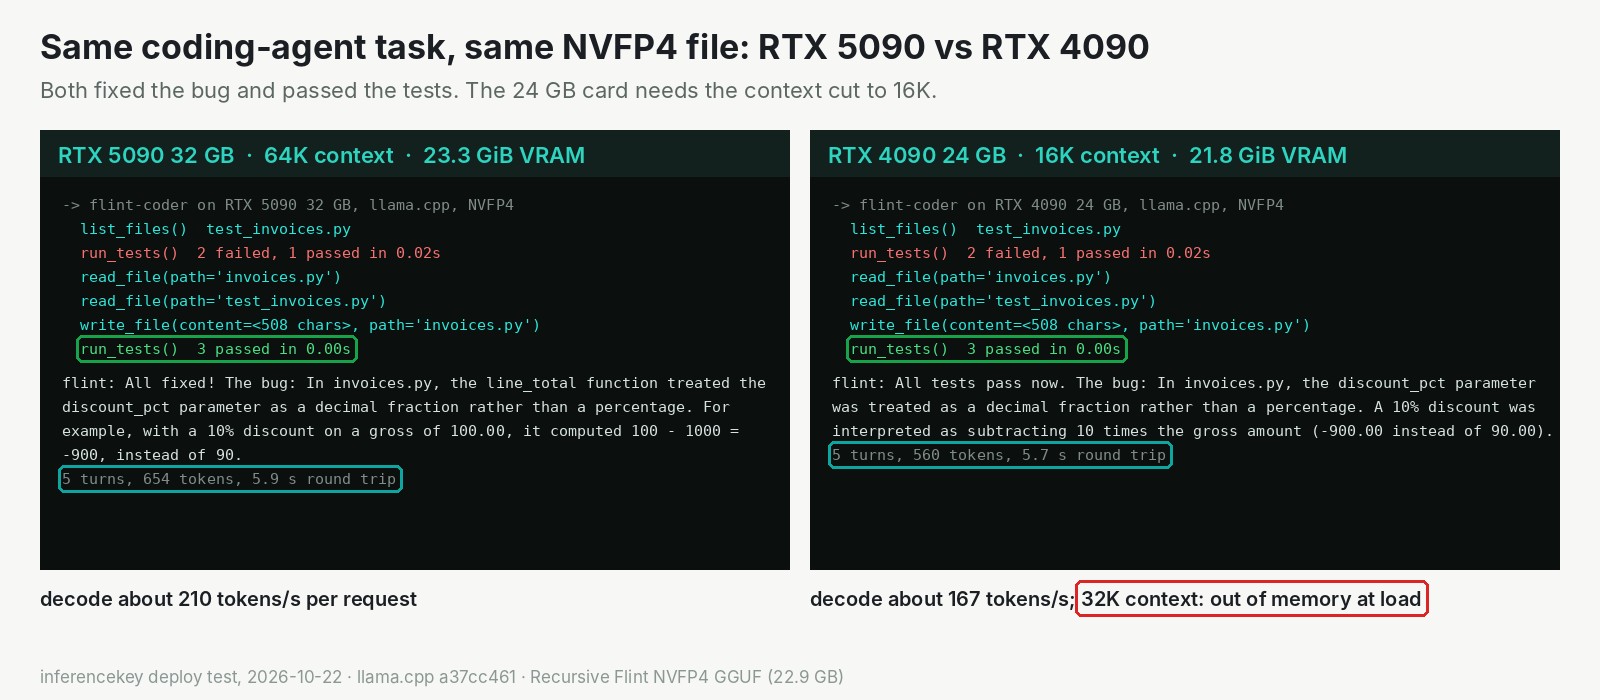
Gleiche Aufgabe, gleiche Datei, gleiche Antwort auf beiden Karten. Der rote Kasten markiert, wo die kleinere Karte aufhört.
Ein großes Modell, das zum Preis eines kleinen arbeitet
Flint hat 39,8 Milliarden Parameter (die Zahlen, aus denen ein Modell besteht). Jedes Wortstück, das es schreibt, nutzt davon nur etwa 2,5 Milliarden. Der Trick heißt Mixture of Experts. Stellen Sie sich eine Studioband mit 256 Musikern auf der Liste vor: Für jedes Wortstück ruft der Bandleader die 6, die am besten passen, plus einen Hausschlagzeuger, der jeden Song spielt. Der Rest wartet im Backstage-Raum. Im Gebäude müssen sie trotzdem sein, also muss das ganze Modell in den Speicher passen, auch wenn der Großteil ruht.
Anders als die Coding-Modelle, die wir zuletzt getestet haben, baut Flint nicht auf dem Modell einer anderen Firma auf. Recursive hat es vom allerersten Schritt an selbst trainiert, mit Wissen bis Juni 2026. Recursive meldet 74,2 % auf SWE-bench Verified, einem Test, der eine Korrektur nur zählt, wenn die eigenen Tests eines echten Projekts bestehen. Das sind Recursives Zahlen, nicht unsere, und sie gelten nicht für die komprimierte Datei, die wir betrieben haben.
Der offizielle Weg ist schwer: Recursives Server-Paket für das volle Modell verlangt eine Rechenzentrumskarte mit 141 GB oder mehr. Es gibt einen günstigeren Weg, eine 22,9 GB große komprimierte Datei, die auf llama.cpp läuft, der Engine, die wir genutzt haben. Recursive empfiehlt dafür mindestens 48 GB, womit Flints voller Kontext von 262.144 Tokens abgedeckt ist. Wir wollten wissen, wie weit ein kleines Team darunter gehen kann.
Die 4090 erledigte die Aufgabe in etwa derselben Zeit, beim Schreiben 20 % langsamer
Die Unterstützung für Flint kam gerade rechtzeitig in llama.cpp an. alexey-rsi schrieb die Änderung, die der Engine Flints Aufbau beibringt, und sie wurde am 21. Oktober gemergt. Wir haben am nächsten Morgen angefangen.
Die Aufgabe war die, die ein Coding-Agent den ganzen Tag erledigt. Ein winziges Rechnungsmodul behandelte einen Prozentsatz als Bruch, und zwei Tests schlugen fehl. Flint konnte Dateien auflisten, eine Datei lesen, eine Datei schreiben und die Tests ausführen. Jeder Lauf verlief gleich: auflisten, Tests ausführen, beide Dateien lesen, die Korrektur schreiben, die Tests erneut ausführen, den Fehler erklären. Es hat nie die Tests verändert, damit sie bestehen, und jeder Werkzeugaufruf, den es schickte, war gültig.
| RTX 5090, 32 GB | RTX 4090, 24 GB | |
|---|---|---|
| Kontext, den es im Kopf behalten kann | 64K Tokens | 16K Tokens (32K passte nicht) |
| Belegter Kartenspeicher | etwa 23,3 von 32 GiB | etwa 21,8 von 24 GiB |
| Schreibgeschwindigkeit | etwa 210 Tokens/s | etwa 167 Tokens/s |
| Eingebauter Bug behoben | ja, 5 Runden, 5,9 s | ja, 5 Runden, 5,7 s |
Auf der 5090 sind 210 Tokens pro Sekunde grob 150 Wörter pro Sekunde. Eine Coding-Antwort mit 374 Tokens kam in drei Sekunden zurück. Auf der 4090 schrieb Flint etwa 20 % langsamer, und bei einer kurzen Agenten-Aufgabe würden Sie das nicht merken. Den Kontext auf 32K zu verdoppeln, brachte es zum Scheitern: Das Modell wurde geladen und konnte dann den letzten kleinen Rest seines Arbeitsspeichers nicht reservieren, weniger als 0,1 GiB.
Unter 24 GB haben wir kleinere Karten nur emuliert, indem ein Teil des Modells in den Hauptspeicher des Rechners verschoben wurde. Bei etwa 16 GB schrieb es 4,6 Tokens pro Sekunde. Für interaktive Nutzung werten wir das als Fehlschlag.
Für wen das interessant ist
- Ein Team, das Coding-Agenten auf eigener Hardware betreibt: Eine RTX 4090 mit 24 GB schafft kurze Aufgaben, und eine RTX 5090 mit 32 GB hat Platz für mittlere.
- Lange Sitzungen in einer großen Codebasis: Planen Sie mehr Speicher ein. Mit 16K oder 64K Kontext ist Flint nicht für Hunderte von Werkzeugaufrufen eingerichtet.
- Alle, die es diese Woche deployen: Nutzen Sie llama.cpp ab Release b11803. Die Standardversion unseres Workers ist älter als Flint und muss bei uns noch aktualisiert werden.
Auf InferenceKey hat der Worker (das kleine Programm auf der GPU-Maschine, das das Modell holt und die Engine startet) die offizielle Datei in seinem eingebauten llama.cpp-Modus ausgeliefert, ohne eigenen Code. Der erste Start auf einer frischen Maschine dauerte etwa neun Minuten, sieben davon für das Kompilieren von llama.cpp. Ein Warmstart war nach 13,5 Sekunden bereit. Eine Baustelle ist noch offen: Flints Reasoning kommt im Antworttext statt in einem eigenen Feld an und zählt gegen Ihr Token-Budget.
Die ehrliche Grenze: Sieben Läufe mit einem eingebauten Bug in einem Spielzeugprojekt sind ein Smoke-Test, kein Benchmark, und alle Anfragen liefen nacheinander.
Danke an Recursive für Flint und an alexey-rsi für die Unterstützung in llama.cpp. Entdeckt haben wir es in einem Thread auf r/LocalLLaMA. Unser Teil waren das Deployment auf InferenceKey, das SDK-Beispiel und die Messungen.
Lesen Sie den vollständigen Test mit der Speicherleiter, den Geschwindigkeitswerten und den Deployment-Schritten in unserem Research-Beitrag.