MOSS-Image schreibt Speisekarten und Plakate fehlerfrei, wenn man ihm 80 Sekunden gibt
MOSS-Image (Apache 2.0) schrieb auf einer A40 in 80 s jedes Wort richtig. Ein Turbo-Add-on braucht 9 s, patzt aber ab und zu. Rund 30 GB auf der Karte.
Eine Speisekarte mit vier Preisen ist für ein Bildmodell eine schwerere Aufgabe als ein Sonnenuntergang. Iris-3B, das letzte Bildmodell, das wir getestet haben, zeichnete die Kreidetafel und ließ die Dezimalpunkte weg. MOSS-Image, ein offenes Modell für lange Texte in Bildern, schrieb in jedem unserer Texttests jedes Wort richtig. Das dauerte auf einer gemieteten A40 etwa 80 Sekunden pro Bild. Ein Turbo-Add-on aus der Community erzeugt dieselben Bilder in etwa 9 Sekunden und schreibt hin und wieder ein Wort falsch. Wenn Ihr Produkt Plakate, Speisekarten oder Social-Media-Grafiken erzeugt, ist das die Wahl: 80 Sekunden, die Sie direkt veröffentlichen können, oder 9 Sekunden, die jemand Korrektur lesen muss. Modell und Add-on stehen unter Apache 2.0, kommerzielle Nutzung ist also abgedeckt. Vollständig geladen belegte es etwa 30 GB Grafikspeicher. Unter emulierten Grenzen von 16 und 12 GB erzeugte es das identische Bild. Sie können es auf einer gemieteten oder eigenen GPU betreiben.
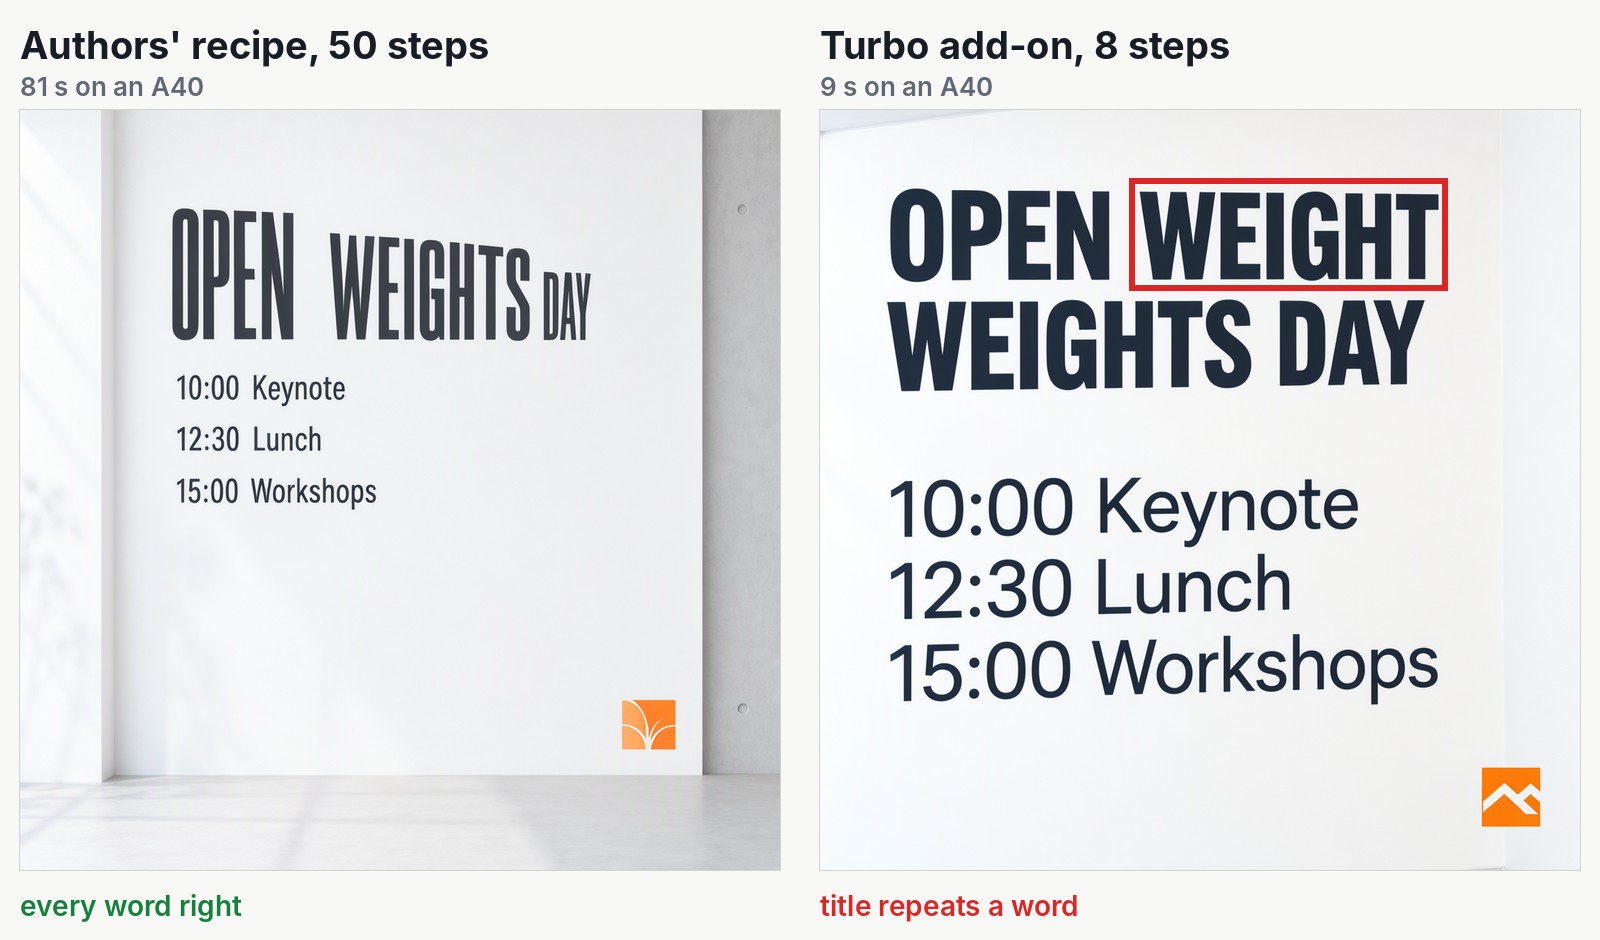
Gleicher Prompt, gleicher zufälliger Startpunkt, gleiches geladenes Modell. Der rote Rahmen markiert den einzigen Fehler der Turbo-Version auf diesem Plakat.
Ein offenes Modell für Wörter und Layouts
MOSS-Image stammt von OpenMOSS bei MOSI.AI. Die Autoren nennen Text in Bildern und lange Prompts als wichtigste Funktionen. Gemeint sind eine vollständige Speisekarte mit Preisen, eine Infografik mit einem Dutzend Beschriftungen oder ein Zeitplan auf einem Plakat: genau die Bilder, bei denen Bildmodelle meist patzen.
In ihrem technischen Bericht haben die Autoren einen eigenen Test für lange Texte in Bildern gebaut. Laut ihnen schreibt MOSS-Image im Schnitt 96,3 % des verlangten Textes, der beste Wert unter Modellen mit öffentlichen Dateien. Es ist ihr eigener Benchmark, also eine Angabe der Autoren. Unser kleiner Test zeigt in dieselbe Richtung.
Sie können auch das Layout steuern. Statt eines Satzes schicken Sie eine kurze strukturierte Beschreibung: eine Bildunterschrift für das ganze Bild, dann eine Liste von Elementen, jedes mit seinem Text und einem Feld auf der Leinwand. Die Autoren nennen das experimentell. Wir haben zwei Layouts ausprobiert, beide wurden eingehalten.
Jedes Wort richtig in 80 Sekunden, ein Wort zum Prüfen in 9
Wir haben mit MOSS-Image-SFT 22 Bilder erzeugt, ein Versuch pro Prompt und eine Anfrage nach der anderen. Die Karte war eine NVIDIA A40 mit 48 GB Speicher, gemietet in unserer eigenen Cloud. Die Prompts stammten von uns: ein Konferenzplakat, eine Infografik, eine Speisekarte auf einer Kreidetafel, eine handschriftliche Notiz auf Chinesisch, zwei Layouts, ein Straßenfoto und die Hände eines Pianisten.
Das Rezept der Autoren verwandelt zufälliges Rauschen in 50 Schritten in ein Bild. Es brauchte 78 bis 81 Sekunden pro Bild mit etwa einem Megapixel. Es schrieb jedes Wort auf dem Plakat, der Infografik, der Speisekarte und der chinesischen Notiz richtig. Auf der Speisekarte stand "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50": vier Preise, vier Dezimalpunkte.
Das Turbo-Add-on stammt von lodestones. Es ist eine 1,2 GB große Datei, die auf das Originalmodell gelegt wird, und sein Autor bezeichnet es als Work in Progress. Es kommt in 8 statt 50 Schritten ans Ziel, in 8,6 bis 9,2 Sekunden, etwa neunmal schneller. Speisekarte, chinesische Notiz und beide Layouts waren richtig. Im verlangten Text patzte es zweimal: beim Plakattitel oben und mit "PNG bock" statt "PNG back" auf der Infografik. Außerdem erfand es halb verstümmelte Schilder im Straßenfoto. Für Entwürfe taugt es gut, für eine Preisliste, die niemand prüft, ist es riskant.
Rund 30 GB auf der Karte und dieselben Pixel unter Grenzen von 16 und 12 GB
Eine 48-GB-Karte brauchen Sie wahrscheinlich nicht. Das Modell besteht aus zwei Teilen, die als Paar arbeiten. Ein 17 GB großer Leser, ein Sprachmodell, macht aus Ihrem Prompt eine Beschreibung. Ein 10 GB großer Maler macht aus dem Rauschen das Bild. Der Leser arbeitet nur kurz am Anfang und ruht dann, also kann er im Hauptspeicher des Rechners warten.
Wir haben begrenzt, wie viel Speicher das Modell auf der A40 nutzen durfte, damit sie sich wie eine Karte mit 16 oder 12 GB verhält:
| Speichergrenze | Spitzenbelegung auf der Karte | Rezept der Autoren | Turbo |
|---|---|---|---|
| Keine (echte A40, 48 GB) | etwa 30 GB | 80 s | 9 s |
| 16 GB (emuliert) | etwa 14 GB | 86 s | 13 s |
| 12 GB (emuliert) | etwa 11 GB | 160 s | 18 s |
Die begrenzten Läufe lieferten Byte für Byte dieselben Dateien wie der Lauf mit allem auf der Karte. Das 12-GB-Plakat hat also weiterhin jedes Wort richtig, und das Turbo-Plakat behält sein doppeltes Wort. Planen Sie etwa 32 GB Hauptspeicher ein: Die begrenzten Varianten nutzten bis zu 22 GB davon.
Emuliert war nur die Speichergröße, nicht die Geschwindigkeit einer Consumer-Karte, und auf einer echten Consumer-Karte ist der Platzbedarf noch nicht bestätigt, weil sich die gemieteten Maschinen mit RTX 3080 Ti, RTX 5080 und RTX 4090 nicht einrichten ließen.
Für wen das interessant ist
- Text, der stimmen muss (eine Speisekarte, ein Preis, ein Rechtshinweis): Nutzen Sie das 50-Schritte-Rezept der Autoren. Es war in unserem Test der einzige Modus ohne Fehler.
- Tempo für Entwürfe und Vorschauen: Nutzen Sie das Turbo-Add-on und lesen Sie jedes Wort, bevor es veröffentlicht wird.
- Eine kleinere GPU: Probieren Sie die 16-GB-Variante auf einer Karte mit 16 oder 24 GB. Auf einer 16-GB-Karte wird es eng, mit etwa 2 GB Reserve.
- Ein kommerzielles Produkt: Apache 2.0 für Modell und Add-on deckt das ab.
Wer nur am Schreibtisch Bilder erzeugen will, für den ist ComfyUI der kürzere Weg, es unterstützt MOSS-Image bereits. Wir wollten eine API, die andere Programme aufrufen, auf einer Karte unserer Wahl. Auf InferenceKey bediente eine einzige geladene Kopie das Rezept und das Turbo-Add-on, Anfrage für Anfrage. Sie war 63 Sekunden nach der Anforderung bereit.
OpenMOSS hat das Modell gebaut, lodestones das Turbo-Add-on, und entdeckt haben wir es in einem Video von AI Search. Unser Teil waren der Code, der es ausliefert, das SDK-Beispiel, das Deployment auf InferenceKey und die Messungen.
Lesen Sie den vollständigen Test mit allen Bildern, der Speicherleiter und den Deployment-Schritten in unserem Research-Beitrag.