MOSS-Image escribe bien menús y carteles, si le das 80 segundos
MOSS-Image, Apache 2.0, acertó todas las palabras en 80 s en una A40. Un complemento turbo tarda 9 s y a veces falla. Unos 30 GB en la tarjeta.
Un menú con cuatro precios es un trabajo más difícil para un modelo de imagen que una puesta de sol. Iris-3B, el último modelo de imagen que probamos, dibujó la pizarra y se comió los puntos decimales. MOSS-Image, un modelo abierto pensado para textos largos dentro de las imágenes, acertó todas las palabras en todas las pruebas de texto que le pusimos. Tardó unos 80 segundos por imagen en una A40 alquilada. Un complemento turbo de la comunidad hace las mismas imágenes en unos 9 segundos, y de vez en cuando se equivoca en una palabra. Si tu producto genera carteles, menús o imágenes para redes, esa es la elección: 80 segundos que puedes publicar, o 9 segundos que alguien tiene que revisar. El modelo y el complemento tienen licencia Apache 2.0, así que el uso comercial está cubierto. Con todo cargado, ocupó unos 30 GB de memoria de la tarjeta. Con límites emulados de 16 y 12 GB, generó la imagen idéntica. Puedes ejecutarlo en una GPU alquilada o propia.
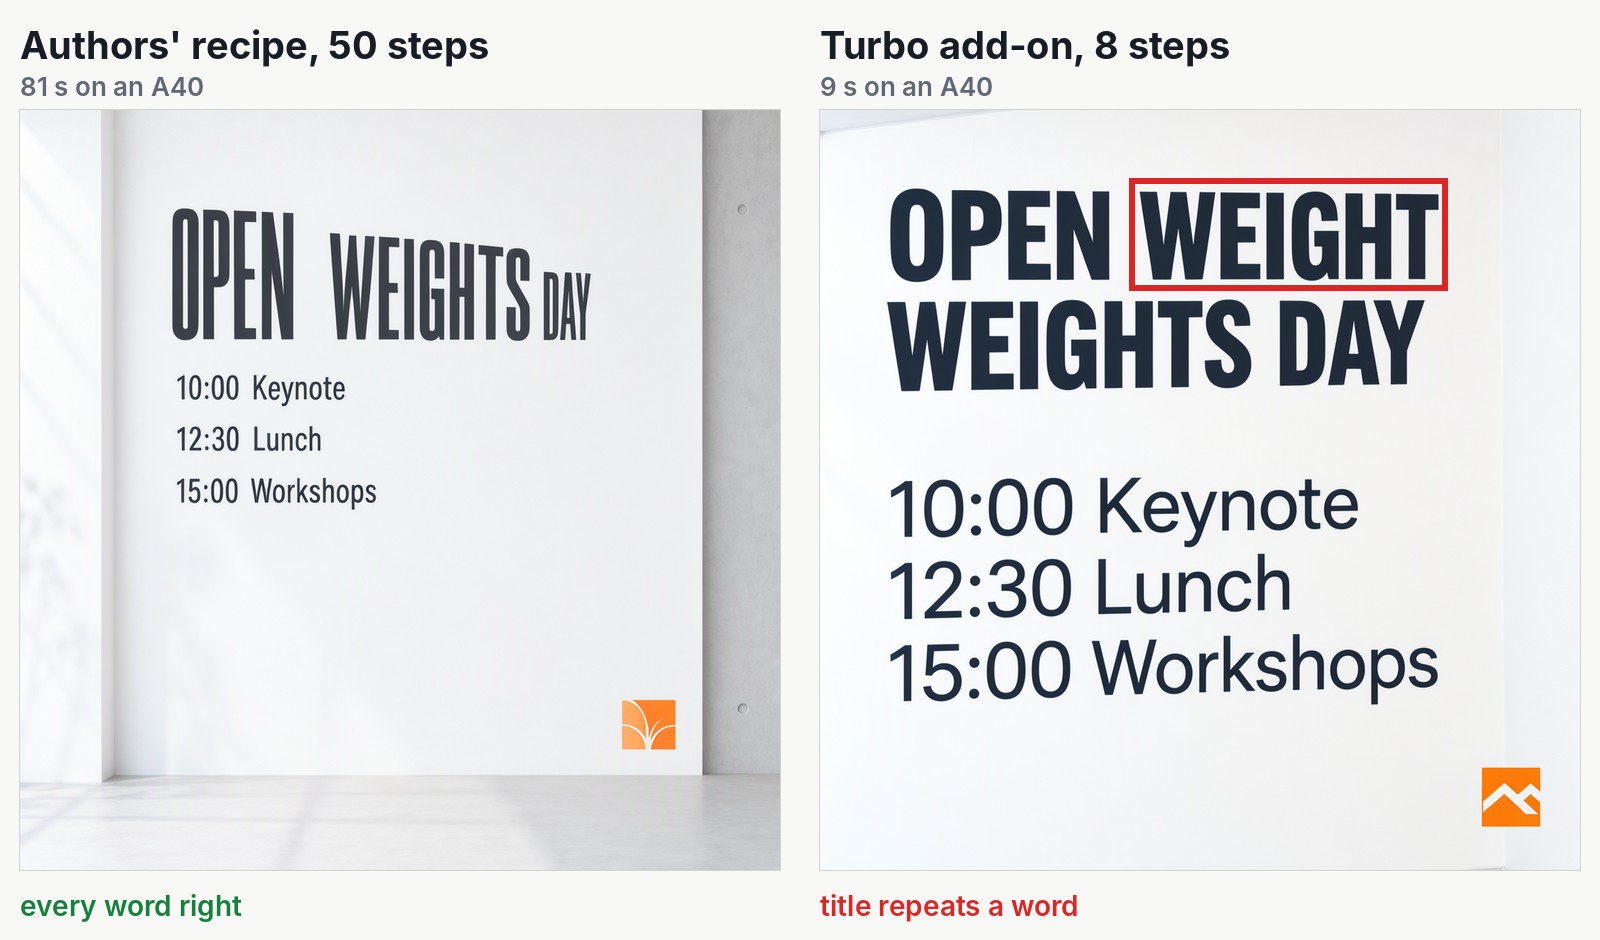
Mismo prompt, mismo punto de partida aleatorio, mismo modelo cargado. El recuadro rojo marca el único error de la versión turbo en este cartel.
Un modelo abierto pensado para palabras y maquetas
MOSS-Image es obra de OpenMOSS, en MOSI.AI. Sus autores destacan como funciones principales el texto en imágenes y los prompts largos. Imagina un menú completo con precios, una infografía con una docena de etiquetas o un horario en un cartel: justo las imágenes en las que los modelos suelen fallar.
En su informe técnico, los autores crearon su propia prueba de textos largos dentro de imágenes. Según ellos, MOSS-Image escribe de media el 96,3 % del texto pedido, la mejor puntuación entre los modelos con ficheros públicos. Es su benchmark, así que tómalo como lo que afirman ellos. Nuestra pequeña prueba apunta en la misma dirección.
También puedes controlar la maqueta. En lugar de una frase, envías una descripción breve y estructurada: un pie para toda la imagen y luego una lista de elementos, cada uno con su texto y una caja en el lienzo. Los autores la consideran experimental. Probamos dos maquetas y el modelo respetó las dos.
Todas las palabras bien en 80 segundos, alguna que revisar en 9
Generamos 22 imágenes con MOSS-Image-SFT, un intento por prompt y una petición cada vez. La tarjeta era una NVIDIA A40 con 48 GB de memoria, alquilada en nuestro cloud. Los prompts eran nuestros: un cartel de conferencia, una infografía, un menú en pizarra, una nota manuscrita en chino, dos maquetas, una foto callejera y las manos de un pianista.
La receta de los autores convierte ruido aleatorio en una imagen a lo largo de 50 pasos. Tardó entre 78 y 81 segundos por imagen de alrededor de un megapíxel. Escribió bien todas las palabras del cartel, la infografía, el menú y la nota en chino. El menú decía "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50": cuatro precios y cuatro puntos decimales.
El complemento turbo es de lodestones. Es un fichero de 1,2 GB que se coloca sobre el modelo original, y su autor lo presenta como trabajo en curso. Llega al resultado en 8 pasos en lugar de 50, en 8,6 a 9,2 segundos, unas nueve veces más rápido. Acertó el menú, la nota en chino y las dos maquetas. Falló dos veces en el texto que le pedimos: el título del cartel de arriba, y "PNG bock" en lugar de "PNG back" en la infografía. Además, se inventó carteles medio ilegibles en la foto callejera. Sirve muy bien para borradores, y es arriesgado para una lista de precios que nadie revisa.
Unos 30 GB en la tarjeta, y los mismos píxeles con límites de 16 y 12 GB
Seguramente no necesitas una tarjeta de 48 GB. El modelo son dos piezas que trabajan en pareja. Un lector de 17 GB, un modelo de lenguaje, convierte tu prompt en una descripción. Un pintor de 10 GB convierte el ruido en la imagen. El lector trabaja un momento al principio y luego se queda parado, así que puede esperar en la memoria principal del ordenador.
Limitamos la memoria que el modelo podía usar en la A40 para que se comportara como una tarjeta de 16 o 12 GB:
| Límite de memoria | Pico de memoria en la tarjeta | Receta de los autores | Turbo |
|---|---|---|---|
| Ninguno (A40 real, 48 GB) | unos 30 GB | 80 s | 9 s |
| 16 GB (emulado) | unos 14 GB | 86 s | 13 s |
| 12 GB (emulado) | unos 11 GB | 160 s | 18 s |
Las ejecuciones con límite produjeron ficheros idénticos byte a byte a los de la ejecución con todo en la tarjeta. Así que el cartel de 12 GB sigue teniendo todas las palabras bien, y el cartel turbo conserva su palabra repetida. Cuenta con unos 32 GB de memoria principal: las configuraciones con límite usaron hasta 22 GB.
Solo emulamos el tamaño de la memoria, no la velocidad de una tarjeta de consumo, y todavía no hemos confirmado que entre en una tarjeta de consumo real, porque las máquinas con RTX 3080 Ti, RTX 5080 y RTX 4090 que alquilamos no se pudieron configurar.
A quién le interesa
- Texto que tiene que salir bien (un menú, un precio, una línea legal): usa la receta de 50 pasos de los autores. Fue el único modo sin fallos en nuestra prueba.
- Velocidad para borradores y previsualizaciones: usa el complemento turbo, y lee cada palabra antes de publicar.
- Una GPU más pequeña: prueba la configuración de 16 GB en una tarjeta de 16 o 24 GB. En una de 16 GB va justo, con unos 2 GB de margen.
- Un producto comercial: la licencia Apache 2.0 del modelo y del complemento lo cubre.
Si solo quieres generar imágenes en tu escritorio, ComfyUI ya ejecuta MOSS-Image y es el camino más corto. Nosotros queríamos una API a la que llamen otros programas, en una tarjeta que elegimos nosotros. En InferenceKey, una sola copia cargada sirvió la receta y el complemento turbo, petición a petición. Estuvo lista 63 segundos después de pedirla.
OpenMOSS creó el modelo, lodestones hizo el complemento turbo, y lo descubrimos en un vídeo de AI Search. Nuestra parte fue el código que lo sirve, el ejemplo del SDK, el despliegue en InferenceKey y las mediciones.
Lee la prueba completa, con todas las imágenes, la escalera de memoria y los pasos de despliegue, en nuestro post de Research.