MOSS-Image acierta todas las palabras en 80 segundos, y casi todas en 9
Probamos MOSS-Image en una A40: todo el texto bien en 80 s, 9 s con un add-on turbo, y los mismos píxeles con la memoria limitada a 12 GB emulados.
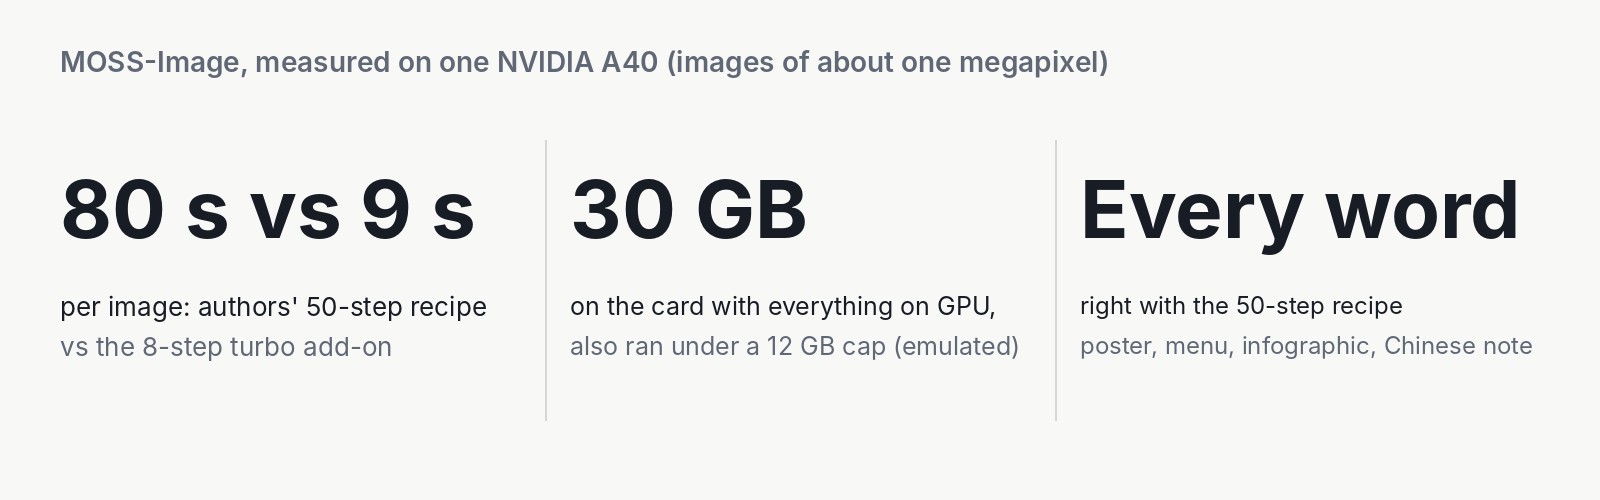
Ochenta segundos, todas las palabras bien. Nueve segundos, una palabra repetida. Ese es el intercambio que medimos con MOSS-Image, un modelo abierto hecho para escribir texto largo dentro de imágenes, en una sola tarjeta gráfica A40 alquilada. Los 80 segundos son la receta de 50 pasos de los autores. Los 9 salen de un add-on turbo de la comunidad que de vez en cuando se equivoca en una palabra. La licencia permite el uso comercial, así que esto importa a cualquiera que haga carteles, cartas de restaurante o tarjetas para redes sociales dentro de un producto. Con todo cargado, el modelo usó unos 30 GB de la memoria de la tarjeta. Cuando limitamos la A40 a 12 GB de memoria, hizo la imagen idéntica a la mitad de velocidad. Puedes desplegarlo en tu propia GPU con el ejemplo de nuestro SDK, y este post te dice qué configuración elegir.
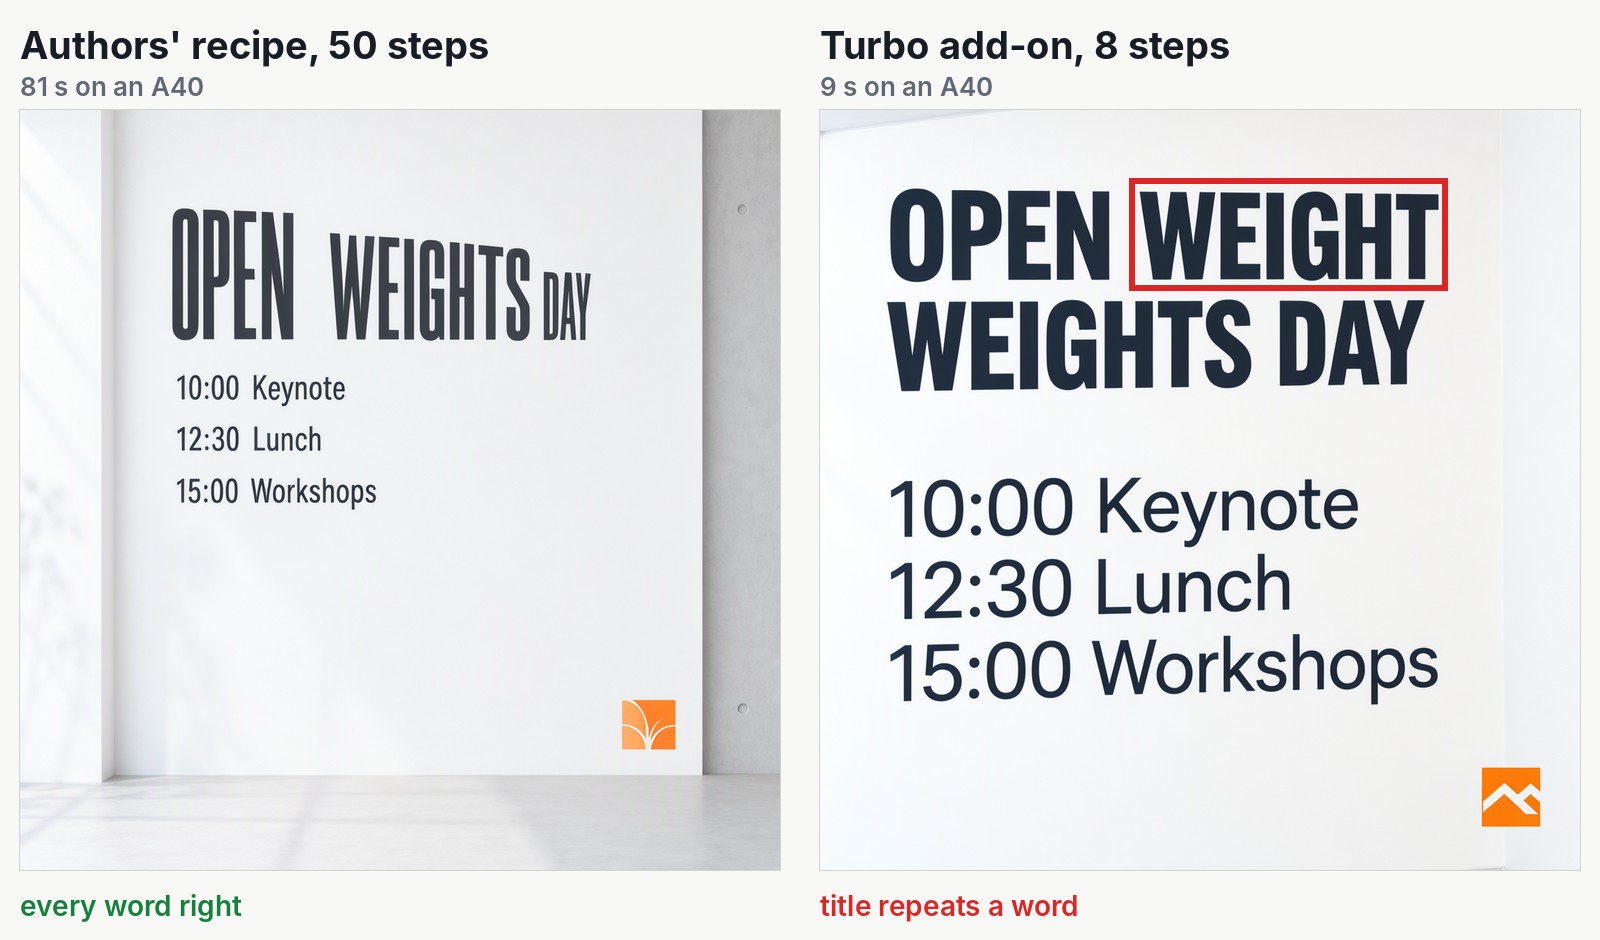
Mismo prompt, mismo punto de partida aleatorio, mismo modelo cargado. El recuadro rojo marca el único error: el título turbo repite una palabra.
Hecho para texto largo en imágenes, con un layout que controlas tú
MOSS-Image está hecho para texto largo. Una carta completa con precios, una infografía con una docena de etiquetas o el programa de un cartel es donde los modelos de imagen resbalan: Iris-3B, el último que probamos, se comió los puntos decimales de una carta de cuatro líneas. Los autores citan el renderizado de texto y los prompts largos como las principales características del modelo.
En su informe técnico, los autores construyeron su propia prueba de texto largo dentro de imágenes. Dicen que MOSS-Image escribe de media el 96,3 % del texto pedido, la mejor puntuación entre los modelos con ficheros públicos. Es su benchmark y solo leímos el resumen, así que tómalo como lo que afirman ellos. Nuestra pequeña prueba, más abajo, apunta en la misma dirección.
También puedes controlar el layout. En lugar de una frase, puedes enviar una descripción estructurada corta. Lleva un pie para toda la imagen y después una lista de elementos, cada uno con su texto y una caja en el lienzo donde debe ir. Los autores la califican de experimental. Probamos dos layouts, y los dos se respetaron.
Ejecutamos MOSS-Image-SFT, la versión con entrenamiento extra sobre ejemplos escogidos a mano.
OpenMOSS construyó el modelo, lodestones hizo el add-on turbo, y nosotros lo descubrimos en un vídeo de AI Search. Nuestra parte fue el código que lo sirve, el ejemplo del SDK, el despliegue en InferenceKey y las mediciones. Los créditos completos están en el apéndice.
La prueba: una A40, 22 imágenes, un intento cada una
Hicimos 22 imágenes, un intento por prompt, en una A40 y con una petición cada vez. Eso muestra cómo se comporta el modelo, no en qué puesto queda. No probamos el modelo Base ni varios usuarios a la vez. La lista completa está en el apéndice.
Alquilamos la A40, con 48 GB de memoria, en nuestro cloud. Ejecutamos el modelo a través de una copia privada de pruebas de InferenceKey, así que nuestro servicio de producción no se tocó en ningún momento. Elegimos una tarjeta de 48 GB porque solo los ficheros del modelo ocupan unos 27 GB, más el espacio para trabajar.
Una sola copia del modelo se quedó cargada y sirvió los dos modos. Cada petición decía cuál quería: la receta de los autores o el add-on turbo. Escribimos nuestros propios prompts: un cartel de conferencia, una infografía, una carta en pizarra y una nota manuscrita en chino sacada de los ejemplos de los autores. Después, dos layouts, una foto callejera y las manos de un pianista. Por la tarde volvimos a ejecutar el cartel con límites de memoria para ver en qué tarjeta tan pequeña podía vivir.
Resultados: 80 segundos para acertar todas las palabras, 9 segundos con palabras que revisar
La receta de los autores acertó todas las palabras en cada prueba de texto que le dimos. El add-on turbo fue unas nueve veces más rápido. Se equivocó en dos palabras del texto que le pedimos (una repetida, otra mal escrita) y se inventó letreros medio ilegibles en una foto callejera, así que no lo pondríamos en producción sin una revisión.
| Receta de los autores (50 pasos) | Add-on turbo (8 pasos) | |
|---|---|---|
| Tiempo por imagen de alrededor de un megapíxel | de 78 a 81 segundos | de 8,6 a 9,2 segundos |
| Texto | todo bien: cartel, infografía, carta, nota en chino | bien: carta, nota en chino, layouts. Mal: título del cartel, una etiqueta de la infografía, letreros en una foto |
Merece un párrafo explicar por qué la receta es lenta, porque también es la razón de que exista el turbo. El modelo parte de ruido aleatorio y lo va limpiando hasta obtener una imagen a lo largo de 50 pasos. En cada paso se ejecuta dos veces, una con tu prompt y otra sin ninguno, y se queda con la diferencia para afinar la imagen. Eso son unas 100 pasadas por imagen. El add-on de lodestones enseña al modelo a llegar en 8 pasadas, sin segunda ejecución. Es un fichero de 1,2 GB que se coloca encima del modelo original, y su autor lo etiqueta como trabajo en curso. Imagina la receta como la toma de estudio completa con todos los overdubs, y el turbo como la versión en directo de una sola toma: suele quedar bien, y de vez en cuando se cuela una nota falsa.
El cartel del principio es el caso más claro. La infografía es el otro tropiezo. La receta de los autores escribió todas las etiquetas, incluido el pie "Median time: 9 seconds". El turbo escribió "PNG bock" en lugar de "PNG back".
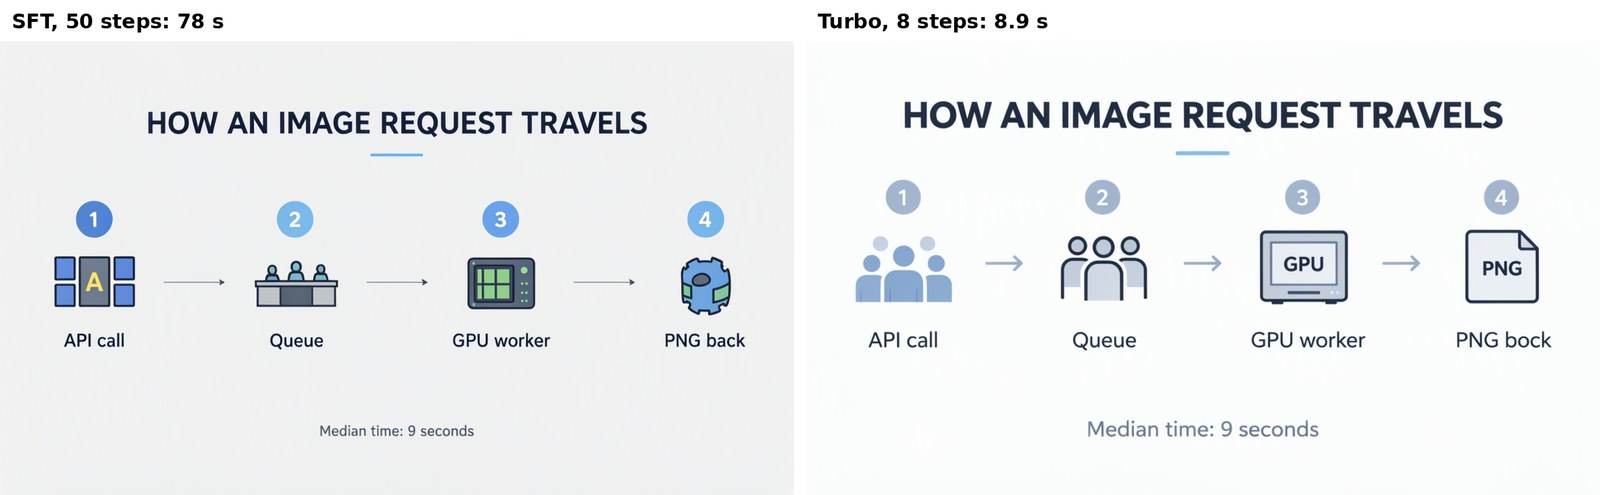
A la izquierda, la receta de los autores. A la derecha, el turbo con "PNG bock". En el panel de InferenceKey, con un prompt ligeramente distinto, el turbo acertó todas las etiquetas.
La carta en pizarra nos importa porque hizo tropezar a Iris-3B, el último modelo de imagen que probamos. Iris se comía los puntos decimales y repetía líneas. MOSS-Image escribió "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50" correctamente en los dos modos. La nota manuscrita en chino también salió exacta, las tres líneas, en los dos modos.
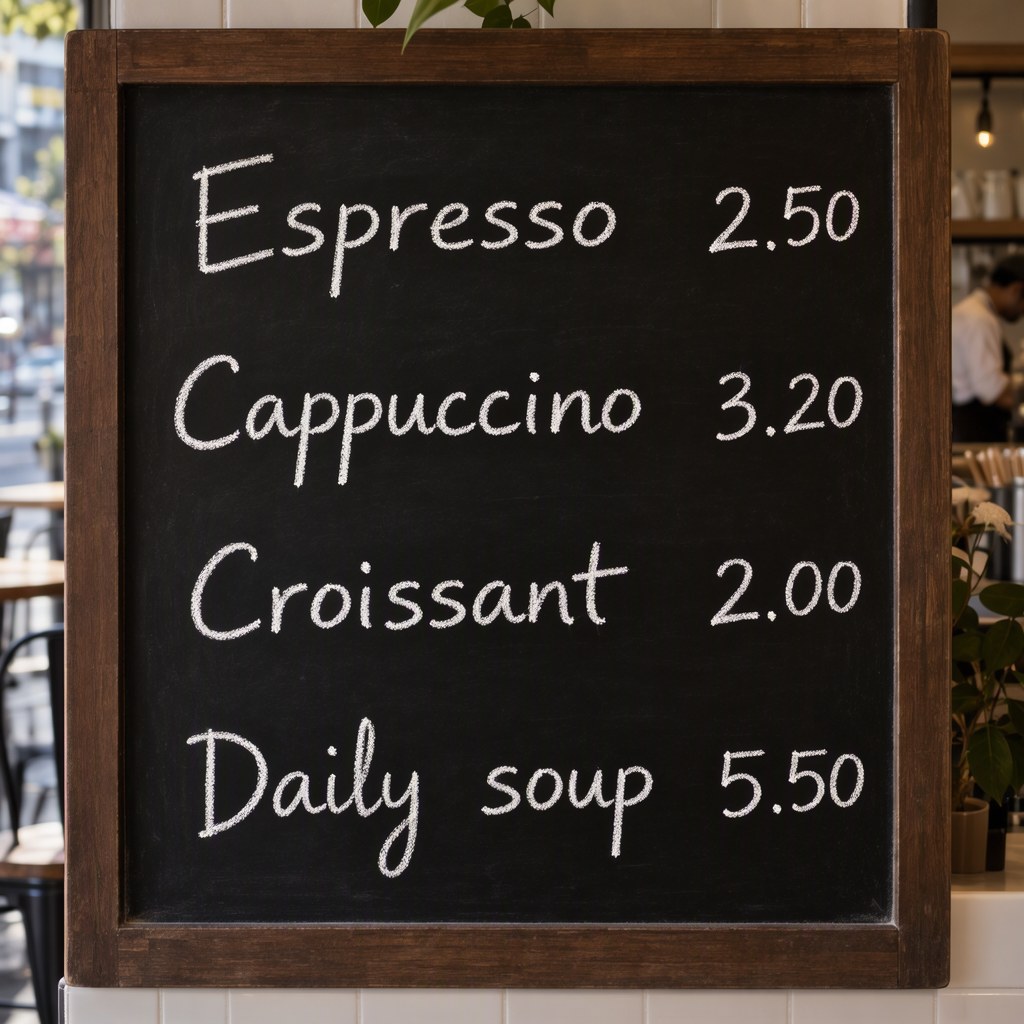
Cuatro precios, cuatro puntos decimales, ninguna línea repetida.
Los layouts y las manos aguantaron, el turbo forzado a 4 pasos no
Fuera del texto, el modelo hizo lo que le pedimos. Los dos layouts se respetaron y las manos salieron bien. Lo único que se rompió fue nuestro propio experimento con menos pasos.
Enviamos un cartel de café como layout con tres elementos: un título, un eslogan y una taza. Después lo enviamos otra vez con las cajas movidas de arriba abajo. Todo se fue a su nueva caja, bien escrito, en los dos modos.
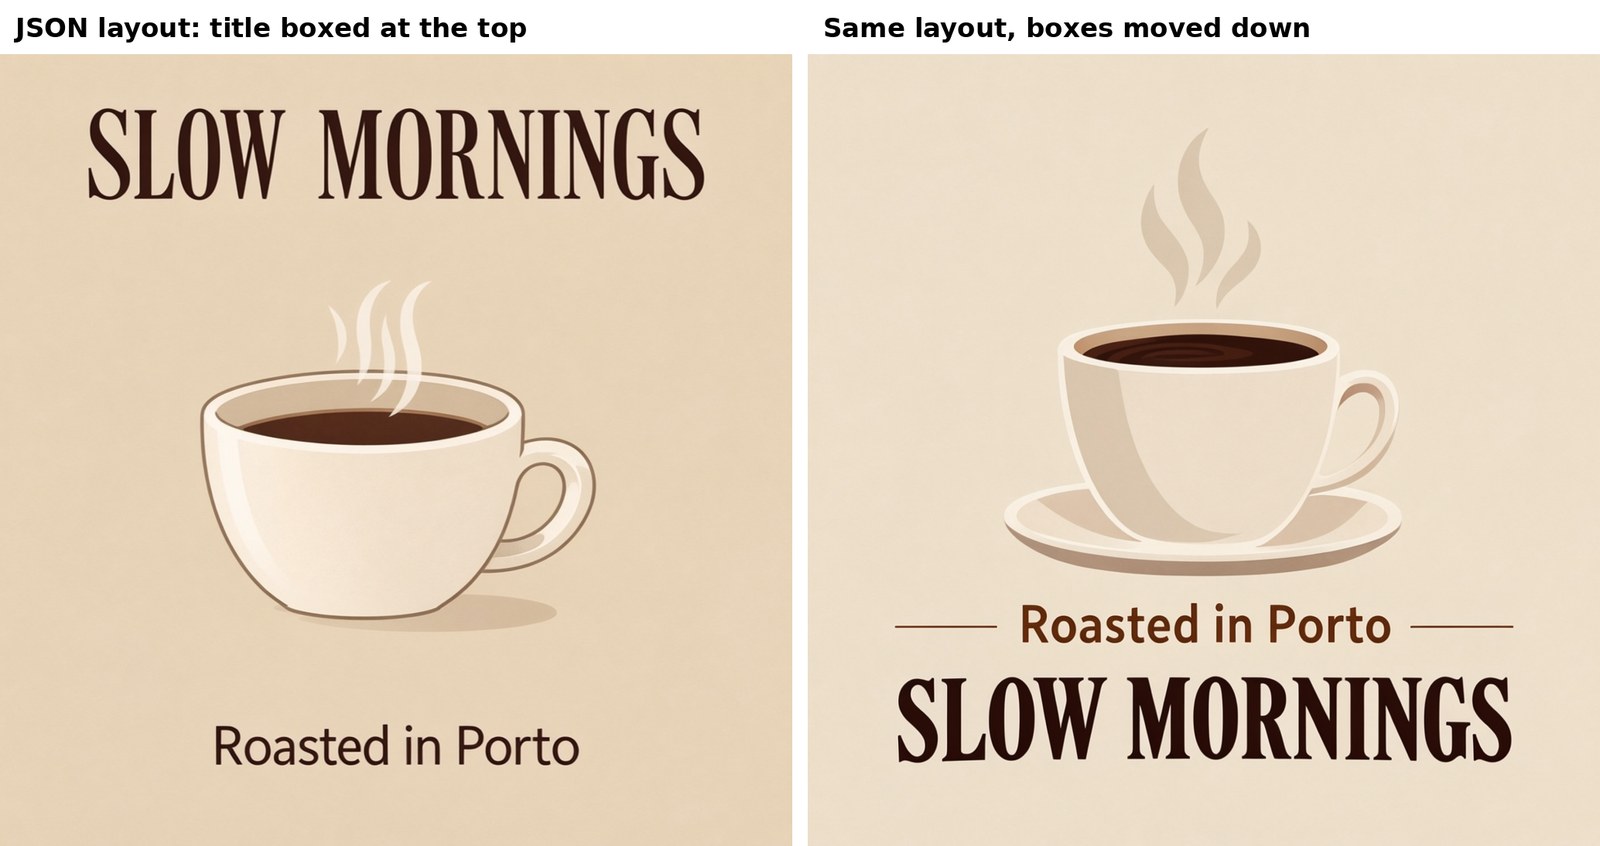
El mismo layout con las cajas movidas. Las palabras y la taza las siguieron.
Las manos son un punto débil clásico de los modelos de imagen. Pedimos las dos manos de un pianista, y la receta de los autores las dibujó bien, tocando, junto con su reflejo en la laca negra detrás de las teclas. La versión turbo del mismo prompt también dibujó dos manos creíbles.
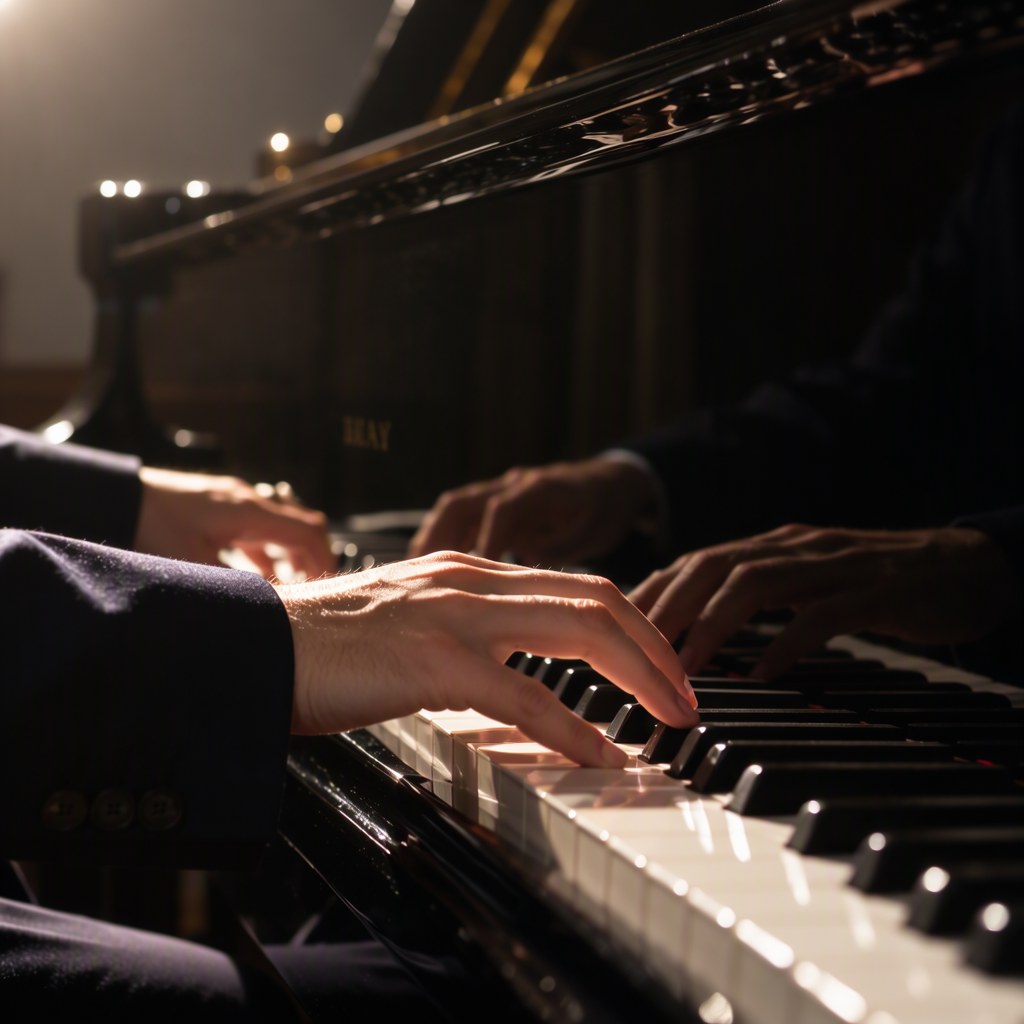
El par que se ve detrás de las teclas es su reflejo en la laca.
Después forzamos el add-on de 8 pasos a 4 pasos para ver qué pasaba. Tardó 5,2 segundos, y el texto se vino abajo: "OPEN WEIGHT DAYDY", y horas como "1(.C0". Eso es el add-on llevado por debajo de aquello para lo que se entrenó. No probamos add-ons hechos para 4 pasos.
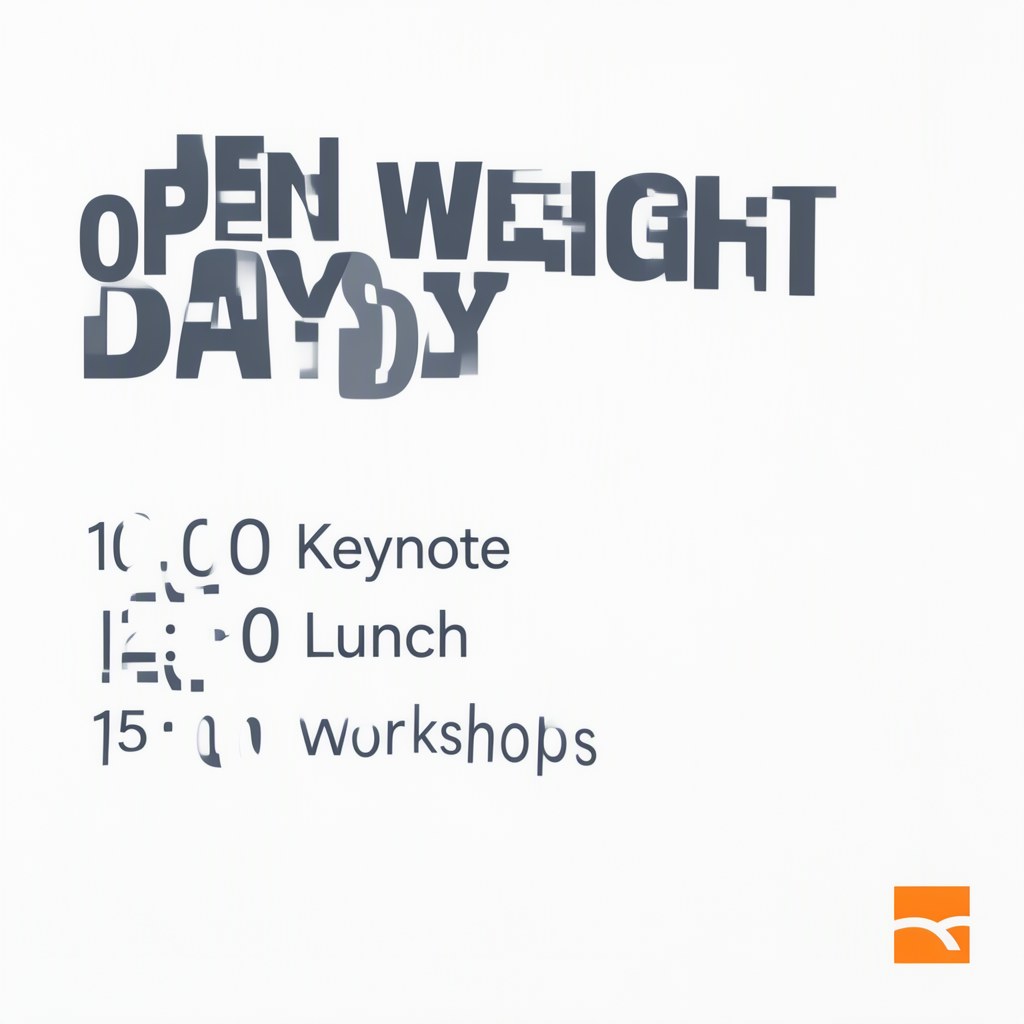
Add-on de ocho pasos, cuatro pasos: más rápido, y las palabras se rompen.
Qué GPU: limitada a 12 GB de memoria, la A40 dio los mismos píxeles a la mitad de velocidad
Seguramente no necesitas una tarjeta de 48 GB. Limitamos cuánta memoria podía usar el modelo en la A40, para que se comportara como una tarjeta de 16 GB o de 12 GB. Con los dos límites dibujó exactamente el mismo cartel. Con la receta de los autores, la configuración de 16 GB fue casi a toda velocidad y la de 12 GB, unas dos veces más lenta.
Solo emulamos el tamaño de la memoria, no la velocidad de una tarjeta doméstica ni su conexión con la memoria principal. Así que esas velocidades son relativas a una A40, no predicciones para una RTX 5080 o una RTX 3080 Ti. Que entre es la parte de la que nos fiamos, y todavía no está confirmada en una tarjeta real (ver los puntos flojos más abajo).
La razón de que entre es cómo está construido el modelo. Son dos modelos que trabajan en pareja: un lector y un pintor. El lector es el modelo de lenguaje de 17 GB que convierte tu prompt en una descripción. El pintor es el modelo de 10 GB que limpia el ruido hasta obtener una imagen a lo largo de todos esos pasos. El lector trabaja un momento al principio de cada imagen y después se queda parado. Así que puede esperar en la memoria principal del ordenador y pasar por la tarjeta trozo a trozo cuando llega un prompt. En la configuración de 12 GB, parte del pintor también espera ahí.
| Límite de memoria | Pico de memoria usada en la tarjeta | Receta de los autores | Turbo |
|---|---|---|---|
| Ninguno, todo en la tarjeta (A40 real, 48 GB) | unos 30 GB | 80 s | 9 s |
| 16 GB (emulado), lector en la memoria principal | unos 14 GB | 86 s | 13 s |
| 12 GB (emulado), lector y parte del pintor en la memoria principal | unos 11 GB | 160 s | 18 s |
Pico de memoria tal como lo informa la propia tarjeta. Las cifras exactas están en el apéndice.
Las salidas fueron, byte a byte, los mismos ficheros que en la ejecución con todo en la tarjeta. Así que el cartel de 12 GB tiene todas las palabras bien, y el cartel turbo conserva su palabra repetida. En una tarjeta de 16 GB va justo, con unos 2 GB de margen, menos si la tarjeta también mueve tu pantalla; en una de 24 GB va holgado. El ejemplo de nuestro SDK elige la configuración según la memoria libre de la tarjeta. Esa elección automática todavía no se ha ejecutado en una GPU: fijamos cada configuración a mano.
La otra cosa que hay que prever es la memoria principal del ordenador. En las configuraciones de 16 y 12 GB el proceso usó hasta 22 GB de memoria principal, así que dale a la máquina unos 32 GB.
En InferenceKey: una copia cargada sirvió los dos modos, lista en 63 segundos
La tarjeta es tuya por horas, y tú decides qué se ejecuta en ella. Una copia cargada de MOSS-Image sirvió la receta de los autores y el add-on turbo, petición a petición. Estaba lista para recibir peticiones 63 segundos después de pedirla, en una máquina alquilada que había tardado 78 segundos en arrancar y conectarse a InferenceKey.
MOSS-Image llega con su propio código de carga. Los backends listos de InferenceKey (el código que carga un modelo una vez y responde a las peticiones) no ejecutan el código propio de un modelo. Así que escribimos el nuestro, un pequeño fichero de Python. Al arrancar descarga una versión fija del modelo y del add-on, y después los carga como lo hacen los autores. De esos 63 segundos, la descarga de 28 GB se llevó 29 y la carga en la tarjeta, 9. Con una conexión más lenta, la descarga es la parte que crece.
Cada petición indica su modo, sft o turbo, y el prompt puede ser una frase o un layout. El backend habla el mismo formato de petición que la API de imágenes de OpenAI, así que el código existente puede llamarlo. El viaje a través de InferenceKey añadió alrededor de un segundo por imagen sobre el trabajo de la tarjeta.
¿Por qué no ComfyUI, la popular aplicación de escritorio para modelos de imagen? Ya ejecuta MOSS-Image, y para una persona haciendo imágenes en su mesa es el camino más corto. Nosotros queríamos una API a la que llamen otros programas, en una tarjeta que elegimos nosotros.
La grabación de 90 segundos de abajo muestra el panel de InferenceKey durante la prueba, con el modelo en la A40. Después, el probador de imágenes del panel hace la carta en pizarra en 9,7 segundos y una infografía apaisada en 6, con todos los precios y etiquetas bien. La empresa que aparece en el panel, Pixelforge Studio, es una cuenta de demo inventada.
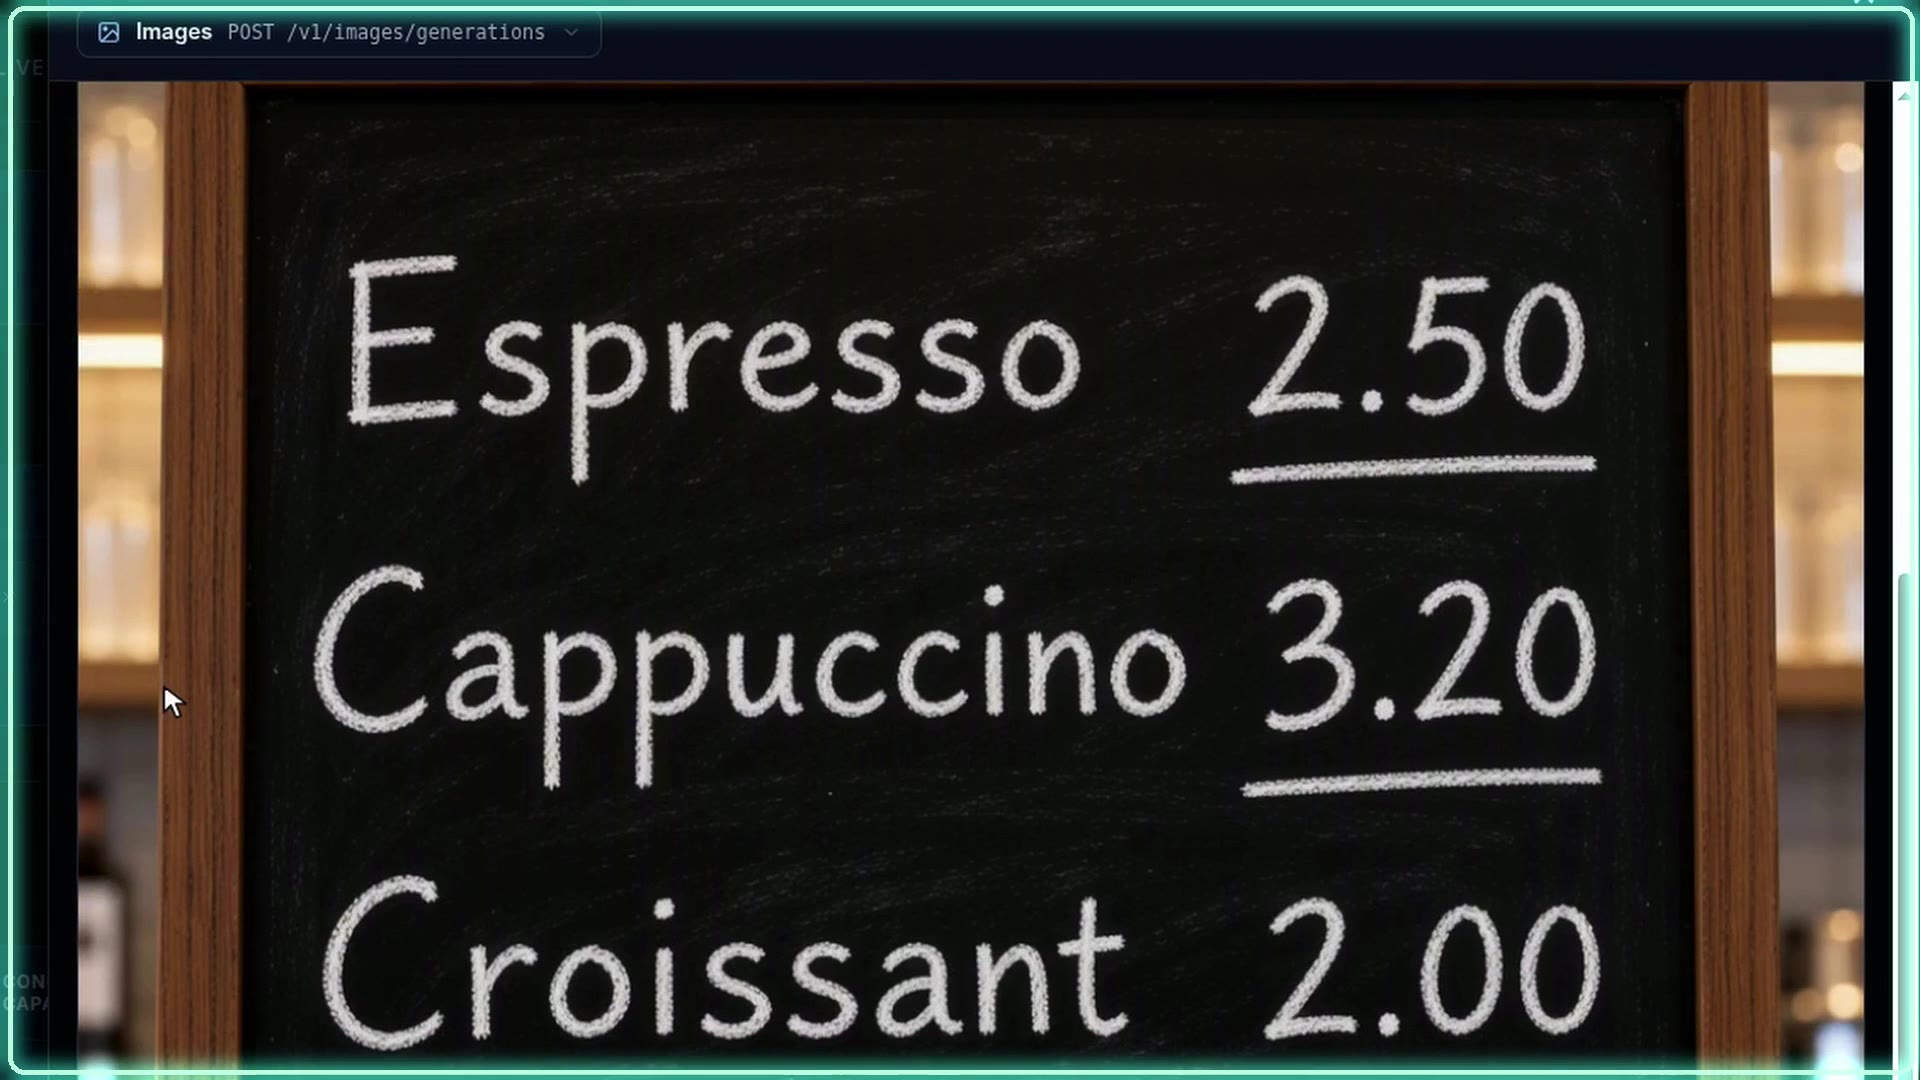
Haz clic para reproducir el MP4 (90 s, narrado).
Hay dos puntos flojos con los que tú también te toparías:
- Un límite de arranque fijo. Un backend que escribes tú tiene 300 segundos para estar listo. En una máquina que InferenceKey alquila por ti, no hay ningún ajuste para subirlo. Un enlace lento puede gastarlos solo en la descarga. Nosotros lo subimos a mano. Estado: abierto.
- Algunas tarjetas domésticas alquiladas no se pueden preparar. Nuestro cloud nos dio las máquinas RTX 3080 Ti, RTX 5080 y RTX 4090 que pedimos. Esas máquinas no tenían la conexión directa que InferenceKey usa para instalarse, así que las devolvió todas a los tres minutos. Estado: abierto, los alquileres todavía no se filtran por eso.
¿Deberías usarlo? La receta de 50 pasos cuando las palabras tienen que estar bien, el turbo para borradores
- Si el texto tiene que estar bien (una carta, un precio, una línea legal), usa la receta de 50 pasos de los autores, en una tarjeta de 48 GB o en la configuración de 16 GB. Fue el único modo sin tropiezos en nuestra prueba.
- Si necesitas velocidad (borradores, vistas previas, layouts sencillos), usa el add-on turbo y lee cada palabra antes de publicarlo.
- Si tu GPU es pequeña, prueba la configuración de 16 GB en una tarjeta de 16 o 24 GB con 32 GB de memoria principal.
- Si necesitas una licencia para un producto, la Apache 2.0 del modelo y del add-on te cubre.
Para hacer las mismas imágenes en tu propia máquina NVIDIA, publica el backend una vez con publish.py y ejecuta python main.py desde el ejemplo del SDK (los pasos están en el apéndice). Necesita la máquina conectada a un proyecto de InferenceKey, descarga unos 28 GB en el primer arranque y borra el despliegue al terminar; una máquina alquilada la tienes que parar tú. Nosotros lo ejecutamos en una tarjeta de 48 GB.
Para ingenieros
Modelo y ficheros
Card de SFT, card de Base, GitHub, informe técnico, arXiv:2610.23374. El README lo describe como "a 5B-parameter base DiT model with high-quality text rendering, layout generation, and efficient fine-tuning", con prompts de hasta 4K tokens. DiT de 42 capas (dim 3072, text_dim 4096, 128 canales latentes), encoder de texto Qwen3.5-9B (Qwen3_5Model, 32 capas, 3 de cada 4 con atención lineal), VAE pequeño de FLUX.2 (AutoencoderKLFlux2). Apache-2.0 en los dos repos de HF y en GitHub. Soporte desde el primer día en SGLang, vLLM-Omni y ComfyUI. Unas 1.200 estrellas en GitHub el 21 de octubre. Resumen del informe: cobertura media de texto en LLTB del 96,3 % (la mejor entre los modelos de pesos abiertos, según los autores). Solo leímos el resumen.
| Repo / fichero | Tamaño |
|---|---|
OpenMOSS-Team/MOSS-Image-SFT @ f972bd4b, total | 27.229.060.886 B |
| transformer, 3 shards, bf16 | unos 10,16 GB |
| text_encoder, 4 shards | unos 16,79 GB |
| VAE | 249,5 MB |
lodestones 8-step DMD lora_latest.safetensors @ f95df83b | 1.189.176.800 B (fp32, rank 128 / alpha 128) |
Muestreo
Receta de la card: Euler con flow matching, 50 pasos, CFG 3, shift 5, prompt negativo vacío, rama negativa con uncond_skip_layers=[22], dos forwards del transformer por paso. Requiere torch >= 2.9, diffusers >= 0.38, transformers >= 5.3. El ancho y el alto tienen que ser múltiplos de 16. Guía de usuario: se recomiendan de 1 a 2 MP, y se puede de 0,25 a 4 MP. Turbo: lora_latest.safetensors aplicado sin fusionar a intensidad 0,7, 8 pasos, CFG 1 (sin rama negativa, así que un prompt negativo se ignora). La card de la LoRA lo llama una destilación en curso de 50 pasos con CFG 3 a 8 evaluaciones de la red y dice que la delta es menor que el paso de redondeo de bf16, de ahí que no se fusione. Nuestra aplicación sin fusionar sigue el Space de demo de la LoRA hugging-apps/moss-image-8-step-dmd.
Prompt de layout (README y guía de usuario, "Layout Prompts (Experimental)"): summary {meta, canvas, caption} más items [{label, caption, text?, bbox}], "bbox_format": "yxyx", "bbox_coord_space": "abs_centralized" (píxeles desde el centro del lienzo). Pásalo por json.dumps(layout, ensure_ascii=False).
Nuestro montaje
NVIDIA A40 48 GB en nuestro cloud (46.068 MiB), nivel secure, CA-MTL-1, driver 595.91.07, imagen runpod/pytorch:1.0.7-cu1300-torch291-ubuntu2404-cluster. L40 nivel community devolvió 409 (sin stock). Worker arrancado por un manager local de InferenceKey a través de túneles HTTP y TCP, 78 s desde el POST del pod. Venv del backend: Python 3.12.3, torch 2.14.1+cu130, diffusers 0.38.0, transformers 5.3.0, instalados con uv. Producción sin tocar.
Despliegue paso a paso
El ejemplo del SDK (commit a69c6e5 en main). Necesitas un token del SDK (ik_sdk_...), una API key (ik_live_...), el slug de un proyecto, el IK_WORKER_ID de un worker NVIDIA registrado (driver CUDA 13, 580+), y para publish.py un tenant id y un token de sesión del panel (o sube dist/*.tar.gz en el panel). Cuenta con unos 32 GB de RAM del sistema si la tarjeta tiene menos de 40 GB.
cp .env.example .env        # SDK token, API key, project, worker id, tenant id, dashboard session token
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # once: packages backend.py and registers it as "moss-image-text2image"
python main.py              # deploy, wait until ready, make 3 pictures, delete the workload
main.py llama a ensure() con ExecutionPolicy.FIXED y 1 réplica, wait_until_ready(timeout=3600), envía tres POST a /v1/images/generations (cartel SFT, cartel turbo, el layout EXPLORE del README), escribe los PNG en ./outputs y borra el workload al salir salvo con IK_KEEP_ALIVE=1. Borrar el workload no para un pod alquilado. El primer arranque descarga unos 28 GB, y el timeout de arranque del custom backend del worker es de 300 s por defecto. .env.example todavía menciona un worker de 40 GB o más. La sección del README sobre tarjetas más pequeñas es la guía actual.
Una petición turbo (enviada a nuestro manager local; el servicio alojado acepta la misma forma, aunque no lo llamamos):
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/moss-image-sft/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"prompt": "A clean conference poster on a white wall. Large bold title: OPEN WEIGHTS DAY", "size": "1024x1024", "seed": 42, "mode": "turbo"}'
Backend
backend.py, slug moss-image-text2image, versión 0.3.1, revisión fijada f972bd4b4b9e3852133cc5da954d87bc32cd8fb9. setup() ejecuta snapshot_download de la revisión fijada (saltándose assets/), hf_hub_download de la LoRA, DiffusionPipeline.from_pretrained(local, custom_pipeline="pipeline_moss_image", trust_remote_code=True, torch_dtype={"default": bf16, "vae": fp32}), y envuelve las 252 proyecciones de los bloques (42 bloques x q, k, v, o, ffn_up_gate, ffn_down) con un módulo LoRA sin fusionar. process() acepta entrada nativa o el cuerpo de imágenes de OpenAI, una cadena o un objeto de layout, mode sft (50, CFG 3, skip [22]) o turbo (8, CFG 1, LoRA 0.7), genera el ruido en la CPU a partir de la semilla, serializa la generación con un lock (la intensidad de la LoRA es estado compartido) y devuelve {data: [{b64_json}]} más seconds y vram_peak_gib. La v0.2.0 añade num_inference_steps como alias de steps, y manda a turbo las peticiones sin mode + guidance_scale 1 + pasos <= 16. La v0.3 añade los modos de memoria gpu, component, lowvram, minimal y auto (umbrales _GPU_MIN_GIB=33.0, _LOWVRAM_MIN_GIB=14.5), y las variables de entorno MOSS_MEMORY_MODE, MOSS_VRAM_LIMIT_GIB, MOSS_ACTIVATION_RESERVE_GIB, MOSS_TURBO_LORA. La v0.3.1 (auto con 0,5 GiB de margen) nunca se ejecutó en una GPU: las ejecuciones medidas usaron la v0.3.0 con cada modo forzado por variable de entorno.
Tiempo hasta estar listo
Mañana: ensure() 05:51:47Z, el SDK dice "ready after 63 s": venv 24 s, descarga de 28,4 GB en 28,6 s (alrededor de 1 GB/s), carga 8,5 s, custom backend ready on port 18000 05:52:52Z. Medido en un worker cuyo timeout de arranque se había subido a mano a 2400 s. Reciclado en caliente al republicar: 16 s. Redespliegue por la tarde en una segunda A40: ensure 09:59:45Z, listo tras 60 s, una llamada al cartel turbo con 11,198 s de GPU, 14,0 s de ida y vuelta, pico asignado de 28,72 GiB.
Mediciones
Tiempo de GPU medido en el backend con cuda.synchronize(), una petición cada vez. Ida y vuelta = del cliente HTTP al manager local.
| Caso | Modo / pasos | Tamaño | GPU s | Ida y vuelta s |
|---|---|---|---|---|
| cartel (primera llamada) | SFT 50 | 1024x1024 | 81,06 | 84,2 |
| cartel | turbo 8 | 1024x1024 | 9,02 | 9,8 |
| layout EXPLORE | SFT 50 | 1024x1024 | 79,88 | 80,6 |
| nota en chino | SFT 50 / turbo 8 | 1024x1024 | 78,76 / 8,90 | 79,82 / 9,79 |
| infografía | SFT 50 / turbo 8 | 1344x768 | 78,11 / 8,85 | 78,88 / 9,46 |
| mercado de Lisboa | SFT 50 / turbo 8 | 1344x768 | 77,71 / 8,62 | 79,23 / 9,57 |
| carta en pizarra | SFT 50 / turbo 8 | 1024x1024 | 79,10 / 8,78 | 80,49 / 9,83 |
| manos del pianista | SFT 50 / turbo 8 | 1024x1024 | 78,83 / 8,87 | 79,94 / 9,70 |
| layout del café, cajas arriba | SFT 50 / turbo 8 | 1024x1024 | 79,98 / 9,21 | 81,20 / 9,77 |
| layout del café, cajas abajo | SFT 50 / turbo 8 | 1024x1024 | 80,08 / 8,94 | 81,18 / 9,52 |
| cartel | turbo 4 | 1024x1024 | 5,22 | 5,97 |
| mercado de Lisboa | turbo 8 | 1440x1440 | 17,30 | 19,47 |
| probador del panel, pizarra / infografía | turbo 8 (v0.2.0) | 1024x1024 / 1024x576 | 9,68 / 6,03 |
SFT de 77,7 a 81,1 s en 9 imágenes (unos 1,6 s por paso, dos forwards). Turbo de 8 pasos de 8,6 a 9,2 s en 9 imágenes de alrededor de 1 MP, unas 8,9 veces más rápido. Sobrecarga de la plataforma de 0,6 a 3,1 s, mediana de alrededor de 1,1 s (3,1 s en la primerísima llamada).
VRAM y consumo (nvidia-smi cada 1 s, 1.342 muestras): 25,9 GiB asignados tras la carga. Pico asignado de 28,72 GiB a 1024x1024, 28,67 GiB a 1344x768, 31,47 GiB a 1440x1440. Tarjeta: 30.361 MiB durante las ejecuciones de 1 MP, pico de 33.741 MiB (turbo a 1440x1440) de 46.068 MiB. Utilización del 100 %, pico de consumo de la placa de 302,6 W frente a un límite de 300 W.
Texto, leído a mano en cada imagen. SFT: cartel "OPEN WEIGHTS DAY / 10:00 Keynote / 12:30 Lunch / 15:00 Workshops", infografía incluido "Median time: 9 seconds", pizarra "Espresso 2.50 / Cappuccino 3.20 / Croissant 2.00 / Daily soup 5.50", nota en chino (记得买牛奶和鸡蛋!/ 牛奶两盒,鸡蛋一打。/ 顺便带一袋面包。), todo bien. Turbo: pizarra, nota en chino y los dos layouts bien. Errores: título del cartel "OPEN WEIGHT / WEIGHTS DAY", infografía "PNG bock", texto de los letreros del mercado de Lisboa en parte ilegible. Turbo con 4 pasos: "OPEN WEIGHT DAYDY", horas como "1(.C0".
Escalera completa de VRAM (emulada)
Por la tarde, segundo pod con A40. El límite es torch.cuda.set_per_process_memory_fraction (variable de entorno MOSS_VRAM_LIMIT_GIB). El mismo cartel, semilla 42, 1024x1024, el mismo backend.py llamado dentro del proceso, un proceso nuevo por peldaño, nvidia-smi muestreado cada 500 ms. Modos: gpu lo mantiene todo residente. component es enable_model_cpu_offload() (el modo "Component" de los autores). lowvram mantiene el encoder de texto bajo accelerate.cpu_offload, transmitido capa a capa en cada prompt, con DiT y VAE residentes. minimal es lowvram más que solo se quedan residentes los bloques del DiT que caben, el resto bajo cpu_offload, y tiling del VAE.
| Emula | Modo / límite | Pico nvidia-smi (reservado por torch) | SFT 50 s | Turbo 8 s | RSS máx. |
|---|---|---|---|---|---|
| 48 GB (A40 real) | gpu, ninguno | 30.359 MiB (29,32 GiB) | 79,55 | 8,82 | 7,3 GB |
| 24 GB | component, 23,0 GiB | 16.403 MiB (15,70 GiB) | 104,46 | 41,19 | 31,5 GB |
| 16 GB | lowvram, 15,0 GiB | 14.433 MiB (13,77 GiB) | 86,17 | 13,17 | 16,8 GB |
| 12 GB | minimal, 11,0 GiB, 31/42 bloques residentes | 11.427 MiB (10,83 GiB) | 160,38 | 17,84 | 21,6 GB |
Unidades: la tabla del relato divide los picos en MiB de nvidia-smi entre 1.024 (29,6, 14,1 y 11,2 GiB), que incluyen el contexto de CUDA que el límite de torch no cuenta. En unidades decimales, 14.433 MiB son 15,1 GB y 11.427 MiB son 12,0 GB. El peldaño de 16 GB deja unos 2 GiB de margen en una tarjeta de 16 GiB, antes de que cualquier otra cosa (un escritorio, otro proceso) se lleve su parte. Sin probar en hardware real.
Los 8 PNG son idénticos byte a byte a los poster-sft.png y poster-turbo.png de la mañana (comprobado con cmp): el ruido se genera en la CPU a partir de la semilla y el offload solo mueve pesos. Lectura: lowvram cuesta un +8 % con 50 pasos (86,2 frente a 79,6 s) y un +49 % en turbo, porque el encoder de 16,8 GB se transmite por PCIe en cada prompt (dos veces por imagen SFT, una por imagen turbo). minimal es 2,0 veces más lento en los dos modos: 11 de los 42 bloques se transmiten en cada uno de los 100 forwards. component entra en 24 GB pero no en 16 GB y es más lento que lowvram, así que auto nunca lo elige, y lowvram es también la mejor opción en una tarjeta de 24 GB.
Nuestro primer intento de escalera falló al cargar en todos los peldaños con límite con ValueError: Expected a torch.device with a specified index or an integer, but got:cuda. Era un bug nuestro (set_per_process_memory_fraction necesita un índice de dispositivo). Lo arreglamos y lo volvimos a ejecutar.
Problemas pendientes y estado
- Timeout de arranque del custom backend (
INFERENCEKEY_CUSTOM_BACKEND_READY_TIMEOUT_SECS): por defecto son 300 s, y el bootstrap de las GPU de nuestro cloud escribe un manifiesto fijo sin campo para variables de entorno extra. Añadimos=2400a/opt/inferencekey/worker.env.manifestpor SSH y relanzamos el worker. La preparación tardó 37 s, así que en este host habría bastado el valor por defecto. A 100 MB/s, solo la descarga lleva unos 280 s. Abierto. - Ninguna configuración por workload llega a un custom backend, así que SFT frente a turbo es un campo de la petición (
mode). Aquí es intencionado: una copia cargada sirve las dos, y dos copias no entrarían en 48 GB. - El probador de imágenes del panel solo envía
prompt, size, n, num_inference_steps, guidance_scale, response_format(por defecto 20 pasos / 4,5 de guidance) y ningún modo. Arreglado en el backend v0.2.0 (que además cambia a turbo cuando el probador pide una imagen rápida), verificado tras el reciclado en caliente que reinició el modelo en ejecución en 16 s (un cuerpo al estilo del panel se ejecutó como turbo, 6,81 s de GPU a 1024x576). - Pods domésticos sin SSH directo. Se crearon a través del manager pods RTX 5080 16 GB community, RTX 4090 24 GB secure y RTX 3080 Ti 12 GB community, y cada uno falló a los 180 s con
ssh.direct is null, no port 22 mapping. RTX 3060, 3080 Ti, 4070 Ti, 4080, 4080 SUPER, 5080 secure y A4000 no tenían stock (409). RTX 4060 Ti devolvió 502 unknown GPU type. Elcreate_pod_bodydel manager no pide una IP pública. Abierto. - Cosmético: la columna Access del panel muestra "No access" con una clave comodín que funciona. Avisos inofensivos en el log: la vía rápida del encoder Qwen3.5 no está instalada (cae a PyTorch), atributos de la configuración del scheduler "will be ignored", un aviso
Expected types for transformerque nombra la misma clase.
Alternativas que no probamos
- lodestones/Kromoss: Base entrenado más a fondo con 704.000 imágenes, un sustituto directo de SFT, con sus propias LoRAs de 8 pasos. Su card dice que con 4 pasos también funciona.
- darask0/MOSS-Image_4-step_adapter_lora: un adaptador de 4 pasos que continúa el de 8 pasos de lodestones.
- akhaliq/MOSS-Image-SFT-4-steps: adaptador de 4 pasos con un nivel de 3 pasos, con arranque en caliente desde el de 8 pasos de lodestones.
- Reempaquetados de Comfy-Org/MOSS-Image: DiT int8 (5,4 GB) más encoder de texto w4a8 (7,3 GB), unos 13 GB de ficheros. Comfy-Org no indica tamaño de GPU. Nuestro offload en bf16 ya entraba en el límite de 12 GB con la salida idéntica, así que no los necesitamos. No sabemos qué efecto tienen en la ortografía.
Los cuatro tienen licencia Apache 2.0, según sus cards. Las cifras de velocidad y calidad de esas cards son afirmaciones de sus autores.
Límites
- Un modelo de GPU (A40), una semilla por prompt, 22 imágenes, prompts nuestros. Comportamiento, no calidad de benchmark. Los juicios de calidad son nuestros, tras leer cada imagen.
- Los resultados de 24, 16 y 12 GB son límites de memoria en una A40, con un prompt, no tarjetas reales.
- Una petición cada vez. Sin probar:
n> 1, el modelo Base, ComfyUI, concurrencia, ficheros cuantizados, Kromoss, adaptadores dedicados de 4 o 3 pasos, límites de memoria por debajo de 11 GiB, tamaños por encima de 1 MP en los modos con offload. Nuestro resultado de 4 pasos es la LoRA de 8 pasos ejecutada con 4 pasos.
Créditos
OpenMOSS en MOSI.AI: el modelo, las versiones Base y SFT, el pipeline, la guía de usuario, el formato de layout y el informe. Equipo de Qwen: Qwen3.5-9B. Black Forest Labs: el VAE pequeño de FLUX.2. El equipo de ComfyUI: el soporte nativo, PR #17095. Comfy-Org: los reempaquetados cuantizados. lodestones: la LoRA de 8 pasos que ejecutamos y Kromoss. darask0 y akhaliq: los adaptadores de 4 y 3 pasos. La aplicación de la LoRA sigue el Space hugging-apps/moss-image-8-step-dmd. AI Search es donde descubrimos el modelo.
Fuentes: card de MOSS-Image-SFT, card de MOSS-Image-Base, repo de GitHub, guía de usuario, informe técnico, lodestones 8-step DMD, reempaquetado de Comfy-Org, Kromoss, ejemplo del SDK.