400, 12.365 o 274 dólares: lo que cuesta un mes de agente de código, y cuándo compensa montar DeepInfer
Un desarrollador, 26.200 millones de tokens en 30 días, tres facturas. Y cuántas personas así necesita una empresa para que le compense su propio DeepInfer.
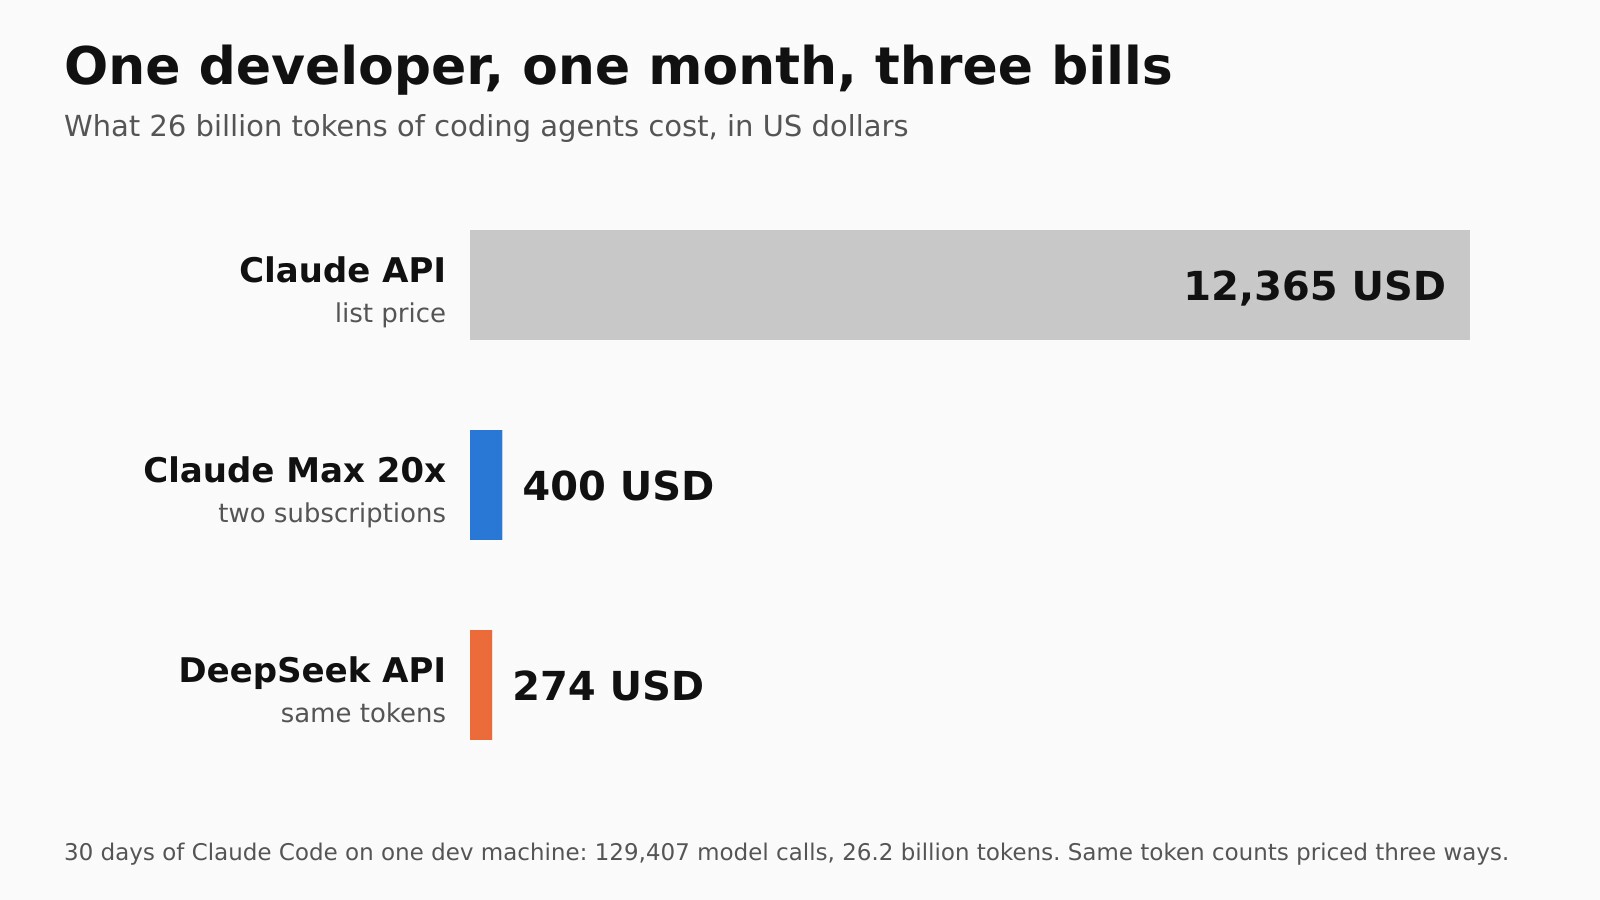
Uno de nuestros desarrolladores pagó 400 dólares el mes pasado por su agente de código. Ese mismo trabajo, a precio de tarifa de la API de Claude, sale por 12.365 dólares. En la API de DeepSeek habrían sido 274.
Las tres cifras salen de su propio ordenador. Cogimos sus registros de Claude Code del 21 de septiembre al 20 de octubre y contamos cada llamada que el agente hizo al modelo: 129.407 llamadas y 26.200 millones de tokens (un token es un trozo de palabra). Después pusimos precio a ese mismo mes de tres maneras.
Este mes DeepSeek ha publicado como código abierto DeepInfer, el motor con el que sirve su propio modelo. Eso lleva a la pregunta que haría cualquier CTO: si toda mi empresa trabajara así, ¿a partir de cuántas personas compensa montar ese motor en máquinas propias en vez de pagar a DeepSeek por token?
La respuesta depende menos de las máquinas de lo que parece. Un agente de código se pasa el día releyendo lo mismo, y quien tiene dónde guardar lo ya leído paga mucho menos. Esa pieza es justo la que DeepInfer no trae.
| Lo que pagó (dos suscripciones Claude Max 20x) | 400 USD |
| Los mismos tokens a precio de tarifa de la API de Claude | 12.365 USD |
| Los mismos tokens en la API de DeepSeek | 274 USD |
| Tokens que lee el agente por cada uno que escribe | unos 303 |
| Un servidor alquilado de 8 GPUs gana a la API desde | unas 262 personas como él, y solo si rinde como en DeepSeek |
| Un rack propio de 72 GPUs gana a la API desde | unas 465 personas como él |
| Con 1.000 personas, coste por persona y mes | 138 USD con rack propio, 274 en la API |
Un agente de código sobre todo lee
Cada vez que el agente da un paso (abrir un fichero, pasar un test, cambiar una línea), le manda al modelo la conversación entera otra vez: las instrucciones, los ficheros que ha abierto y todo lo dicho hasta ese momento. Una llamada típica llevaba unos 138.000 tokens, más o menos un libro de 400 páginas. El modelo escribe unos cientos de tokens y vuelta a empezar. En un mes, eso son unos 190.000 libros leídos.
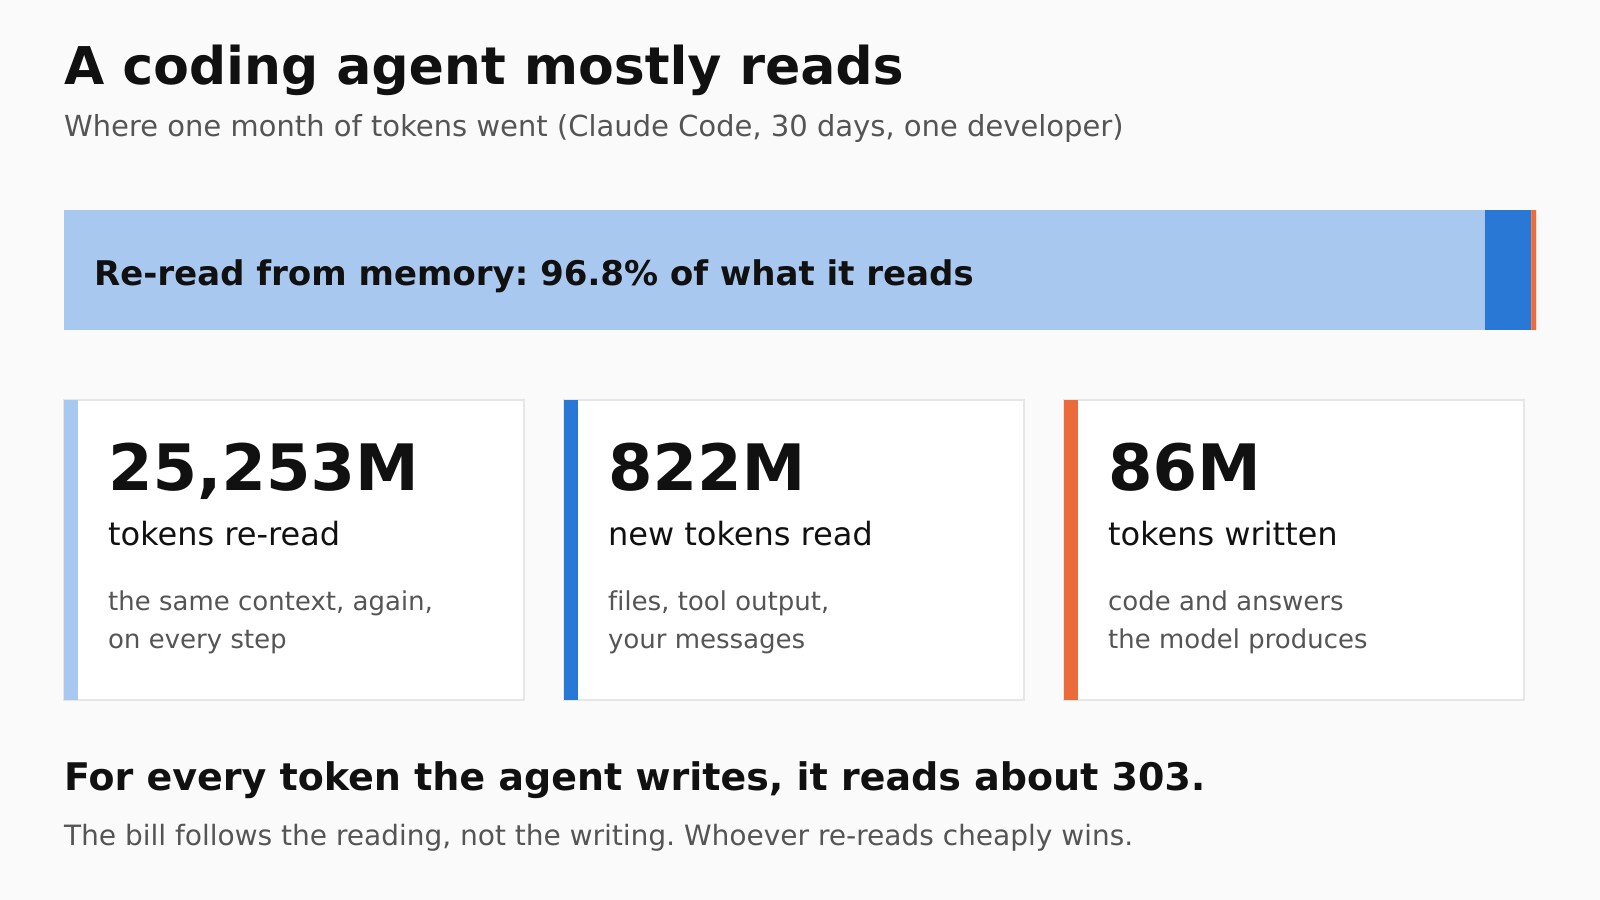
De los 26.200 millones de tokens del mes, 25.253 millones fueron el mismo contexto leído otra vez. El material nuevo (ficheros, resultados de las herramientas y los mensajes del desarrollador) fueron 822 millones. Lo que el modelo escribió de verdad, el código y las respuestas, fueron 86 millones. Por cada token escrito, el agente leyó unos 303.
Los proveedores lo saben y guardan el contexto reciente para que releer salga barato. Imagina una estantería junto al modelo: lo que ya ha leído se queda ahí y la siguiente vez lo coge hecho. En Claude, releer de la estantería cuesta la vigésima parte que leer algo nuevo, y el 96,8 % de lo que leyó este agente salió de ahí. Sin estantería, el mismo mes en la API de Claude habría costado más de 100.000 dólares, unas nueve veces más.
Tres facturas para el mismo trabajo
La suscripción es, con diferencia, lo más barato frente al precio de tarifa de Claude, pero tiene techo. Un plan Max 20x cuesta 200 dólares al mes según la página de precios de Claude, con un límite de uso en cada ventana de cinco horas, y él paga dos. Para una persona funciona. No es un plan pensado para una empresa entera.
El precio de tarifa es lo que cuestan esos tokens a través de la API de Claude, que es como suele pagar una empresa cuando los planes individuales se quedan cortos. Es 31 veces lo que él pagó, y casi nada es por escribir. De los 10.348 dólares que se fueron en Opus 5.5, el código y las respuestas costaron unos 1.600. Unos 4.500 fueron por releer la estantería y unos 4.250 por colocar en ella el material nuevo la primera vez.
La API de DeepSeek, con los mismos tokens y a sus precios publicados, sale por 274 dólares, 45 veces menos que la API de Claude. Casi toda la diferencia está en releer: un millón de tokens releídos cuesta un tercio de céntimo en DeepSeek en horario valle y 20 céntimos en Claude Opus 5.5.
Es una comparación de precios, nada más. DeepSeek-V4.1-Flash no es Opus, parte el texto en tokens de otra forma (no hemos medido cuánto cambia) y no hemos repetido el mes con él. Un modelo distinto puede necesitar más o menos vueltas para acabar la misma tarea.
¿Programa bien el modelo barato?
En la prueba que más se parece a este trabajo, sí. LiveBench es una clasificación independiente que cambia sus preguntas con frecuencia para que los modelos no se las aprendan. En su categoría de programación con agentes, donde el modelo saca adelante una tarea de código real paso a paso, DeepSeek-V4.1-Flash quedó primero de 69 modelos cuando lo miramos el 10 de octubre.
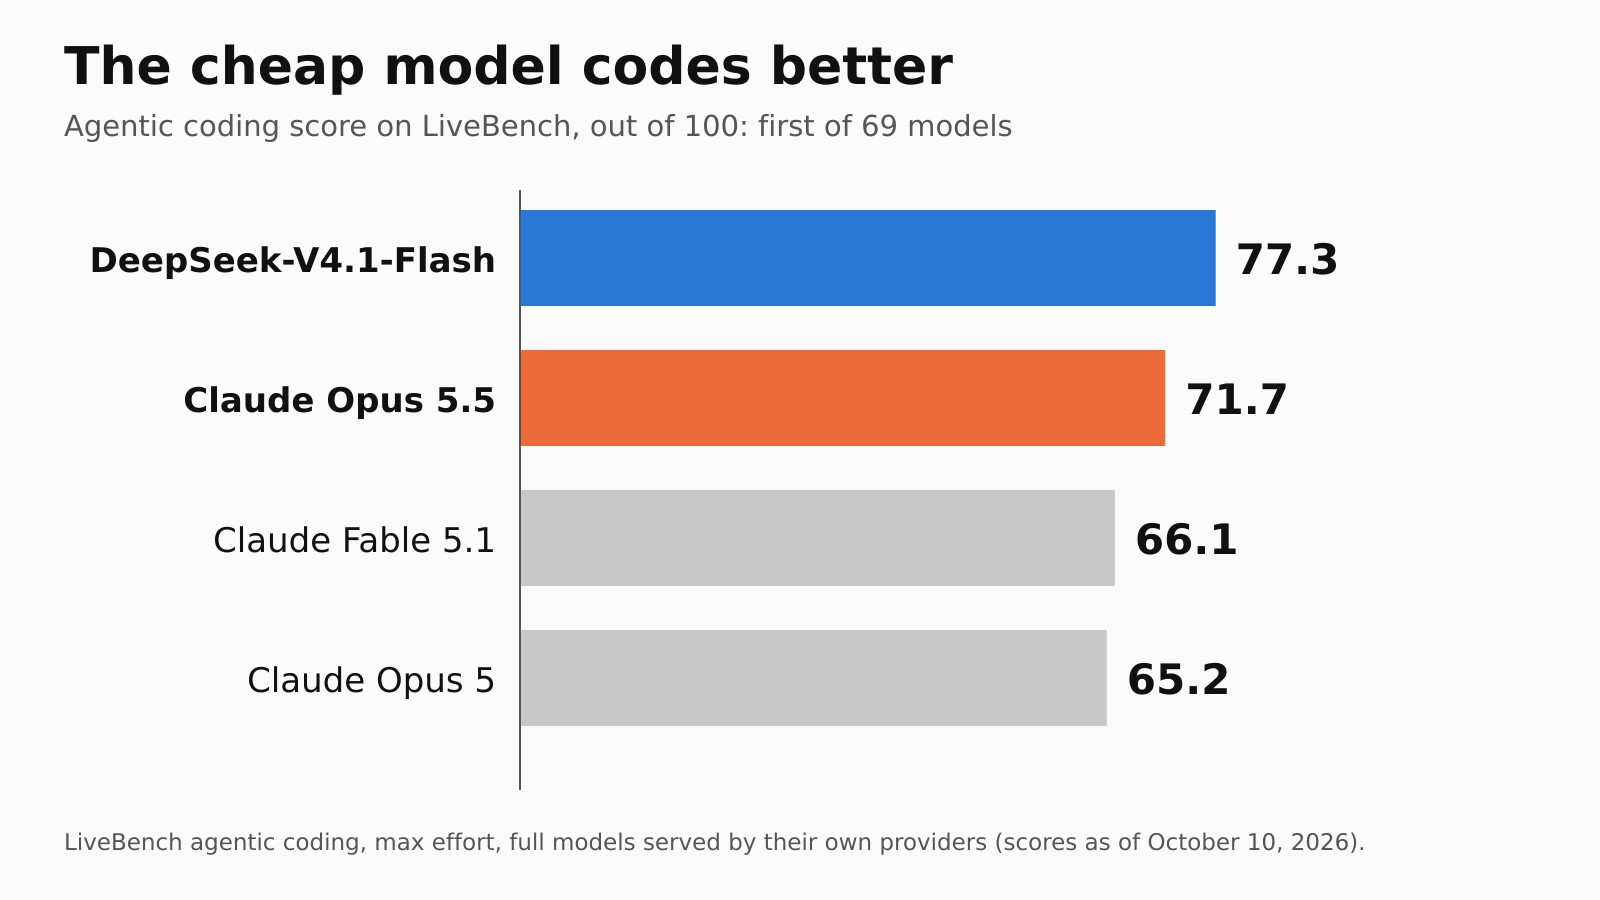
Es la misma tabla que usamos cuando montamos este modelo en dos tarjetas gráficas. En una nota más amplia, el Intelligence Index de Artificial Analysis, que mezcla muchos tipos de pruebas, Opus 5.5 va claramente por delante: 58 frente a 39 el 16 de octubre. Flash programa muy bien por una fracción del precio y Opus es más fuerte en conjunto. Cuál te conviene depende de a qué dediquen el día tus agentes.
Cómo sirve DeepSeek a DeepSeek
DeepSeek contó cómo funciona su servicio en un artículo largo en Zhihu, una web china de preguntas y respuestas. Se entiende bien como un edificio con una puerta, dos salas y la estantería de antes.
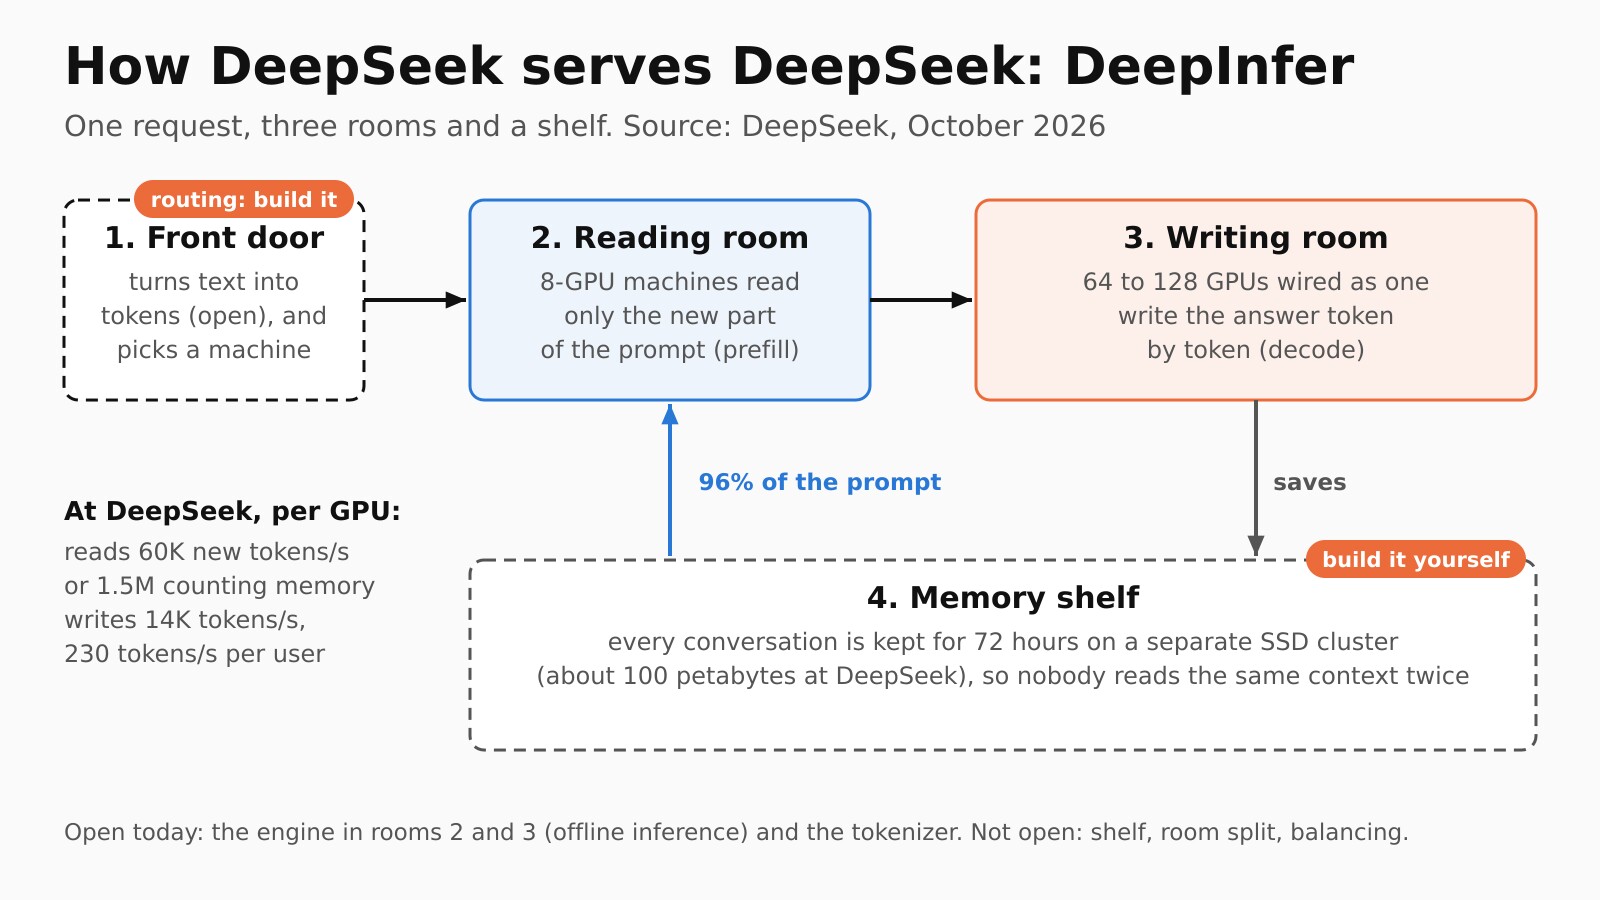
La petición entra por la puerta, que la convierte en tokens y la manda a una máquina libre. En la sala de lectura, servidores de 8 GPUs leen solo la parte nueva del prompt, porque el resto ya está en la estantería. En la sala de escritura, entre 64 y 128 GPUs conectadas como si fueran una sola máquina escriben la respuesta token a token y dejan la conversación en la estantería para el siguiente turno.
La estantería de DeepSeek son unos 100 petabytes de almacenamiento aparte, y guarda cada conversación 72 horas desde que se queda quieta. Funciona como el backline compartido de un festival: los amplis se quedan en el escenario y cada grupo se enchufa a ellos. Cualquier máquina de lectura puede retomar cualquier conversación. De media, el 96 % de cada prompt sale de ahí, casi lo mismo que el 96,8 % de nuestro desarrollador en Claude.
Con esa estantería, una GPU de lectura al ritmo de DeepSeek da abasto para unos 150 desarrolladores como él, y una de escritura para unos 420. Sus prompts son más largos que la media de DeepSeek (138.000 tokens frente a 77.000), así que la carga real de alguien como él probablemente sea algo mayor.
Lo que DeepSeek ha abierto es el motor de las dos salas y la pieza que convierte las peticiones en tokens igual que su API. La propia página del proyecto dice que faltan tres cosas "necesarias para un servicio de inferencia completo": la estantería, la separación entre máquinas de lectura y de escritura (el motor ya hace casi todo el trabajo para ello) y el código que reparte el tráfico. Según el artículo de Zhihu, ese código está atado a su infraestructura interna, aunque explica con detalle cómo funciona cada parte. Una empresa que quiera este montaje tiene obra por delante. En nuestras cuentas, dos ingenieros a tiempo completo.
El mérito es del equipo de DeepSeek, que escribió DeepInfer, lo publicó con una licencia que permite uso comercial y contó su diseño de producción con números reales. DeepInfer nació sobre vLLM y toma ideas de SGLang y TensorRT-LLM, así que esos equipos también están aquí. Lo nuestro es la otra mitad: medir a un usuario intenso de verdad y calcular qué significan esas cifras para una empresa.
El primer escalón: alquilar un servidor
Para empezar no hace falta comprar nada. Los ejemplos de DeepInfer ejecutan el modelo en un servidor de 8 GPUs, y eso se alquila por horas. RunPod tiene la B200, el chip para el que está escrito DeepInfer, a 7,99 dólares por GPU y hora. Ocho salen por 46.662 dólares al mes, con la luz incluida.
A la velocidad de producción de DeepSeek, ese servidor da para unas 293 personas como nuestro desarrollador, con margen para la hora de más uso. Sumando los dos ingenieros, gana a la API a partir de unas 262. Con 293 personas sale a 245 dólares por persona frente a 274, un 11 % menos. Es poco margen para todo lo que hay que montar.
Con 4 GPUs el modelo todavía entra con sitio para trabajar (pesa unos 510 GB, y con 2 B200 ni siquiera carga). Cuestan 23.331 dólares al mes y dan para unas 146 personas. Contando solo el alquiler, ganan a la API desde unas 85. Con los ingenieros no llegan nunca: harían falta 176 personas y no caben.
| Alquiler en RunPod (B200, por horas) | Al mes | Personas que caben a la velocidad de DeepSeek | Gana a la API desde (solo alquiler) | Gana a la API desde (con dos ingenieros) |
|---|---|---|---|---|
| 4 GPUs | 23.331 USD | 146 | 85 | no llega |
| 8 GPUs | 46.662 USD | 293 | 170 | 262 |
Todo esto cuelga de dos supuestos que nadie ha comprobado todavía.
El primero es la velocidad de cada GPU. Las cifras de DeepSeek salen de salas de escritura de 64 GPUs o más, donde cada una guarda un trozo pequeño del modelo y atiende a mucha gente a la vez. En un servidor de 8, cada GPU carga más modelo y le queda menos memoria para la gente, así que irá más lenta. Si cada GPU alquilada no llega al 58 % de lo que hace una en producción en DeepSeek, alquilar no gana a la API con ningún número de personas.
El segundo es la estantería. Sin ella, cada relectura vuelve a ser una lectura completa, y un servidor de 8 GPUs da para unas 15 personas como él en vez de 293.
Nuestro propio motor de una GPU, deepseek-one-gpu, tampoco sirve para este perfil. Reserva unos 70.000 tokens por persona cuando atiende a varias a la vez, y el 84 % de las llamadas de este desarrollador eran más grandes. Está pensado para equipos pequeños y un uso más ligero.
El escalón grande: un rack propio
El montaje más grande del que DeepSeek publica cifras completas es una sala de escritura de 64 GPUs. Lo más parecido que se puede comprar es un rack de NVIDIA con 72 GPUs (un armario con las GPUs conectadas como una sola máquina), y lo hemos calculado con unos 3,5 millones de dólares. Es un supuesto nuestro: no encontramos un precio publicado que pudiéramos comprobar.
Tu propio rack gana a la API de DeepSeek a partir de unas 465 personas que usen agentes como él. Contando solo el hardware y la electricidad, a partir de 337.
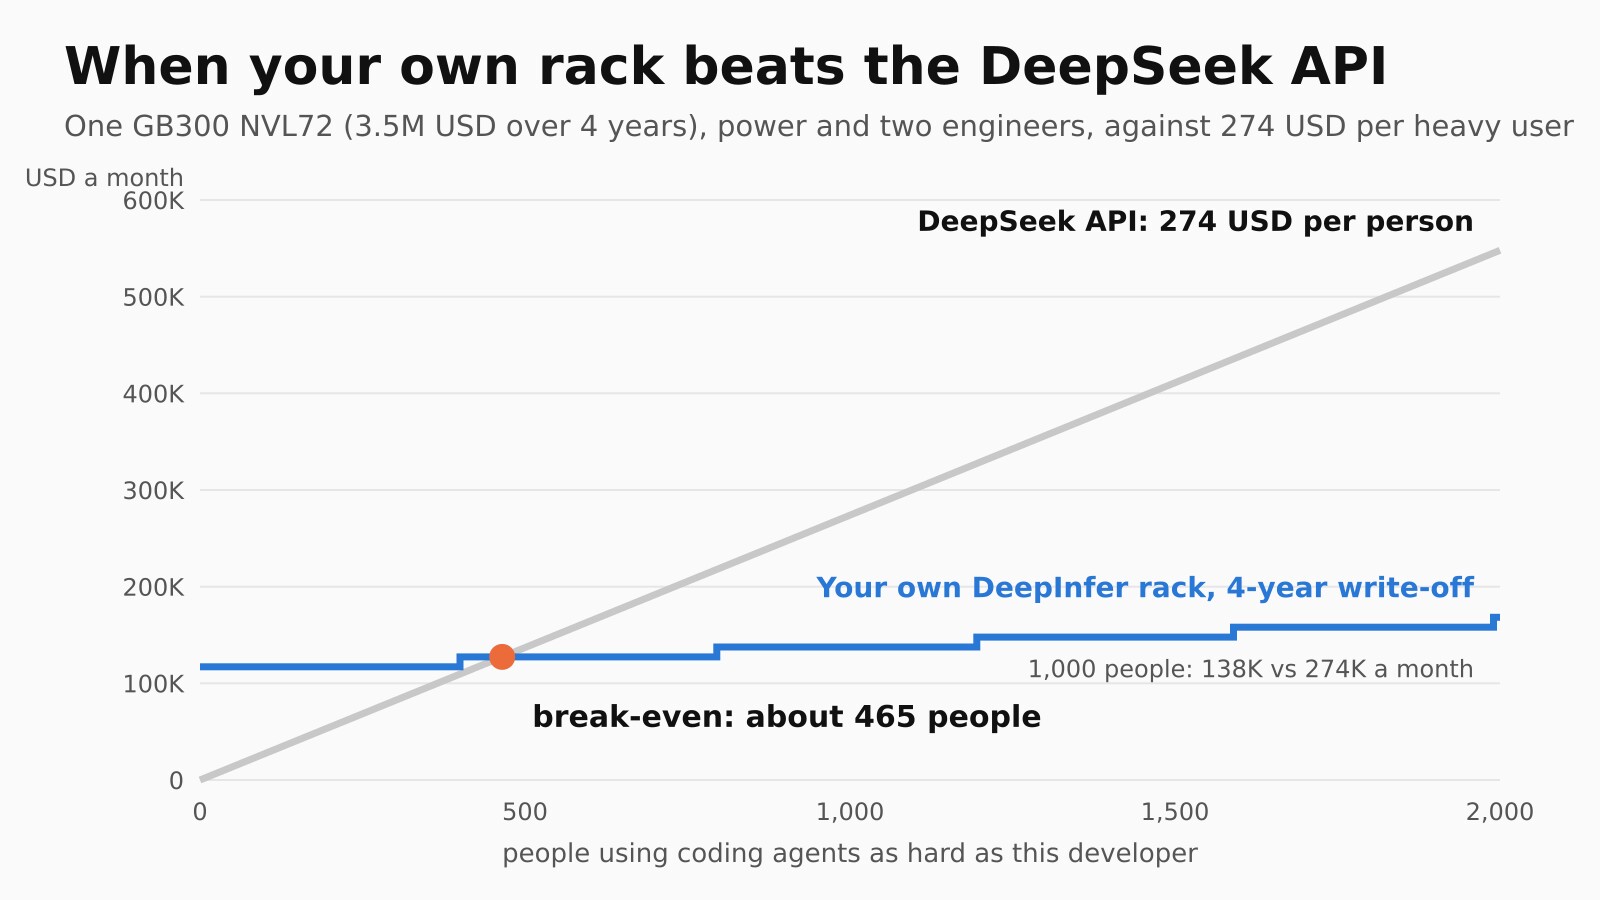
El rack, amortizado a cuatro años, sale por unos 73.000 dólares al mes. La electricidad añade unos 19.000 y los dos ingenieros, 25.000. Son unos 117.000 dólares al mes antes del primer usuario. A partir de ahí cada persona más cuesta unos 26 dólares al mes, y por eso la distancia con la API crece rápido: con 1.000 personas son 138.000 dólares al mes frente a 274.000, la mitad. El precio del rack es lo que más mueve el resultado: con 3 millones el cruce baja a unas 390 personas, y con 4 millones sube a unas 507.
Con este tráfico, casi todo el rack se queda esperando. Con 465 personas, de las 64 GPUs de escritura trabajan unas tres, y esas 64 son la mayor parte del precio. Lo que se llena es la lectura: las 8 GPUs de lectura del rack dan para unas 397 personas, así que hay que añadir otras 8.
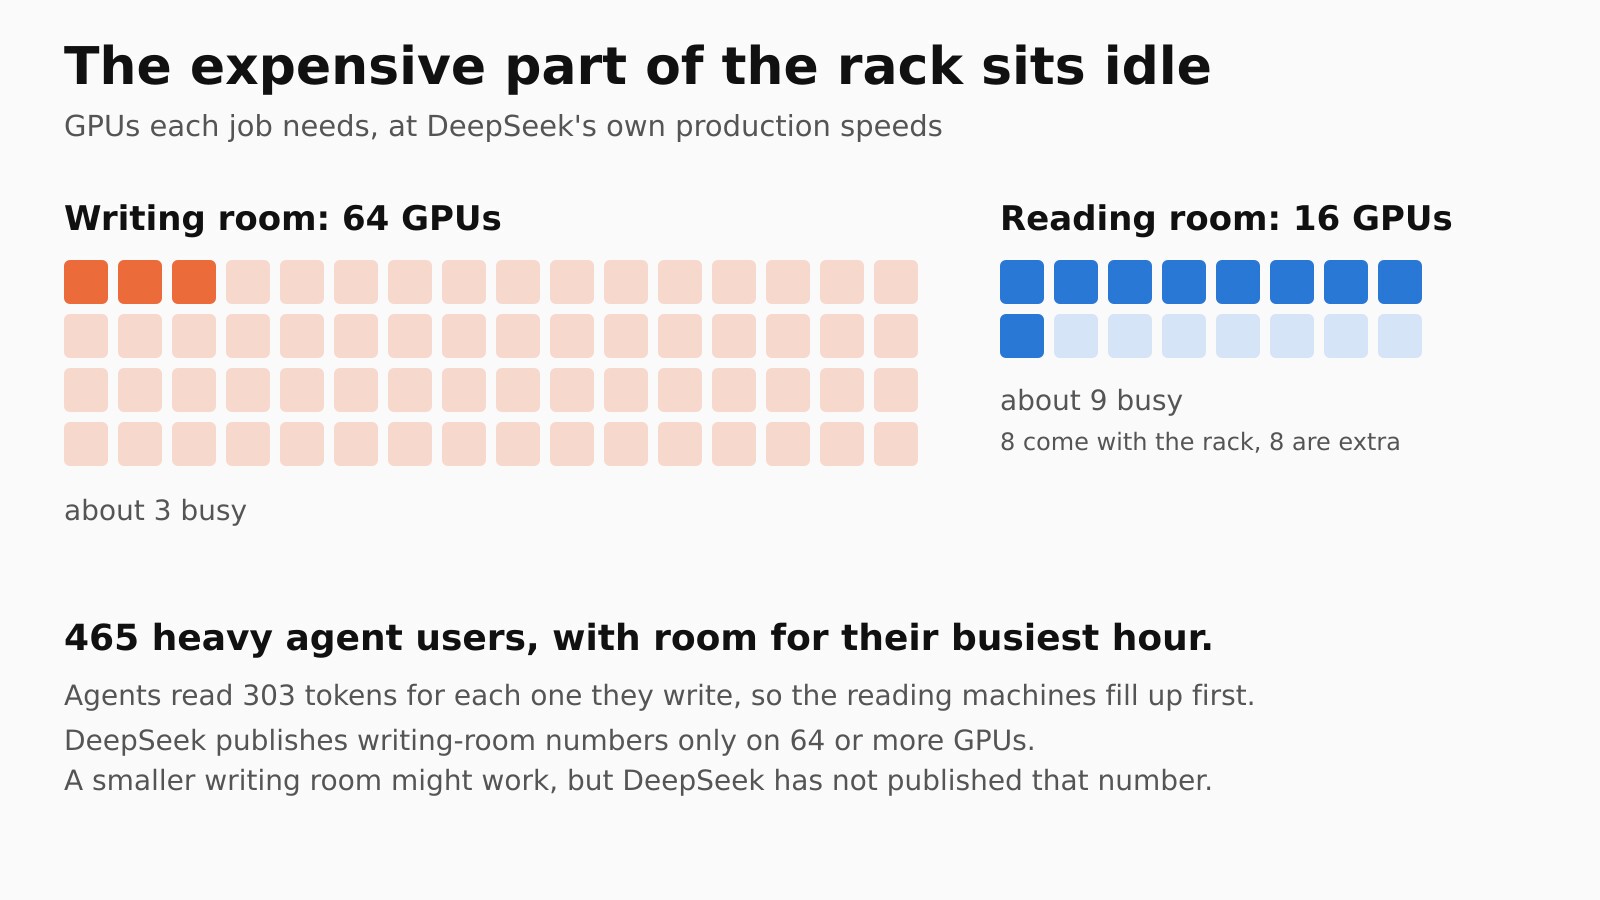
Todo está dimensionado para la hora de más uso, que en este desarrollador lee tres veces más material nuevo que su hora media. Un equipo que trabaja en el mismo horario tiene los picos a la vez.
Hay costes que no están en las cuentas, y todos suben el punto de cruce. El mayor es la propia estantería: para 465 personas como él harían falta, a ojo, unos 300 terabytes de almacenamiento rápido y las máquinas que lo rodean. Tampoco entran el centro de datos capaz de refrigerar con líquido un rack de 135 kW, la red, los repuestos ni el soporte. Toma 465 como un mínimo, y ten en cuenta que hablamos de 465 personas a 26.000 millones de tokens al mes cada una. Con gente que use agentes la mitad, hace falta más o menos el doble de personas.
Por qué la API puede ser tan barata
Un rack de 72 GPUs sirviendo la API de DeepSeek ingresa unos 2 millones de dólares al mes a precios de valle, según la propia cifra de DeepSeek de unos 38 dólares por GPU y hora. Tenerlo cuesta, en nuestro modelo, unos 92.000 al mes en hardware y electricidad. Esa diferencia no es beneficio: deja fuera el almacenamiento, la red, el personal y el entrenamiento del modelo, y supone un rack siempre lleno. Pero explica el precio. Para DeepSeek, el tamaño mínimo (un rack, una estantería y un equipo) ya está pagado. Para cualquier otra empresa es la barrera de entrada.
Qué hacer según el tamaño de tu equipo
Con usuarios como este desarrollador, y con las cifras de producción de DeepSeek como techo:
| Personas que usan agentes así | Lo más barato |
|---|---|
| Menos de unas 260 | La API de DeepSeek |
| Unas 260 a 290 | Un servidor alquilado de 8 GPUs, por un 11 % y solo si rinde como en DeepSeek |
| Unas 430 a 590 | Dos servidores alquilados, por debajo de la API y del rack |
| Más de unas 590 | Un rack propio |
Entre unas 290 y unas 430 personas vuelve a ganar la API, porque hace falta un segundo servidor que todavía no se llena. Si tu equipo usa los agentes la mitad que él, multiplica cada cifra por dos.
La cifra que falta
Todo el artículo depende de una cifra que no existe todavía: cuánto rinde DeepInfer en un servidor de 8 GPUs frente a los 64 de DeepSeek. La página del proyecto tiene dos gráficas, la lectura medida en 4 GPUs y la escritura en 64, y la que haría falta no está.
Se puede sacar alquilando ese servidor unas horas y pasando el benchmark que trae el propio DeepInfer, por unos 200 a 270 dólares. Si sale por encima del 58 %, alquilar empieza a tener sentido. Si sale por debajo, la API de DeepSeek gana con cualquier número de personas. Todavía no lo hemos hecho.
Para ingenieros
Cada cifra, fórmula y supuesto detrás del texto.
Datos y tokens
- Datos. Registros de Claude Code de un desarrollador (
~/.claude/projects/**/*.jsonl), ventana del 2026-09-21 00:00 UTC al 2026-10-20 11:08 UTC, duplicados eliminados por (message id, request id). 129.407 llamadas. Modelos: sobre todo Opus 5.5, más Opus 4.8, Sonnet 5.5 y Opus 5 (73 llamadas a modelos locales o sintéticos cuentan en tokens pero no tienen precio). - Cómo contar la salida. Claude Code escribe varias líneas de registro por llamada mientras hace streaming. La primera lleva un
output_tokensparcial (sustop_reasontodavía es null). Hay que coger el uso de la última línea de cada (message id, request id). Nuestra primera pasada usó la primera línea y se quedó corta en la salida por 2,4x (36,4 M en vez de 86,0 M). Todas las cifras de aquí usan la última línea. Si lo repites con tus registros, mira esto primero. - Tokens. Lecturas de caché 25.253 M. Escrituras de caché 822 M (612 M con TTL de 5 minutos, 209 M con TTL de 1 hora). Entrada sin caché 0,3 M. Salida 86,0 M. Total 26.161 M. Las lecturas de caché son el 96,8 % de los tokens de entrada (la cifra de la segunda imagen) y el 96,5 % del total. Unos 303 tokens leídos por token escrito. Contexto por llamada: mediana 138K, media 201K, p90 438K. 26.161 M / 138K = unos 190.000 contextos típicos. Día de más uso: 2026-10-01 con 4.894 M tokens; el más tranquilo, 2026-10-18 con 63 M. Hora de más uso de la semana (perfil por hora de la semana): 3,05x la hora media en tokens de entrada nuevos, 3,6x en tokens totales.
Precios
- Claude (claude.com/pricing). Suscripciones pagadas: 2 x Max 20x a 200 USD = 400 USD. Tarifas de la API por MTok: Opus 5.5 entrada 4, salida 20, lectura de caché 0,20, escritura de caché 5 (5 min) u 8 (1 h). Opus 5 y 4.8: 5 / 25 / 0,50 / 6,25 / 10. Sonnet 5.5: 2 / 10 / 0,10 / 2,5 / 4. Total 12.365 USD (Opus 5.5 10.348, Opus 4.8 1.930, Sonnet 5.5 63, Opus 5 24). De Opus 5.5: lecturas de caché 4.488, escrituras de caché 4.249, salida 1.609, entrada sin caché 1.
- Contrafactual sin caché en Claude. Lecturas de caché cobradas al precio de entrada de cada modelo en vez de al de lectura de caché (escrituras y salida sin cambios): unos 109.900 USD, 8,9x los 12.365.
- DeepSeek (deepseek-flash, DeepSeek-V4.1-Flash-1017, api-docs.deepseek.com/quick_start/pricing, 2026-10-20), USD por MTok valle / punta: acierto de caché 0,003 / 0,006, fallo de caché 0,15 / 0,30, salida 0,60 / 1,20. La punta es de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, salvo festivos chinos. Tratamos del 1 al 7 de octubre (semana del Día Nacional) como valle. Contar también el 25 de septiembre (Medio Otoño) cambia el total en menos de un dólar. Escrituras de caché cobradas como fallos, lecturas como aciertos. Todo en valle 251 USD, todo en punta 501 USD, con las horas reales del desarrollador 274 USD: el 9,4 % de su uso cae en hora punta y el 17,2 % de la factura se paga a tarifa punta. Sin la regla de festivos serían 289 USD.
- Proporciones. API de Claude = 31x las suscripciones y 45x la API de DeepSeek. Suscripciones = 1,46x la API de DeepSeek. Precio de relectura, Claude Opus 5.5 frente a DeepSeek en valle: 0,20 / 0,003 = 67x.
- Calidad en código. LiveBench, programación con agentes, esfuerzo máximo, modelos completos servidos por sus propios proveedores, según recogimos en nuestro artículo del 2026-10-10: DeepSeek-V4.1-Flash 77,3 (primero de 69), Claude Opus 5.5 71,7, Claude Fable 5.1 66,1, Claude Opus 5 65,2. Artificial Analysis Intelligence Index, 2026-10-16: Claude Opus 5.5 58, DeepSeek V4.1 Flash 39.
DeepInfer y la producción de DeepSeek
- DeepInfer (github.com/deepseek-ai/DeepInfer). Apache 2.0. Esta versión ofrece inferencia offline. Construido originalmente sobre todo sobre vLLM, inspirado en SGLang y TensorRT-LLM. Solo admite DeepSeek-V4.1-Flash, en GPUs NVIDIA SM100 y NPUs Huawei Ascend 950. Kernels FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, TileLang. Attention DP / CP balanceado, MoE EP + EPLB, decodificación especulativa DSpark (
DEEPINFER_ENABLE_MTP_VARLEN=1,DEEPINFER_USE_NEXTN_DECODEpor defecto 5), SWA bounded replay (DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact,DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140), planificación asíncrona activada por defecto, inferencia invariante al lote (DEEPINFER_BATCH_INVARIANT=1, solo NVIDIA). Se compila conexport DEEPINFER_ACCELERATOR=nvidia; ./build.shy se ejecuta conpython examples/offline_inference.py. Elexamples/README.mdejecuta un nodo de 8 GPUs con--ep 8,--ep 2 --dp 8o--ep 2 --cp 8, y mide conexamples/sweep/run_sweep.sh. No incluye: sistema de caché KV, separación VE/prefill/decode, balanceo de carga entre réplicas DP, ni un servidor HTTP documentado. DeepSeek también ha publicado deepseek-recipe (del protocolo de la API a tokens y vuelta, en Rust con bindings de Python). - Checkpoint.
deepseek-ai/DeepSeek-V4.1-Flash-1017: 763B parámetros, unos 510 GB (sobre todo expertos empaquetados en 4 bits y FP8). - Benchmark del README. 4 GPUs SM100 para prefill y 64 para decode, cada grupo en un mismo dominio scale-up. Gráfica de prefill en las 4 GPUs (EP4DP4, contexto 131.072): unos 60K tok/s/GPU con lotes de 4.096 tokens, hasta unos 89,5K con 65.536. Gráfica de decode en las 64 GPUs (EP64DP64, nextn=3, 75 % de aceptación): unos 26,3K tok/s/GPU a unos 103 tok/s por usuario, bajando a unos 2,6K a unos 325.
- Producción de DeepSeek (artículo de Zhihu, tabla con margen para los picos de tráfico; no dice en qué hardware se midieron). Prefill 60K tok/s/GPU sin caché, 1,5 M con aciertos de caché, 96 % de acierto de caché medio, entrada media de 77K, TTFT de 400 ms de media y 1.000 ms en el P99. Decode 14K tok/s/GPU, 230 tok/s por usuario (300 en código). P:D cerca de 1:1. 155 billones de tokens al día en un solo clúster. Ingresos de 38 USD por GPU y hora a precios de valle. Prefill en máquinas de 8 GPUs (EP2-8), decode en supernodos de 64-128 GPUs (EP64-128). Caché KV en un clúster 3FS aparte, unos 100 PiB de SSD, páginas de 128 tokens, TTL de 3 días para tráfico de agentes y 7 para chat, lectura pico de 10 TiB/s. Cualquier máquina de prefill puede acertar cualquier prefijo.
- Carga por usuario (media de 30 días sobre 2.592.000 s): 33,2 tok/s escritos, 317 tok/s de entrada nueva, 9.743 tok/s de entrada en caché, 10.060 tok/s de entrada total. Fracción de GPU a las velocidades de producción de DeepSeek: prefill 10.060 / 1,5 M = 0,0067 GPU (unos 150 usuarios por GPU), decode 33,2 / 14K = 0,0024 GPU (unos 420 usuarios por GPU). Margen de 3x la carga media para la hora punta: 0,0273 GPU por usuario.
- Sin caché. Prefill por usuario 10.060 / 60K = 0,168 GPU, 25 veces más.
Servidores alquilados
- Precios (runpod.io/pricing, 2026-10-20, por horas, sin precio de reserva publicado). B200 7,99 USD por GPU y hora en Secure Cloud, 5,98 en Community; B300 8,99 / 6,94. 8 x 7,99 x 730 h = 46.662 USD al mes, 4 GPUs 23.331, luz incluida. 2 B200 (unos 360 GB) no pueden cargar el checkpoint; 4 (unos 720 GB) dejan unos 200 GB para la caché KV.
- Capacidad. 8 GPUs / 0,0273 = 293 usuarios, 4 GPUs 146, a las velocidades de DeepSeek (220 y 110 al 75 %, 147 y 73 al 50 %). Sin caché, 8 GPUs dan para 8 / ((0,168 + 0,0024) x 3) = unos 15 usuarios.
- Punto de equilibrio frente a 274 USD. 8 GPUs: 46.662 / 274 = 170 usuarios solo alquiler, (46.662 + 25.000) / 274 = 262 con ingenieros. 4 GPUs: 85 solo alquiler; con ingenieros harían falta 176 y solo caben 146, así que no hay punto de equilibrio. Precio Community, 8 GPUs: 127 y 219.
- Umbral de velocidad. Coste de alquiler por usuario a plena capacidad 46.662 / 293 = 159 USD, así que la velocidad por GPU tiene que llegar a 159 / 274 = 58 % de la de producción de DeepSeek para que alquilar gane a la API con cualquier tamaño, sin contar ingenieros (43 % al precio Community).
- Varios nodos (Secure, 100 %, ingenieros incluidos): 1 nodo 71.662 USD hasta 293 usuarios; 2 nodos 118.324 hasta 586 (gana a la API desde 432 y al rack propio, 127.374, en todo ese tramo); 3 nodos 164.986; 4 nodos 211.648 con 1.000 usuarios, frente a 137.614 del rack y 274.000 de la API.
- Prueba propuesta. Unas 2 h con 4 GPUs para instalar y descargar los pesos, más 2 a 3 h con 8 para los barridos de
run_sweep.shen prefill y decode con contexto de 128K: entre 200 y 270 USD aproximadamente. No ejecutada. - deepseek-one-gpu. DeepSeek-V4.1-Flash Q2_K en una RTX PRO 6000 de 96 GB más la RAM del servidor. 8 plazas de lote de 69.632 posiciones, hasta 262.144 para una petición sola. El 84,1 % de las llamadas del desarrollador supera 69.632 y el 23,5 % supera 262.144. No hemos probado un servidor con varias GPUs.
Rack propio
- Hardware. Un GB300 NVL72: 72 GPUs Blackwell Ultra y 36 CPUs Grace en un mismo dominio NVLink, 288 GB de HBM3e por GPU. Reparto 64 decode + 8 prefill. Precio 3,5 M USD, supuesto nuestro (rango 3-4 M). Together AI y Clusterbid no dan precio de rack. El GB200 NVL72 (compute capability 10.0, SM100, el objetivo que nombra DeepInfer) es el mismo rack NVLink de 72 GPUs. No lo hemos calculado aparte y su precio tampoco está comprobado. GPUs de prefill extra al coste por GPU del rack, 48,6K USD cada una, añadidas en cajas de 8.
- Coste mensual. Amortización 3,5 M / 48 meses = 72.917 USD. Electricidad 135 kW x PUE 1,3 x 730 h x 0,15 USD/kWh = 19.217 USD. Dos ingenieros 25.000 USD (150K USD al año con cargas, cada uno). Base 117.134 USD. Solo hardware y electricidad, 92.134 USD. Cada GPU de prefill extra, 1.280 USD al mes (48,6K / 48 + 267 de electricidad). Coste marginal por usuario 1.280 x 0,0067 x 3 = unos 26 USD.
- Margen. 3x la carga media en prefill. Las 8 GPUs de prefill del rack dan para unos 397 usuarios a 3x (unos 1.190 a 1x). Con 465 usuarios: unas 9,4 GPUs de prefill y unas 3,3 de decode ocupadas.
- Punto de equilibrio (primer número de usuarios en el que el coste propio queda igual o por debajo de 274 USD x usuarios, con prefill añadido en cajas de 8). Hardware + electricidad: 92.134 / 274 = 337 usuarios. Con ingenieros: 117.134 / 274 = 428 supera los 397 que cubre el prefill del propio rack, así que se añade una caja de 8: 127.371 / 274 = unos 465. Rack a 3 M: 299 y 390. Rack a 4 M: 375 y 507. El número de personas para empatar escala más o menos con 1 / uso por persona.
| Usuarios | API de DeepSeek (USD/mes) | Rack propio (USD/mes) | Rack propio por usuario |
|---|---|---|---|
| 100 | 27.416 | 117.134 | 1.171 |
| 200 | 54.832 | 117.134 | 586 |
| 300 | 82.248 | 117.134 | 390 |
| 400 | 109.664 | 127.371 | 318 |
| 500 | 137.080 | 127.371 | 255 |
| 750 | 205.620 | 127.371 | 170 |
| 1.000 | 274.160 | 137.608 | 138 |
| 2.000 | 548.320 | 168.319 | 84 |
| 5.000 | 1.370.800 | 239.979 | 48 |
- Comprobación de ingresos. En valle, una GPU de prefill ingresa unos 47,95 USD/h con la mezcla de 96 % de aciertos de DeepSeek y una GPU de decode 30,24 USD/h, coherente con los 38 de DeepSeek. 72 GPUs x 38 USD x 730 h = unos 2,0 M USD al mes. Un rack equilibrado para este tráfico (si el decode funcionara con menos GPUs) daría para unos 7.900 usuarios como él, 7.900 x 251 USD (todo en valle) = unos 2,0 M USD al mes.
- Tamaño de la estantería, a ojo. 465 usuarios x 872 M tokens al día = 405.000 M tokens al día, el 0,26 % de los 155 billones de DeepSeek. La misma proporción de unos 100 PiB son unos 300 TB. Escalar por tokens es tosco. Sin precio.
Límites
- El precio del rack es un supuesto nuestro, no un presupuesto, y ninguna fuente que hayamos podido abrir da uno. Las estimaciones de consumo del rack también varían (de unos 120 a 140 kW según la fuente).
- El almacenamiento de la estantería no está en el modelo de costes. Tampoco el espacio en un centro de datos o el alojamiento para un rack de 135 kW con refrigeración líquida, la red, los repuestos ni el soporte. Todo ello sube el punto de equilibrio.
- El README de DeepInfer nombra GPUs SM100, y CUDA trata Blackwell Ultra (GB300, B300) como otra compute capability (sm_103). Usar DeepInfer en un GB300 a las velocidades de producción de DeepSeek es un supuesto nuestro, y DeepSeek no dice qué hardware produjo esas velocidades.
- DeepSeek no ha publicado cifras de DeepInfer con una sala de escritura más pequeña. Las cifras del rack suponen una sala de escritura de 64 GPUs. Las de 4 y 8 GPUs alquiladas suponen las velocidades por GPU de DeepSeek, o la fracción indicada, y una caché que funcione y que DeepInfer no trae. No hemos medido ninguna de las dos cosas.
- El modelo de usuario es una sola persona, y muy intensiva. Una empresa tiene usuarios más ligeros, otros horarios y otras costumbres. Sus prompts son más largos que la media de DeepSeek (77K), así que su carga de lectura por token probablemente sea mayor de lo que sugieren las velocidades de producción.
- Claude y DeepSeek parten el texto en tokens de forma distinta, en una cantidad que no hemos medido, así que el precio en DeepSeek es aproximado. La comparación es solo de precio. DeepSeek-V4.1-Flash es un modelo distinto de Opus 5.5, y el mismo trabajo con él puede llevar otro número de vueltas y de tokens.
- La suscripción es una tarifa plana con límites de uso para particulares. No es un plan de empresa.
- Las velocidades de producción de DeepSeek salen de su propio servicio, con su estantería, sus balanceadores y su mezcla de tráfico. Un primer montaje probablemente rinda menos.
- La privacidad, el control y la elección de modelo quedan fuera de la comparación de costes a propósito.