400, 12.365 oder 274 Dollar: was ein Monat Coding-Agent kostet und wann sich ein eigenes DeepInfer lohnt
Ein Entwickler, 26,2 Milliarden Tokens in 30 Tagen, drei Rechnungen. Und wie viele solche Leute ein Unternehmen braucht, bis sich ein eigenes DeepInfer lohnt.
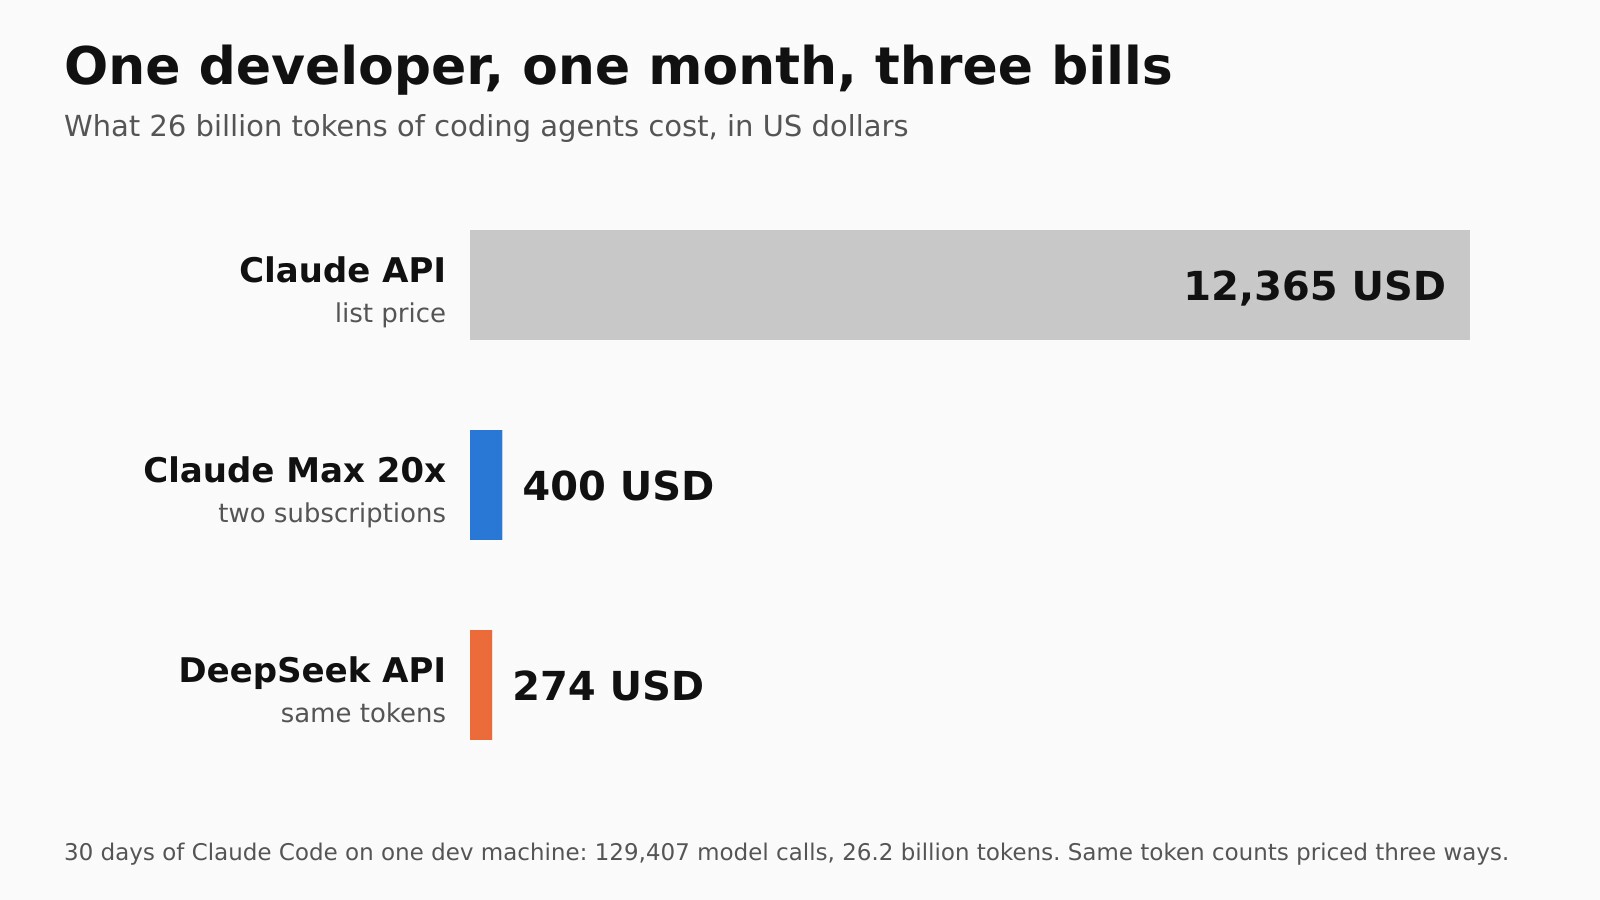
Einer unserer Entwickler hat letzten Monat 400 Dollar für seinen Coding-Agent bezahlt. Dieselbe Arbeit kostet zum Listenpreis der Claude-API 12.365 Dollar. Über die API von DeepSeek wären es 274 gewesen.
Alle drei Zahlen stammen von seinem eigenen Rechner. Wir haben seine Claude-Code-Logs vom 21. September bis zum 20. Oktober genommen und jeden Aufruf gezählt, den der Agent an das Modell geschickt hat: 129.407 Aufrufe und 26,2 Milliarden Tokens (ein Token ist ein Stück eines Wortes). Dann haben wir genau diesen Monat auf drei Arten bepreist.
Diesen Monat hat DeepSeek DeepInfer als Open Source veröffentlicht, die Engine, mit der es sein eigenes Modell ausliefert. Das führt zu der Frage, die jeder CTO stellen würde: Wenn meine ganze Firma so arbeiten würde, ab wie vielen Leuten lohnt es sich, diese Engine auf eigenen Maschinen zu betreiben, statt DeepSeek pro Token zu bezahlen?
Die Antwort hängt weniger von den Maschinen ab, als man denkt. Ein Coding-Agent liest den ganzen Tag dasselbe immer wieder, und wer einen Platz hat, um schon Gelesenes aufzubewahren, zahlt viel weniger. Genau dieses Teil liefert DeepInfer nicht mit.
| Was er bezahlt hat (zwei Claude-Max-20x-Abos) | 400 USD |
| Dieselben Tokens zum Listenpreis der Claude-API | 12.365 USD |
| Dieselben Tokens über die API von DeepSeek | 274 USD |
| Tokens, die der Agent pro geschriebenem Token liest | etwa 303 |
| Ein gemieteter Server mit 8 GPUs schlägt die API ab | etwa 262 Leuten wie ihm, und nur wenn er so schnell läuft wie bei DeepSeek |
| Ein eigenes Rack mit 72 GPUs schlägt die API ab | etwa 465 Leuten wie ihm |
| Bei 1.000 Leuten, Kosten pro Person und Monat | 138 USD mit eigenem Rack, 274 über die API |
Ein Coding-Agent liest vor allem
Bei jedem Schritt (eine Datei öffnen, einen Test laufen lassen, eine Zeile ändern) schickt der Agent dem Modell das ganze Gespräch noch einmal: die Anweisungen, die geöffneten Dateien und alles bisher Gesagte. Ein typischer Aufruf trug etwa 138.000 Tokens, ungefähr ein Buch mit 400 Seiten. Das Modell schreibt ein paar hundert Tokens, und es geht von vorn los. In einem Monat sind das etwa 190.000 gelesene Bücher.
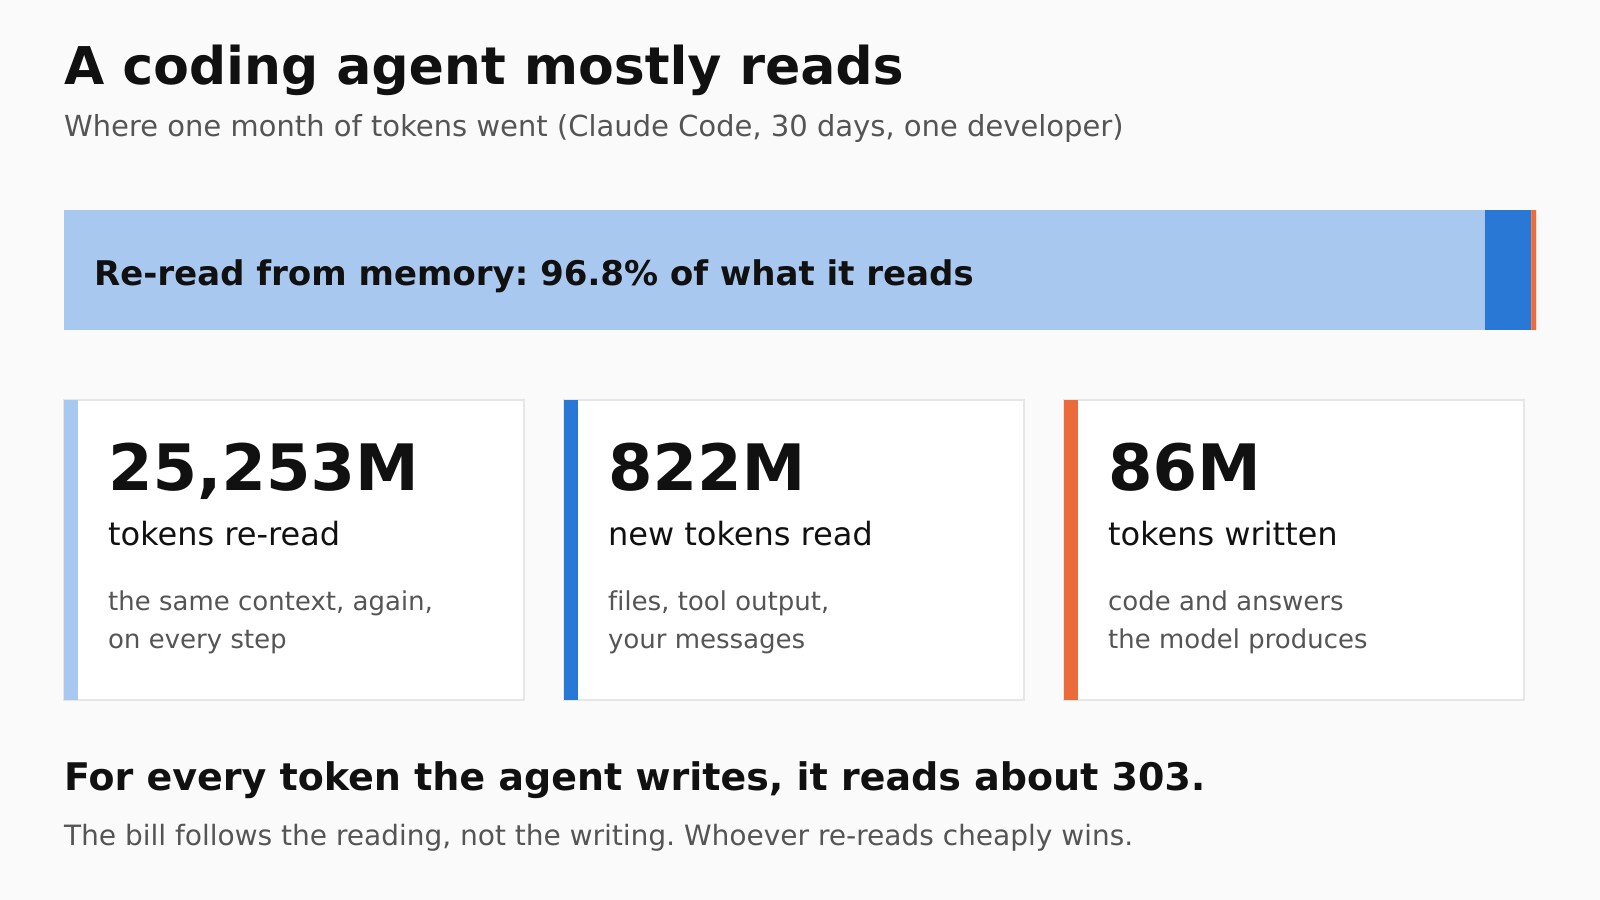
Von den 26,2 Milliarden Tokens des Monats waren 25.253 Millionen derselbe Kontext, noch einmal gelesen. Neues Material (Dateien, Ergebnisse der Tools und die Nachrichten des Entwicklers) waren 822 Millionen. Was das Modell wirklich geschrieben hat, Code und Antworten, waren 86 Millionen. Für jeden geschriebenen Token hat der Agent etwa 303 gelesen.
Die Anbieter wissen das und halten den jüngsten Kontext bereit, damit erneutes Lesen billig ist. Stell dir ein Regal neben dem Modell vor: Was es schon gelesen hat, bleibt dort liegen, und beim nächsten Mal nimmt es das fertig heraus. Bei Claude kostet das Wiederlesen aus dem Regal ein Zwanzigstel des Lesens von etwas Neuem, und 96,8 % dessen, was dieser Agent gelesen hat, kamen von dort. Ohne Regal hätte derselbe Monat über die Claude-API mehr als 100.000 Dollar gekostet, etwa neunmal so viel.
Drei Rechnungen für dieselbe Arbeit
Gegenüber dem Listenpreis von Claude ist das Abo mit Abstand am billigsten, aber es hat eine Obergrenze. Ein Max-20x-Plan kostet laut Claudes Preisseite 200 Dollar im Monat, mit einem Nutzungslimit in jedem Fünf-Stunden-Fenster, und er bezahlt zwei. Für eine Person funktioniert das. Für eine ganze Firma ist der Plan nicht gedacht.
Der Listenpreis ist das, was diese Tokens über die Claude-API kosten, und so bezahlt ein Unternehmen meistens, wenn Pläne pro Person nicht mehr reichen. Das ist das 31-Fache dessen, was er bezahlt hat, und fast nichts davon entfällt aufs Schreiben. Von den 10.348 Dollar für Opus 5.5 kosteten Code und Antworten etwa 1.600. Etwa 4.500 gingen ins Wiederlesen aus dem Regal und etwa 4.250 dafür, neues Material zum ersten Mal hineinzulegen.
Die API von DeepSeek kommt mit denselben Tokens und zu ihren veröffentlichten Preisen auf 274 Dollar, 45-mal weniger als die Claude-API. Fast der ganze Unterschied steckt im Wiederlesen: Eine Million wiedergelesener Tokens kostet bei DeepSeek in der Nebenzeit ein Drittel Cent und bei Claude Opus 5.5 20 Cent.
Das ist ein Preisvergleich, mehr nicht. DeepSeek-V4.1-Flash ist nicht Opus, es zerlegt Text anders in Tokens (wie stark, haben wir nicht gemessen), und wir haben den Monat nicht damit wiederholt. Ein anderes Modell braucht für dieselbe Aufgabe vielleicht mehr oder weniger Durchläufe.
Kann das billige Modell programmieren?
Im Test, der dieser Arbeit am nächsten kommt, ja. LiveBench ist eine unabhängige Rangliste, die ihre Fragen oft wechselt, damit Modelle sie nicht auswendig lernen. In der Kategorie agentisches Programmieren, in der das Modell eine echte Programmieraufgabe Schritt für Schritt erledigen muss, lag DeepSeek-V4.1-Flash am 10. Oktober auf Platz eins von 69 Modellen.
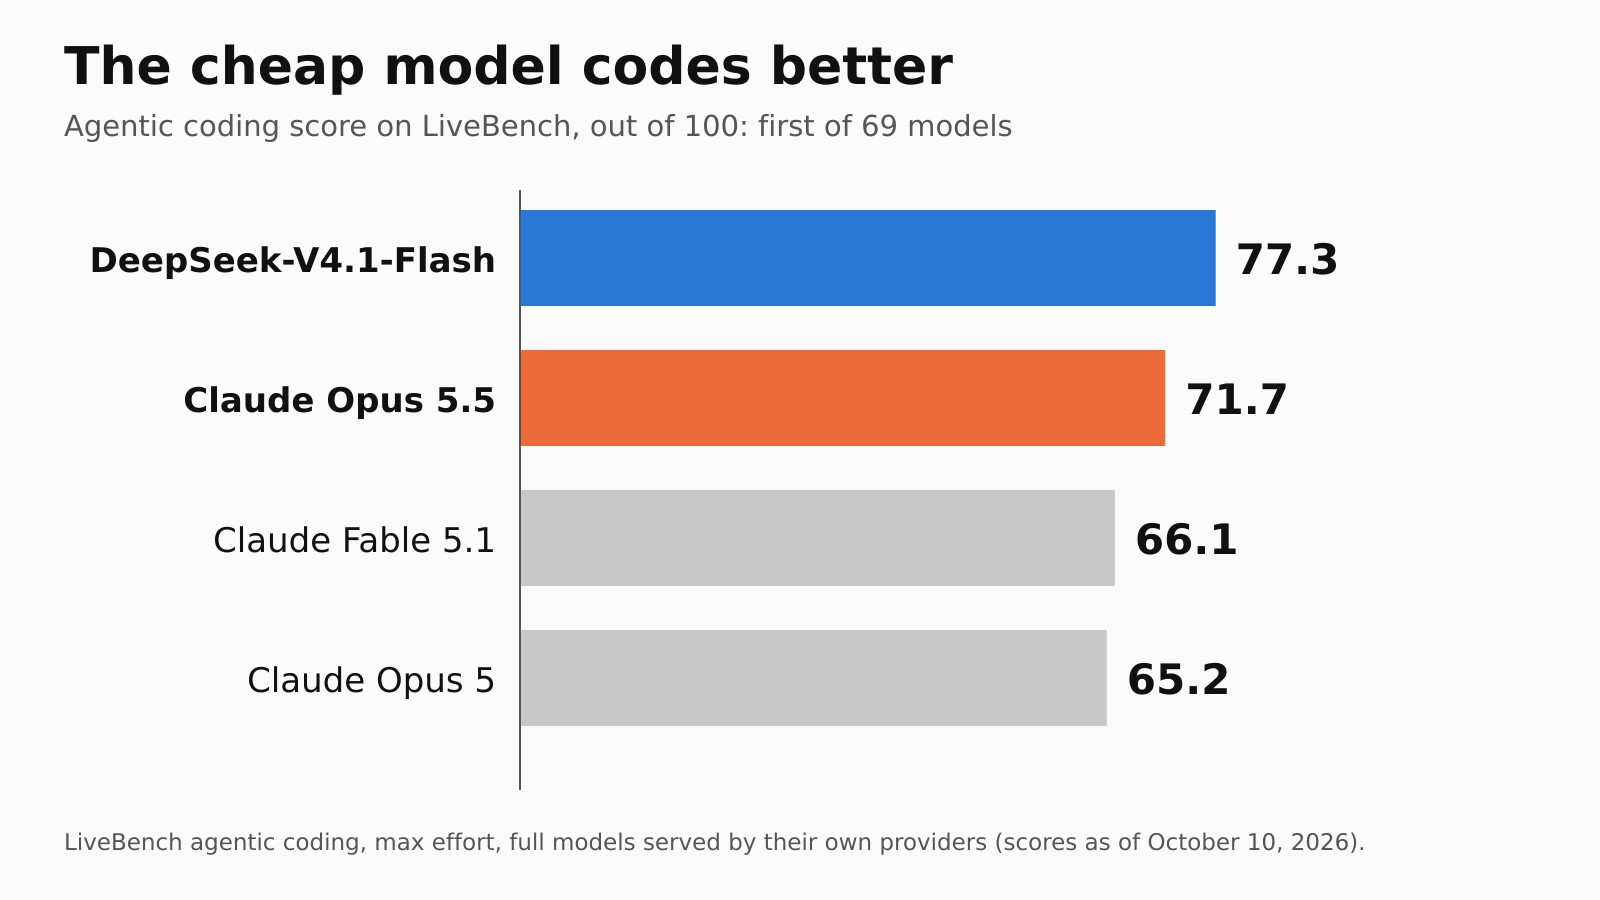
Es ist dieselbe Tabelle, die wir genutzt haben, als wir dieses Modell auf zwei Grafikkarten betrieben haben. In einer breiteren Wertung, dem Intelligence Index von Artificial Analysis, der viele Arten von Tests mischt, liegt Opus 5.5 klar vorn: 58 zu 39 am 16. Oktober. Flash programmiert sehr gut für einen Bruchteil des Preises, und Opus ist insgesamt stärker. Was zu dir passt, hängt davon ab, womit deine Agenten ihren Tag verbringen.
Wie DeepSeek DeepSeek ausliefert
DeepSeek hat in einem langen Beitrag auf Zhihu, einer chinesischen Frage-und-Antwort-Seite, erklärt, wie sein Dienst funktioniert. Am einfachsten stellt man es sich als Gebäude mit einer Eingangstür, zwei Räumen und dem Regal von vorhin vor.
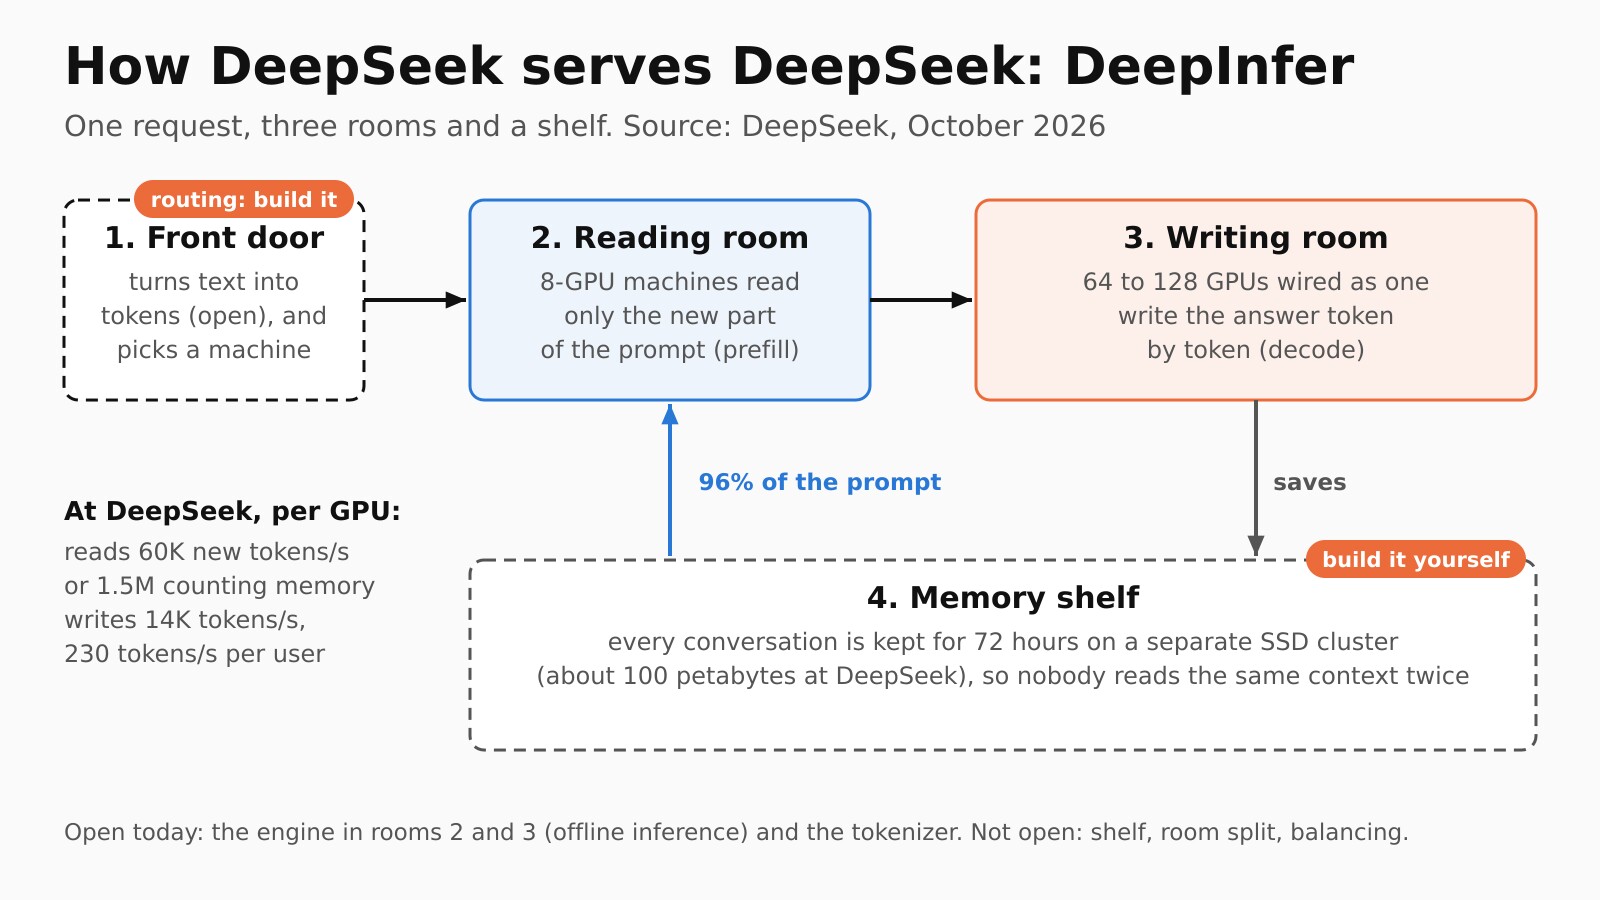
Eine Anfrage kommt durch die Eingangstür, die sie in Tokens umwandelt und an eine freie Maschine schickt. Im Leseraum lesen Server mit 8 GPUs nur den neuen Teil des Prompts, denn der Rest liegt schon im Regal. Im Schreibraum schreiben 64 bis 128 GPUs, verbunden, als wären sie eine Maschine, die Antwort Token für Token und legen das Gespräch für die nächste Runde ins Regal.
Das Regal von DeepSeek sind etwa 100 Petabyte eigener Speicher, und es bewahrt jedes Gespräch 72 Stunden auf, nachdem es still geworden ist. Es funktioniert wie das gemeinsame Backline auf einem Festival: Die Verstärker bleiben auf der Bühne, und jede Band steckt sich dort ein. Jede Lesemaschine kann jedes Gespräch übernehmen. Im Schnitt kommen 96 % jedes Prompts von dort, fast so viel wie die 96,8 % unseres Entwicklers bei Claude.
Mit diesem Regal reicht eine Lese-GPU im Tempo von DeepSeek für etwa 150 Entwickler wie ihn, und eine Schreib-GPU für etwa 420. Seine Prompts sind länger als der Durchschnitt bei DeepSeek (138.000 Tokens gegen 77.000), daher ist die echte Last von jemandem wie ihm wahrscheinlich etwas höher.
Geöffnet hat DeepSeek die Engine der beiden Räume, dazu das Teil, das Anfragen so in Tokens umwandelt wie seine API. Die Projektseite selbst sagt, dass drei Dinge fehlen, die "für einen vollständigen Inferenzdienst nötig" sind: das Regal, die Trennung zwischen Lese- und Schreibmaschinen (die Engine erledigt dafür schon den Großteil der Arbeit) und der Code, der den Verkehr verteilt. Laut dem Zhihu-Beitrag hängt dieser Code an DeepSeeks interner Infrastruktur, auch wenn der Beitrag genau erklärt, wie jeder Teil funktioniert. Ein Unternehmen, das diesen Aufbau will, hat also eine Baustelle vor sich. In unserer Rechnung zwei Ingenieure in Vollzeit.
Der Verdienst gehört dem Team von DeepSeek, das DeepInfer geschrieben, unter einer Lizenz mit kommerzieller Nutzung veröffentlicht und sein Produktionsdesign mit echten Zahlen beschrieben hat. DeepInfer ist auf vLLM entstanden und übernimmt Ideen aus SGLang und TensorRT-LLM, also stecken auch diese Teams darin. Unser Teil ist die andere Hälfte: einen echten Vielnutzer zu messen und auszurechnen, was diese Zahlen für ein Unternehmen bedeuten.
Der erste Schritt: einen Server mieten
Um anzufangen, musst du nichts kaufen. Die Beispiele von DeepInfer betreiben das Modell auf einem Server mit 8 GPUs, und so etwas lässt sich stundenweise mieten. RunPod bietet die B200, den Chip, für den DeepInfer geschrieben ist, für 7,99 Dollar pro GPU und Stunde an. Acht davon kosten 46.662 Dollar im Monat, Strom inklusive.
Bei der Produktionsgeschwindigkeit von DeepSeek reicht dieser Server für etwa 293 Leute wie unseren Entwickler, mit Reserve für die Stunde mit der meisten Nutzung. Rechnet man die zwei Ingenieure dazu, schlägt er die API ab etwa 262. Bei 293 Leuten kostet er 245 Dollar pro Person gegen 274, 11 % weniger. Das ist wenig Spielraum für alles, was gebaut werden muss.
Mit 4 GPUs passt das Modell noch mit Platz zum Arbeiten (es wiegt etwa 510 GB, und auf 2 B200 lädt es nicht einmal). Sie kosten 23.331 Dollar im Monat und reichen für etwa 146 Leute. Zählt man nur die Miete, schlagen sie die API ab etwa 85. Mit den Ingenieuren kommen sie nie hin: Es bräuchte 176 Leute, und die passen nicht.
| Gemietet bei RunPod (B200, stundenweise) | Pro Monat | Leute bei der Geschwindigkeit von DeepSeek | Schlägt die API ab (nur Miete) | Schlägt die API ab (mit zwei Ingenieuren) |
|---|---|---|---|---|
| 4 GPUs | 23.331 USD | 146 | 85 | nie |
| 8 GPUs | 46.662 USD | 293 | 170 | 262 |
All das hängt an zwei Annahmen, die noch niemand geprüft hat.
Die erste ist die Geschwindigkeit jeder GPU. Die Zahlen von DeepSeek stammen aus Schreibräumen mit 64 GPUs oder mehr, in denen jede ein kleines Stück des Modells hält und viele Leute gleichzeitig bedient. In einem Server mit 8 GPUs trägt jede GPU mehr vom Modell und hat weniger Speicher für die Leute übrig, also wird sie langsamer sein. Wenn jede gemietete GPU nicht 58 % dessen erreicht, was eine in der Produktion von DeepSeek leistet, schlägt Mieten die API bei keiner Zahl von Leuten.
Die zweite ist das Regal. Ohne es wird jedes Wiederlesen wieder zu einem vollen Lesen, und ein Server mit 8 GPUs reicht für etwa 15 Leute wie ihn statt für 293.
Auch unsere eigene Ein-GPU-Engine, deepseek-one-gpu, passt nicht zu diesem Profil. Sie hält etwa 70.000 Tokens pro Person, wenn sie mehrere gleichzeitig bedient, und 84 % der Aufrufe dieses Entwicklers waren größer. Sie ist für kleine Teams und leichtere Nutzung gebaut.
Der große Schritt: ein eigenes Rack
Der größte Aufbau, für den DeepSeek vollständige Zahlen veröffentlicht, ist ein Schreibraum mit 64 GPUs. Das Nächste, was man kaufen kann, ist ein NVIDIA-Rack mit 72 GPUs (ein Schrank, in dem die GPUs wie eine Maschine verbunden sind), und wir haben es mit etwa 3,5 Millionen Dollar angesetzt. Das ist unsere Annahme: Wir haben keinen veröffentlichten Preis gefunden, den wir prüfen konnten.
Dein eigenes Rack schlägt die API von DeepSeek ab etwa 465 Leuten, die Agenten so nutzen wie er. Zählt man nur Hardware und Strom, ab 337.
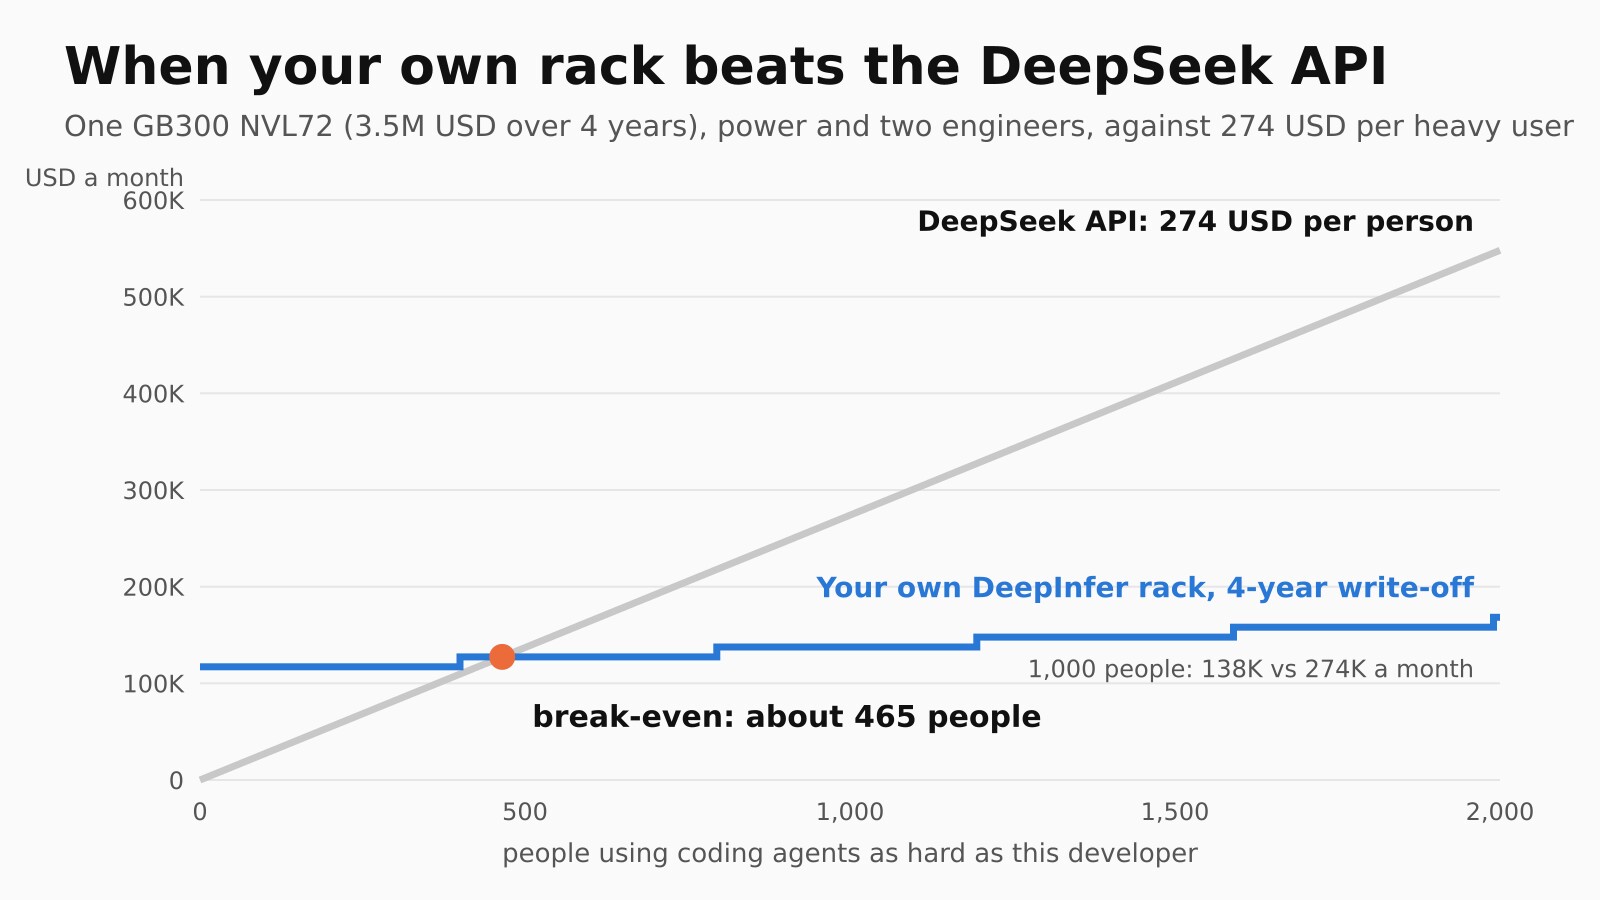
Das Rack kostet, über vier Jahre abgeschrieben, etwa 73.000 Dollar im Monat. Strom kommt mit etwa 19.000 dazu und die zwei Ingenieure mit 25.000. Das sind etwa 117.000 Dollar im Monat vor dem ersten Nutzer. Danach kostet jede weitere Person etwa 26 Dollar im Monat, und deshalb wächst der Abstand zur API schnell: Bei 1.000 Leuten sind es 138.000 Dollar im Monat gegen 274.000, die Hälfte. Der Preis des Racks bewegt das Ergebnis am stärksten: Bei 3 Millionen sinkt der Schnittpunkt auf etwa 390 Leute, bei 4 Millionen steigt er auf etwa 507.
Bei diesem Verkehr wartet der größte Teil des Racks. Bei 465 Leuten arbeiten etwa drei der 64 Schreib-GPUs, und diese 64 sind der größte Teil des Preises. Voll wird die Leseseite: Die 8 Lese-GPUs des Racks reichen für etwa 397 Leute, also kommen weitere 8 dazu.
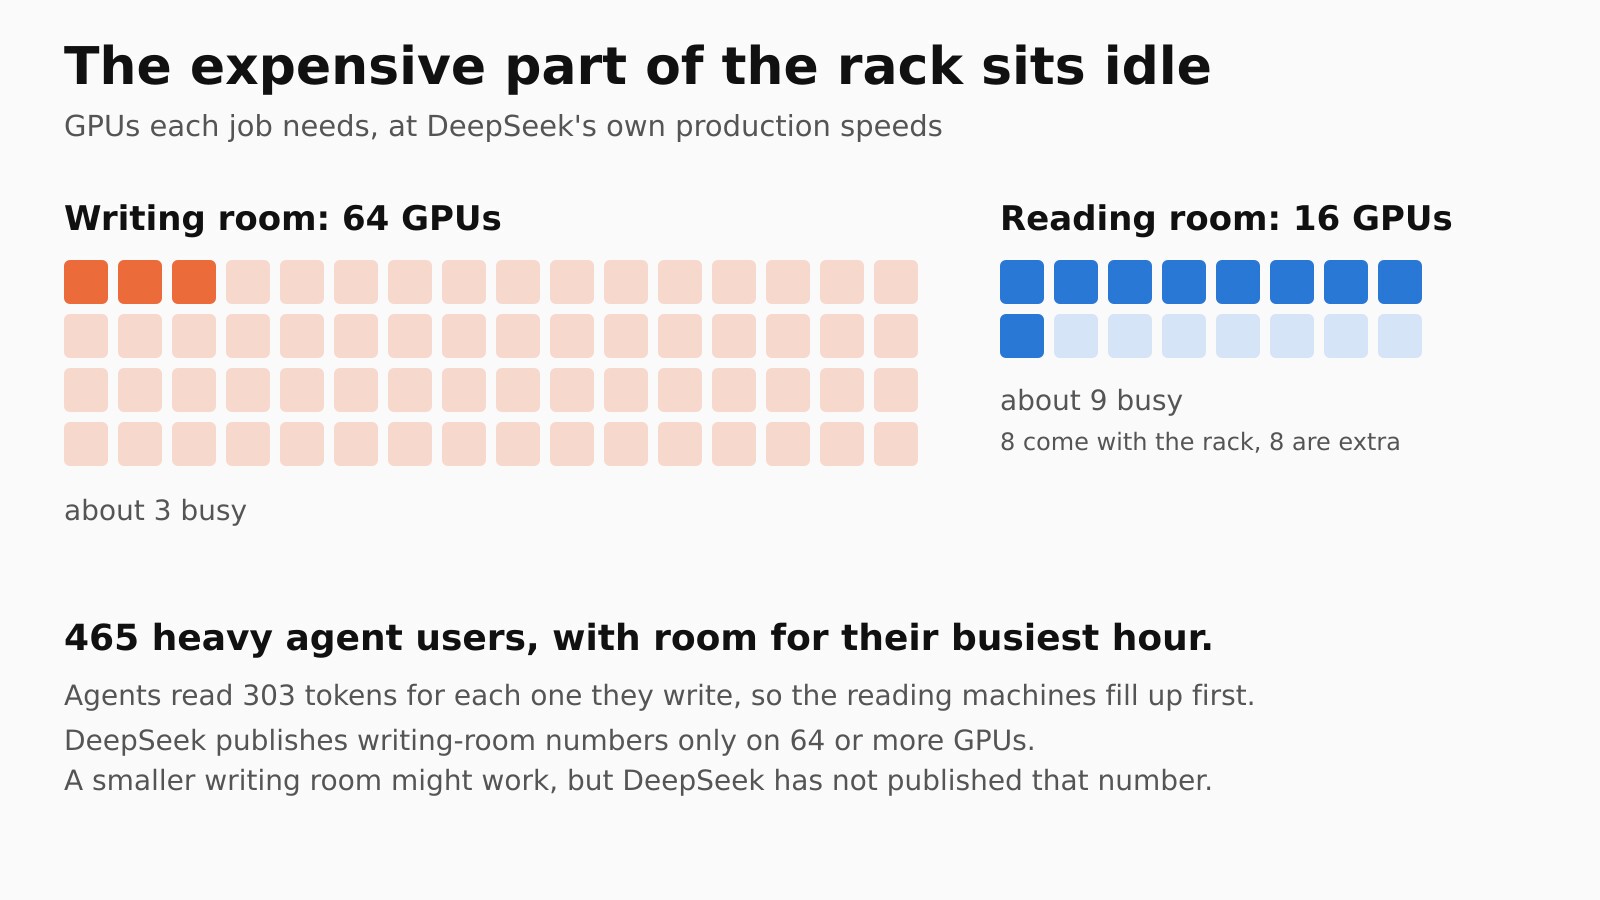
Alles ist auf die Stunde mit der meisten Nutzung ausgelegt, in der dieser Entwickler dreimal so viel neues Material liest wie in seiner durchschnittlichen Stunde. Ein Team mit denselben Arbeitszeiten hat seine Spitzen gleichzeitig.
Manche Kosten stecken nicht in diesen Zahlen, und alle verschieben den Schnittpunkt nach oben. Der größte ist das Regal selbst: Für 465 Leute wie ihn bräuchte es grob geschätzt 300 Terabyte schnellen Speicher und die Maschinen drumherum. Ebenfalls nicht enthalten sind ein Rechenzentrum, das ein 135-kW-Rack mit Flüssigkeit kühlen kann, das Netzwerk, Ersatzteile und Support. Nimm 465 als Untergrenze, und bedenke, dass es um 465 Leute mit je 26 Milliarden Tokens im Monat geht. Bei Leuten, die Agenten halb so viel nutzen, braucht es ungefähr doppelt so viele.
Warum die API so billig sein kann
Ein Rack mit 72 GPUs, das die API von DeepSeek bedient, bringt in der Nebenzeit etwa 2 Millionen Dollar im Monat ein, nach DeepSeeks eigener Zahl von etwa 38 Dollar pro GPU und Stunde. Es zu besitzen kostet in unserem Modell etwa 92.000 im Monat für Hardware und Strom. Dieser Abstand ist kein Gewinn: Er lässt Speicher, Netzwerk, Personal und das Training des Modells weg und nimmt ein immer volles Rack an. Aber er erklärt den Preis. Für DeepSeek ist die Mindestgröße (ein Rack, ein Regal und ein Team) schon bezahlt. Für jedes andere Unternehmen ist sie die Eintrittshürde.
Was bei deiner Teamgröße zu tun ist
Mit Nutzern wie diesem Entwickler und mit DeepSeeks Produktionszahlen als Obergrenze:
| Leute, die Agenten so stark nutzen | Günstigste Option |
|---|---|
| Weniger als etwa 260 | Die API von DeepSeek |
| Etwa 260 bis 290 | Ein gemieteter Server mit 8 GPUs, um 11 % und nur wenn er so schnell läuft wie bei DeepSeek |
| Etwa 430 bis 590 | Zwei gemietete Server, unter API und Rack |
| Mehr als etwa 590 | Ein eigenes Rack |
Zwischen etwa 290 und 430 Leuten gewinnt wieder die API, weil ein zweiter Server nötig ist, der noch nicht voll ist. Wenn dein Team Agenten halb so viel nutzt wie er, verdopple jede Zahl.
Die Zahl, die fehlt
Dieser ganze Artikel hängt an einer Zahl, die es noch nicht gibt: wie schnell DeepInfer auf einem Server mit 8 GPUs läuft, verglichen mit den 64 von DeepSeek. Die Projektseite hat zwei Diagramme, Lesen gemessen auf 4 GPUs und Schreiben auf 64, und das eine, das nötig wäre, fehlt.
Man bekommt sie, indem man diesen Server ein paar Stunden mietet und den Benchmark laufen lässt, der bei DeepInfer dabei ist, für etwa 200 bis 270 Dollar. Liegt das Ergebnis über 58 %, fängt Mieten an, sinnvoll zu werden. Liegt es darunter, gewinnt die API von DeepSeek bei jeder Zahl von Leuten. Gemacht haben wir das noch nicht.
Für Ingenieure
Jede Zahl, Formel und Annahme hinter dem Text.
Daten und Tokens
- Daten. Claude-Code-Transkripte eines Entwicklers (
~/.claude/projects/**/*.jsonl), Zeitraum 2026-09-21 00:00 UTC bis 2026-10-20 11:08 UTC, Duplikate entfernt nach (message id, request id). 129.407 Aufrufe. Modelle: überwiegend Opus 5.5, dazu Opus 4.8, Sonnet 5.5 und Opus 5 (73 Aufrufe an lokale oder synthetische Modelle sind in den Tokens gezählt, aber nicht bepreist). - Ausgabe zählen. Claude Code schreibt beim Streaming mehrere Transkriptzeilen pro Aufruf. Die erste trägt einen unvollständigen
output_tokens-Wert (ihrstop_reasonist noch null). Die Nutzung muss aus der letzten Zeile jedes (message id, request id) kommen. Unser erster Durchlauf nahm die erste Zeile und zählte die Ausgabe um den Faktor 2,4 zu niedrig (36,4 Mio. statt 86,0 Mio.). Alle Zahlen hier nutzen die letzte Zeile. Wenn du das mit deinen eigenen Logs wiederholst, prüfe das zuerst. - Tokens. Cache-Lesezugriffe 25.253 Mio. Cache-Schreibzugriffe 822 Mio. (612 Mio. mit 5-Minuten-TTL, 209 Mio. mit 1-Stunden-TTL). Ungecachte Eingabe 0,3 Mio. Ausgabe 86,0 Mio. Gesamt 26.161 Mio. Cache-Lesezugriffe sind 96,8 % der Eingabetokens (die Zahl im zweiten Bild) und 96,5 % aller Tokens. Etwa 303 gelesene Tokens pro geschriebenem Token. Kontext pro Aufruf: Median 138K, Mittelwert 201K, p90 438K. 26.161 Mio. / 138K = etwa 190.000 typische Kontexte. Stärkster Tag 2026-10-01 mit 4.894 Mio. Tokens, ruhigster 2026-10-18 mit 63 Mio. Stärkste Stunde der Woche (Profil nach Wochenstunde): 3,05x die durchschnittliche Stunde bei neuen Eingabetokens, 3,6x bei allen Tokens.
Preise
- Claude (claude.com/pricing). Bezahlte Abos: 2 x Max 20x zu 200 USD = 400 USD. API-Listenpreise pro MTok: Opus 5.5 Eingabe 4, Ausgabe 20, Cache-Lesen 0,20, Cache-Schreiben 5 (5 min) oder 8 (1 h). Opus 5 und 4.8: 5 / 25 / 0,50 / 6,25 / 10. Sonnet 5.5: 2 / 10 / 0,10 / 2,5 / 4. Gesamt 12.365 USD (Opus 5.5 10.348, Opus 4.8 1.930, Sonnet 5.5 63, Opus 5 24). Davon Opus 5.5: Cache-Lesen 4.488, Cache-Schreiben 4.249, Ausgabe 1.609, ungecachte Eingabe 1.
- Kontrafaktisch ohne Cache bei Claude. Cache-Lesezugriffe zum Eingabepreis jedes Modells statt zum Cache-Lesepreis (Schreiben und Ausgabe unverändert): etwa 109.900 USD, 8,9x die 12.365.
- DeepSeek (deepseek-flash, DeepSeek-V4.1-Flash-1017, api-docs.deepseek.com/quick_start/pricing, 2026-10-20), USD pro MTok Nebenzeit / Hauptzeit: Cache-Treffer 0,003 / 0,006, Cache-Fehlschlag 0,15 / 0,30, Ausgabe 0,60 / 1,20. Hauptzeit ist 01:00-04:00 und 06:00-10:00 UTC, Montag bis Freitag, außer an chinesischen Feiertagen. Den 1. bis 7. Oktober (Woche des Nationalfeiertags) haben wir als Nebenzeit behandelt. Den 25. September (Mondfest) mitzuzählen ändert die Summe um weniger als einen Dollar. Cache-Schreibzugriffe als Fehlschläge berechnet, Lesezugriffe als Treffer. Alles Nebenzeit 251 USD, alles Hauptzeit 501 USD, mit den echten Stunden des Entwicklers 274 USD: 9,4 % seiner Nutzung fallen in die Hauptzeit, und 17,2 % der Rechnung werden zum Hauptzeittarif bezahlt. Ohne die Feiertagsregel wären es 289 USD.
- Verhältnisse. Claude-API = 31x die Abos und 45x die DeepSeek-API. Abos = 1,46x die DeepSeek-API. Preis fürs Wiederlesen, Claude Opus 5.5 gegen DeepSeek in der Nebenzeit: 0,20 / 0,003 = 67x.
- Qualität beim Programmieren. LiveBench agentisches Programmieren, maximaler Aufwand, vollständige Modelle bei ihren eigenen Anbietern, wie in unserem Beitrag vom 2026-10-10 festgehalten: DeepSeek-V4.1-Flash 77,3 (Platz eins von 69), Claude Opus 5.5 71,7, Claude Fable 5.1 66,1, Claude Opus 5 65,2. Artificial Analysis Intelligence Index, 2026-10-16: Claude Opus 5.5 58, DeepSeek V4.1 Flash 39.
DeepInfer und die Produktion von DeepSeek
- DeepInfer (github.com/deepseek-ai/DeepInfer). Apache 2.0. Diese Version bietet Offline-Inferenz. Ursprünglich vor allem auf vLLM gebaut, inspiriert von SGLang und TensorRT-LLM. Unterstützt nur DeepSeek-V4.1-Flash, auf NVIDIA-SM100-GPUs und Huawei-Ascend-950-NPUs. Kernels FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, TileLang. Attention DP / balanciertes CP, MoE EP + EPLB, spekulatives Decoding DSpark (
DEEPINFER_ENABLE_MTP_VARLEN=1,DEEPINFER_USE_NEXTN_DECODEStandard 5), SWA bounded replay (DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact,DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140), asynchrones Scheduling standardmäßig an, batch-invariante Inferenz (DEEPINFER_BATCH_INVARIANT=1, nur NVIDIA). Bauen mitexport DEEPINFER_ACCELERATOR=nvidia; ./build.sh, starten mitpython examples/offline_inference.py.examples/README.mdbetreibt einen Knoten mit 8 GPUs mit--ep 8,--ep 2 --dp 8oder--ep 2 --cp 8und misst mitexamples/sweep/run_sweep.sh. Nicht enthalten: KV-Cache-System, VE/Prefill/Decode-Trennung, Lastverteilung zwischen DP-Replikaten und kein dokumentierter HTTP-Server. DeepSeek hat außerdem deepseek-recipe veröffentlicht (vom API-Protokoll zu Tokens und zurück, in Rust mit Python-Bindings). - Checkpoint.
deepseek-ai/DeepSeek-V4.1-Flash-1017: 763B Parameter, etwa 510 GB (überwiegend in 4 Bit gepackte Experten und FP8). - README-Benchmark. 4 SM100-GPUs für Prefill und 64 für Decode, jede Gruppe in einer Scale-up-Domäne. Prefill-Diagramm auf den 4 GPUs (EP4DP4, Kontext 131.072): etwa 60K tok/s/GPU bei Batches von 4.096 Tokens bis etwa 89,5K bei 65.536. Decode-Diagramm auf den 64 GPUs (EP64DP64, nextn=3, 75 % Akzeptanz): etwa 26,3K tok/s/GPU bei etwa 103 tok/s pro Nutzer, bis etwa 2,6K bei etwa 325.
- Produktion von DeepSeek (Zhihu-Beitrag, Tabelle mit Reserve für Verkehrsspitzen; auf welcher Hardware gemessen wurde, steht dort nicht). Prefill 60K tok/s/GPU ohne Cache, 1,5 Mio. mit Cache-Treffern, 96 % durchschnittliche Trefferquote, 77K durchschnittliche Eingabe, TTFT 400 ms im Mittel und 1.000 ms im P99. Decode 14K tok/s/GPU, 230 tok/s pro Nutzer (300 bei Code). P:D nahe 1:1. 155 Billionen Tokens am Tag auf einem Cluster. 38 USD Umsatz pro GPU-Stunde zu Nebenzeitpreisen. Prefill auf Maschinen mit 8 GPUs (EP2-8), Decode auf Superknoten mit 64-128 GPUs (EP64-128). KV-Cache auf einem eigenen 3FS-Cluster, etwa 100 PiB SSD, Seiten zu 128 Tokens, TTL 3 Tage für Agentenverkehr und 7 für Chat, Spitzenlesen 10 TiB/s. Jede Prefill-Maschine kann jeden Präfix treffen.
- Last pro Nutzer (30-Tage-Mittel über 2.592.000 s): 33,2 tok/s geschrieben, 317 tok/s neue Eingabe, 9.743 tok/s gecachte Eingabe, 10.060 tok/s Eingabe gesamt. GPU-Anteil bei DeepSeeks Produktionsraten: Prefill 10.060 / 1,5 Mio. = 0,0067 GPU (etwa 150 Nutzer pro GPU), Decode 33,2 / 14K = 0,0024 GPU (etwa 420 Nutzer pro GPU). Mit 3x Reserve für die Spitzenstunde: 0,0273 GPU pro Nutzer.
- Ohne Cache. Prefill pro Nutzer 10.060 / 60K = 0,168 GPU, 25-mal mehr.
Gemietete Server
- Preise (runpod.io/pricing, 2026-10-20, stundenweise, kein Reservierungspreis veröffentlicht). B200 7,99 USD pro GPU-Stunde in der Secure Cloud, 5,98 in der Community Cloud; B300 8,99 / 6,94. 8 x 7,99 x 730 h = 46.662 USD im Monat, 4 GPUs 23.331, Strom inklusive. 2 B200 (etwa 360 GB) können den Checkpoint nicht laden; 4 (etwa 720 GB) lassen etwa 200 GB für den KV-Cache.
- Kapazität. 8 GPUs / 0,0273 = 293 Nutzer, 4 GPUs 146, bei DeepSeeks Raten (220 und 110 bei 75 %, 147 und 73 bei 50 %). Ohne Cache reichen 8 GPUs für 8 / ((0,168 + 0,0024) x 3) = etwa 15 Nutzer.
- Break-even gegen 274 USD. 8 GPUs: 46.662 / 274 = 170 Nutzer nur Miete, (46.662 + 25.000) / 274 = 262 mit Ingenieuren. 4 GPUs: 85 nur Miete; mit Ingenieuren bräuchte es 176, und es passen nur 146, also gibt es keinen Break-even. Community-Preis, 8 GPUs: 127 und 219.
- Geschwindigkeitsschwelle. Mietkosten pro Nutzer bei voller Auslastung 46.662 / 293 = 159 USD, also muss die Geschwindigkeit pro GPU 159 / 274 = 58 % der Produktionsraten von DeepSeek erreichen, damit Mieten die API bei irgendeiner Größe schlägt, ohne Ingenieure (43 % zum Community-Preis).
- Mehrere Knoten (Secure, 100 %, Ingenieure inklusive): 1 Knoten 71.662 USD bis 293 Nutzer; 2 Knoten 118.324 bis 586 (schlagen die API ab 432 und das eigene Rack, 127.374, im ganzen Bereich); 3 Knoten 164.986; 4 Knoten 211.648 bei 1.000 Nutzern, gegen 137.614 fürs Rack und 274.000 für die API.
- Vorgeschlagener Test. Etwa 2 h auf 4 GPUs zum Installieren und Herunterladen der Gewichte, dazu 2 bis 3 h auf 8 für die
run_sweep.sh-Durchläufe für Prefill und Decode mit 128K Kontext: etwa 200 bis 270 USD. Nicht durchgeführt. - deepseek-one-gpu. DeepSeek-V4.1-Flash Q2_K auf einer RTX PRO 6000 mit 96 GB plus Host-RAM. 8 Batch-Plätze mit 69.632 Positionen, bis 262.144 für eine einzelne Anfrage. 84,1 % der Aufrufe des Entwicklers überschreiten 69.632, 23,5 % überschreiten 262.144. Ein Server mit mehreren GPUs wurde nicht getestet.
Eigenes Rack
- Hardware. Ein GB300 NVL72: 72 Blackwell-Ultra-GPUs und 36 Grace-CPUs in einer NVLink-Domäne, 288 GB HBM3e pro GPU. Aufteilung 64 Decode + 8 Prefill. Preis 3,5 Mio. USD, unsere Annahme (Spanne 3-4 Mio.). Together AI und Clusterbid nennen keinen Rackpreis. Das GB200 NVL72 (Compute Capability 10.0, SM100, das Ziel, das DeepInfer nennt) ist dasselbe NVLink-Rack mit 72 GPUs. Wir haben es nicht getrennt gerechnet, und sein Preis ist ebenfalls ungeprüft. Zusätzliche Prefill-GPUs zu den Kosten pro GPU des Racks, je 48,6K USD, in Einheiten zu 8.
- Monatliche Kosten. Abschreibung 3,5 Mio. / 48 Monate = 72.917 USD. Strom 135 kW x PUE 1,3 x 730 h x 0,15 USD/kWh = 19.217 USD. Zwei Ingenieure 25.000 USD (je 150K USD im Jahr mit Nebenkosten). Basis 117.134 USD. Nur Hardware und Strom 92.134 USD. Jede zusätzliche Prefill-GPU 1.280 USD im Monat (48,6K / 48 + 267 Strom). Grenzkosten pro Nutzer 1.280 x 0,0067 x 3 = etwa 26 USD.
- Reserve. 3x Durchschnittslast beim Prefill. Die 8 Prefill-GPUs des Racks reichen für etwa 397 Nutzer bei 3x (etwa 1.190 bei 1x). Bei 465 Nutzern: etwa 9,4 Prefill-GPUs und etwa 3,3 Decode-GPUs beschäftigt.
- Break-even (erste Nutzerzahl, bei der die eigenen Kosten bei oder unter 274 USD x Nutzer liegen, Prefill in Einheiten zu 8 ergänzt). Hardware + Strom: 92.134 / 274 = 337 Nutzer. Mit Ingenieuren: 117.134 / 274 = 428 liegt über den 397, die das Prefill des Racks abdeckt, also kommt eine Einheit zu 8 dazu: 127.371 / 274 = etwa 465. Rack zu 3 Mio.: 299 und 390. Rack zu 4 Mio.: 375 und 507. Die Zahl der Leute für den Break-even skaliert ungefähr mit 1 / Nutzung pro Person.
| Nutzer | DeepSeek-API (USD/Monat) | Eigenes Rack (USD/Monat) | Eigenes Rack pro Nutzer |
|---|---|---|---|
| 100 | 27.416 | 117.134 | 1.171 |
| 200 | 54.832 | 117.134 | 586 |
| 300 | 82.248 | 117.134 | 390 |
| 400 | 109.664 | 127.371 | 318 |
| 500 | 137.080 | 127.371 | 255 |
| 750 | 205.620 | 127.371 | 170 |
| 1.000 | 274.160 | 137.608 | 138 |
| 2.000 | 548.320 | 168.319 | 84 |
| 5.000 | 1.370.800 | 239.979 | 48 |
- Umsatzprüfung. In der Nebenzeit bringt eine Prefill-GPU bei DeepSeeks Mischung mit 96 % Treffern etwa 47,95 USD/h ein und eine Decode-GPU 30,24 USD/h, passend zu DeepSeeks 38. 72 GPUs x 38 USD x 730 h = etwa 2,0 Mio. USD im Monat. Ein auf diesen Verkehr abgestimmtes Rack (wenn Decode auf weniger GPUs liefe) würde etwa 7.900 Nutzer wie diesen aufnehmen, 7.900 x 251 USD (alles Nebenzeit) = etwa 2,0 Mio. USD im Monat.
- Größe des Regals, grob. 465 Nutzer x 872 Mio. Tokens am Tag = 405 Mrd. Tokens am Tag, 0,26 % von DeepSeeks 155 Billionen. Derselbe Anteil an etwa 100 PiB sind etwa 300 TB. Nach Tokens zu skalieren ist grob. Nicht bepreist.
Grenzen
- Der Rackpreis ist unsere Annahme, kein Angebot, und keine Quelle, die wir öffnen konnten, nennt einen. Auch die Schätzungen zum Stromverbrauch des Racks schwanken (etwa 120 bis 140 kW je nach Quelle).
- Der Speicher für das Regal steckt nicht im Kostenmodell. Ebenso wenig Platz im Rechenzentrum oder Colocation für ein flüssiggekühltes 135-kW-Rack, Netzwerk, Ersatzteile und Support. All das hebt den Break-even.
- Das README von DeepInfer nennt SM100-GPUs, und CUDA führt Blackwell Ultra (GB300, B300) als eigene Compute Capability (sm_103). DeepInfer auf einem GB300 mit DeepSeeks Produktionsraten zu betreiben, ist unsere Annahme, und DeepSeek sagt nicht, welche Hardware diese Raten erzeugt hat.
- DeepSeek hat keine DeepInfer-Zahlen mit einem kleineren Schreibraum veröffentlicht. Die Rackzahlen setzen einen Schreibraum mit 64 GPUs voraus. Die Zahlen für gemietete 4 und 8 GPUs setzen DeepSeeks Raten pro GPU voraus, oder den angegebenen Bruchteil davon, sowie einen funktionierenden Cache, den DeepInfer nicht mitliefert. Beides haben wir nicht gemessen.
- Das Nutzermodell ist eine einzige Person, und eine intensive. Ein Unternehmen hat leichtere Nutzer, andere Arbeitszeiten und andere Gewohnheiten. Seine Prompts sind länger als der Durchschnitt bei DeepSeek (77K), daher ist seine Leselast pro Token wahrscheinlich höher, als die Produktionsraten nahelegen.
- Claude und DeepSeek zerlegen Text unterschiedlich in Tokens, um einen Betrag, den wir nicht gemessen haben, daher ist die Umrechnung auf DeepSeek ungefähr. Der Vergleich betrifft nur den Preis. DeepSeek-V4.1-Flash ist ein anderes Modell als Opus 5.5, und dieselbe Arbeit kann damit eine andere Zahl von Durchläufen und Tokens brauchen.
- Das Abo ist eine Pauschale mit Nutzungslimits für Einzelpersonen. Es ist kein Firmenplan.
- DeepSeeks Produktionsraten stammen aus seinem eigenen Dienst, mit eigenem Regal, eigenen Lastverteilern und eigener Verkehrsmischung. Ein erster Aufbau wird wahrscheinlich darunter liegen.
- Datenschutz, Kontrolle und Modellwahl bleiben im Kostenvergleich bewusst außen vor.