400, 12 365 ou 274 dollars : ce que coûte un mois d'agent de code, et quand votre propre DeepInfer devient rentable
Un développeur, 26,2 milliards de tokens en 30 jours, trois factures. Et combien de personnes comme lui il faut pour qu'un DeepInfer maison soit rentable.
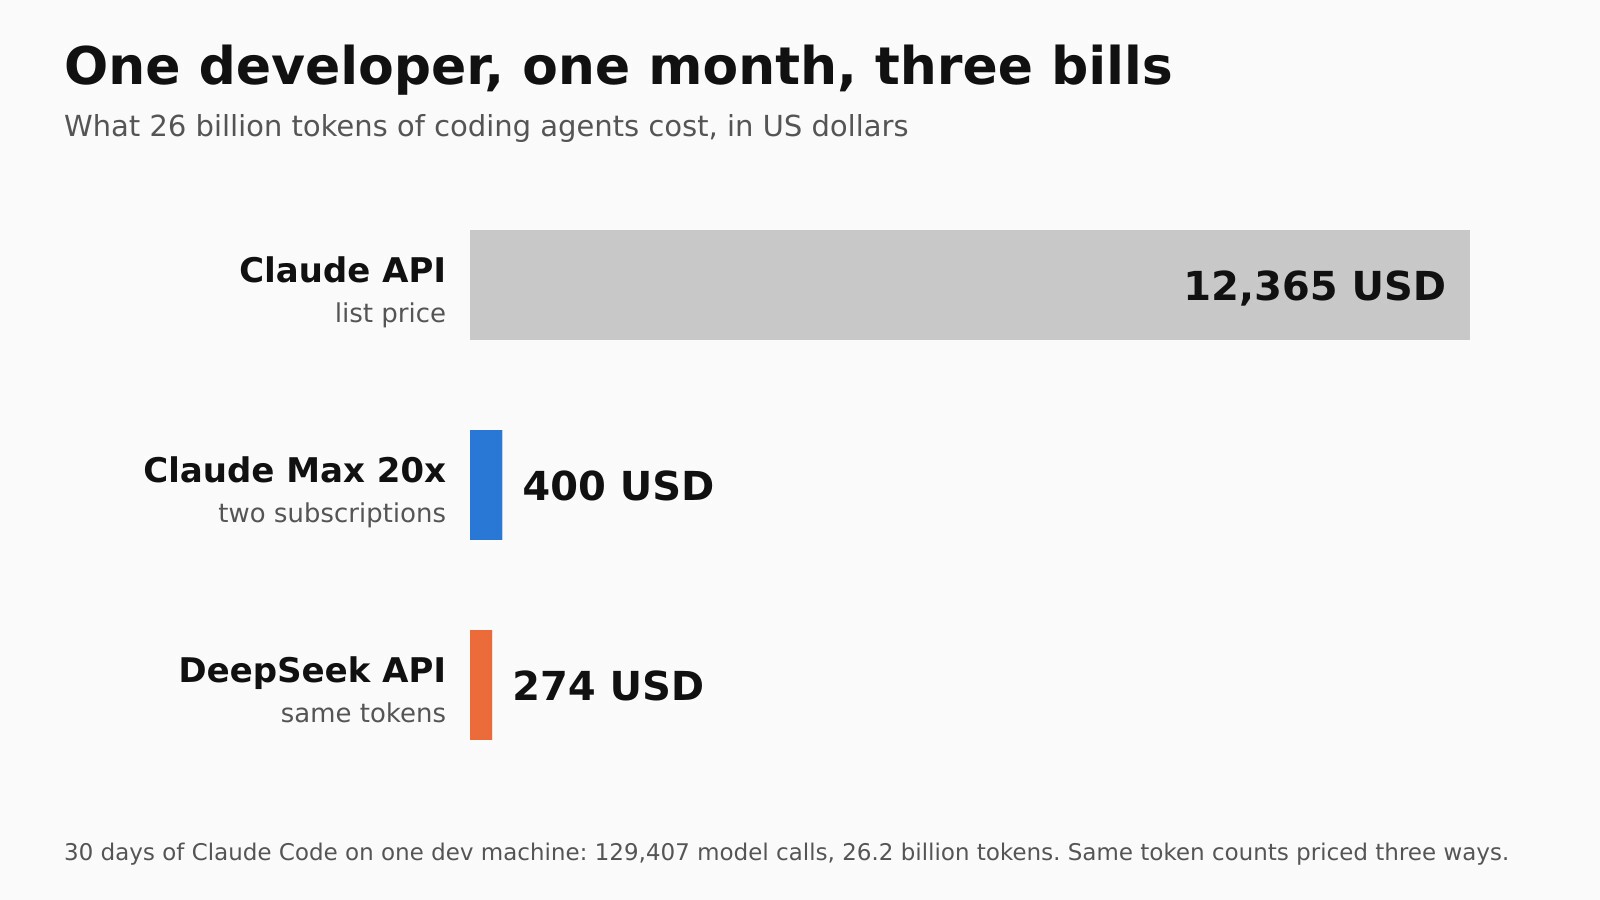
L'un de nos développeurs a payé 400 dollars le mois dernier pour son agent de code. Le même travail, au prix catalogue de l'API Claude, revient à 12 365 dollars. Sur l'API de DeepSeek, cela aurait été 274.
Les trois chiffres viennent de sa propre machine. Nous avons pris ses journaux Claude Code du 21 septembre au 20 octobre et compté chaque appel que l'agent a fait au modèle : 129 407 appels et 26,2 milliards de tokens (un token est un morceau de mot). Puis nous avons chiffré ce même mois de trois façons.
Ce mois-ci, DeepSeek a publié en open source DeepInfer, le moteur avec lequel il sert son propre modèle. D'où la question que poserait n'importe quel CTO : si toute mon entreprise travaillait comme ça, à partir de combien de personnes faire tourner ce moteur sur nos propres machines coûte-t-il moins cher que de payer DeepSeek au token ?
La réponse dépend moins des machines qu'il n'y paraît. Un agent de code passe sa journée à relire la même chose, et celui qui a un endroit où garder ce qui a déjà été lu paie beaucoup moins. C'est justement la pièce que DeepInfer ne fournit pas.
| Ce qu'il a payé (deux abonnements Claude Max 20x) | 400 USD |
| Les mêmes tokens au prix catalogue de l'API Claude | 12 365 USD |
| Les mêmes tokens sur l'API de DeepSeek | 274 USD |
| Tokens que l'agent lit pour chaque token écrit | environ 303 |
| Un serveur loué de 8 GPU bat l'API à partir de | environ 262 personnes comme lui, et seulement s'il va aussi vite que chez DeepSeek |
| Votre propre rack de 72 GPU bat l'API à partir de | environ 465 personnes comme lui |
| À 1 000 personnes, coût par personne et par mois | 138 USD avec votre rack, 274 sur l'API |
Un agent de code lit surtout
À chaque étape (ouvrir un fichier, lancer un test, modifier une ligne), l'agent renvoie au modèle toute la conversation : les instructions, les fichiers ouverts et tout ce qui a été dit jusque-là. Un appel typique transportait environ 138 000 tokens, à peu près un livre de 400 pages. Le modèle écrit quelques centaines de tokens, et on recommence. Sur un mois, cela fait environ 190 000 livres lus.
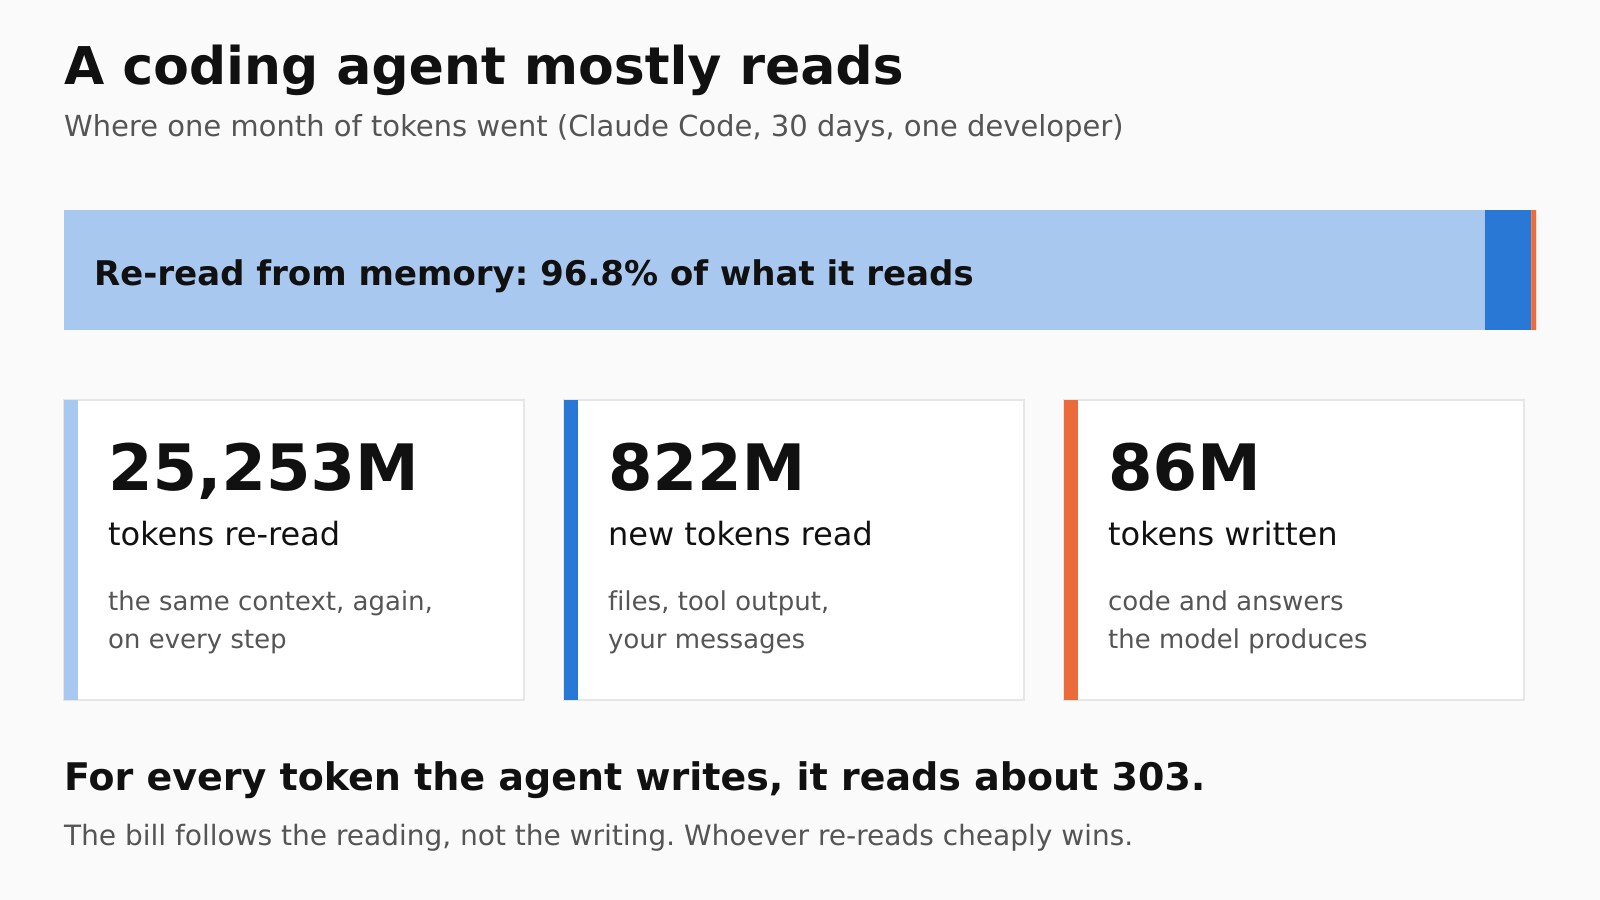
Sur les 26,2 milliards de tokens du mois, 25 253 millions étaient le même contexte relu. Le matériau nouveau (fichiers, résultats des outils et messages du développeur) représentait 822 millions. Ce que le modèle a vraiment écrit, le code et les réponses, 86 millions. Pour chaque token écrit, l'agent en a lu environ 303.
Les fournisseurs le savent et gardent le contexte récent sous la main pour que relire coûte peu. Imaginez une étagère à côté du modèle : ce qu'il a déjà lu y reste, et la fois suivante il le reprend tout prêt. Chez Claude, relire depuis l'étagère coûte un vingtième de la lecture de quelque chose de nouveau, et 96,8 % de ce que cet agent a lu en venait. Sans étagère, le même mois sur l'API Claude aurait coûté plus de 100 000 dollars, environ neuf fois plus.
Trois factures pour le même travail
Face au prix catalogue de Claude, l'abonnement est de loin le moins cher, mais il a un plafond. Un forfait Max 20x coûte 200 dollars par mois selon la page de tarifs de Claude, avec une limite d'usage par fenêtre de cinq heures, et il en paie deux. Pour une personne, ça marche. Ce n'est pas un forfait pensé pour toute une entreprise.
Le prix catalogue, c'est ce que coûtent ces tokens via l'API Claude, et c'est généralement ainsi que paie une entreprise quand les forfaits individuels ne suffisent plus. C'est 31 fois ce qu'il a payé, et presque rien ne vient de l'écriture. Sur les 10 348 dollars partis dans Opus 5.5, le code et les réponses ont coûté environ 1 600. Environ 4 500 sont allés à la relecture de l'étagère et environ 4 250 à y déposer le matériau nouveau la première fois.
L'API de DeepSeek, avec les mêmes tokens et à ses tarifs publiés, revient à 274 dollars, 45 fois moins que l'API Claude. Presque tout l'écart tient à la relecture : un million de tokens relus coûte un tiers de centime chez DeepSeek en heures creuses et 20 centimes chez Claude Opus 5.5.
C'est une comparaison de prix, rien de plus. DeepSeek-V4.1-Flash n'est pas Opus, il découpe le texte en tokens autrement (nous n'avons pas mesuré de combien) et nous n'avons pas rejoué le mois avec lui. Un autre modèle peut avoir besoin de plus ou de moins d'allers-retours pour finir la même tâche.
Le modèle bon marché sait-il coder ?
Sur le test le plus proche de ce travail, oui. LiveBench est un classement indépendant qui change souvent ses questions pour que les modèles ne puissent pas les apprendre. Dans sa catégorie de programmation agentique, où le modèle doit mener à bien une vraie tâche de code étape par étape, DeepSeek-V4.1-Flash était premier sur 69 modèles quand nous avons regardé le 10 octobre.
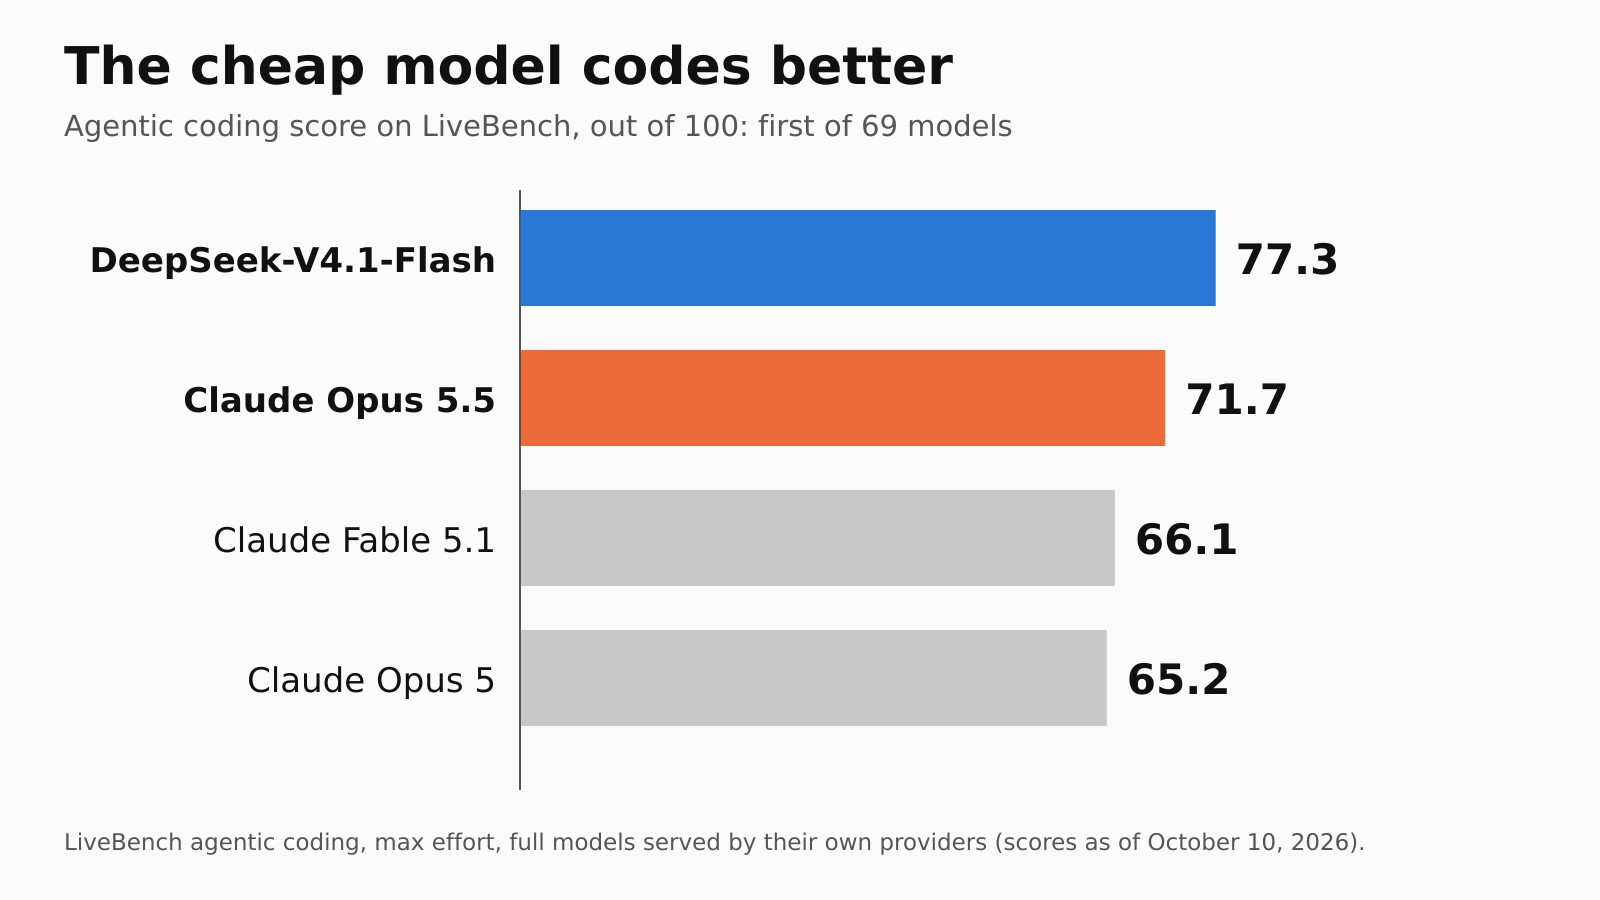
C'est le même tableau que nous avons utilisé quand nous avons fait tourner ce modèle sur deux cartes graphiques. Sur une note plus large, l'Intelligence Index d'Artificial Analysis, qui mélange de nombreux types de tests, Opus 5.5 est nettement devant : 58 contre 39 le 16 octobre. Flash code très bien pour une fraction du prix, et Opus est plus fort dans l'ensemble. Le bon choix dépend de ce à quoi vos agents passent leur journée.
Comment DeepSeek sert DeepSeek
DeepSeek a expliqué le fonctionnement de son service dans un long billet sur Zhihu, un site chinois de questions-réponses. Le plus simple est de l'imaginer comme un bâtiment avec une porte d'entrée, deux salles et l'étagère de tout à l'heure.
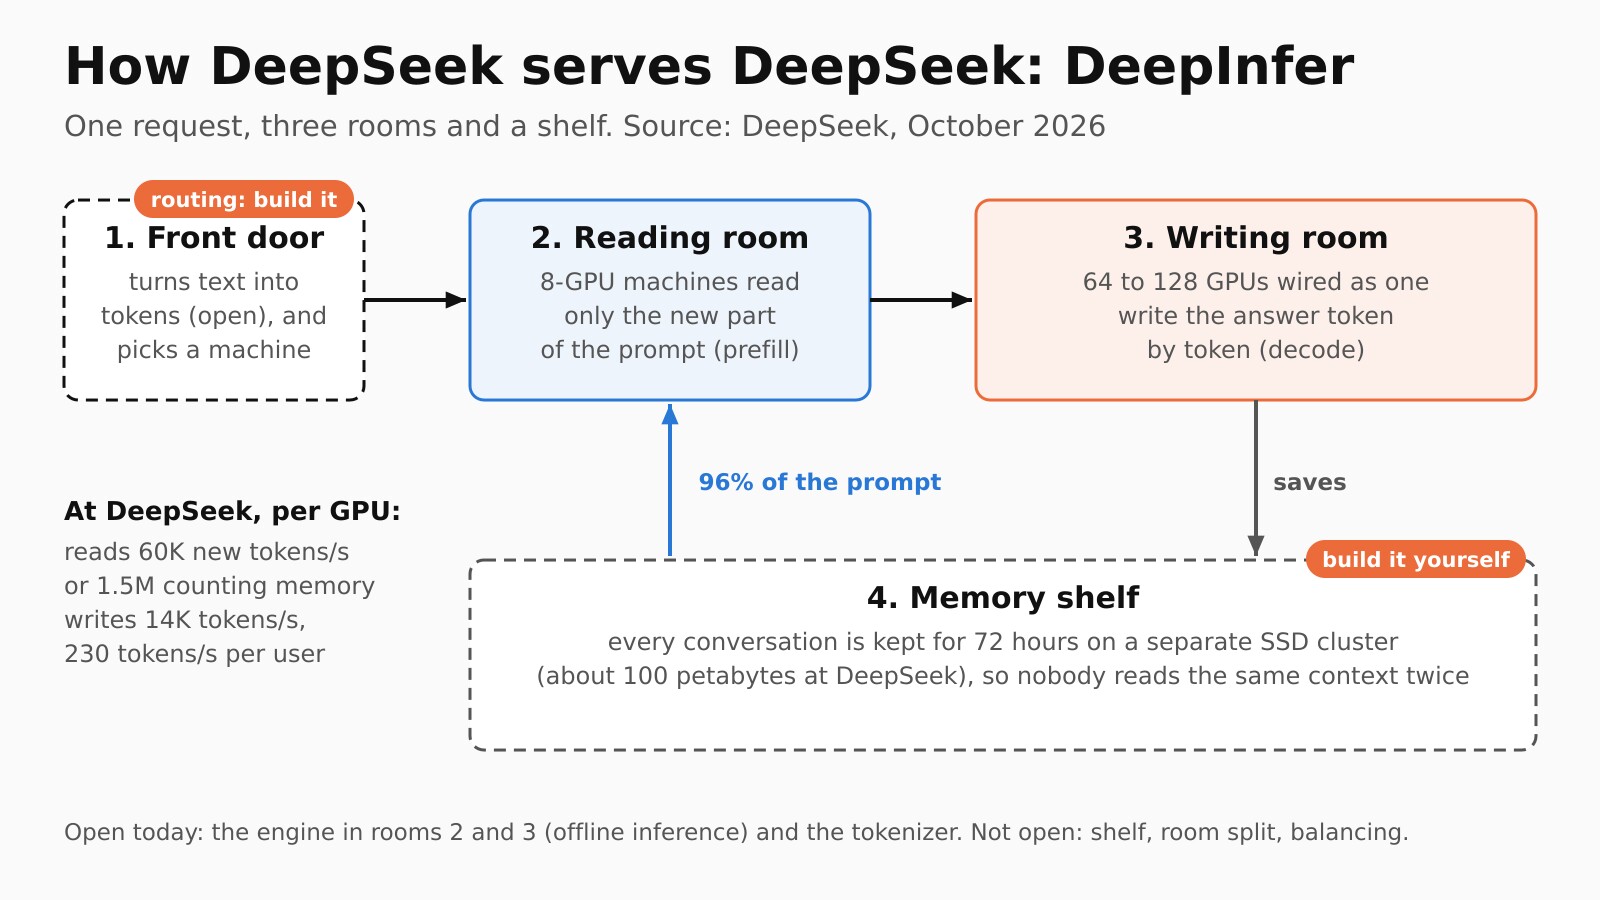
Une requête entre par la porte, qui la transforme en tokens et l'envoie à une machine libre. Dans la salle de lecture, des serveurs de 8 GPU ne lisent que la partie nouvelle du prompt, car le reste est déjà sur l'étagère. Dans la salle d'écriture, 64 à 128 GPU reliés comme s'ils formaient une seule machine écrivent la réponse token par token et déposent la conversation sur l'étagère pour le tour suivant.
L'étagère de DeepSeek, ce sont environ 100 pétaoctets de stockage à part, et elle garde chaque conversation 72 heures après qu'elle s'est arrêtée. Elle fonctionne comme le backline partagé d'un festival : les amplis restent sur scène et chaque groupe s'y branche. N'importe quelle machine de lecture peut reprendre n'importe quelle conversation. En moyenne, 96 % de chaque prompt en sort, presque autant que les 96,8 % de notre développeur chez Claude.
Avec cette étagère, un GPU de lecture au rythme de DeepSeek suffit pour environ 150 développeurs comme lui, et un GPU d'écriture pour environ 420. Ses prompts sont plus longs que la moyenne de DeepSeek (138 000 tokens contre 77 000), donc la charge réelle de quelqu'un comme lui est probablement un peu plus élevée.
Ce que DeepSeek a ouvert, c'est le moteur des deux salles, plus la pièce qui transforme les requêtes en tokens comme le fait son API. La page du projet elle-même indique qu'il manque trois choses "nécessaires à un service d'inférence complet" : l'étagère, la séparation entre machines de lecture et d'écriture (le moteur fait déjà l'essentiel du travail pour cela) et le code qui répartit le trafic. Selon le billet Zhihu, ce code est lié à son infrastructure interne, même si le billet explique en détail le fonctionnement de chaque partie. Une entreprise qui veut ce montage a donc un chantier devant elle. Dans nos calculs, deux ingénieurs à temps plein.
Le mérite revient à l'équipe de DeepSeek, qui a écrit DeepInfer, l'a publié sous une licence qui autorise l'usage commercial et a décrit sa conception de production avec de vrais chiffres. DeepInfer est né sur vLLM et reprend des idées de SGLang et de TensorRT-LLM, donc ces équipes sont aussi dans le lot. Notre part, c'est l'autre moitié : mesurer un vrai gros utilisateur et calculer ce que ces chiffres signifient pour une entreprise.
Le premier palier : louer un serveur
Pour commencer, pas besoin d'acheter quoi que ce soit. Les exemples de DeepInfer font tourner le modèle sur un serveur de 8 GPU, et cela se loue à l'heure. RunPod propose la B200, la puce pour laquelle DeepInfer est écrit, à 7,99 dollars par GPU et par heure. Huit reviennent à 46 662 dollars par mois, électricité comprise.
À la vitesse de production de DeepSeek, ce serveur suffit pour environ 293 personnes comme notre développeur, avec de la marge pour l'heure la plus chargée. En ajoutant les deux ingénieurs, il bat l'API à partir d'environ 262. À 293 personnes, il revient à 245 dollars par personne contre 274, 11 % de moins. C'est une marge mince pour tout ce qu'il faut construire.
Avec 4 GPU, le modèle rentre encore avec de la place pour travailler (il pèse environ 510 Go, et sur 2 B200 il ne se charge même pas). Ils coûtent 23 331 dollars par mois et suffisent pour environ 146 personnes. En ne comptant que la location, ils battent l'API à partir d'environ 85. Avec les ingénieurs, ils n'y arrivent jamais : il faudrait 176 personnes, et elles ne rentrent pas.
| Location sur RunPod (B200, à l'heure) | Par mois | Personnes à la vitesse de DeepSeek | Bat l'API à partir de (location seule) | Bat l'API à partir de (avec deux ingénieurs) |
|---|---|---|---|---|
| 4 GPU | 23 331 USD | 146 | 85 | jamais |
| 8 GPU | 46 662 USD | 293 | 170 | 262 |
Tout cela repose sur deux hypothèses que personne n'a encore vérifiées.
La première, c'est la vitesse de chaque GPU. Les chiffres de DeepSeek viennent de salles d'écriture de 64 GPU ou plus, où chacun garde un petit morceau du modèle et sert beaucoup de monde à la fois. Dans un serveur de 8 GPU, chaque GPU porte une plus grande part du modèle et a moins de mémoire pour les utilisateurs, donc il ira moins vite. Si chaque GPU loué n'atteint pas 58 % de ce que fait un GPU en production chez DeepSeek, louer ne bat l'API pour aucun nombre de personnes.
La seconde, c'est l'étagère. Sans elle, chaque relecture redevient une lecture complète, et un serveur de 8 GPU suffit pour environ 15 personnes comme lui au lieu de 293.
Notre propre moteur à un GPU, deepseek-one-gpu, ne convient pas non plus à ce profil. Il réserve environ 70 000 tokens par personne quand il en sert plusieurs à la fois, et 84 % des appels de ce développeur étaient plus gros. Il est conçu pour de petites équipes et un usage plus léger.
Le grand palier : votre propre rack
Le plus grand montage pour lequel DeepSeek publie des chiffres complets est une salle d'écriture de 64 GPU. Le plus proche que l'on puisse acheter est un rack NVIDIA de 72 GPU (une armoire où les GPU sont reliés comme une seule machine), et nous l'avons chiffré à environ 3,5 millions de dollars. C'est notre hypothèse : nous n'avons trouvé aucun prix publié vérifiable.
Votre propre rack bat l'API de DeepSeek à partir d'environ 465 personnes qui utilisent les agents comme lui. En ne comptant que le matériel et l'électricité, à partir de 337.
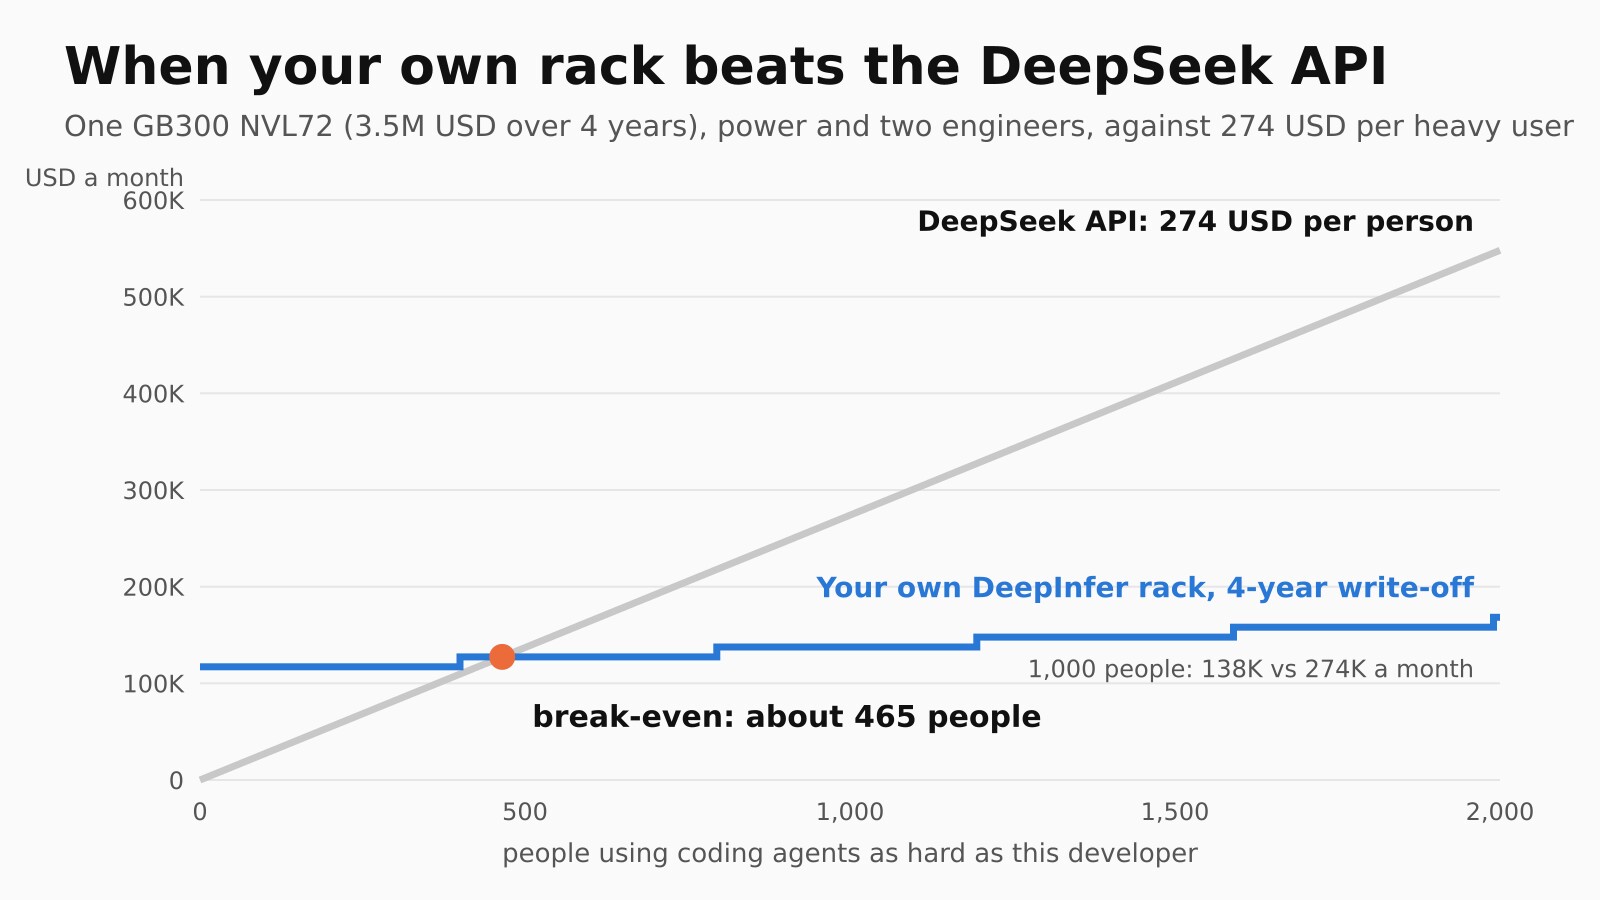
Le rack, amorti sur quatre ans, revient à environ 73 000 dollars par mois. L'électricité ajoute environ 19 000 et les deux ingénieurs 25 000. Cela fait environ 117 000 dollars par mois avant le premier utilisateur. Ensuite, chaque personne supplémentaire coûte environ 26 dollars par mois, et c'est pourquoi l'écart avec l'API se creuse vite : à 1 000 personnes, 138 000 dollars par mois contre 274 000, la moitié. Le prix du rack est ce qui fait le plus bouger le résultat : à 3 millions, le croisement descend à environ 390 personnes, à 4 millions il monte à environ 507.
Avec ce trafic, l'essentiel du rack attend. À 465 personnes, environ trois des 64 GPU d'écriture travaillent, et ces 64 représentent l'essentiel du prix. Ce qui se remplit, c'est la lecture : les 8 GPU de lecture du rack couvrent environ 397 personnes, il faut donc en ajouter 8.
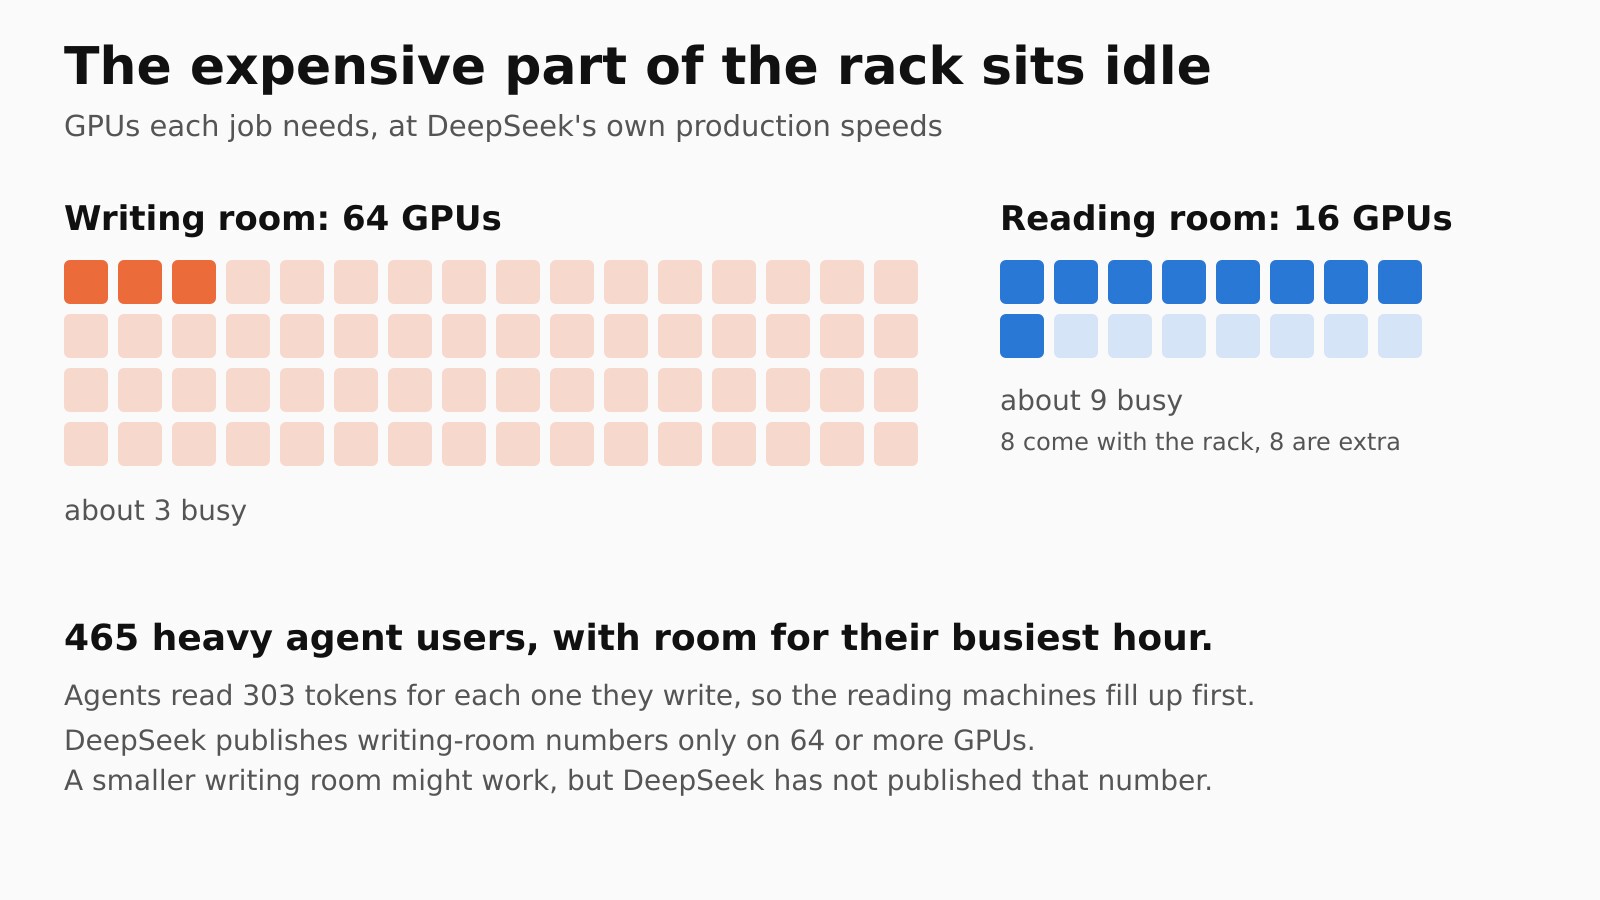
Tout est dimensionné pour l'heure la plus chargée, où ce développeur lit trois fois plus de matériau nouveau que pendant son heure moyenne. Une équipe qui travaille aux mêmes horaires a ses pics en même temps.
Certains coûts ne figurent pas dans ces chiffres, et tous repoussent le croisement vers le haut. Le plus gros est l'étagère elle-même : pour 465 personnes comme lui, il faudrait, à la louche, 300 téraoctets de stockage rapide et les machines autour. Sont aussi exclus un centre de données capable de refroidir par liquide un rack de 135 kW, le réseau, les pièces de rechange et le support. Prenez 465 comme un minimum, et gardez en tête qu'il s'agit de 465 personnes à 26 milliards de tokens par mois chacune. Avec des gens qui utilisent les agents moitié moins, il en faut à peu près deux fois plus.
Pourquoi l'API peut être si bon marché
Un rack de 72 GPU qui sert l'API de DeepSeek rapporte environ 2 millions de dollars par mois en heures creuses, d'après le chiffre de DeepSeek lui-même d'environ 38 dollars par GPU et par heure. Le posséder coûte, dans notre modèle, environ 92 000 par mois en matériel et électricité. Cet écart n'est pas un bénéfice : il laisse de côté le stockage, le réseau, le personnel et l'entraînement du modèle, et suppose un rack toujours plein. Mais il explique le prix. Pour DeepSeek, la taille minimale (un rack, une étagère et une équipe) est déjà payée. Pour toute autre entreprise, c'est la barrière à l'entrée.
Que faire selon la taille de votre équipe
Avec des utilisateurs comme ce développeur, et avec les chiffres de production de DeepSeek comme plafond :
| Personnes qui utilisent les agents à ce point | Option la moins chère |
|---|---|
| Moins d'environ 260 | L'API de DeepSeek |
| Environ 260 à 290 | Un serveur loué de 8 GPU, de 11 % et seulement s'il va aussi vite que chez DeepSeek |
| Environ 430 à 590 | Deux serveurs loués, sous l'API et sous le rack |
| Plus d'environ 590 | Votre propre rack |
Entre environ 290 et 430 personnes, l'API repasse devant, car il faut un second serveur qui n'est pas encore plein. Si votre équipe utilise les agents moitié moins que lui, doublez chaque chiffre.
Le chiffre qui manque
Tout cet article dépend d'un chiffre qui n'existe pas encore : à quelle vitesse DeepInfer tourne sur un serveur de 8 GPU, comparé aux 64 de DeepSeek. La page du projet a deux graphiques, la lecture mesurée sur 4 GPU et l'écriture sur 64, et celui qu'il faudrait n'y est pas.
On peut l'obtenir en louant ce serveur quelques heures et en lançant le benchmark fourni avec DeepInfer, pour environ 200 à 270 dollars. Si le résultat dépasse 58 %, louer commence à avoir du sens. S'il est en dessous, l'API de DeepSeek gagne quel que soit le nombre de personnes. Nous ne l'avons pas encore fait.
Pour les ingénieurs
Chaque chiffre, formule et hypothèse derrière le texte.
Données et tokens
- Données. Journaux Claude Code d'un développeur (
~/.claude/projects/**/*.jsonl), fenêtre du 2026-09-21 00:00 UTC au 2026-10-20 11:08 UTC, doublons supprimés par (message id, request id). 129 407 appels. Modèles : surtout Opus 5.5, plus Opus 4.8, Sonnet 5.5 et Opus 5 (73 appels à des modèles locaux ou synthétiques sont comptés en tokens mais pas chiffrés). - Compter la sortie. Claude Code écrit plusieurs lignes de journal par appel pendant le streaming. La première porte un
output_tokenspartiel (sonstop_reasonest encore null). Il faut prendre l'usage dans la dernière ligne de chaque (message id, request id). Notre premier passage utilisait la première ligne et sous-comptait la sortie d'un facteur 2,4 (36,4 M au lieu de 86,0 M). Tous les chiffres ici utilisent la dernière ligne. Si vous refaites l'exercice sur vos journaux, vérifiez ce point d'abord. - Tokens. Lectures de cache 25 253 M. Écritures de cache 822 M (612 M avec TTL de 5 minutes, 209 M avec TTL d'1 heure). Entrée hors cache 0,3 M. Sortie 86,0 M. Total 26 161 M. Les lectures de cache représentent 96,8 % des tokens d'entrée (le chiffre de la deuxième image) et 96,5 % du total. Environ 303 tokens lus par token écrit. Contexte par appel : médiane 138K, moyenne 201K, p90 438K. 26 161 M / 138K = environ 190 000 contextes typiques. Jour le plus chargé 2026-10-01 avec 4 894 M tokens, le plus calme 2026-10-18 avec 63 M. Heure la plus chargée de la semaine (profil par heure de la semaine) : 3,05x l'heure moyenne en tokens d'entrée nouveaux, 3,6x en tokens totaux.
Prix
- Claude (claude.com/pricing). Abonnements payés : 2 x Max 20x à 200 USD = 400 USD. Tarifs API par MTok : Opus 5.5 entrée 4, sortie 20, lecture de cache 0,20, écriture de cache 5 (5 min) ou 8 (1 h). Opus 5 et 4.8 : 5 / 25 / 0,50 / 6,25 / 10. Sonnet 5.5 : 2 / 10 / 0,10 / 2,5 / 4. Total 12 365 USD (Opus 5.5 10 348, Opus 4.8 1 930, Sonnet 5.5 63, Opus 5 24). Pour Opus 5.5 : lectures de cache 4 488, écritures de cache 4 249, sortie 1 609, entrée hors cache 1.
- Contrefactuel sans cache chez Claude. Lectures de cache facturées au prix d'entrée de chaque modèle au lieu du prix de lecture de cache (écritures et sortie inchangées) : environ 109 900 USD, 8,9x les 12 365.
- DeepSeek (deepseek-flash, DeepSeek-V4.1-Flash-1017, api-docs.deepseek.com/quick_start/pricing, 2026-10-20), USD par MTok heures creuses / heures pleines : cache hit 0,003 / 0,006, cache miss 0,15 / 0,30, sortie 0,60 / 1,20. Les heures pleines vont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, sauf jours fériés chinois. Nous avons traité du 1er au 7 octobre (semaine de la fête nationale) comme heures creuses. Compter aussi le 25 septembre (fête de la mi-automne) change le total de moins d'un dollar. Écritures de cache facturées comme cache miss, lectures comme cache hit. Tout en heures creuses 251 USD, tout en heures pleines 501 USD, avec les vraies heures du développeur 274 USD : 9,4 % de son usage tombe en heures pleines et 17,2 % de la facture est payée au tarif plein. Sans la règle des jours fériés, ce serait 289 USD.
- Ratios. API Claude = 31x les abonnements et 45x l'API DeepSeek. Abonnements = 1,46x l'API DeepSeek. Prix de relecture, Claude Opus 5.5 contre DeepSeek en heures creuses : 0,20 / 0,003 = 67x.
- Qualité en code. LiveBench programmation agentique, effort maximal, modèles complets servis par leurs propres fournisseurs, tels que relevés dans notre billet du 2026-10-10 : DeepSeek-V4.1-Flash 77,3 (premier sur 69), Claude Opus 5.5 71,7, Claude Fable 5.1 66,1, Claude Opus 5 65,2. Artificial Analysis Intelligence Index, 2026-10-16 : Claude Opus 5.5 58, DeepSeek V4.1 Flash 39.
DeepInfer et la production de DeepSeek
- DeepInfer (github.com/deepseek-ai/DeepInfer). Apache 2.0. Cette version propose l'inférence hors ligne. Construit à l'origine surtout sur vLLM, inspiré de SGLang et TensorRT-LLM. Ne prend en charge que DeepSeek-V4.1-Flash, sur GPU NVIDIA SM100 et NPU Huawei Ascend 950. Kernels FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, TileLang. Attention DP / CP équilibré, MoE EP + EPLB, décodage spéculatif DSpark (
DEEPINFER_ENABLE_MTP_VARLEN=1,DEEPINFER_USE_NEXTN_DECODEpar défaut 5), SWA bounded replay (DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact,DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140), ordonnancement asynchrone activé par défaut, inférence invariante au lot (DEEPINFER_BATCH_INVARIANT=1, NVIDIA seulement). Compilation avecexport DEEPINFER_ACCELERATOR=nvidia; ./build.sh, exécution avecpython examples/offline_inference.py.examples/README.mdfait tourner un nœud de 8 GPU avec--ep 8,--ep 2 --dp 8ou--ep 2 --cp 8, et mesure avecexamples/sweep/run_sweep.sh. Non inclus : système de cache KV, séparation VE/prefill/decode, répartition de charge entre réplicas DP, et aucun serveur HTTP documenté. DeepSeek a aussi publié deepseek-recipe (du protocole de l'API aux tokens et retour, en Rust avec bindings Python). - Checkpoint.
deepseek-ai/DeepSeek-V4.1-Flash-1017: 763B paramètres, environ 510 Go (surtout des experts empaquetés en 4 bits et du FP8). - Benchmark du README. 4 GPU SM100 pour le prefill et 64 pour le decode, chaque groupe dans un même domaine scale-up. Graphique de prefill sur les 4 GPU (EP4DP4, contexte 131 072) : environ 60K tok/s/GPU avec des lots de 4 096 tokens, jusqu'à environ 89,5K à 65 536. Graphique de decode sur les 64 GPU (EP64DP64, nextn=3, 75 % d'acceptation) : environ 26,3K tok/s/GPU à environ 103 tok/s par utilisateur, jusqu'à environ 2,6K à environ 325.
- Production de DeepSeek (billet Zhihu, tableau avec marge pour les pics de trafic ; le matériel derrière ces débits n'est pas précisé). Prefill 60K tok/s/GPU hors cache, 1,5 M avec cache hits, 96 % de cache hit en moyenne, entrée moyenne de 77K, TTFT de 400 ms en moyenne et 1 000 ms au P99. Decode 14K tok/s/GPU, 230 tok/s par utilisateur (300 pour le code). P:D proche de 1:1. 155 000 milliards de tokens par jour sur un seul cluster. 38 USD de revenu par GPU-heure aux tarifs heures creuses. Prefill sur des machines de 8 GPU (EP2-8), decode sur des supernœuds de 64-128 GPU (EP64-128). Cache KV sur un cluster 3FS séparé, environ 100 PiB de SSD, pages de 128 tokens, TTL de 3 jours pour le trafic d'agents et 7 pour le chat, lecture en pointe de 10 TiB/s. N'importe quelle machine de prefill peut retrouver n'importe quel préfixe.
- Charge par utilisateur (moyenne sur 30 jours, 2 592 000 s) : 33,2 tok/s écrits, 317 tok/s d'entrée nouvelle, 9 743 tok/s d'entrée en cache, 10 060 tok/s d'entrée totale. Part de GPU aux débits de production de DeepSeek : prefill 10 060 / 1,5 M = 0,0067 GPU (environ 150 utilisateurs par GPU), decode 33,2 / 14K = 0,0024 GPU (environ 420 utilisateurs par GPU). Avec une marge de 3x pour l'heure de pointe : 0,0273 GPU par utilisateur.
- Sans cache. Prefill par utilisateur 10 060 / 60K = 0,168 GPU, 25 fois plus.
Serveurs loués
- Prix (runpod.io/pricing, 2026-10-20, à l'heure, aucun prix de réservation publié). B200 7,99 USD par GPU-heure en Secure Cloud, 5,98 en Community ; B300 8,99 / 6,94. 8 x 7,99 x 730 h = 46 662 USD par mois, 4 GPU 23 331, électricité comprise. 2 B200 (environ 360 Go) ne peuvent pas charger le checkpoint ; 4 (environ 720 Go) laissent environ 200 Go pour le cache KV.
- Capacité. 8 GPU / 0,0273 = 293 utilisateurs, 4 GPU 146, aux débits de DeepSeek (220 et 110 à 75 %, 147 et 73 à 50 %). Sans cache, 8 GPU suffisent pour 8 / ((0,168 + 0,0024) x 3) = environ 15 utilisateurs.
- Point mort face à 274 USD. 8 GPU : 46 662 / 274 = 170 utilisateurs location seule, (46 662 + 25 000) / 274 = 262 avec ingénieurs. 4 GPU : 85 location seule ; avec ingénieurs il en faudrait 176 et seuls 146 rentrent, donc pas de point mort. Prix Community, 8 GPU : 127 et 219.
- Seuil de vitesse. Coût de location par utilisateur à pleine capacité 46 662 / 293 = 159 USD, donc la vitesse par GPU doit atteindre 159 / 274 = 58 % des débits de production de DeepSeek pour que louer batte l'API à n'importe quelle taille, hors ingénieurs (43 % au prix Community).
- Plusieurs nœuds (Secure, 100 %, ingénieurs compris) : 1 nœud 71 662 USD jusqu'à 293 utilisateurs ; 2 nœuds 118 324 jusqu'à 586 (battent l'API à partir de 432 et le rack, 127 374, sur toute cette plage) ; 3 nœuds 164 986 ; 4 nœuds 211 648 à 1 000 utilisateurs, contre 137 614 pour le rack et 274 000 pour l'API.
- Test proposé. Environ 2 h sur 4 GPU pour installer et télécharger les poids, plus 2 à 3 h sur 8 pour les balayages
run_sweep.shen prefill et decode avec un contexte de 128K : environ 200 à 270 USD. Non exécuté. - deepseek-one-gpu. DeepSeek-V4.1-Flash Q2_K sur une RTX PRO 6000 de 96 Go plus la RAM de l'hôte. 8 places de lot de 69 632 positions, jusqu'à 262 144 pour une requête seule. 84,1 % des appels du développeur dépassent 69 632, 23,5 % dépassent 262 144. Un serveur multi-GPU n'a pas été testé.
Votre propre rack
- Matériel. Un GB300 NVL72 : 72 GPU Blackwell Ultra et 36 CPU Grace dans un même domaine NVLink, 288 Go de HBM3e par GPU. Répartition 64 decode + 8 prefill. Prix 3,5 M USD, notre hypothèse (fourchette 3-4 M). Together AI et Clusterbid ne donnent pas de prix de rack. Le GB200 NVL72 (compute capability 10.0, SM100, la cible que nomme DeepInfer) est le même rack NVLink de 72 GPU. Nous ne l'avons pas modélisé à part, et son prix n'est pas vérifié non plus. GPU de prefill supplémentaires au coût par GPU du rack, 48,6K USD chacun, ajoutés par boîtes de 8.
- Coût mensuel. Amortissement 3,5 M / 48 mois = 72 917 USD. Électricité 135 kW x PUE 1,3 x 730 h x 0,15 USD/kWh = 19 217 USD. Deux ingénieurs 25 000 USD (150K USD par an chargés, chacun). Base 117 134 USD. Matériel et électricité seuls 92 134 USD. Chaque GPU de prefill supplémentaire 1 280 USD par mois (48,6K / 48 + 267 d'électricité). Coût marginal par utilisateur 1 280 x 0,0067 x 3 = environ 26 USD.
- Marge. 3x la charge moyenne en prefill. Les 8 GPU de prefill du rack couvrent environ 397 utilisateurs à 3x (environ 1 190 à 1x). À 465 utilisateurs : environ 9,4 GPU de prefill et environ 3,3 de decode occupés.
- Point mort (premier nombre d'utilisateurs où le coût propre est inférieur ou égal à 274 USD x utilisateurs, prefill ajouté par boîtes de 8). Matériel + électricité : 92 134 / 274 = 337 utilisateurs. Avec ingénieurs : 117 134 / 274 = 428 dépasse les 397 que couvre le prefill du rack, donc une boîte de 8 est ajoutée : 127 371 / 274 = environ 465. Rack à 3 M : 299 et 390. Rack à 4 M : 375 et 507. Le nombre de personnes au point mort varie à peu près comme 1 / usage par personne.
| Utilisateurs | API DeepSeek (USD/mois) | Votre rack (USD/mois) | Votre rack par utilisateur |
|---|---|---|---|
| 100 | 27 416 | 117 134 | 1 171 |
| 200 | 54 832 | 117 134 | 586 |
| 300 | 82 248 | 117 134 | 390 |
| 400 | 109 664 | 127 371 | 318 |
| 500 | 137 080 | 127 371 | 255 |
| 750 | 205 620 | 127 371 | 170 |
| 1 000 | 274 160 | 137 608 | 138 |
| 2 000 | 548 320 | 168 319 | 84 |
| 5 000 | 1 370 800 | 239 979 | 48 |
- Vérification des revenus. En heures creuses, un GPU de prefill rapporte environ 47,95 USD/h avec le mélange à 96 % de hits de DeepSeek et un GPU de decode 30,24 USD/h, cohérent avec les 38 de DeepSeek. 72 GPU x 38 USD x 730 h = environ 2,0 M USD par mois. Un rack équilibré pour ce trafic (si le decode tournait sur moins de GPU) accueillerait environ 7 900 utilisateurs comme celui-ci, 7 900 x 251 USD (tout en heures creuses) = environ 2,0 M USD par mois.
- Taille de l'étagère, à la louche. 465 utilisateurs x 872 M tokens par jour = 405 milliards de tokens par jour, 0,26 % des 155 000 milliards de DeepSeek. La même part d'environ 100 PiB représente environ 300 To. Extrapoler par les tokens est grossier. Non chiffré.
Limites
- Le prix du rack est notre hypothèse, pas un devis, et aucune source que nous avons pu ouvrir n'en donne. Les estimations de consommation du rack varient aussi (environ 120 à 140 kW selon les sources).
- Le stockage de l'étagère n'est pas dans le modèle de coûts. Ni l'espace en centre de données ou l'hébergement d'un rack de 135 kW refroidi par liquide, ni le réseau, les pièces de rechange et le support. Tout cela relève le point mort.
- Le README de DeepInfer nomme des GPU SM100, et CUDA classe Blackwell Ultra (GB300, B300) comme une compute capability distincte (sm_103). Faire tourner DeepInfer sur un GB300 aux débits de production de DeepSeek est notre hypothèse, et DeepSeek ne dit pas quel matériel a produit ces débits.
- DeepSeek n'a pas publié de chiffres DeepInfer avec une salle d'écriture plus petite. Les chiffres du rack supposent une salle d'écriture de 64 GPU. Ceux des 4 et 8 GPU loués supposent les débits par GPU de DeepSeek, ou la fraction indiquée, et un cache fonctionnel que DeepInfer ne fournit pas. Nous n'avons mesuré ni l'un ni l'autre.
- Le modèle d'utilisateur est une seule personne, et un gros utilisateur. Une entreprise a des utilisateurs plus légers, d'autres horaires et d'autres habitudes. Ses prompts sont plus longs que la moyenne de DeepSeek (77K), donc sa charge de lecture par token est probablement plus élevée que ne le suggèrent les débits de production.
- Claude et DeepSeek découpent le texte en tokens différemment, d'une quantité que nous n'avons pas mesurée, donc le chiffrage DeepSeek est approximatif. La comparaison porte uniquement sur le prix. DeepSeek-V4.1-Flash est un autre modèle qu'Opus 5.5, et le même travail peut demander un autre nombre d'allers-retours et de tokens.
- L'abonnement est un forfait avec des limites d'usage pour les particuliers. Ce n'est pas une offre entreprise.
- Les débits de production de DeepSeek viennent de son propre service, avec son étagère, ses répartiteurs et son mélange de trafic. Un premier montage tournera probablement en dessous.
- La confidentialité, le contrôle et le choix du modèle sont volontairement laissés hors de la comparaison des coûts.