MOSS-Image écrit chaque mot juste en 80 secondes, et presque chaque mot en 9
MOSS-Image testé sur une A40 : chaque mot juste en 80 s, 9 s avec un module turbo, et les mêmes pixels sous un plafond émulé de 12 GB de mémoire.
Quatre-vingts secondes, chaque mot juste. Neuf secondes, un mot répété. C'est le compromis que nous avons mesuré avec MOSS-Image, un modèle ouvert conçu pour écrire du texte long dans les images, sur une seule carte graphique A40 louée. Les 80 secondes, c'est la recette des auteurs en 50 steps. Les 9 viennent d'un module turbo de la communauté qui se trompe de mot de temps en temps. La licence autorise l'usage commercial, donc cela compte pour quiconque fabrique des affiches, des menus ou des visuels pour les réseaux sociaux dans un produit. Tout chargé, le modèle occupait environ 30 GB de la mémoire de la carte. Quand nous avons limité l'A40 à 12 GB de mémoire, il a produit exactement la même image, deux fois moins vite. Vous pouvez le déployer sur votre propre GPU avec notre exemple du SDK, et cet article vous dit quelle configuration choisir.
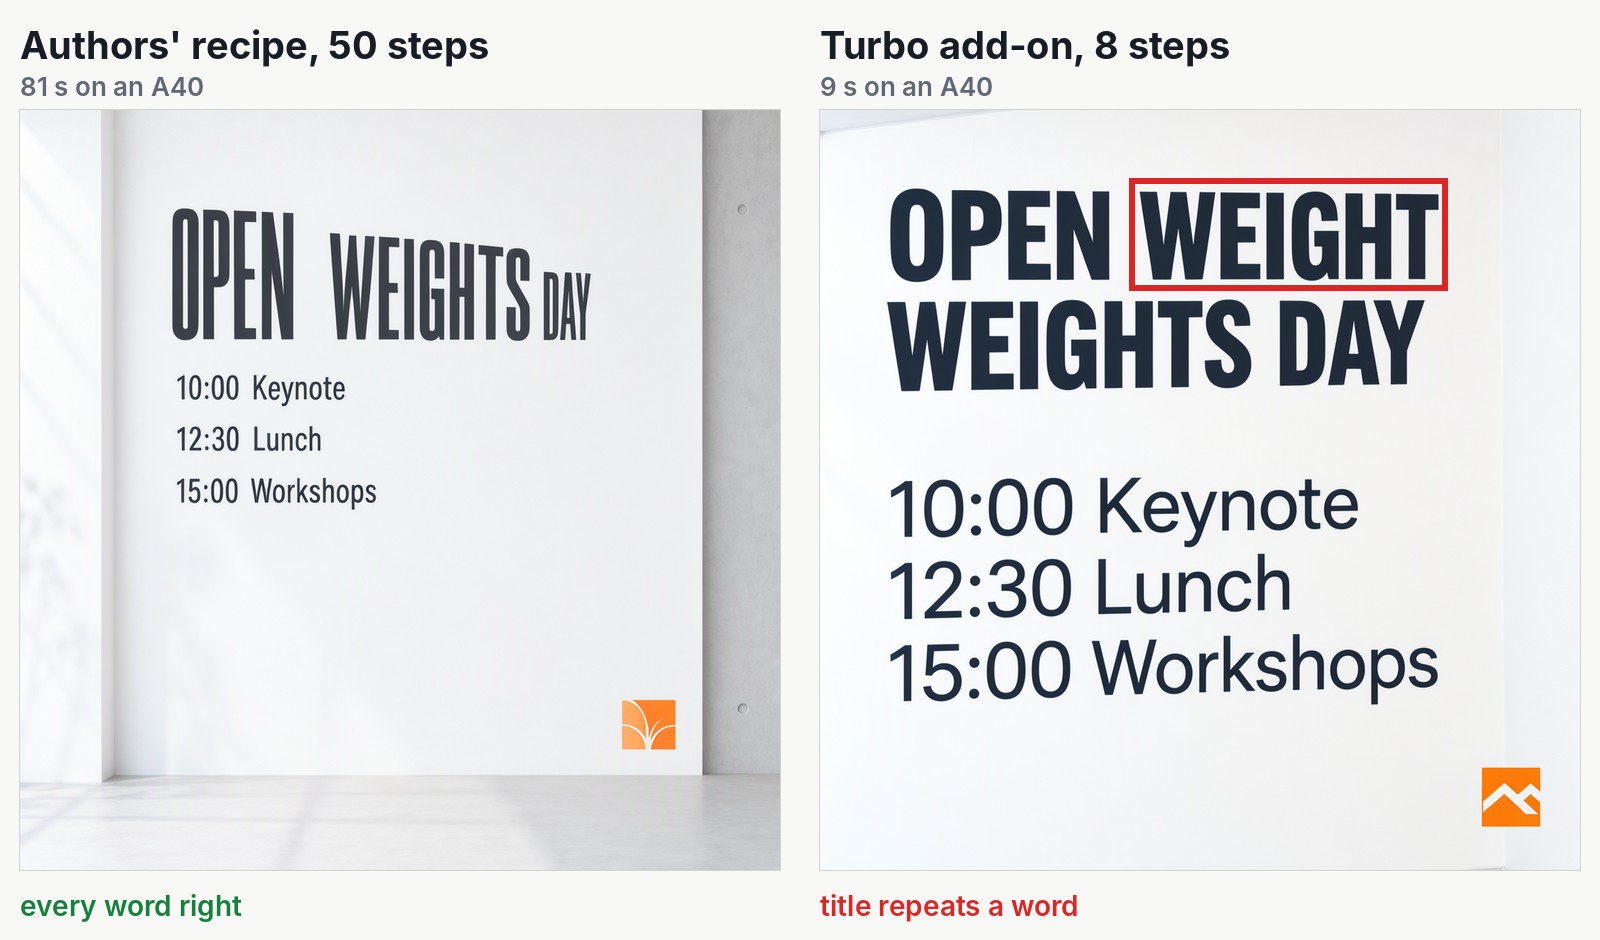
Même prompt, même départ aléatoire, même modèle chargé. Le cadre rouge marque la seule erreur : le titre turbo répète un mot.
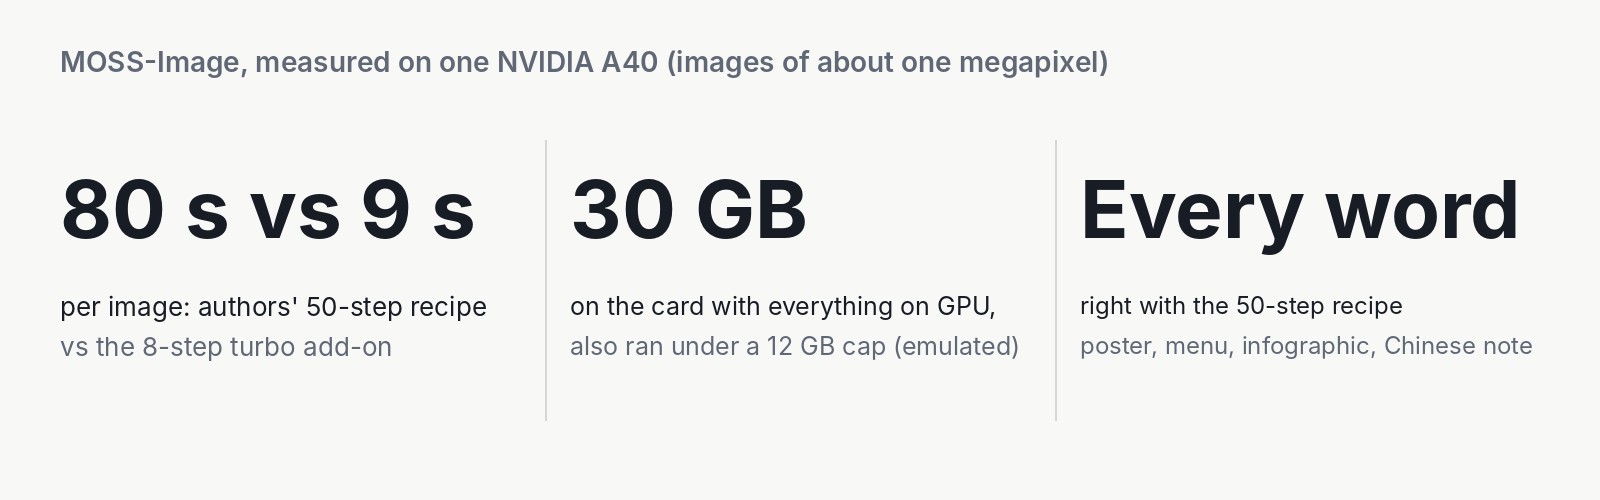
Conçu pour le texte long dans les images, avec une mise en page que vous contrôlez
MOSS-Image est conçu pour le texte long. Un menu complet avec les prix, une infographie avec une douzaine d'étiquettes ou un programme sur une affiche, c'est là que les modèles d'image dérapent : Iris-3B, le dernier que nous avons testé, a perdu les virgules décimales d'un menu de quatre lignes. Les auteurs citent le rendu du texte et les prompts longs comme les principaux atouts du modèle.
Dans leur rapport technique, les auteurs ont construit leur propre test de texte long dans les images. Ils annoncent que MOSS-Image écrit en moyenne 96,3 % du texte demandé, le meilleur score parmi les modèles dont les fichiers sont publics. C'est leur benchmark et nous n'avons lu que le résumé, donc prenez-le comme leur affirmation. Notre petit test, plus bas, va dans le même sens.
Vous pouvez aussi contrôler la mise en page. Au lieu d'une phrase, vous pouvez envoyer une courte description structurée. Elle contient une légende pour l'image entière, puis une liste d'éléments, chacun avec son texte et un cadre sur la toile où il doit aller. Les auteurs la qualifient d'expérimentale. Nous avons essayé deux mises en page, et les deux ont été respectées.
Nous avons fait tourner MOSS-Image-SFT, la version qui a reçu un entraînement supplémentaire sur des exemples choisis à la main.
OpenMOSS a construit le modèle, lodestones a fait le module turbo, et nous l'avons repéré dans une vidéo d'AI Search. Notre part : le code qui le sert, l'exemple du SDK, le déploiement sur InferenceKey et les mesures. Les crédits complets sont en annexe.
Le test : une A40, 22 images, un essai chacune
Nous avons fait 22 images, un essai par prompt, sur une A40 et une requête à la fois. Cela montre comment le modèle se comporte, pas où il se classe. Nous n'avons essayé ni le modèle Base ni plusieurs utilisateurs à la fois. La liste complète est en annexe.
Nous avons loué l'A40, avec 48 GB de mémoire, sur notre propre cloud. Nous avons fait tourner le modèle via une copie de test privée d'InferenceKey, donc notre service de production n'a jamais été touché. Nous avons choisi une carte de 48 GB parce que les fichiers du modèle prennent à eux seuls environ 27 GB, plus la place pour travailler.
Un seul exemplaire du modèle est resté chargé et a servi les deux modes. Chaque requête disait lequel elle voulait : la recette des auteurs ou le module turbo. Nous avons écrit nos propres prompts : une affiche de conférence, une infographie, un menu sur ardoise et un mot manuscrit en chinois tiré des exemples des auteurs. Puis deux mises en page, une photo de rue et les mains d'un pianiste. L'après-midi, nous avons relancé l'affiche sous des plafonds de mémoire pour voir sur quelle petite carte il pouvait vivre.
Résultats : 80 secondes pour chaque mot juste, 9 secondes avec des mots à vérifier
La recette des auteurs a écrit chaque mot juste sur chaque test de texte que nous lui avons donné. Le module turbo était environ neuf fois plus rapide. Il s'est trompé sur deux mots du texte demandé (un répété, un mal orthographié) et a inventé des enseignes à moitié illisibles dans une photo de rue, donc nous ne le mettrions pas en production sans vérification.
| Recette des auteurs (50 steps) | Module turbo (8 steps) | |
|---|---|---|
| Temps par image d'environ un mégapixel | 78 à 81 secondes | 8.6 à 9.2 secondes |
| Texte | tout juste : affiche, infographie, menu, mot en chinois | juste : menu, mot en chinois, mises en page. Faux : titre de l'affiche, une étiquette de l'infographie, enseignes dans une photo |
Pourquoi la recette est lente mérite un paragraphe, parce que c'est aussi la raison d'être du turbo. Le modèle part d'un bruit aléatoire et le nettoie en image sur 50 steps. À chaque step, il tourne deux fois, une fois avec votre prompt et une fois sans, et garde la différence pour rendre l'image plus nette. Cela fait environ 100 passages par image. Le module de lodestones apprend au modèle à y arriver en 8 passages, sans second tour. C'est un fichier de 1,2 GB posé par-dessus le modèle original, et son auteur le présente comme un travail en cours. Voyez la recette comme la prise studio complète avec tous les overdubs, et le turbo comme la version live en une prise : en général ça passe, de temps en temps une fausse note.
L'affiche du début est le cas le plus net. L'infographie est l'autre dérapage. La recette des auteurs a écrit chaque étiquette, y compris le pied de page "Median time: 9 seconds". Le turbo a écrit "PNG bock" au lieu de "PNG back".
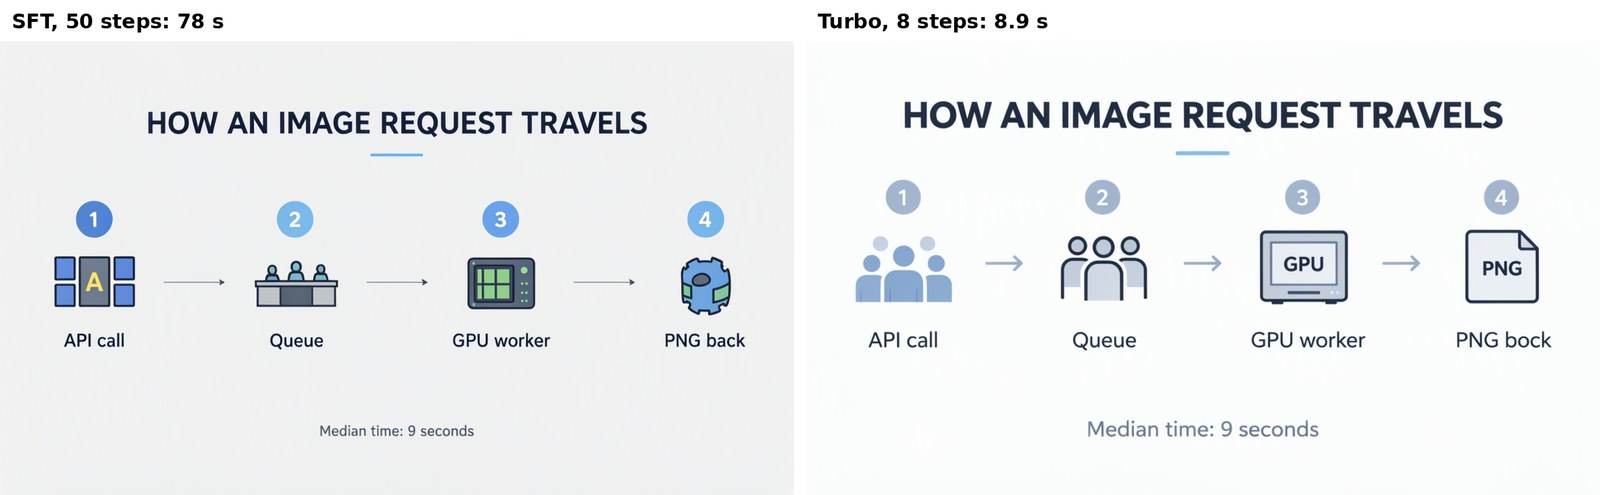
À gauche, la recette des auteurs. À droite, le turbo avec "PNG bock". Dans le tableau de bord d'InferenceKey, avec un prompt un peu différent, le turbo a écrit chaque étiquette juste.
Le menu sur ardoise compte pour nous parce qu'il avait fait trébucher Iris-3B, le dernier modèle d'image que nous avons testé. Iris perdait les virgules décimales et répétait des lignes. MOSS-Image a écrit "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50" correctement dans les deux modes. Le mot manuscrit en chinois est lui aussi sorti exact, ses trois lignes, dans les deux modes.
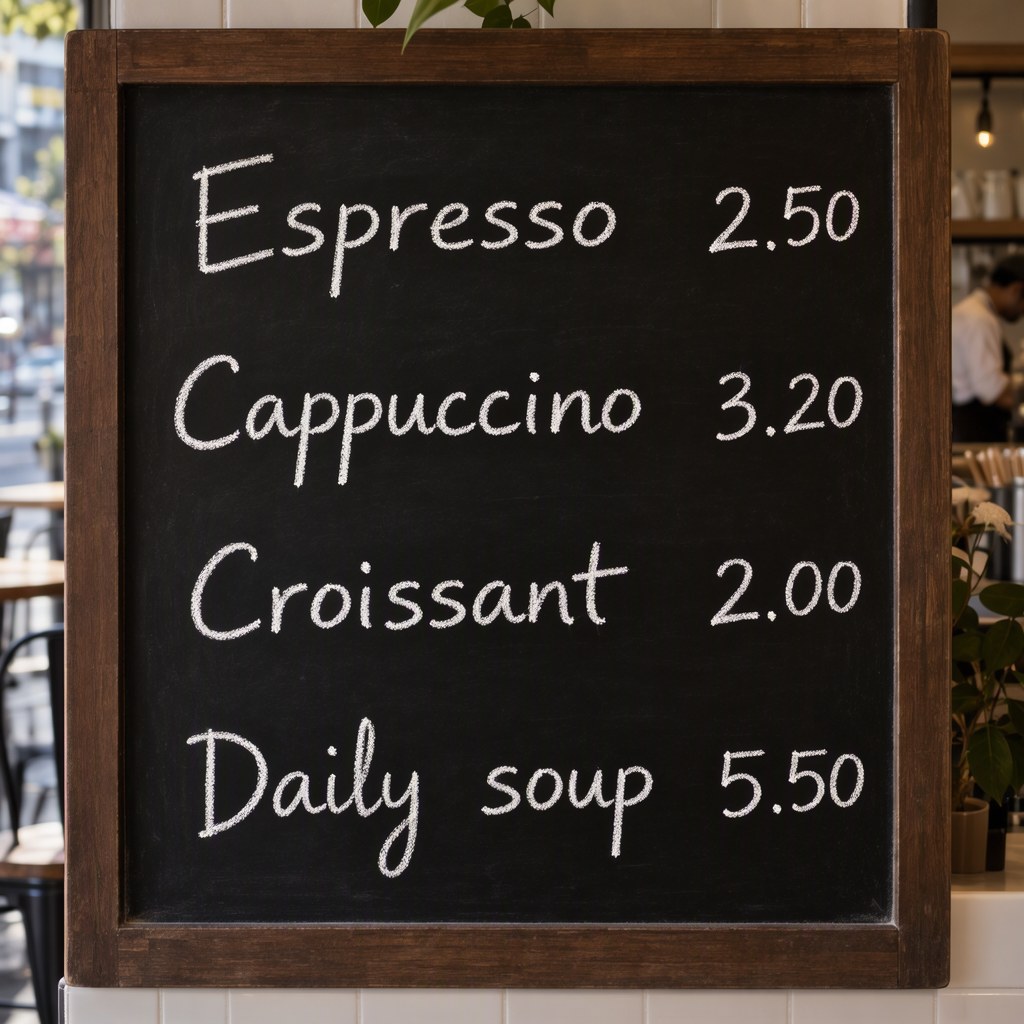
Quatre prix, quatre séparateurs décimaux, aucune ligne répétée.
Les mises en page et les mains ont tenu, le turbo poussé à 4 steps non
En dehors du texte, le modèle a fait ce que nous demandions. Les deux mises en page ont été respectées et les mains étaient justes. La seule chose qui a cassé, c'est notre propre expérience avec moins de steps.
Nous avons envoyé une affiche de café sous forme de mise en page à trois éléments : un titre, un slogan et une tasse. Puis nous l'avons renvoyée avec les cadres déplacés du haut vers le bas. Tout est allé dans son nouveau cadre, bien orthographié, dans les deux modes.
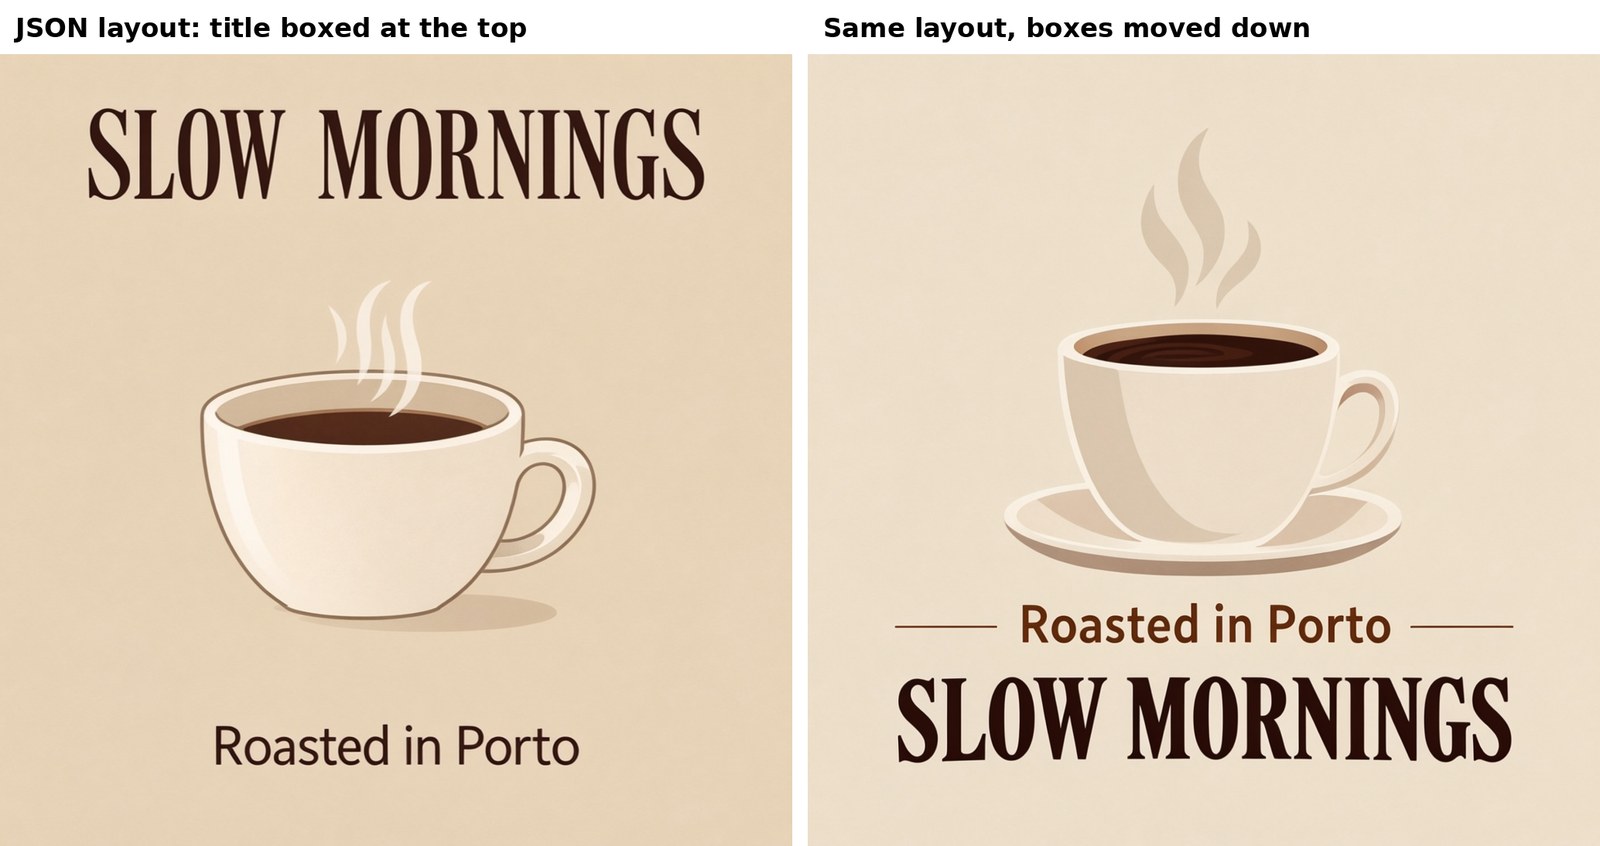
Même mise en page, cadres déplacés. Les mots et la tasse ont suivi.
Les mains sont un point faible classique des modèles d'image. Nous avons demandé les deux mains d'un pianiste, et la recette des auteurs les a dessinées correctement, en train de jouer, avec leur reflet dans la laque noire derrière les touches. La version turbo du même prompt a aussi dessiné deux mains plausibles.
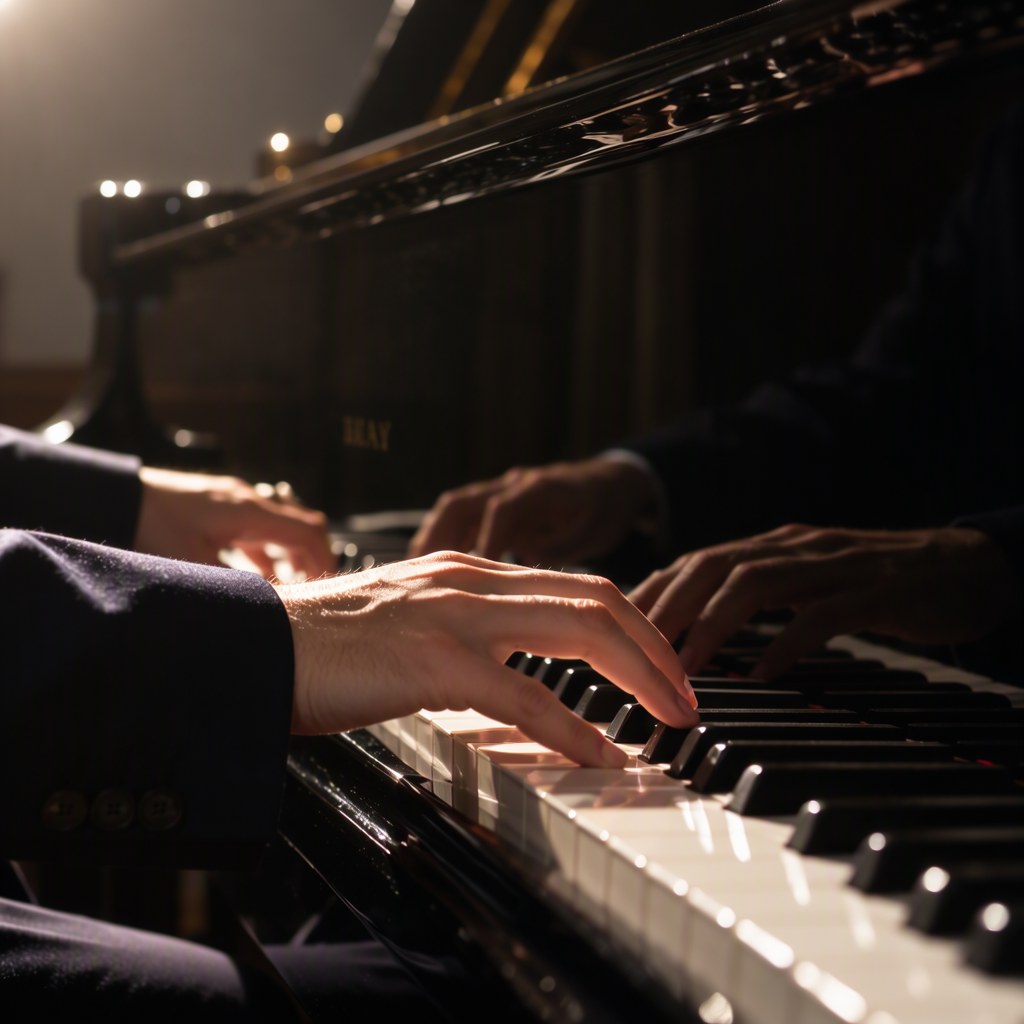
La paire derrière les touches, c'est leur reflet dans la laque.
Ensuite, nous avons poussé le module en 8 steps à 4 steps pour voir ce qui se passe. Il a pris 5,2 secondes, et le texte s'est effondré : "OPEN WEIGHT DAYDY", et des horaires comme "1(.C0". C'est le module poussé en dessous de ce pour quoi il a été entraîné. Nous n'avons pas testé les modules conçus pour 4 steps.
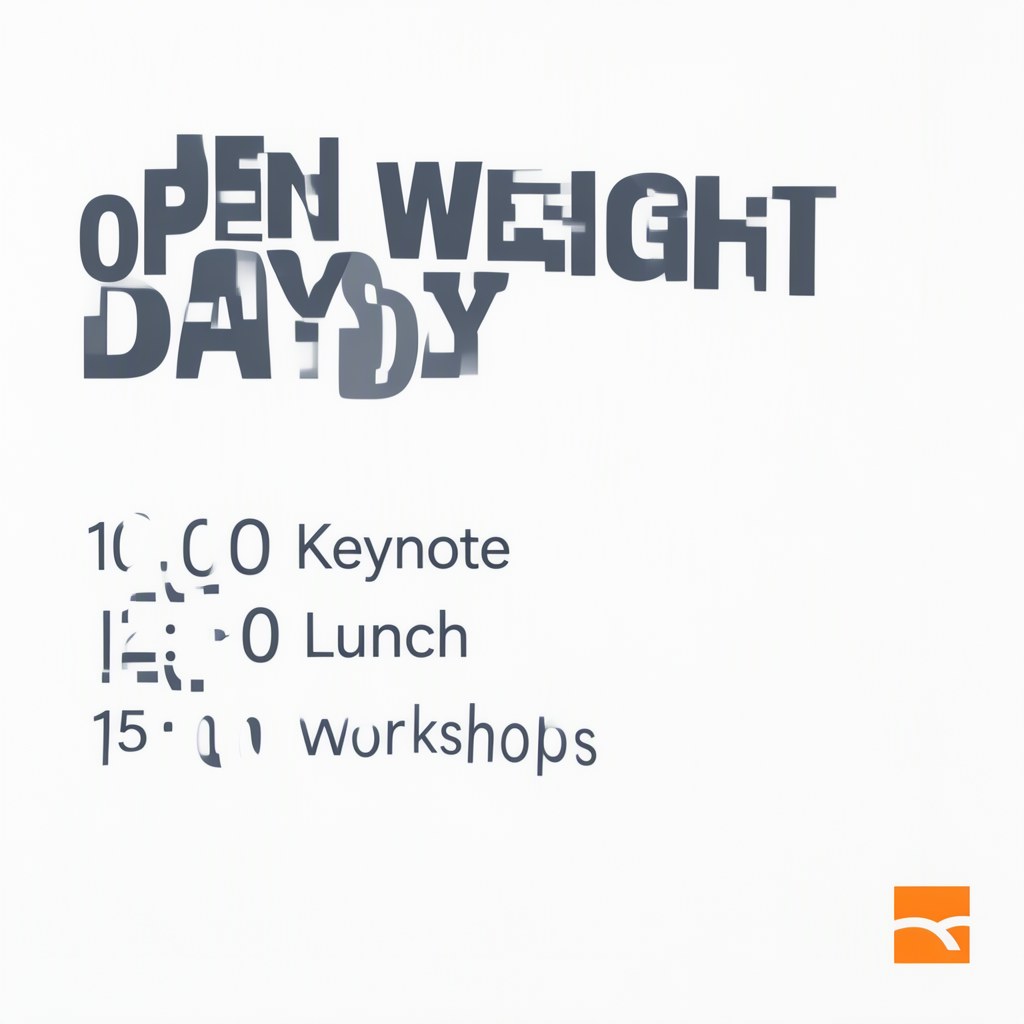
Module en huit steps, quatre steps : plus rapide, et les mots cassent.
Quel GPU : plafonnée à 12 GB de mémoire, l'A40 a donné les mêmes pixels deux fois moins vite
Vous n'avez probablement pas besoin d'une carte de 48 GB. Nous avons plafonné la mémoire que le modèle pouvait utiliser sur l'A40, pour qu'elle se comporte comme une carte de 16 GB ou de 12 GB. Sous les deux plafonds, il a dessiné exactement la même affiche. Avec la recette des auteurs, la configuration 16 GB tournait presque à pleine vitesse et la 12 GB environ deux fois plus lentement.
Seule la taille de la mémoire était émulée, pas la vitesse d'une carte grand public ni sa liaison avec la mémoire principale. Ces vitesses sont donc relatives à une A40, pas des prédictions pour une RTX 5080 ou une RTX 3080 Ti. Le fait que ça tienne, c'est la partie à laquelle nous nous fions, et ce n'est pas encore confirmé sur une vraie carte (voir les points à reprendre plus bas).
Si ça tient, c'est grâce à la façon dont le modèle est construit. Ce sont deux modèles qui travaillent en duo : un lecteur et un peintre. Le lecteur est le modèle de langage de 17 GB qui transforme votre prompt en description. Le peintre est le modèle de 10 GB qui nettoie le bruit en image au fil de tous ces steps. Le lecteur travaille un instant au début de chaque image, puis reste inactif. Il peut donc attendre dans la mémoire principale de l'ordinateur et passer par la carte morceau par morceau quand un prompt arrive. Dans la configuration 12 GB, une partie du peintre attend là aussi.
| Plafond de mémoire | Pic de mémoire utilisée sur la carte | Recette des auteurs | Turbo |
|---|---|---|---|
| Aucun, tout sur la carte (vraie A40, 48 GB) | environ 30 GB | 80 s | 9 s |
| 16 GB (émulé), lecteur en mémoire principale | environ 14 GB | 86 s | 13 s |
| 12 GB (émulé), lecteur et une partie du peintre en mémoire principale | environ 11 GB | 160 s | 18 s |
Pic de mémoire tel que la carte elle-même le rapporte. Les chiffres exacts sont en annexe.
Les sorties étaient, octet par octet, les mêmes fichiers que lors de l'exécution avec tout sur la carte. L'affiche en 12 GB a donc chaque mot juste, et l'affiche turbo garde son mot répété. Sur une carte de 16 GB, c'est serré, environ 2 GB de marge, moins si la carte gère aussi votre écran ; sur une carte de 24 GB, il a de la place. Notre exemple du SDK choisit la configuration d'après la mémoire libre de la carte. Ce choix automatique n'a pas encore tourné sur un GPU : nous avons fixé chaque configuration à la main.
L'autre chose à prévoir, c'est la mémoire principale de l'ordinateur. Dans les configurations 16 et 12 GB, le processus a utilisé jusqu'à 22 GB de mémoire principale, donc donnez à la machine environ 32 GB.
Sur InferenceKey : un seul exemplaire chargé a servi les deux modes, prêt en 63 secondes
La carte est à vous à l'heure, et c'est vous qui décidez de ce qui tourne dessus. Un seul exemplaire chargé de MOSS-Image a servi la recette des auteurs et le module turbo, requête par requête. Il était prêt à recevoir des requêtes 63 secondes après que nous l'avons demandé, sur une machine louée qui avait mis 78 secondes à démarrer et à rejoindre InferenceKey.
MOSS-Image arrive avec son propre code de chargement. Les backends tout faits d'InferenceKey (le code qui charge un modèle une fois et répond aux requêtes) n'exécutent pas le code propre d'un modèle. Nous avons donc écrit le nôtre, un petit fichier Python. Au démarrage, il télécharge une version figée du modèle et du module, puis les charge comme le font les auteurs. Sur ces 63 secondes, le téléchargement de 28 GB en a pris 29 et le chargement sur la carte 9. Sur une connexion plus lente, c'est le téléchargement qui s'allonge.
Chaque requête indique son mode, sft ou turbo, et le prompt peut être une phrase ou une mise en page. Le backend parle le même format de requête que l'API d'images d'OpenAI, donc du code existant peut l'appeler. Le passage par InferenceKey a ajouté environ une seconde par image en plus du travail de la carte.
Pourquoi pas ComfyUI, l'application de bureau populaire pour les modèles d'image ? Elle fait déjà tourner MOSS-Image, et pour une personne qui fabrique des images à son bureau, c'est le chemin le plus court. Nous voulions une API que d'autres programmes appellent, sur une carte que nous choisissons.
L'enregistrement de 90 secondes ci-dessous montre le tableau de bord d'InferenceKey pendant le test, avec le modèle sur l'A40. Ensuite, le testeur d'images du tableau de bord fait le menu sur ardoise en 9,7 secondes et une infographie large en 6, chaque prix et chaque étiquette justes. L'entreprise du tableau de bord, Pixelforge Studio, est un compte de démo inventé.
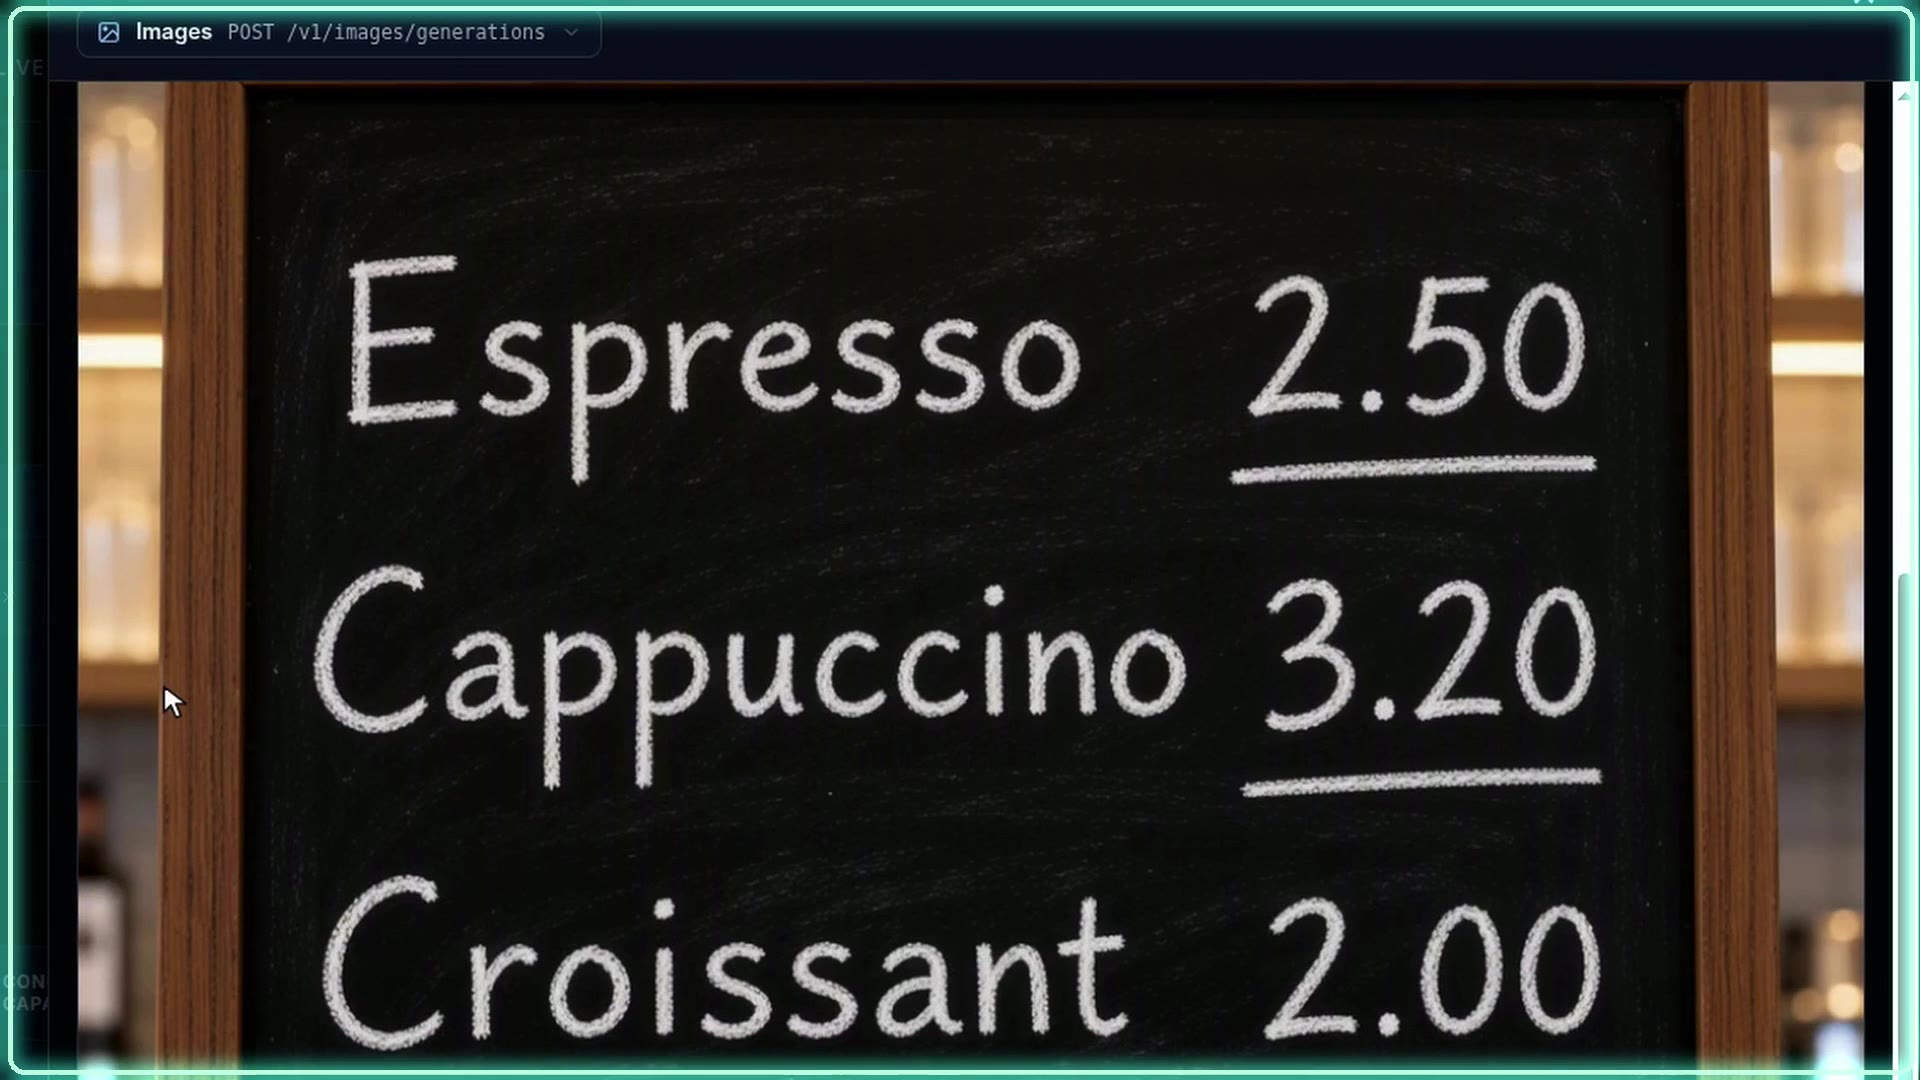
Cliquez pour lire le MP4 (90 s, commenté).
Deux points à reprendre sur lesquels vous tomberiez aussi :
- Une limite de démarrage fixe. Un backend que vous écrivez vous-même a 300 secondes pour être prêt. Sur une machine qu'InferenceKey loue pour vous, aucun réglage ne permet de l'augmenter. Une liaison lente peut y passer rien qu'avec le téléchargement. Nous l'avons augmentée à la main. Statut : ouvert.
- Certaines cartes grand public louées ne peuvent pas être configurées. Notre propre cloud nous a fourni les machines RTX 3080 Ti, RTX 5080 et RTX 4090 demandées. Ces machines n'avaient pas la connexion directe qu'InferenceKey utilise pour s'installer, donc il a rendu chacune au bout de trois minutes. Statut : ouvert, les locations ne sont pas encore filtrées sur ce point.
Faut-il l'utiliser ? La recette en 50 steps quand les mots doivent être justes, le turbo pour les brouillons
- Si le texte doit être juste (un menu, un prix, une mention légale), utilisez la recette des auteurs en 50 steps, sur une carte de 48 GB ou dans la configuration 16 GB. C'est le seul mode sans dérapage dans notre test.
- Si vous avez besoin de vitesse (brouillons, aperçus, mises en page simples), utilisez le module turbo et relisez chaque mot avant la mise en ligne.
- Si votre GPU est petit, essayez la configuration 16 GB sur une carte de 16 ou 24 GB avec 32 GB de mémoire principale.
- S'il vous faut une licence pour un produit, Apache 2.0 sur le modèle et sur le module le couvre.
Pour faire les mêmes images sur votre propre machine NVIDIA, publiez le backend une fois avec publish.py et lancez python main.py depuis l'exemple du SDK (étapes en annexe). Il faut que la machine soit reliée à un projet InferenceKey ; il télécharge environ 28 GB au premier démarrage et supprime le déploiement à la fin ; arrêtez vous-même une machine louée. Nous l'avons fait tourner sur une carte de 48 GB.
Pour les ingénieurs
Modèle et fichiers
Card SFT, card Base, GitHub, rapport technique, arXiv:2610.23374. Le README le décrit comme "a 5B-parameter base DiT model with high-quality text rendering, layout generation, and efficient fine-tuning", avec des prompts jusqu'à 4K tokens. DiT à 42 couches (dim 3072, text_dim 4096, 128 canaux latents), encodeur de texte Qwen3.5-9B (Qwen3_5Model, 32 couches, 3 sur 4 en linear-attention), petit VAE FLUX.2 (AutoencoderKLFlux2). Apache-2.0 sur les deux repos HF et sur GitHub. Support dès le jour 0 dans SGLang, vLLM-Omni et ComfyUI. Environ 1 200 étoiles GitHub le 21 octobre. Résumé du rapport : couverture moyenne du texte LLTB de 96,3 % (meilleure parmi les open weights, selon les auteurs). Nous n'avons lu que le résumé.
| Repo / fichier | Taille |
|---|---|
OpenMOSS-Team/MOSS-Image-SFT @ f972bd4b, total | 27,229,060,886 B |
| transformer, 3 shards, bf16 | environ 10.16 GB |
| text_encoder, 4 shards | environ 16.79 GB |
| VAE | 249.5 MB |
lodestones 8-step DMD lora_latest.safetensors @ f95df83b | 1,189,176,800 B (fp32, rank 128 / alpha 128) |
Échantillonnage
Recette de la card : Euler en flow-matching, 50 steps, CFG 3, shift 5, prompt négatif vide, branche négative avec uncond_skip_layers=[22], deux forwards du transformer par step. Nécessite torch >= 2.9, diffusers >= 0.38, transformers >= 5.3. Largeur et hauteur doivent être des multiples de 16. Guide d'utilisation : 1 à 2 MP recommandés, 0,25 à 4 MP possibles. Turbo : lora_latest.safetensors appliqué sans fusion à une force de 0,7, 8 steps, CFG 1 (pas de branche négative, donc un prompt négatif est ignoré). La card du LoRA le présente comme une distillation, en cours, de 50 steps CFG 3 vers 8 évaluations du réseau et indique que le delta est plus petit que le pas d'arrondi du bf16, d'où l'application sans fusion. Notre application sans fusion suit le Space de démo du LoRA, hugging-apps/moss-image-8-step-dmd.
Prompt de mise en page (README et guide d'utilisation, "Layout Prompts (Experimental)") : summary {meta, canvas, caption} plus items [{label, caption, text?, bbox}], "bbox_format": "yxyx", "bbox_coord_space": "abs_centralized" (pixels depuis le centre de la toile). Passez-le par json.dumps(layout, ensure_ascii=False).
Notre installation
NVIDIA A40 48 GB sur notre propre cloud (46 068 MiB), niveau secure, CA-MTL-1, driver 595.91.07, image runpod/pytorch:1.0.7-cu1300-torch291-ubuntu2404-cluster. L40 niveau community a renvoyé 409 (pas de stock). Worker initialisé par un manager InferenceKey local via des tunnels HTTP et TCP, 78 s après le POST du pod. Venv du backend : Python 3.12.3, torch 2.14.1+cu130, diffusers 0.38.0, transformers 5.3.0, installés par uv. Production jamais touchée.
Déploiement pas à pas
L'exemple du SDK (commit a69c6e5 sur main). Il vous faut un token SDK (ik_sdk_...), une clé d'API (ik_live_...), un slug de projet, l'IK_WORKER_ID d'un worker NVIDIA enregistré (driver CUDA 13, 580+), et pour publish.py un tenant id et un token de session du tableau de bord (ou bien téléversez dist/*.tar.gz dans le tableau de bord). Prévoyez environ 32 GB de RAM système si la carte fait moins de 40 GB.
cp .env.example .env        # SDK token, API key, project, worker id, tenant id, dashboard session token
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # once: packages backend.py and registers it as "moss-image-text2image"
python main.py              # deploy, wait until ready, make 3 pictures, delete the workload
main.py appelle ensure() avec ExecutionPolicy.FIXED et 1 réplique, wait_until_ready(timeout=3600), envoie trois POST à /v1/images/generations (affiche SFT, affiche turbo, la mise en page EXPLORE du README), écrit les PNG dans ./outputs et supprime le workload en sortant, sauf si IK_KEEP_ALIVE=1. Supprimer le workload n'arrête pas un pod loué. Le premier démarrage télécharge environ 28 GB, et le délai de disponibilité d'un backend custom du worker est de 300 s par défaut. .env.example mentionne encore un worker de 40 GB+. La section du README sur les cartes plus petites est la consigne à jour.
Une requête turbo (envoyée à notre manager local. Le service hébergé accepte la même forme, mais nous ne l'avons pas appelé) :
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/moss-image-sft/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"prompt": "A clean conference poster on a white wall. Large bold title: OPEN WEIGHTS DAY", "size": "1024x1024", "seed": 42, "mode": "turbo"}'
Backend
backend.py, slug moss-image-text2image, version 0.3.1, révision figée f972bd4b4b9e3852133cc5da954d87bc32cd8fb9. setup() lance snapshot_download de la révision figée (en sautant assets/), hf_hub_download du LoRA, DiffusionPipeline.from_pretrained(local, custom_pipeline="pipeline_moss_image", trust_remote_code=True, torch_dtype={"default": bf16, "vae": fp32}), et enveloppe les 252 projections des blocs (42 blocs x q, k, v, o, ffn_up_gate, ffn_down) dans un module LoRA sans fusion. process() accepte l'entrée native ou le corps de l'API images d'OpenAI, une chaîne ou un objet de mise en page, mode sft (50, CFG 3, skip [22]) ou turbo (8, CFG 1, LoRA 0.7), tire le bruit sur le CPU à partir de la seed, sérialise la génération avec un verrou (la force du LoRA est un état partagé) et renvoie {data: [{b64_json}]} plus seconds et vram_peak_gib. La v0.2.0 ajoute num_inference_steps comme alias de steps, et route vers turbo les requêtes sans mode avec guidance_scale 1 et steps <= 16. La v0.3 ajoute les modes de mémoire gpu, component, lowvram, minimal et auto (seuils _GPU_MIN_GIB=33.0, _LOWVRAM_MIN_GIB=14.5), les variables d'env MOSS_MEMORY_MODE, MOSS_VRAM_LIMIT_GIB, MOSS_ACTIVATION_RESERVE_GIB, MOSS_TURBO_LORA. La v0.3.1 (auto avec 0,5 GiB de marge) n'a jamais tourné sur un GPU : les exécutions mesurées ont utilisé la v0.3.0 avec chaque mode forcé par env.
Délai de disponibilité
Matin : ensure() à 05:51:47Z, le SDK indique "ready after 63 s" : venv 24 s, téléchargement de 28,4 GB en 28,6 s (environ 1 GB/s), chargement 8,5 s, custom backend ready on port 18000 à 05:52:52Z. Mesuré sur un worker dont le délai de disponibilité avait été porté à la main à 2400 s. Recyclage à chaud à la republication : 16 s. Redéploiement l'après-midi sur une seconde A40 : ensure à 09:59:45Z, prêt après 60 s, un appel affiche turbo à 11,198 s de GPU, 14,0 s aller-retour, pic alloué 28,72 GiB.
Mesures
Temps GPU mesuré dans le backend avec cuda.synchronize(), une requête à la fois. Aller-retour = du client HTTP au manager local.
| Cas | Mode / steps | Taille | GPU s | Aller-retour s |
|---|---|---|---|---|
| affiche (premier appel) | SFT 50 | 1024x1024 | 81.06 | 84.2 |
| affiche | turbo 8 | 1024x1024 | 9.02 | 9.8 |
| mise en page EXPLORE | SFT 50 | 1024x1024 | 79.88 | 80.6 |
| mot en chinois | SFT 50 / turbo 8 | 1024x1024 | 78.76 / 8.90 | 79.82 / 9.79 |
| infographie | SFT 50 / turbo 8 | 1344x768 | 78.11 / 8.85 | 78.88 / 9.46 |
| marché de Lisbonne | SFT 50 / turbo 8 | 1344x768 | 77.71 / 8.62 | 79.23 / 9.57 |
| menu sur ardoise | SFT 50 / turbo 8 | 1024x1024 | 79.10 / 8.78 | 80.49 / 9.83 |
| mains du pianiste | SFT 50 / turbo 8 | 1024x1024 | 78.83 / 8.87 | 79.94 / 9.70 |
| mise en page café, cadres en haut | SFT 50 / turbo 8 | 1024x1024 | 79.98 / 9.21 | 81.20 / 9.77 |
| mise en page café, cadres en bas | SFT 50 / turbo 8 | 1024x1024 | 80.08 / 8.94 | 81.18 / 9.52 |
| affiche | turbo 4 | 1024x1024 | 5.22 | 5.97 |
| marché de Lisbonne | turbo 8 | 1440x1440 | 17.30 | 19.47 |
| testeur du panneau, ardoise / infographie | turbo 8 (v0.2.0) | 1024x1024 / 1024x576 | 9.68 / 6.03 |
SFT de 77,7 à 81,1 s sur 9 images (environ 1,6 s par step, deux forwards). Turbo en 8 steps de 8,6 à 9,2 s sur 9 images à environ 1 MP, environ 8,9x plus rapide. Surcoût de la plateforme de 0,6 à 3,1 s, médiane d'environ 1,1 s (3,1 s au tout premier appel).
VRAM et puissance (nvidia-smi toutes les 1 s, 1 342 échantillons) : 25,9 GiB alloués après le chargement. Pic alloué de 28,72 GiB en 1024x1024, 28,67 GiB en 1344x768, 31,47 GiB en 1440x1440. Carte : 30 361 MiB pendant les exécutions à 1 MP, pic de 33 741 MiB (turbo en 1440x1440) sur 46 068 MiB. Utilisation 100 %, pic de puissance de la carte 302,6 W pour une limite de 300 W.
Texte, lu à la main sur chaque image. SFT : affiche "OPEN WEIGHTS DAY / 10:00 Keynote / 12:30 Lunch / 15:00 Workshops", infographie y compris "Median time: 9 seconds", ardoise "Espresso 2.50 / Cappuccino 3.20 / Croissant 2.00 / Daily soup 5.50", mot en chinois (记得买牛奶和鸡蛋!/ 牛奶两盒,鸡蛋一打。/ 顺便带一袋面包。), tout juste. Turbo : ardoise, mot en chinois et les deux mises en page justes. Erreurs : titre de l'affiche "OPEN WEIGHT / WEIGHTS DAY", infographie "PNG bock", texte des enseignes en partie illisible sur le marché de Lisbonne. Turbo à 4 steps : "OPEN WEIGHT DAYDY", des horaires comme "1(.C0".
Échelle de VRAM complète (émulée)
Après-midi, second pod A40. Le plafond est torch.cuda.set_per_process_memory_fraction (env MOSS_VRAM_LIMIT_GIB). Même affiche, seed 42, 1024x1024, le backend.py exact appelé dans le processus, un processus neuf par échelon, nvidia-smi échantillonné toutes les 500 ms. Modes : gpu garde tout résident. component correspond à enable_model_cpu_offload() (le mode "Component" des auteurs). lowvram garde l'encodeur de texte sous accelerate.cpu_offload, transféré couche par couche pour chaque prompt, avec le DiT et le VAE résidents. minimal est lowvram où seuls les blocs du DiT qui tiennent restent résidents, le reste sous cpu_offload, plus le tiling du VAE.
| Émule | Mode / plafond | Pic nvidia-smi (torch reserved) | SFT 50 s | Turbo 8 s | RSS max |
|---|---|---|---|---|---|
| 48 GB (vraie A40) | gpu, aucun | 30,359 MiB (29.32 GiB) | 79.55 | 8.82 | 7.3 GB |
| 24 GB | component, 23.0 GiB | 16,403 MiB (15.70 GiB) | 104.46 | 41.19 | 31.5 GB |
| 16 GB | lowvram, 15.0 GiB | 14,433 MiB (13.77 GiB) | 86.17 | 13.17 | 16.8 GB |
| 12 GB | minimal, 11.0 GiB, 31/42 blocs résidents | 11,427 MiB (10.83 GiB) | 160.38 | 17.84 | 21.6 GB |
Unités : le tableau du récit divise les pics nvidia-smi en MiB par 1 024 (29,6, 14,1 et 11,2 GiB), et ces pics incluent le contexte CUDA que le plafond de torch ne compte pas. En unités décimales, 14 433 MiB font 15,1 GB et 11 427 MiB font 12,0 GB. L'échelon 16 GB laisse environ 2 GiB de marge sur une carte de 16 GiB, avant que quoi que ce soit d'autre (un bureau, un autre processus) prenne sa part. Non testé sur du vrai matériel.
Les 8 PNG sont identiques octet par octet aux poster-sft.png et poster-turbo.png du matin (vérifié avec cmp) : le bruit est tiré sur le CPU à partir de la seed et l'offload ne fait que déplacer des poids. Lecture : lowvram coûte +8 % à 50 steps (86,2 contre 79,6 s) et +49 % en turbo, parce que l'encodeur de 16,8 GB passe par le PCIe pour chaque prompt (deux fois par image SFT, une fois par image turbo). minimal est 2,0x plus lent dans les deux modes : 11 des 42 blocs sont transférés à chacun des 100 forwards. component tient dans 24 GB mais pas dans 16 GB et il est plus lent que lowvram, donc auto ne le choisit jamais, et lowvram est aussi le meilleur choix sur une carte de 24 GB.
Notre première tentative d'échelle a échoué au chargement pour chaque échelon plafonné avec ValueError: Expected a torch.device with a specified index or an integer, but got:cuda. C'était notre bug (set_per_process_memory_fraction a besoin d'un index de device). Nous l'avons corrigé et avons relancé.
Problèmes restants et statut
- Délai de disponibilité du backend custom (
INFERENCEKEY_CUSTOM_BACKEND_READY_TIMEOUT_SECS) : 300 s par défaut, et le bootstrap des GPU de notre propre cloud écrit un manifeste fixe sans champ pour des variables d'env supplémentaires. Nous avons ajouté=2400à/opt/inferencekey/worker.env.manifestpar SSH et relancé le worker. Le setup a pris 37 s, donc la valeur par défaut aurait suffi sur cet hôte. À 100 MB/s, le téléchargement seul prend environ 280 s. Ouvert. - Aucune config par workload n'atteint un backend custom, donc SFT contre turbo est un champ de la requête (
mode). Voulu ici : un seul exemplaire chargé sert les deux, et deux exemplaires ne tiendraient pas dans 48 GB. - Le testeur d'images du panneau n'envoie que
prompt, size, n, num_inference_steps, guidance_scale, response_format(par défaut 20 steps / guidance 4,5) et aucun mode. Corrigé dans le backend v0.2.0 (qui passe aussi en turbo quand le testeur demande une image rapide), vérifié après le recyclage à chaud qui a redémarré le modèle en service en 16 s (un corps du style du panneau a tourné en turbo, 6,81 s de GPU en 1024x576). - Pods grand public sans SSH direct. Des pods RTX 5080 16 GB community, RTX 4090 24 GB secure et RTX 3080 Ti 12 GB community ont été créés via le manager et chacun a échoué au bout de 180 s avec
ssh.direct is null, no port 22 mapping. RTX 3060, 3080 Ti, 4070 Ti, 4080, 4080 SUPER, 5080 secure et A4000 n'avaient pas de stock (409). RTX 4060 Ti a renvoyé 502 unknown GPU type. Lecreate_pod_bodydu manager ne demande pas d'IP publique. Ouvert. - Cosmétique : la colonne Access du panneau affiche "No access" avec une clé wildcard qui fonctionne. Avertissements de log sans gravité : le fast path de l'encodeur Qwen3.5 n'est pas installé (repli sur PyTorch), des attributs de config du scheduler "will be ignored", un avertissement
Expected types for transformerqui nomme la même classe.
Alternatives que nous n'avons pas testées
- lodestones/Kromoss : Base entraîné davantage sur 704 000 images, remplaçant direct de SFT, avec ses propres LoRA en 8 steps. Sa card dit que 4 steps fonctionnent aussi.
- darask0/MOSS-Image_4-step_adapter_lora : un adaptateur en 4 steps prolongé à partir du 8 steps de lodestones.
- akhaliq/MOSS-Image-SFT-4-steps : adaptateur en 4 steps avec un palier à 3 steps, démarré à partir du 8 steps de lodestones.
- Les reconditionnements Comfy-Org/MOSS-Image : DiT int8 (5,4 GB) plus encodeur de texte w4a8 (7,3 GB), environ 13 GB de fichiers. Comfy-Org n'indique aucune taille de GPU. Notre offload en bf16 tenait déjà sous le plafond de 12 GB avec une sortie identique, donc nous n'en avions pas besoin. Leur effet sur l'orthographe nous est inconnu.
Les quatre sont sous Apache 2.0, d'après leurs cards. Les chiffres de vitesse et de qualité de ces cards sont des affirmations de leurs auteurs.
Limites
- Un seul modèle de GPU (A40), une seed par prompt, 22 images, nos propres prompts. Comportement, pas qualité de benchmark. Les jugements de qualité sont les nôtres, après lecture de chaque image.
- Les résultats 24, 16 et 12 GB sont des plafonds de mémoire sur une A40, un seul prompt, pas de vraies cartes.
- Une requête à la fois. Non essayé :
n> 1, le modèle Base, ComfyUI, la concurrence, les fichiers quantifiés, Kromoss, les adaptateurs dédiés en 4 ou 3 steps, les plafonds de mémoire sous 11 GiB, les tailles au-delà de 1 MP dans les modes avec offload. Notre résultat en 4 steps est le LoRA en 8 steps lancé à 4 steps.
Crédits
OpenMOSS chez MOSI.AI : le modèle, les versions Base et SFT, la pipeline, le guide d'utilisation, le format de mise en page et le rapport. L'équipe Qwen : Qwen3.5-9B. Black Forest Labs : le petit VAE FLUX.2. L'équipe ComfyUI : le support natif, PR #17095. Comfy-Org : les reconditionnements quantifiés. lodestones : le LoRA en 8 steps que nous avons utilisé et Kromoss. darask0 et akhaliq : les adaptateurs en 4 et 3 steps. L'application du LoRA suit le Space hugging-apps/moss-image-8-step-dmd. AI Search, c'est là que nous avons repéré le modèle.
Sources : card MOSS-Image-SFT, card MOSS-Image-Base, repo GitHub, guide d'utilisation, rapport technique, lodestones 8-step DMD, reconditionnement Comfy-Org, Kromoss, exemple du SDK.