MOSS-Image schreibt in 80 Sekunden jedes Wort richtig, in 9 fast jedes
Praxistest von MOSS-Image auf einer A40: jedes Wort richtig in 80 s, 9 s mit Turbo-Add-on, und dieselben Pixel unter einer emulierten 12-GB-Speichergrenze.
Achtzig Sekunden, jedes Wort richtig. Neun Sekunden, ein Wort doppelt. Das ist der Tausch, den wir mit MOSS-Image gemessen haben, einem offenen Modell, das dafür gebaut ist, langen Text in Bilder zu schreiben, auf einer gemieteten A40-Grafikkarte. Die 80 Sekunden sind das 50-Schritte-Rezept der Autoren. Die 9 kommen von einem Turbo-Add-on aus der Community, das ab und zu ein Wort falsch schreibt. Die Lizenz erlaubt kommerzielle Nutzung, also zählt das für alle, die in einem Produkt Plakate, Speisekarten oder Social Cards erzeugen. Mit allem geladen belegte das Modell etwa 30 GB Speicher auf der Karte. Als wir die A40 auf 12 GB Speicher begrenzt haben, hat sie das identische Bild mit halber Geschwindigkeit gemacht. Mit unserem SDK-Beispiel kannst du es auf deiner eigenen GPU deployen, und dieser Beitrag sagt dir, welches Setup du nehmen solltest.
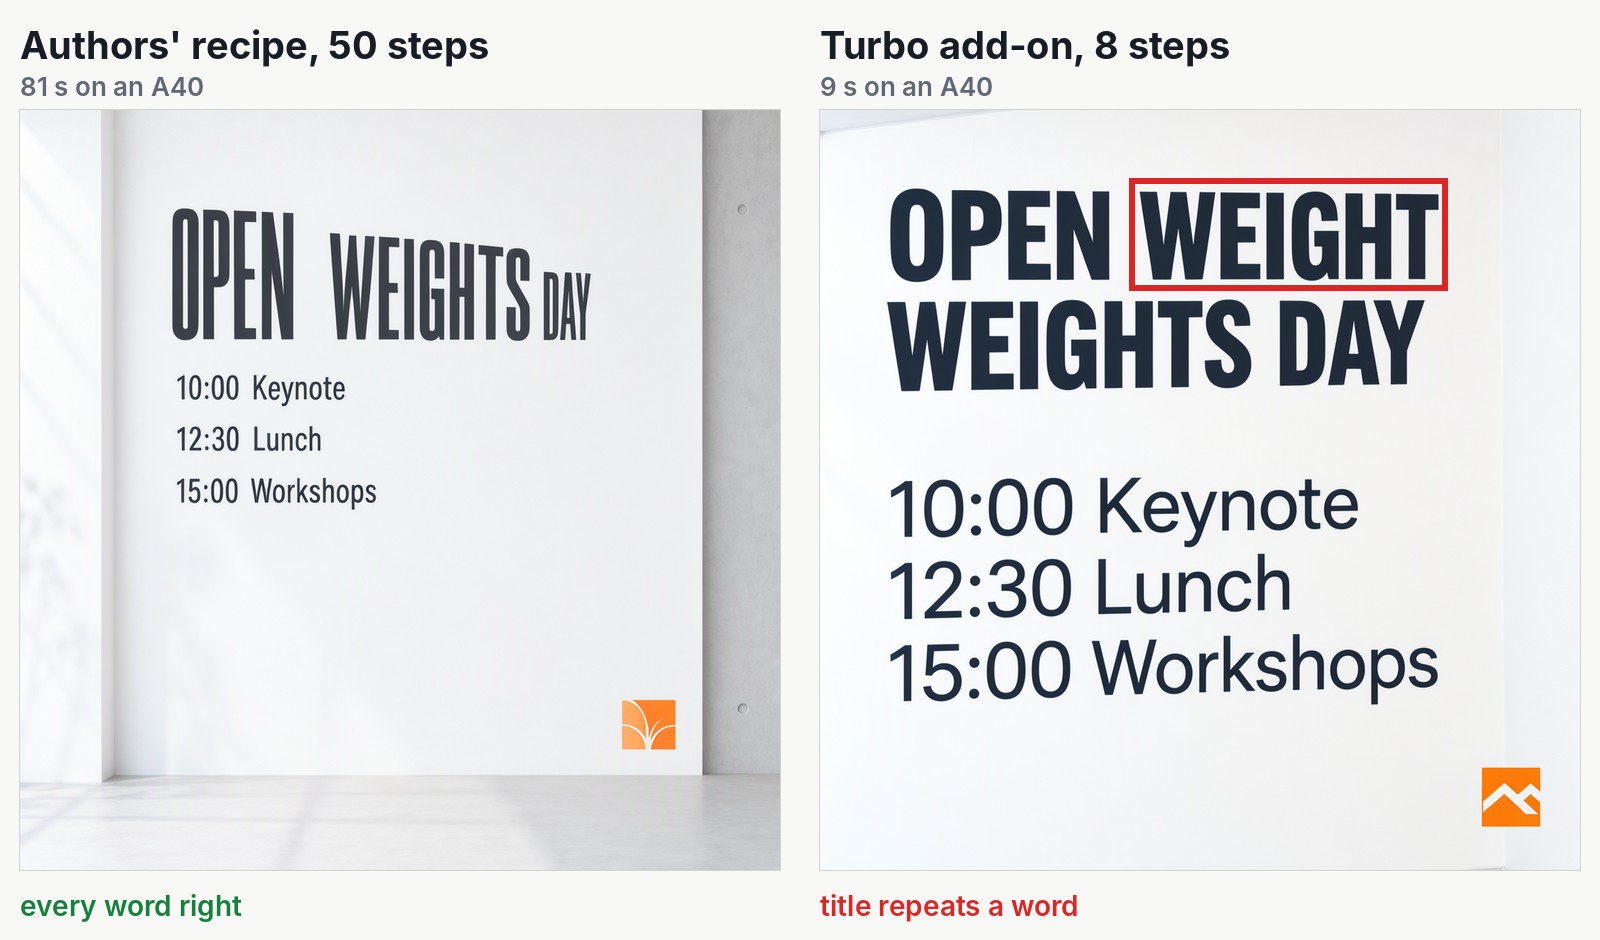
Gleicher Prompt, gleicher zufälliger Start, gleiches geladenes Modell. Der rote Kasten markiert den einzigen Fehler: Der Turbo-Titel wiederholt ein Wort.
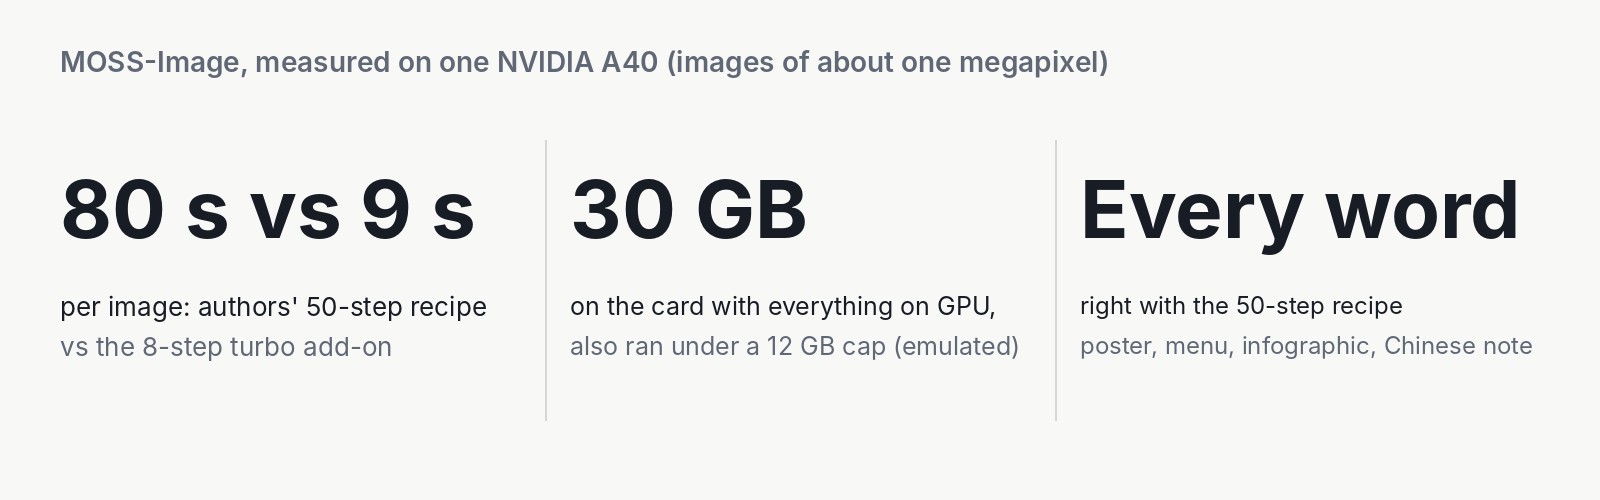
Gebaut für langen Text in Bildern, mit einem Layout, das du bestimmst
MOSS-Image ist für langen Text gebaut. Eine volle Speisekarte mit Preisen, eine Infografik mit einem Dutzend Beschriftungen oder ein Programm auf einem Plakat: Genau da patzen Bildmodelle. Iris-3B, das letzte, das wir getestet haben, ließ bei einer vierzeiligen Speisekarte die Dezimalpunkte weg. Die Autoren nennen Textdarstellung und lange Prompts als die Hauptmerkmale des Modells.
In ihrem technischen Bericht haben die Autoren einen eigenen Test für langen Text in Bildern gebaut. Sie berichten, dass MOSS-Image im Schnitt 96,3 % des verlangten Texts schreibt, das beste Ergebnis unter den Modellen, deren Dateien öffentlich sind. Es ist ihr Benchmark, und wir haben nur die Zusammenfassung gelesen, also nimm es als ihre Behauptung. Unser kleiner Test weiter unten zeigt in dieselbe Richtung.
Du kannst auch das Layout bestimmen. Statt eines Satzes kannst du eine kurze strukturierte Beschreibung schicken. Sie enthält eine Beschreibung des ganzen Bildes, dann eine Liste von Elementen, jedes mit seinem Text und einem Kasten auf der Leinwand, wo es hinsoll. Die Autoren nennen das experimentell. Wir haben zwei Layouts ausprobiert, und beide wurden eingehalten.
Wir haben MOSS-Image-SFT betrieben, die Version mit zusätzlichem Training auf handverlesenen Beispielen.
OpenMOSS hat das Modell gebaut, lodestones das Turbo-Add-on, und entdeckt haben wir es in einem Video von AI Search. Unser Teil waren der Code, der es ausliefert, das SDK-Beispiel, das Deployment auf InferenceKey und die Messungen. Die vollständigen Credits stehen im Anhang.
Der Test: eine A40, 22 Bilder, je ein Versuch
Wir haben 22 Bilder gemacht, ein Versuch pro Prompt, auf einer A40 und mit einer Anfrage nach der anderen. Das zeigt, wie sich das Modell verhält, nicht, wo es im Ranking steht. Das Base-Modell und mehrere Nutzer gleichzeitig haben wir nicht ausprobiert. Die vollständige Liste steht im Anhang.
Die A40 mit 48 GB Speicher haben wir in unserer eigenen Cloud gemietet. Das Modell lief über eine private Testkopie von InferenceKey, unser Produktivdienst wurde also nie angefasst. Wir haben eine 48-GB-Karte gewählt, weil allein die Modelldateien etwa 27 GB belegen, plus Platz zum Arbeiten.
Eine Kopie des Modells blieb geladen und bediente beide Modi. Jede Anfrage sagte, welchen sie wollte: das Rezept der Autoren oder das Turbo-Add-on. Die Prompts haben wir selbst geschrieben: ein Konferenzplakat, eine Infografik, eine Kreidetafel-Speisekarte und eine handgeschriebene chinesische Notiz aus den Beispielen der Autoren. Dann zwei Layouts, ein Straßenfoto und die Hände eines Pianisten. Am Nachmittag haben wir das Plakat noch einmal unter Speichergrenzen laufen lassen, um zu sehen, mit wie kleiner Karte es auskommt.
Ergebnisse: 80 Sekunden für jedes Wort richtig, 9 Sekunden mit Wörtern zum Nachprüfen
Das Rezept der Autoren hat in jedem Texttest, den wir ihm gegeben haben, jedes Wort richtig geschrieben. Das Turbo-Add-on war etwa neunmal schneller. Es hat im verlangten Text zwei Wörter falsch geschrieben (eines doppelt, eines vertippt) und in einem Straßenfoto halb verstümmelte Schilder erfunden, also würden wir es nicht ohne Kontrolle ausliefern.
| Rezept der Autoren (50 Schritte) | Turbo-Add-on (8 Schritte) | |
|---|---|---|
| Zeit pro Bild mit etwa einem Megapixel | 78 bis 81 Sekunden | 8,6 bis 9,2 Sekunden |
| Text | alles richtig: Plakat, Infografik, Speisekarte, chinesische Notiz | richtig: Speisekarte, chinesische Notiz, Layouts. Falsch: Plakattitel, eine Beschriftung der Infografik, Schilder in einem Foto |
Warum das Rezept langsam ist, ist einen Absatz wert, denn es ist auch der Grund, warum es Turbo gibt. Das Modell startet mit zufälligem Rauschen und säubert es in 50 Schritten zu einem Bild. Bei jedem Schritt läuft es zweimal, einmal mit deinem Prompt und einmal ohne, und behält den Unterschied, um das Bild zu schärfen. Das sind etwa 100 Durchläufe pro Bild. Das Add-on von lodestones bringt dem Modell bei, in 8 Durchläufen ans Ziel zu kommen, ohne zweiten Lauf. Es ist eine Datei mit 1,2 GB, die über das Originalmodell gelegt wird, und ihr Autor bezeichnet sie als Work in Progress. Stell dir das Rezept als die volle Studioaufnahme mit jedem Overdub vor und Turbo als die Live-Version in einem Take: meistens gut, ab und zu ein schiefer Ton.
Das Plakat vom Anfang ist der deutlichste Fall. Die Infografik ist der andere Ausrutscher. Das Rezept der Autoren hat jede Beschriftung geschrieben, auch die Fußzeile „Median time: 9 seconds“. Turbo schrieb „PNG bock“ statt „PNG back“.
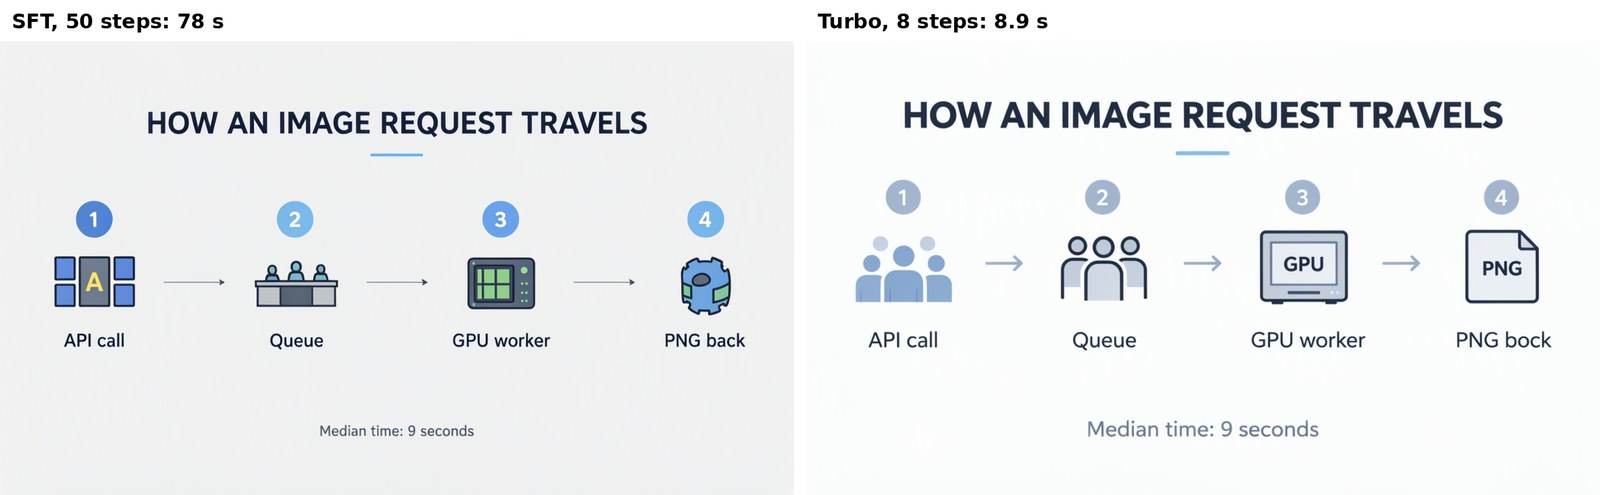
Links das Rezept der Autoren. Rechts Turbo mit „PNG bock“. Im Dashboard von InferenceKey, mit einem leicht anderen Prompt, hat Turbo jede Beschriftung richtig geschrieben.
Die Kreidetafel-Speisekarte ist uns wichtig, weil sie Iris-3B zu Fall gebracht hat, das letzte Bildmodell, das wir getestet haben. Iris ließ Dezimalpunkte weg und wiederholte Zeilen. MOSS-Image schrieb „Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50“ in beiden Modi richtig. Auch die handgeschriebene chinesische Notiz kam in beiden Modi exakt heraus, alle drei Zeilen.
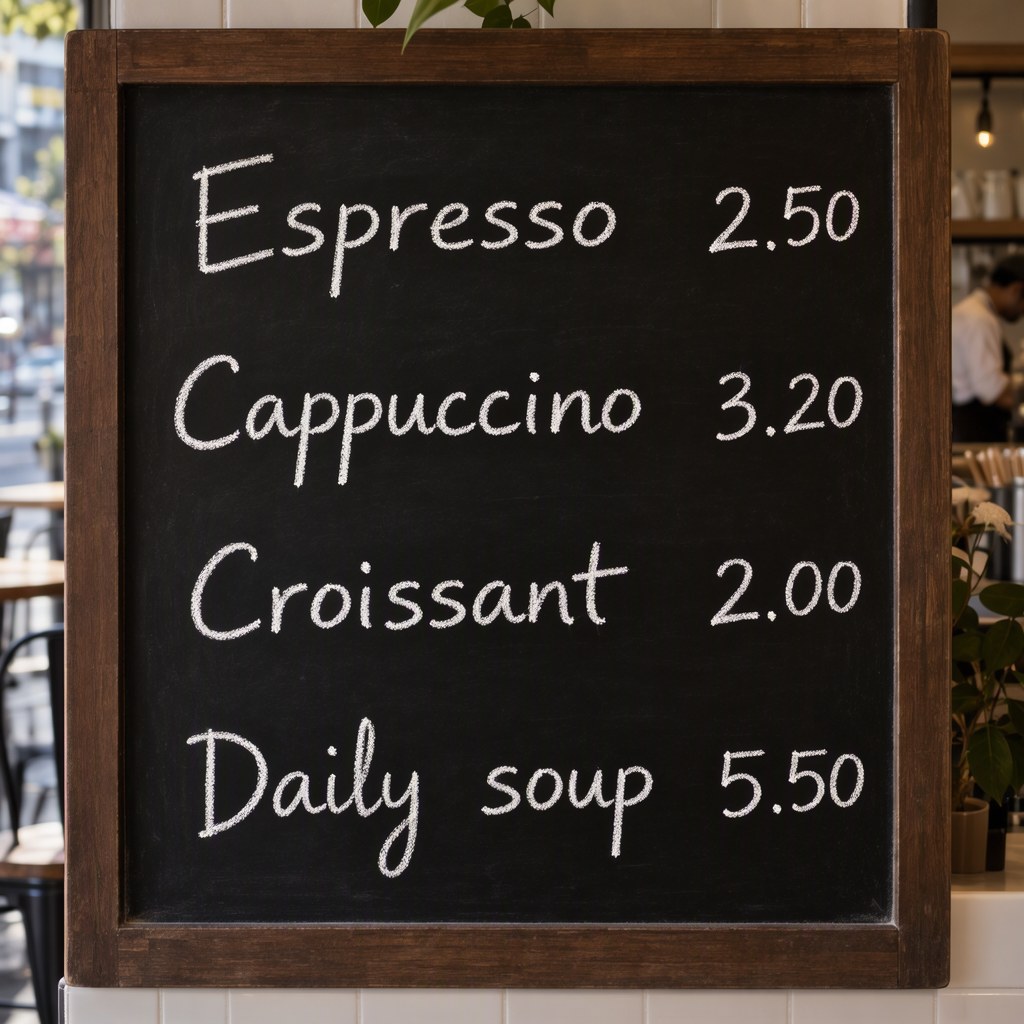
Vier Preise, vier Dezimalpunkte, keine doppelten Zeilen.
Layouts und Hände hielten, Turbo auf 4 Schritte gedrückt nicht
Abseits vom Text hat das Modell getan, was wir verlangt haben. Beide Layouts wurden eingehalten, und die Hände stimmten. Das Einzige, was kaputtging, war unser eigenes Experiment mit weniger Schritten.
Wir haben ein Kaffeeplakat als Layout mit drei Elementen geschickt: einem Titel, einem Slogan und einer Tasse. Dann haben wir es noch einmal geschickt, mit den Kästen von oben nach unten verschoben. Alles ist in seinen neuen Kasten gewandert, richtig geschrieben, in beiden Modi.
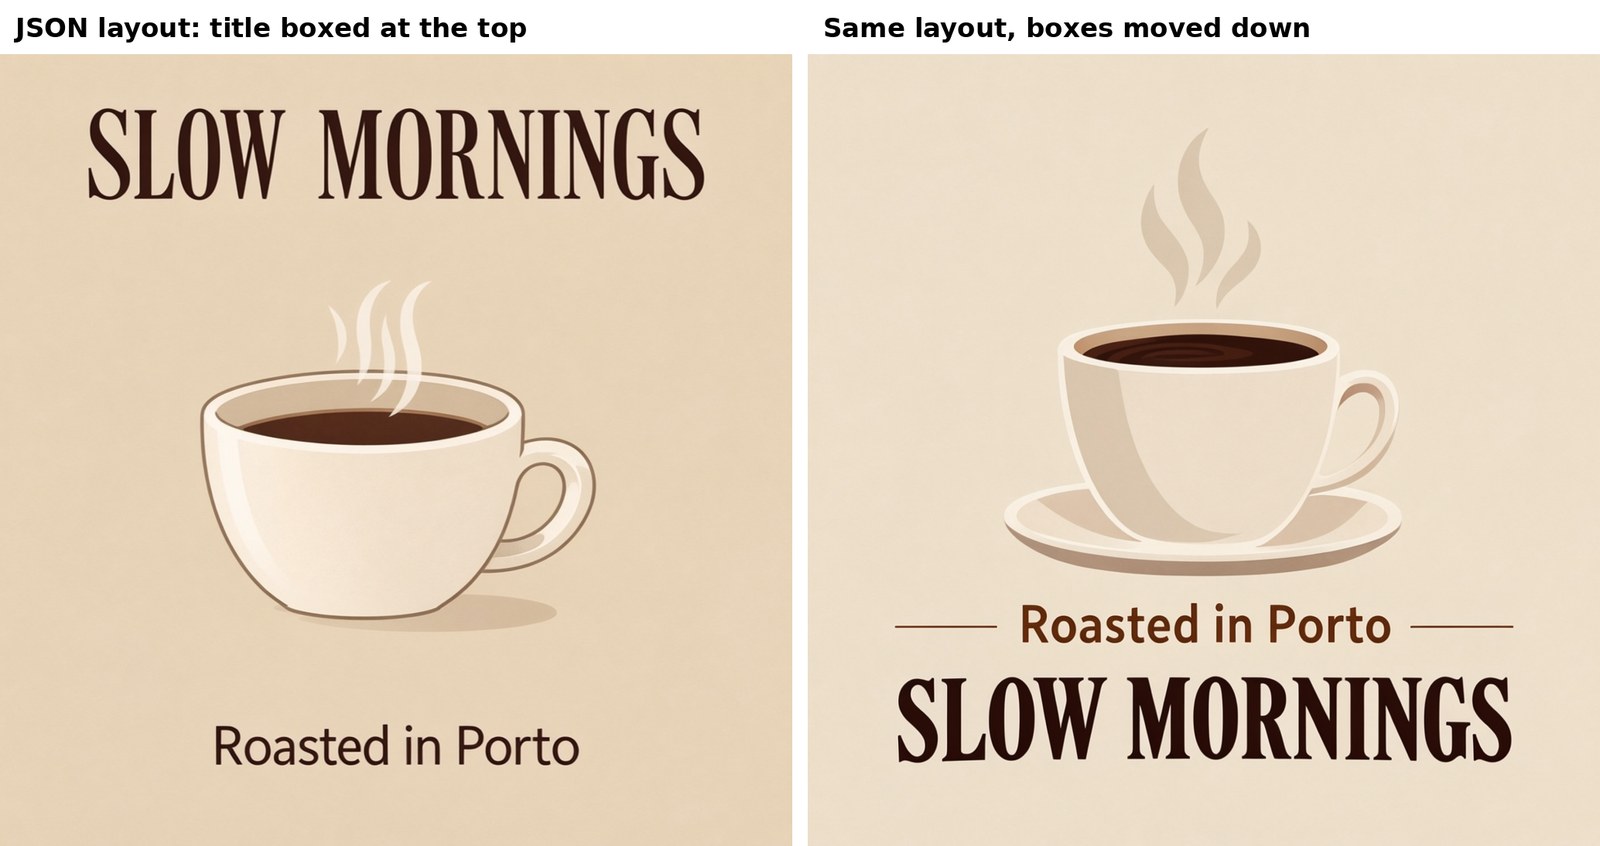
Gleiches Layout, Kästen verschoben. Die Wörter und die Tasse sind mitgegangen.
Hände sind ein klassischer Schwachpunkt von Bildmodellen. Wir haben die beiden Hände eines Pianisten verlangt, und das Rezept der Autoren hat sie richtig gezeichnet, beim Spielen, samt ihrer Spiegelung im schwarzen Lack hinter den Tasten. Die Turbo-Version desselben Prompts hat ebenfalls zwei plausible Hände gezeichnet.
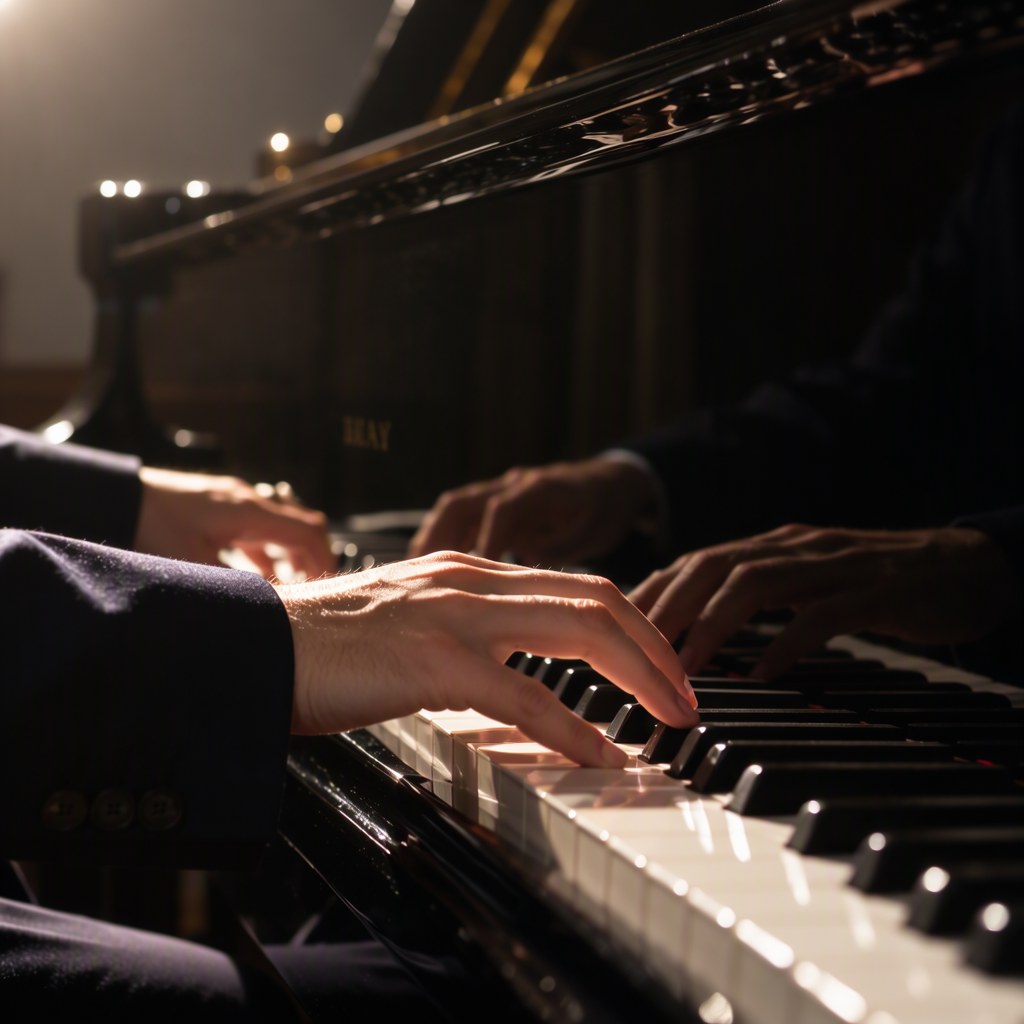
Das Paar hinter den Tasten ist ihre Spiegelung im Lack.
Dann haben wir das 8-Schritte-Add-on auf 4 Schritte gedrückt, um zu sehen, was passiert. Es brauchte 5,2 Sekunden, und der Text fiel auseinander: „OPEN WEIGHT DAYDY“ und Uhrzeiten wie „1(.C0“. Das ist das Add-on, unter das gedrückt, wofür es trainiert wurde. Add-ons, die für 4 Schritte gebaut sind, haben wir nicht getestet.
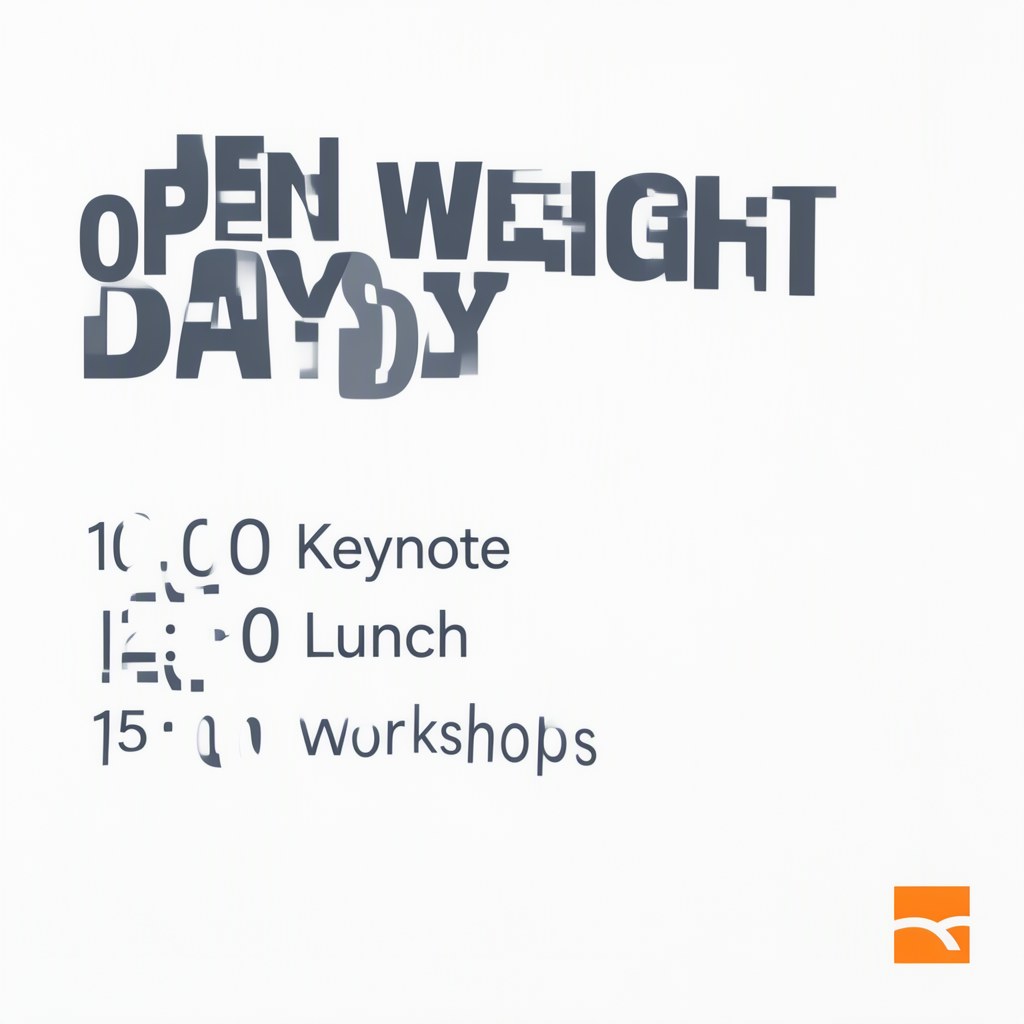
8-Schritte-Add-on, vier Schritte: schneller, und die Wörter brechen.
Welche GPU: auf 12 GB Speicher begrenzt lieferte die A40 dieselben Pixel mit halber Geschwindigkeit
Du brauchst wahrscheinlich keine 48-GB-Karte. Wir haben begrenzt, wie viel Speicher das Modell auf der A40 nutzen durfte, damit sie sich wie eine Karte mit 16 GB oder 12 GB Speicher verhält. Unter beiden Grenzen hat sie exakt dasselbe Plakat gezeichnet. Mit dem Rezept der Autoren lief das 16-GB-Setup fast mit voller Geschwindigkeit und das 12-GB-Setup etwa doppelt so langsam.
Emuliert wurde nur die Speichergröße, nicht die Geschwindigkeit einer Consumer-Karte oder ihre Verbindung zum Hauptspeicher. Diese Geschwindigkeiten sind also relativ zu einer A40, keine Vorhersagen für eine RTX 5080 oder eine RTX 3080 Ti. Dass es passt, ist der Teil, dem wir trauen, und auch das ist auf einer echten Karte noch nicht bestätigt (siehe die Ecken und Kanten unten).
Dass es passt, liegt daran, wie das Modell gebaut ist. Es sind zwei Modelle, die als Paar arbeiten: ein Leser und ein Maler. Der Leser ist das Sprachmodell mit 17 GB, das deinen Prompt in eine Beschreibung verwandelt. Der Maler ist das Modell mit 10 GB, das über all diese Schritte Rauschen zu einem Bild säubert. Der Leser arbeitet am Anfang jedes Bildes einen Moment lang und sitzt dann untätig herum. Also kann er im Hauptspeicher des Rechners warten und Stück für Stück durch die Karte laufen, wenn ein Prompt ankommt. Im 12-GB-Setup wartet dort auch ein Teil des Malers.
| Speichergrenze | Spitzenspeicher auf der Karte | Rezept der Autoren | Turbo |
|---|---|---|---|
| Keine, alles auf der Karte (echte A40, 48 GB) | etwa 30 GB | 80 s | 9 s |
| 16 GB (emuliert), Leser im Hauptspeicher | etwa 14 GB | 86 s | 13 s |
| 12 GB (emuliert), Leser und ein Teil des Malers im Hauptspeicher | etwa 11 GB | 160 s | 18 s |
Spitzenspeicher, wie die Karte selbst ihn meldet. Die genauen Zahlen stehen im Anhang.
Die Ausgaben waren Byte für Byte dieselben Dateien wie im Lauf mit allem auf der Karte. Das 12-GB-Plakat hat also jedes Wort richtig, und das Turbo-Plakat behält sein doppeltes Wort. Auf einer 16-GB-Karte ist es knapp, etwa 2 GB Luft, weniger, wenn die Karte auch deinen Bildschirm betreibt. Auf einer 24-GB-Karte ist Platz. Unser SDK-Beispiel wählt das Setup nach dem freien Speicher der Karte. Diese automatische Wahl ist noch nicht auf einer GPU gelaufen: Wir haben jedes Setup von Hand eingestellt.
Das andere, womit du planen musst, ist der Hauptspeicher des Rechners. In den Setups mit 16 und 12 GB hat der Prozess bis zu 22 GB Hauptspeicher belegt, gib der Maschine also etwa 32 GB.
Auf InferenceKey: eine geladene Kopie bediente beide Modi, bereit nach 63 Sekunden
Die Karte gehört dir stundenweise, und du entscheidest, was darauf läuft. Eine geladene Kopie von MOSS-Image bediente das Rezept der Autoren und das Turbo-Add-on, Anfrage für Anfrage. Sie war 63 Sekunden nach unserer Anforderung bereit für Anfragen, auf einer gemieteten Maschine, die 78 Sekunden gebraucht hatte, um zu starten und sich mit InferenceKey zu verbinden.
MOSS-Image kommt mit eigenem Ladecode. Die fertigen Backends von InferenceKey (der Code, der ein Modell einmal lädt und Anfragen beantwortet) führen keinen modelleigenen Code aus. Also haben wir unser eigenes geschrieben, eine kleine Python-Datei. Beim Start lädt es eine feste Version des Modells und des Add-ons herunter und lädt sie dann so, wie die Autoren es tun. Von diesen 63 Sekunden brauchte der Download von 28 GB 29 und das Laden auf die Karte 9. Bei einer langsameren Verbindung ist der Download der Teil, der wächst.
Jede Anfrage nennt ihren Modus, sft oder turbo, und der Prompt kann ein Satz oder ein Layout sein. Das Backend spricht dasselbe Anfrageformat wie die Bild-API von OpenAI, also kann bestehender Code es aufrufen. Der Weg durch InferenceKey kostete pro Bild etwa eine Sekunde zusätzlich zur Arbeit der Karte.
Warum nicht ComfyUI, die beliebte Desktop-App für Bildmodelle? Es kann MOSS-Image schon ausführen, und für eine Person, die am Schreibtisch Bilder macht, ist es der kürzere Weg. Wir wollten eine API, die andere Programme aufrufen, auf einer Karte, die wir aussuchen.
Die 90-Sekunden-Aufnahme unten zeigt das Dashboard von InferenceKey während des Tests, mit dem Modell auf der A40. Dann macht der Bildtester des Dashboards die Kreidetafel-Speisekarte in 9,7 Sekunden und eine breite Infografik in 6, jeder Preis und jede Beschriftung richtig. Die Firma im Dashboard, Pixelforge Studio, ist ein erfundenes Demo-Konto.
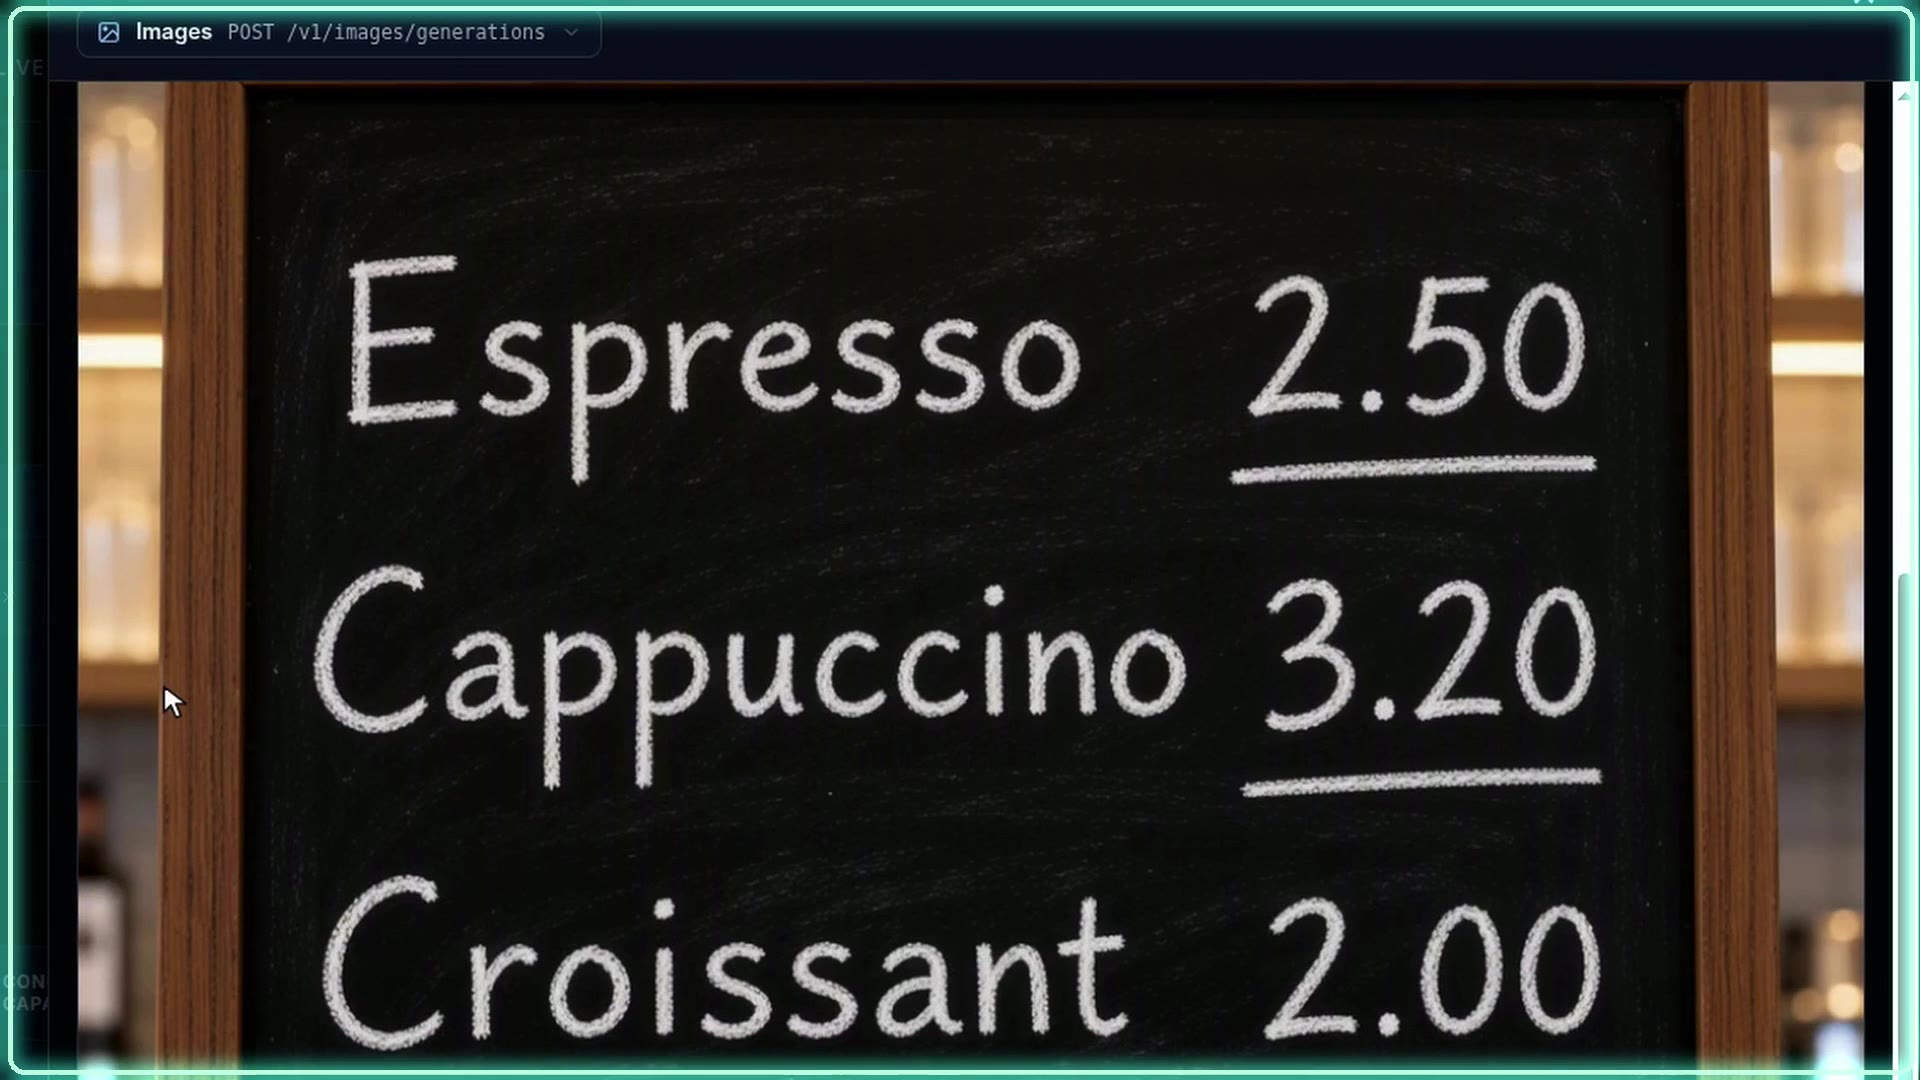
Klicken, um das MP4 abzuspielen (90 s, mit Sprecher).
Zwei Ecken und Kanten, an die du auch stoßen würdest:
- Eine feste Startgrenze. Ein Backend, das du selbst schreibst, hat 300 Sekunden, um bereit zu werden. Auf einer Maschine, die InferenceKey für dich mietet, gibt es keine Einstellung, um das zu erhöhen. Eine langsame Leitung kann das allein mit dem Download verbrauchen. Wir haben es von Hand erhöht. Status: offen.
- Manche gemieteten Consumer-Karten lassen sich nicht einrichten. Unsere eigene Cloud hat uns die angefragten Maschinen mit RTX 3080 Ti, RTX 5080 und RTX 4090 gegeben. Diesen Maschinen fehlte die direkte Verbindung, über die InferenceKey sich installiert, also hat es jede nach drei Minuten zurückgegeben. Status: offen, Mieten werden danach noch nicht gefiltert.
Solltest du es nutzen? Das 50-Schritte-Rezept, wenn die Wörter stimmen müssen, Turbo für Entwürfe
- Wenn der Text stimmen muss (eine Speisekarte, ein Preis, eine Rechtszeile), nimm das 50-Schritte-Rezept der Autoren, auf einer 48-GB-Karte oder im 16-GB-Setup. Es war in unserem Test der einzige Modus ohne Ausrutscher.
- Wenn du Tempo brauchst (Entwürfe, Vorschauen, einfache Layouts), nimm das Turbo-Add-on und lies jedes Wort, bevor es rausgeht.
- Wenn deine GPU klein ist, probier das 16-GB-Setup auf einer Karte mit 16 oder 24 GB und 32 GB Hauptspeicher.
- Wenn du eine Lizenz für ein Produkt brauchst, deckt Apache 2.0 auf dem Modell und dem Add-on das ab.
Um dieselben Bilder auf deiner eigenen NVIDIA-Maschine zu machen, veröffentlichst du das Backend einmal mit publish.py und startest python main.py aus dem SDK-Beispiel (Schritte im Anhang). Dafür muss die Maschine mit einem InferenceKey-Projekt verbunden sein. Beim ersten Start lädt es etwa 28 GB herunter, und am Ende löscht es das Deployment. Eine gemietete Maschine stoppst du selbst. Wir haben es auf einer 48-GB-Karte laufen lassen.
Für Ingenieure
Modell und Dateien
SFT-Card, Base-Card, GitHub, technischer Bericht, arXiv:2610.23374. Die README beschreibt es als „a 5B-parameter base DiT model with high-quality text rendering, layout generation, and efficient fine-tuning“, mit Prompts bis 4K Tokens. DiT mit 42 Layern (dim 3072, text_dim 4096, 128 latente Kanäle), Text-Encoder Qwen3.5-9B (Qwen3_5Model, 32 Layer, 3 von 4 mit Linear Attention), kleines FLUX.2-VAE (AutoencoderKLFlux2). Apache-2.0 auf beiden HF-Repos und auf GitHub. Day-0-Support in SGLang, vLLM-Omni und ComfyUI. Etwa 1.200 GitHub-Sterne am 21. Oktober. Abstract des Berichts: LLTB durchschnittliche Textabdeckung 96,3 % (das Beste unter Open Weights, laut den Autoren). Wir haben nur das Abstract gelesen.
| Repo / Datei | Größe |
|---|---|
OpenMOSS-Team/MOSS-Image-SFT @ f972bd4b, gesamt | 27,229,060,886 B |
| transformer, 3 Shards, bf16 | etwa 10.16 GB |
| text_encoder, 4 Shards | etwa 16.79 GB |
| VAE | 249.5 MB |
lodestones 8-step DMD lora_latest.safetensors @ f95df83b | 1,189,176,800 B (fp32, rank 128 / alpha 128) |
Sampling
Rezept der Card: Flow-Matching-Euler, 50 Schritte, CFG 3, Shift 5, leerer Negative Prompt, Negativ-Zweig mit uncond_skip_layers=[22], zwei Transformer-Forwards pro Schritt. Erfordert torch >= 2.9, diffusers >= 0.38, transformers >= 5.3. Breite und Höhe müssen Vielfache von 16 sein. Benutzerhandbuch: 1 bis 2 MP empfohlen, 0,25 bis 4 MP möglich. Turbo: lora_latest.safetensors ungemergt mit Stärke 0,7, 8 Schritte, CFG 1 (kein Negativ-Zweig, ein Negative Prompt wird also ignoriert). Die LoRA-Card nennt es eine Work-in-Progress-Destillation von 50 Schritten mit CFG 3 auf 8 Netzauswertungen und sagt, das Delta sei kleiner als der Rundungsschritt von bf16, daher ungemergt. Unsere ungemergte Anwendung folgt dem Demo-Space der LoRA, hugging-apps/moss-image-8-step-dmd.
Layout-Prompt (README und Benutzerhandbuch, „Layout Prompts (Experimental)“): summary {meta, canvas, caption} plus items [{label, caption, text?, bbox}], "bbox_format": "yxyx", "bbox_coord_space": "abs_centralized" (Pixel ab der Mitte der Leinwand). Durch json.dumps(layout, ensure_ascii=False) übergeben.
Unser Setup
NVIDIA A40 48 GB in unserer eigenen Cloud (46.068 MiB), Secure-Stufe, CA-MTL-1, Treiber 595.91.07, Image runpod/pytorch:1.0.7-cu1300-torch291-ubuntu2404-cluster. L40 Community-Stufe lieferte 409 (kein Bestand). Worker per Bootstrap von einem lokalen InferenceKey-Manager über HTTP- und TCP-Tunnel, 78 s ab dem POST für den Pod. Backend-venv: Python 3.12.3, torch 2.14.1+cu130, diffusers 0.38.0, transformers 5.3.0, installiert mit uv. Produktion nie angefasst.
Deployment Schritt für Schritt
Das SDK-Beispiel (Commit a69c6e5 auf main). Du brauchst ein SDK-Token (ik_sdk_...), einen API-Key (ik_live_...), einen Projekt-Slug, die IK_WORKER_ID eines registrierten NVIDIA-Workers (CUDA-13-Treiber, 580+) und für publish.py eine Tenant-ID und ein Session-Token des Dashboards (oder du lädst dist/*.tar.gz im Dashboard hoch). Plane etwa 32 GB System-RAM ein, wenn die Karte kleiner als 40 GB ist.
cp .env.example .env        # SDK token, API key, project, worker id, tenant id, dashboard session token
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # once: packages backend.py and registers it as "moss-image-text2image"
python main.py              # deploy, wait until ready, make 3 pictures, delete the workload
main.py ruft ensure() mit ExecutionPolicy.FIXED und 1 Replica auf, dann wait_until_ready(timeout=3600), schickt drei POSTs an /v1/images/generations (Plakat SFT, Plakat Turbo, das EXPLORE-Layout der README), schreibt PNGs nach ./outputs und löscht den Workload beim Beenden, außer bei IK_KEEP_ALIVE=1. Das Löschen des Workloads stoppt keinen gemieteten Pod. Der erste Start lädt etwa 28 GB herunter, und der Ready-Timeout des Workers für Custom Backends liegt standardmäßig bei 300 s. .env.example erwähnt noch einen Worker mit 40 GB+. Der Abschnitt der README zu kleineren Karten ist die aktuelle Anleitung.
Eine Turbo-Anfrage (an unseren lokalen Manager geschickt. Der gehostete Dienst nimmt dieselbe Form an, wir haben ihn aber nicht aufgerufen):
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/moss-image-sft/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"prompt": "A clean conference poster on a white wall. Large bold title: OPEN WEIGHTS DAY", "size": "1024x1024", "seed": 42, "mode": "turbo"}'
Backend
backend.py, Slug moss-image-text2image, Version 0.3.1, gepinnte Revision f972bd4b4b9e3852133cc5da954d87bc32cd8fb9. setup() macht snapshot_download der gepinnten Revision (ohne assets/), hf_hub_download der LoRA, DiffusionPipeline.from_pretrained(local, custom_pipeline="pipeline_moss_image", trust_remote_code=True, torch_dtype={"default": bf16, "vae": fp32}) und umhüllt die 252 Block-Projektionen (42 Blöcke x q, k, v, o, ffn_up_gate, ffn_down) mit einem ungemergten LoRA-Modul. process() akzeptiert natives Input oder den Body der OpenAI-Images-API, einen String oder ein Layout-Objekt, mode sft (50, CFG 3, skip [22]) oder turbo (8, CFG 1, LoRA 0,7), zieht das Rauschen auf der CPU aus dem Seed, serialisiert die Generierung mit einem Lock (die LoRA-Stärke ist geteilter Zustand) und gibt {data: [{b64_json}]} plus seconds und vram_peak_gib zurück. v0.2.0 fügt num_inference_steps als Alias von steps hinzu und leitet kein mode + guidance_scale 1 + Schritte <= 16 auf Turbo. v0.3 fügt die Speichermodi gpu, component, lowvram, minimal und auto hinzu (Schwellen _GPU_MIN_GIB=33.0, _LOWVRAM_MIN_GIB=14.5), Env MOSS_MEMORY_MODE, MOSS_VRAM_LIMIT_GIB, MOSS_ACTIVATION_RESERVE_GIB, MOSS_TURBO_LORA. v0.3.1 (auto mit 0,5 GiB Reserve) ist nie auf einer GPU gelaufen: Die gemessenen Läufe nutzten v0.3.0, jeder Modus per Env erzwungen.
Zeit bis bereit
Vormittag: ensure() 05:51:47Z, SDK „ready after 63 s“: venv 24 s, Download 28,4 GB in 28,6 s (etwa 1 GB/s), Laden 8,5 s, custom backend ready on port 18000 05:52:52Z. Gemessen auf einem Worker, dessen Ready-Timeout von Hand auf 2400 s angehoben war. Hot Recycle beim erneuten Veröffentlichen: 16 s. Erneutes Deployment am Nachmittag auf einer zweiten A40: ensure 09:59:45Z, bereit nach 60 s, ein Turbo-Plakat-Aufruf 11,198 s GPU, 14,0 s Round Trip, Spitze allokiert 28,72 GiB.
Messungen
GPU-Zeit im Backend gemessen mit cuda.synchronize(), eine Anfrage nach der anderen. Round Trip = HTTP-Client zum lokalen Manager.
| Fall | Modus / Schritte | Größe | GPU s | Round Trip s |
|---|---|---|---|---|
| Plakat (erster Aufruf) | SFT 50 | 1024x1024 | 81.06 | 84.2 |
| Plakat | turbo 8 | 1024x1024 | 9.02 | 9.8 |
| EXPLORE-Layout | SFT 50 | 1024x1024 | 79.88 | 80.6 |
| chinesische Notiz | SFT 50 / turbo 8 | 1024x1024 | 78.76 / 8.90 | 79.82 / 9.79 |
| Infografik | SFT 50 / turbo 8 | 1344x768 | 78.11 / 8.85 | 78.88 / 9.46 |
| Markt in Lissabon | SFT 50 / turbo 8 | 1344x768 | 77.71 / 8.62 | 79.23 / 9.57 |
| Kreidetafel-Speisekarte | SFT 50 / turbo 8 | 1024x1024 | 79.10 / 8.78 | 80.49 / 9.83 |
| Hände des Pianisten | SFT 50 / turbo 8 | 1024x1024 | 78.83 / 8.87 | 79.94 / 9.70 |
| Kaffee-Layout, Kästen oben | SFT 50 / turbo 8 | 1024x1024 | 79.98 / 9.21 | 81.20 / 9.77 |
| Kaffee-Layout, Kästen unten | SFT 50 / turbo 8 | 1024x1024 | 80.08 / 8.94 | 81.18 / 9.52 |
| Plakat | turbo 4 | 1024x1024 | 5.22 | 5.97 |
| Markt in Lissabon | turbo 8 | 1440x1440 | 17.30 | 19.47 |
| Panel-Tester, Kreidetafel / Infografik | turbo 8 (v0.2.0) | 1024x1024 / 1024x576 | 9.68 / 6.03 |
SFT 77,7 bis 81,1 s über 9 Bilder (etwa 1,6 s pro Schritt, zwei Forwards). Turbo mit 8 Schritten 8,6 bis 9,2 s über 9 Bilder bei etwa 1 MP, etwa 8,9x schneller. Plattform-Overhead 0,6 bis 3,1 s, Median etwa 1,1 s (3,1 s beim allerersten Aufruf).
VRAM und Leistung (nvidia-smi alle 1 s, 1.342 Samples): 25,9 GiB allokiert nach dem Laden. Spitze allokiert 28,72 GiB bei 1024x1024, 28,67 GiB bei 1344x768, 31,47 GiB bei 1440x1440. Karte: 30.361 MiB während der 1-MP-Läufe, 33.741 MiB Spitze (1440x1440 Turbo) von 46.068 MiB. Auslastung 100 %, Spitzenleistung der Karte 302,6 W bei einem Limit von 300 W.
Text, auf jedem Bild von Hand gelesen. SFT: Plakat „OPEN WEIGHTS DAY / 10:00 Keynote / 12:30 Lunch / 15:00 Workshops“, Infografik einschließlich „Median time: 9 seconds“, Kreidetafel „Espresso 2.50 / Cappuccino 3.20 / Croissant 2.00 / Daily soup 5.50“, chinesische Notiz (记得买牛奶和鸡蛋!/ 牛奶两盒,鸡蛋一打。/ 顺便带一袋面包。), alles richtig. Turbo: Kreidetafel, chinesische Notiz und beide Layouts richtig. Fehler: Plakattitel „OPEN WEIGHT / WEIGHTS DAY“, Infografik „PNG bock“, teilweise verstümmelter Schildertext auf dem Markt in Lissabon. Turbo mit 4 Schritten: „OPEN WEIGHT DAYDY“, Uhrzeiten wie „1(.C0“.
Vollständige VRAM-Leiter (emuliert)
Nachmittag, zweiter A40-Pod. Die Grenze ist torch.cuda.set_per_process_memory_fraction (Env MOSS_VRAM_LIMIT_GIB). Gleiches Plakat, Seed 42, 1024x1024, genau das backend.py im Prozess aufgerufen, ein frischer Prozess pro Stufe, nvidia-smi alle 500 ms abgetastet. Modi: gpu hält alles resident. component ist enable_model_cpu_offload() (der Modus „Component“ der Autoren). lowvram hält den Text-Encoder unter accelerate.cpu_offload, für jeden Prompt Layer für Layer gestreamt, mit DiT und VAE resident. minimal ist lowvram, wobei nur die DiT-Blöcke resident bleiben, die passen, der Rest unter cpu_offload, plus VAE-Tiling.
| Emuliert | Modus / Grenze | Spitze nvidia-smi (torch reserviert) | SFT 50 s | Turbo 8 s | Max RSS |
|---|---|---|---|---|---|
| 48 GB (echte A40) | gpu, keine | 30,359 MiB (29.32 GiB) | 79.55 | 8.82 | 7.3 GB |
| 24 GB | component, 23.0 GiB | 16,403 MiB (15.70 GiB) | 104.46 | 41.19 | 31.5 GB |
| 16 GB | lowvram, 15.0 GiB | 14,433 MiB (13.77 GiB) | 86.17 | 13.17 | 16.8 GB |
| 12 GB | minimal, 11.0 GiB, 31/42 Blöcke resident | 11,427 MiB (10.83 GiB) | 160.38 | 17.84 | 21.6 GB |
Einheiten: Die Tabelle im Text teilt die MiB-Spitzen von nvidia-smi durch 1.024 (29,6, 14,1 und 11,2 GiB). Darin steckt der CUDA-Kontext, den die torch-Grenze nicht mitzählt. In Dezimaleinheiten sind 14.433 MiB 15,1 GB und 11.427 MiB 12,0 GB. Die 16-GB-Stufe lässt auf einer 16-GiB-Karte etwa 2 GiB Reserve, bevor irgendetwas anderes (ein Desktop, ein anderer Prozess) seinen Anteil nimmt. Auf echter Hardware nicht getestet.
Alle 8 PNGs sind byte-identisch mit den Vormittagsdateien poster-sft.png und poster-turbo.png (mit cmp geprüft): Das Rauschen wird auf der CPU aus dem Seed gezogen, und Offload verschiebt nur Gewichte. Lesart: lowvram kostet +8 % bei 50 Schritten (86,2 gegen 79,6 s) und +49 % bei Turbo, weil der Encoder mit 16,8 GB für jeden Prompt über PCIe streamt (zweimal pro SFT-Bild, einmal pro Turbo-Bild). minimal ist in beiden Modi 2,0x langsamer: 11 von 42 Blöcken streamen bei jedem der 100 Forwards. component passt in 24 GB, aber nicht in 16 GB, und ist langsamer als lowvram. Deshalb wählt auto es nie, und lowvram ist auch auf einer 24-GB-Karte die bessere Wahl.
Unser erster Versuch mit der Leiter scheiterte bei jeder begrenzten Stufe beim Laden mit ValueError: Expected a torch.device with a specified index or an integer, but got:cuda. Das war unser Bug (set_per_process_memory_fraction braucht einen Geräteindex). Wir haben ihn behoben und neu laufen lassen.
Offene Probleme und Status
- Ready-Timeout für Custom Backends (
INFERENCEKEY_CUSTOM_BACKEND_READY_TIMEOUT_SECS) liegt standardmäßig bei 300 s, und der GPU-Bootstrap unserer eigenen Cloud schreibt ein festes Manifest ohne Feld für zusätzliche Env-Variablen. Wir haben=2400per SSH an/opt/inferencekey/worker.env.manifestangehängt und den Worker neu gestartet. Das Setup dauerte 37 s, auf diesem Host hätte der Standardwert also gereicht. Bei 100 MB/s braucht allein der Download etwa 280 s. Offen. - Keine Konfiguration pro Workload erreicht ein Custom Backend, deshalb ist SFT gegen Turbo ein Feld der Anfrage (
mode). Hier so gewollt: Eine geladene Kopie bedient beide, und zwei Kopien würden nicht in 48 GB passen. - Der Bildtester im Panel schickt nur
prompt, size, n, num_inference_steps, guidance_scale, response_format(Standard 20 Schritte / 4,5 Guidance) und keinen Modus. Behoben in Backend v0.2.0 (das auch auf Turbo umschaltet, wenn der Tester ein schnelles Bild verlangt), geprüft nach dem Hot Recycle, der das laufende Modell in 16 s neu gestartet hat (ein Body im Stil des Panels lief als Turbo, 6,81 s GPU bei 1024x576). - Consumer-Pods ohne direktes SSH. Pods mit RTX 5080 16 GB community, RTX 4090 24 GB secure und RTX 3080 Ti 12 GB community wurden über den Manager angelegt und scheiterten jeweils nach 180 s mit
ssh.direct is null, no port 22 mapping. RTX 3060, 3080 Ti, 4070 Ti, 4080, 4080 SUPER, 5080 secure und A4000 hatten keinen Bestand (409). RTX 4060 Ti lieferte 502 unknown GPU type.create_pod_bodyim Manager fordert keine öffentliche IP an. Offen. - Kosmetisch: Die Spalte Access im Panel zeigt „No access“ bei einem funktionierenden Wildcard-Key. Harmlose Log-Warnungen: Der Fast Path des Qwen3.5-Encoders ist nicht installiert (Rückfall auf PyTorch), Attribute der Scheduler-Konfiguration „will be ignored“, eine Warnung
Expected types for transformer, die dieselbe Klasse nennt.
Alternativen, die wir nicht getestet haben
- lodestones/Kromoss: Base, weitertrainiert auf 704.000 Bildern, ein direkter Ersatz für SFT, mit eigenen 8-Schritte-LoRAs. Laut seiner Card funktionieren auch 4 Schritte.
- darask0/MOSS-Image_4-step_adapter_lora: ein 4-Schritte-Adapter, fortgesetzt vom 8-Schritte-Adapter von lodestones.
- akhaliq/MOSS-Image-SFT-4-steps: 4-Schritte-Adapter mit einer 3-Schritte-Stufe, warmgestartet vom 8-Schritte-Adapter von lodestones.
- Neu gepackte Dateien von Comfy-Org/MOSS-Image: int8-DiT (5,4 GB) plus w4a8-Text-Encoder (7,3 GB), etwa 13 GB Dateien. Comfy-Org nennt keine GPU-Größe. Unser bf16-Offload passte schon unter die 12-GB-Grenze, mit identischer Ausgabe, also brauchten wir sie nicht. Wie sie sich auf die Rechtschreibung auswirken, wissen wir nicht.
Alle vier stehen laut ihren Cards unter Apache 2.0. Die Zahlen zu Tempo und Qualität auf diesen Cards sind Angaben ihrer Autoren.
Grenzen
- Ein GPU-Modell (A40), ein Seed pro Prompt, 22 Bilder, unsere eigenen Prompts. Verhalten, keine Benchmark-Qualität. Die Qualitätsurteile sind unsere, aus dem Lesen jedes Bildes.
- Die Ergebnisse für 24, 16 und 12 GB sind Speichergrenzen auf einer A40, ein Prompt, keine echten Karten.
- Eine Anfrage nach der anderen. Nicht ausprobiert:
n> 1, das Base-Modell, ComfyUI, Nebenläufigkeit, quantisierte Dateien, Kromoss, eigene 4- oder 3-Schritte-Adapter, Speichergrenzen unter 11 GiB, Größen über 1 MP in den ausgelagerten Modi. Unser 4-Schritte-Ergebnis ist die 8-Schritte-LoRA mit 4 Schritten.
Credits
OpenMOSS bei MOSI.AI: das Modell, die Releases von Base und SFT, die Pipeline, das Benutzerhandbuch, das Layout-Format und der Bericht. Qwen-Team: Qwen3.5-9B. Black Forest Labs: das kleine FLUX.2-VAE. Das ComfyUI-Team: native Unterstützung, PR #17095. Comfy-Org: die quantisierten Neupackungen. lodestones: die 8-Schritte-LoRA, die wir betrieben haben, und Kromoss. darask0 und akhaliq: die Adapter mit 4 und 3 Schritten. Die Anwendung der LoRA folgt dem Space hugging-apps/moss-image-8-step-dmd. Bei AI Search haben wir das Modell entdeckt.
Quellen: Card von MOSS-Image-SFT, Card von MOSS-Image-Base, GitHub-Repo, Benutzerhandbuch, technischer Bericht, lodestones 8-step DMD, Comfy-Org-Neupackung, Kromoss, SDK-Beispiel.