Flint, ein von Grund auf trainiertes Coding-Modell, fährt seine Agent-Schleife auf einer RTX 4090
Flint von Recursive auf eigenen GPUs: 210 Tokens/s auf einer RTX 5090 mit 64K Kontext, 167 auf einer RTX 4090 mit 16K, ein Bug in 7 von 7 Läufen behoben.
Das Server-Kit von Recursive für Flint in voller Präzision verlangt eine Rechenzentrumskarte mit mindestens 141 GB Speicher. Wir haben die offizielle komprimierte Datei von Flint samt Coding-Agent-Schleife auf einer RTX 4090 mit 24 GB laufen lassen, einer Karte, die fürs Gaming gebaut ist. Flint ist das neue Coding-Agent-Modell von Recursive, und diese Datei wiegt 22,9 GB. Wir haben sie auf eine RTX 5090 mit 32 GB und auf die 4090 geladen, beide in unserer eigenen Cloud. Auf der 5090 hat Flint einen eingeschleusten Bug in einem kleinen Code-Projekt in fünf Schritten und etwa sechs Sekunden behoben. Die 4090 hat denselben Job in etwa derselben Zeit erledigt und dabei etwa 20 % langsamer geschrieben, aber nur mit einem kürzeren Kontext (dem, was das Modell im Kopf behält). Mit doppelt so viel Kontext ging ihr der Platz aus, bevor es überhaupt losging. Recursive hat Flint von Grund auf trainiert, und die Lizenz ist Apache 2.0. Wenn du Coding-Agents auf deinen eigenen GPUs betreibst, ist das ein Modell, das du auf einer stundenweise gemieteten Karte laufen lassen und verändern kannst.
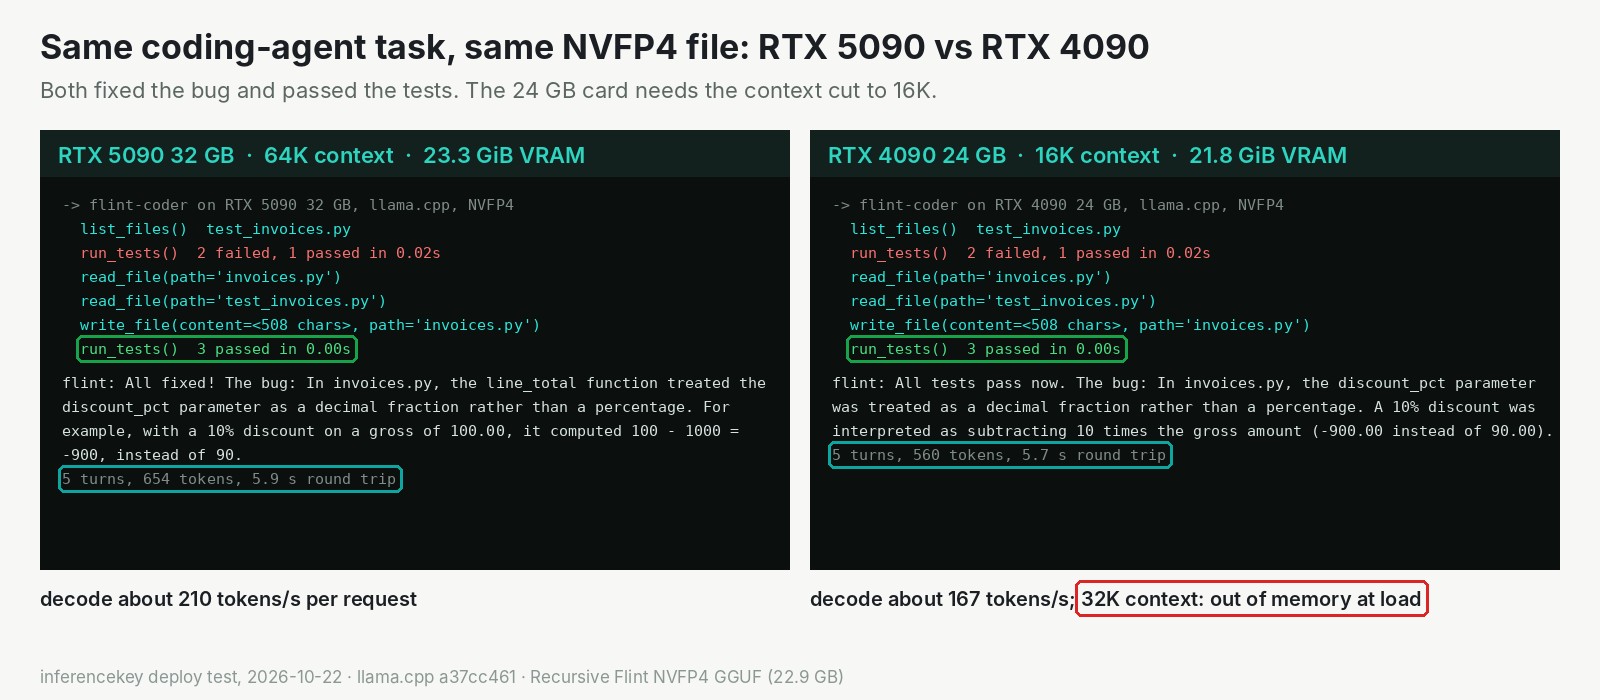
Gleiche Aufgabe, gleiche Datei, gleiche Antwort auf beiden Karten. Der rote Kasten markiert, wo die kleinere Karte aufhört: 32K Kontext passen nicht hinein.
| RTX 5090, 32 GB | RTX 4090, 24 GB | |
|---|---|---|
| Text, den es im Kopf behalten kann (Kontext) | 64K Tokens | 16K Tokens (32K passten nicht) |
| Belegter Kartenspeicher | etwa 23,3 von 32 GiB | etwa 21,8 von 24 GiB |
| Schreibgeschwindigkeit | etwa 210 Tokens/s | etwa 167 Tokens/s |
| Eingeschleuster Bug behoben | ja, 5 Turns, 5,9 s | ja, 5 Turns, 5,7 s |
Von Grund auf gebaut, mit 6 von 256 Spezialisten wach für jedes Wort
Flint ist ein großes Modell, das zum Preis eines kleinen arbeitet. Es hat 39,8 Milliarden Parameter (die Zahlen, aus denen ein Modell besteht), aber jedes Token (Wortstück), das es schreibt, nutzt nur etwa 2,5 Milliarden davon. Der Trick heißt Mixture of Experts. Stell dir eine Session-Band mit 256 Musikern auf der Liste vor. Für jedes Wortstück ruft der Bandleader die 6, die am besten dazu passen, plus einen Hausdrummer, der jeden Song spielt. Die anderen 250 sitzen im Backstage, bis sie dran sind. Im Gebäude sein müssen trotzdem alle, deshalb muss das ganze Modell in den Speicher passen, obwohl der größte Teil Pause macht.
Anders als die Coding-Modelle, die wir zuletzt getestet haben, baut Flint nicht auf dem Modell einer anderen Firma auf. Recursive hat Flint selbst trainiert, vom allerersten Schritt an, mit Wissen bis Juni 2026. Es hat seine eigene Architektur, also brauchte llama.cpp, die Engine, auf der wir es betrieben haben, neuen Code, um es zu laden.
Recursive meldet 74,2 % auf SWE-bench Verified. Dieser Test gibt einem Agent echte Bug-Reports aus Open-Source-Projekten und zählt einen Fix nur, wenn die projekteigenen Tests durchlaufen. Dazu meldet Recursive 54,9 % in einem zweiten Test mit Kommandozeilen-Aufgaben. Das sind die Zahlen von Recursive, und wir haben sie nicht nachgestellt. Sie gelten nicht für die komprimierte Datei, die wir betrieben haben, und wir haben nicht gemessen, wie viel Qualität die Kompression kostet. Unsere Frage war enger. Was braucht Flint, um auf einer Karte zu laufen, die ein kleines Team mieten kann?
Das Server-Kit von Recursive braucht eine Rechenzentrumskarte mit 141 GB oder mehr. Die komprimierte Datei mit 22,9 GB ist der günstigere Weg. Sie läuft auf llama.cpp. Recursive hat sie auf mehreren NVIDIA-Maschinen getestet, Rechenzentrum wie Desktop, und empfiehlt mindestens 48 GB Speicher. Diese Zahl deckt den vollen Kontext von Flint mit 262.144 Tokens ab.
Der Test: zwei Gaming-Karten, eine Anfrage nach der anderen
Wir wollten die kleinere Antwort. Wir haben die offizielle komprimierte Datei auf einer RTX 5090 mit 32 GB und einer RTX 4090 mit 24 GB in unserer Cloud laufen lassen und den Kontext gekürzt, bis das Modell hineinpasste. Auf der 5090 hieß das 64K Tokens, ein Viertel der vollen Länge. Auf der 4090 hieß es 16K.
Der Support in llama.cpp kam gerade rechtzeitig. Die Änderung, die ihm die Architektur von Flint beibringt (PR #30928), hat alexey-rsi geschrieben, gemergt wurde sie am 21. Oktober. Unseren Test haben wir am nächsten Morgen gestartet.
Die Hauptaufgabe ist die, die ein Coding-Agent den ganzen Tag macht. Wir haben Flint ein winziges Projekt gegeben, mit einem Rechnungsmodul, dessen Rabattcode einen Prozentwert als Bruch behandelte, und zwei fehlschlagenden Tests. Flint hatte vier Tools: Dateien auflisten, eine Datei lesen, eine Datei schreiben und die Tests ausführen. Es musste den Bug finden, ihn beheben und den Fix beweisen. Diesen Lauf haben wir siebenmal auf drei Maschinen wiederholt. Außerdem haben wir ein kurzes Codewort in langen Prompts mit 8,8K und 17,5K Tokens versteckt, um zu prüfen, ob das Modell noch Dinge findet, wenn es viel liest.
Unsere sieben Läufe sind ein eingeschleuster Bug in einem Spielzeugprojekt, kein Benchmark. Wir lagen unter dem, was Recursive empfiehlt: Mit 64K oder 16K Kontext ist Flint nicht für lange Agent-Sessions eingerichtet. Jeder Test schickte eine Anfrage nach der anderen. Eine echte Karte mit 16 GB oder 12 GB haben wir nicht ausprobiert, den vollen Kontext von 262K auch nicht. Die kleineren Karten weiter unten sind auf einer langsamen Maschine emuliert, ihre Geschwindigkeiten sind also unsicher.
Ergebnisse: fünf Turns und drei grüne Tests in etwa sechs Sekunden
Flint hat den Bug in allen sieben Läufen behoben, und zwar jedes Mal auf dieselbe Weise. Es hat die Dateien aufgelistet und die Tests ausgeführt, die fehlschlugen. Es hat das Modul und die Testdatei gelesen, den Fix geschrieben, die Tests erneut ausgeführt und drei bestehen sehen. Dann hat es den Fehler mit Prozent gegen Bruch erklärt. Das sind fünf Turns, und es hat nie die Tests verändert, damit sie durchlaufen. Auf der 5090 dauerte die ganze Schleife 5,9 Sekunden.
Für eine einzelne Person fühlte sich die 5090 sofort an. Flint schrieb etwa 210 Tokens pro Sekunde, grob 150 Wörter pro Sekunde. Eine Coding-Antwort mit 374 Tokens kam in drei Sekunden zurück. Lesen geht bei diesen Modellen schneller als Schreiben. Flint hat einen Prompt mit 17.557 Tokens, etwa so groß wie ein langes Design-Dokument, in weniger als zweieinhalb Sekunden aufgenommen. Mit 64K Kontext belegte die Karte etwa 23,3 GiB ihrer 32.
Auch die Details hielten. Jeder Tool-Aufruf, den es schickte, war gültig, und es las beide Dateien in einem einzigen Turn. Das versteckte Codewort fand es in allen drei langen Prompts. Eine Nebenantwort war falsch: Gefragt nach dem Ergebnis einer kleinen Hilfsfunktion, sagte der Lauf auf der 5090 171, richtig ist 113. Die anderen beiden Läufe lagen richtig.
Ein Ergebnis gehört hierher, damit die 210 nicht wie ein Glückstreffer wirken. Unsere erste RTX 5090 lief mit derselben Datei und demselben llama.cpp-Build mit 27 Tokens pro Sekunde, etwa 8-mal langsamer. Unsere zweite 5090, auf einer anderen Maschine, lieferte die 210 mit derselben Datei, die Langsamkeit kam also von dieser Maschine, nicht vom Modell oder seinem Format. Die sichtbaren Unterschiede waren ein Power-Limit von 400 W und ein älterer Treiber. Unsere Cloud meldete diese Karte als gesund, und nichts prüft die GPU-Geschwindigkeit, wenn eine Maschine startet. Status: offen, Ursache nicht eingegrenzt.
Welche GPU: eine RTX 4090 mit 24 GB funktioniert mit 16K, 32K passen nicht
Die kleinste Karte, die funktioniert hat, ist die RTX 4090 mit 24 GB. Mit 16K Kontext und dem ganzen Modell auf der Karte füllte sie ihren nutzbaren Speicher bis auf etwa 0,7 GiB. Sie schrieb etwa 167 Tokens pro Sekunde, etwa 20 % langsamer als die 5090. Dieselbe Agent-Schleife lief in 5,7 und 6,3 Sekunden, jedes Mal mit drei bestandenen Tests. Bei kurzen Agent-Aufgaben würdest du den Unterschied nicht merken.
Den Kontext auf 32K zu verdoppeln hat sie gebrochen. Das Modell lud, konnte dann aber das letzte bisschen Arbeitsspeicher nicht reservieren, unter 0,1 GiB, und hielt an, bevor es eine einzige Anfrage bediente. Allein die Datei belegt 21,3 GiB, und die Karte stellt nur etwa 22,5 GiB bereit. 16K reichten also für eine Aufgabe wie unsere, nicht für eine lange Session in einer großen Codebasis.
Unter 24 GB haben wir kleinere Karten nur emuliert, indem wir den Speicher auf der langsamen 5090 begrenzt und einen Teil der Spezialisten in den Hauptspeicher der Maschine verschoben haben. Mit einer Grenze nahe 16 GB antwortete Flint, aber mit 4,6 Tokens pro Sekunde, und eine Anfrage dauerte 111 Sekunden. Mit einer Grenze nahe 15 GB schrieb es etwa 6 Tokens pro Sekunde, und unser Endpoint gab zweimal nach seinem Zwei-Minuten-Limit auf. Beides zählen wir für interaktive Nutzung als Fehlschlag.
Auf InferenceKey: warm in 13,5 Sekunden bereit, nach einem Build von 7 Minuten
Die Karte gehört dir stundenweise, und du entscheidest, was darauf läuft. Auf InferenceKey ist der Worker das kleine Programm auf der GPU-Maschine, das das Modell holt und die Engine startet. Für Flint hat sein eingebauter llama.cpp-Modus die offizielle Datei ohne eigenen Code ausgeliefert. Derselbe Endpoint beantwortete die Tool-Aufrufe des Agents im OpenAI-Format, das Coding-Tools schon sprechen.
Der erste Start auf einer frischen Maschine dauerte etwa neun Minuten. Sieben davon gingen dafür drauf, llama.cpp für die Karte zu kompilieren. Der Download der 22,9-GB-Datei dauerte etwa zwei weitere, das Laden etwa sechs Sekunden. Danach war ein Neustart mit allem an Ort und Stelle in 13,5 Sekunden bereit.
Zwei Probleme sind die, auf die du stoßen wirst.
Das erste ist die llama.cpp-Version. Die Standardversion des Workers, b9748, ist älter als Flint. Wir haben den Merge-Commit von Hand gebaut, weil wir dachten, keine veröffentlichte Version enthalte ihn. Das war unser Fehler: Release b11803 ist derselbe Code und wurde veröffentlicht, bevor unser Test begann. Stell den Worker auf b11803 oder neuer. Status: offen auf unserer Seite. Unser Worker-Standard (b9748) und die README des Beispiels müssen noch aktualisiert werden. Den Worker mit b11803 haben wir nicht laufen lassen.
Das zweite ist, wo das Denken des Modells landet. Flint überlegt, bevor es antwortet, und mit diesem Build kommt dieses Reasoning im Antworttext an statt in einem eigenen Feld. Coding-Tools, die so eingerichtet sind, wie Recursive es vorschlägt, suchen es an einer separaten Stelle und werden es nicht finden. Das Reasoning zählt außerdem gegen dein Token-Budget. Status: offen.
Solltest du es nutzen? Ja, für kurze Agent-Aufgaben auf einer Karte mit 24 oder 32 GB
Wenn du einen offenen Coding-Agent auf Hardware willst, die dir gehört oder die du mietest, ist Flint heute einen Versuch wert. Eine RTX 5090 mit 32 GB hat Platz für eine mittlere Aufgabe, eine RTX 4090 mit 24 GB für kurze.
Wenn deine Agent-Sessions lang laufen, über große Codebasen und Hunderte Tool-Aufrufe, plane mehr Speicher ein.
Danke an Recursive für Flint und an alexey-rsi für den Support in llama.cpp. Entdeckt haben wir es in einem Thread auf r/LocalLLaMA.
Führ python main.py aus dem Flint-SDK-Beispiel aus, um die Bugfix-Schleife auf deinem eigenen NVIDIA-Worker zu wiederholen. Es braucht das aus dem Repo gebaute SDK, 32 GB oder mehr für den Standard von 64K und llama.cpp b11803 oder neuer. Rechne mit etwa sieben Minuten für den ersten Build und einem Download von 22,9 GB.
Für Ingenieure
Modell und Dateien
- RecursiveSI/flint:
FlintForCausalLM, 39,8B gesamt, etwa 2,5B aktiv pro Token einschließlich Output-Head (etwa 2,2B nur für den Körper). 49 Layer: 2 dichte (mlp_only_layers [0,1]) und 47 MoE mit 256 gerouteten Experten, 6 pro Token, plus ein Shared Expert (shared_expert_intermediate_size 1024). 35 Sliding-Window-Layer (Fenster 513) und 14 Full-Attention-Layer. 32 Query-Heads, 4 KV-Heads, head_dim 128, hidden 2048, Vokabular 150.144,max_position_embeddings262.144. Sigmoid-Router, QK-RMSNorm pro Head, gelernte Attention Sinks pro Head (softmax_type "learnable"), RoPE nur auf den Sliding-Window-Layern. Von Grund auf trainiert über Pretraining, Mid-Training, SFT und RL. Wissensstand Juni 2026. Token-Zahlen nicht angegeben. Modeling-Code für Transformers noch nicht enthalten. BF16-Checkpoint etwa 80 GB. - Evals des Herstellers (selbst gemeldet, nicht von uns geprüft): Terminal-Bench 2.1 54,9 % (Terminus 2), SWE-bench Verified 74,2 % und SWE-bench Pro v2 89,7 % (mini-swe-agent). Durchschnittliches pass@1 über mindestens fünf Versuche, Temperatur 1.0, top-p 0.95, top-k 20. Aus dem Web geholte Terminal-Bench-Lösungen zählten als Fehlschlag. Die Werte der Konkurrenz stehen nur in einem Diagrammbild, deshalb haben wir sie nicht übernommen.
- flint-nvfp4-gguf:
flint-nvfp4.gguf, 22.863.084.160 Bytes, Gewichte, Tokenizer und Chat-Template in einer Datei, für llama.cpp auf CUDA. Die Autoren nennen B300, RTX PRO 6000 Blackwell, RTX Spark und DGX Spark als getestet und empfehlen mindestens 48 GB GPU-Speicher (oder Unified Memory auf Spark). Ihr Beispielbefehl nutzt-c 262144; wir lagen unter dieser Empfehlung. llama-bench meldet sie als 21,29 GiB, 39,79 B Parameter. - flint-int4-gguf:
flint-int4-q4_1.gguf, 25.992.966.976 Bytes, Q4_1, gedacht für Apple Silicon mit Metal und 48 GB Unified Memory. Wir haben sie nur in llama-bench laufen lassen, auf dem langsamen Host. - flint-int4: MLX INT4 (Group-64 affin, INT8-Embeddings), etwa 22,6 GB, für mlx-lm.
- SGLang-Kit (
sglang/im Haupt-Repo, SGLang 0.5.16): eine GPU mit mindestens 141 GB pro Replica (B300, B200 oder H200), "80 GB GPUs are not supported", Treiber 580 oder neuer. Die Serve-Skripte nutzen--context-length 262144 --tool-call-parser flint --reasoning-parser flint. Quantisierte Gewichte und KV, TP/EP und Speculative Decoding von den Autoren nicht validiert. - recursive-oss/rec: Engine unter Apache-2.0 für Flint auf Apple Silicon (M4 Pro, M5 Pro, M5 Max, 48 GB oder mehr), OpenAI-kompatible API, beansprucht das 1,4- bis 2,6-Fache des llama.cpp-Decodes auf M4 Pro (ihre Zahl).
Support in llama.cpp
- PR #30928 "models: Add Flint model (FlintForCausalLM)" von alexey-rsi, gemergt 2026-10-21T21:26:22Z, Merge-Commit
a37cc46104eb50900d5ab4a9ba02a0abdac039db, +319/-7 in 18 Dateien, freigegeben von CISC und ggerganov. Er nutzt die adaptive Skalierung der Experten-Aktivierung aus #30861 als Workaround, und der PR meldet eine Verlangsamung um 10 bis 30 % durch diese Auto-Skalierung, die in Folge-PRs angegangen werden soll (nicht von uns gemessen). Der PR legt offen, dass Codex bei der Implementierung wesentlich geholfen hat. - PR #30929 "jinja: support hexadecimal string escapes" (alexey-rsi, gemergt 2026-10-21T16:04:37Z, freigegeben von CISC und danbev) wird vom Chat-Template gebraucht.
- Release
b11803(veröffentlicht 2026-10-21T22:30:59Z) ist identisch mita37cc461. b11804 und später enthalten ihn ebenfalls.v0.7.0liegt 134 Commits zurück.
Unser Setup
- Karten in unserer Cloud: RTX 5090 32 GB (Treiber 595.91.07, 575 W), RTX 4090 24 GB (23.028 MiB nutzbar, Treiber 595.91.07, 450 W) und eine erste RTX 5090 (Treiber 580.178.04, Power-Limit 400 W), die sich als langsamer Host herausstellte.
- Ein lokaler InferenceKey-Manager aus
mainbei5c08ab03, von den Workern über Dev-Tunnel erreicht. Produktion nie angefasst. - Worker-Env:
INFERENCEKEY_LLAMACPP_TAG=flint-a37cc461,INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000,CMAKE_BUILD_PARALLEL_LEVEL,CUDACXX. - llama.cpp von Hand bei
a37cc461gebaut, im Installationspfad des Workers/opt/inferencekey/llamacpp-cuda/flint-a37cc461-cuda<arch>/. Der Worker fand dortbuild/bin/llama-serverund hat es wiederverwendet. Sein Standard-Tag istb9748, und er klont mitgit clone --branch <tag>, was einen Tag- oder Branch-Namen akzeptiert, keinen Commit.
Deployment Schritt für Schritt
-
Klon das SDK und öffne examples/flint-coding-agent-llamacpp-private-nvidia (
main.py,README.md,.env.example,requirements.txt, Commit1654d272). -
Kopier
.env.examplenach.env, füll sie aus und exportier die Variablen in deine Shell (main.pyliest sie aus der Umgebung und lädt.envnicht selbst):INFERENCEKEY_SDK_TOKEN=... INFERENCEKEY_API_KEY=... INFERENCEKEY_PROJECT=... IK_WORKER_ID=... # private NVIDIA worker, 32 GB or more for the 64K default # optional INFERENCEKEY_BASE_URL=... IK_KEEP_ALIVE=1 # keep the deployment after the run -
Stell auf dem Worker eine llama.cpp-Version ein, die Flint enthält, und gib dem ersten Build Zeit:
INFERENCEKEY_LLAMACPP_TAG=b11803          # or newer; we used a hand build at a37cc461
INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000
CMAKE_BUILD_PARALLEL_LEVEL=<cores>
# Blackwell needs the CUDA toolkit with nvcc 12.8 or newer
Die README des Beispiels verlangt einen Tag, der
a37cc461enthält, odermaster. Ihr Hinweis, dass zum Zeitpunkt unseres Tests kein Release-Tag den PR enthielt, ist veraltet:b11803entspricht dem Merge-Commit. Den Worker mitb11803selbst haben wir nicht laufen lassen. -
Installieren und ausführen. Das SDK ist noch nicht auf PyPI (die Zeile
inferencekeyinrequirements.txtist auskommentiert), also bau es zuerst lokal, wie es die README des Beispiels und../CONTRIBUTING.mdbeschreiben:python -m venv .venv && . .venv/bin/activate pip install maturin ( cd ../../bindings/python && maturin develop --release ) pip install -r requirements.txt set -a; . ./.env; set +a python main.pymain.pyruftensure()mitBackend.LLAMACPPauf, wartet bis zu 3.600 s auf ready, fragt nach einer Funktionmerge_intervals, führt die Coding-Agent-Schleife mitlist_files,read_file,write_fileundrun_testsaus, beschränkt auf ein temporäres Verzeichnis, schreibtoutputs/answers.jsonund löscht das Deployment, außer beiIK_KEEP_ALIVE=1. -
Der Befehl, den es deployt:
llama-server -hf RecursiveSI/flint-nvfp4-gguf --hf-file flint-nvfp4.gguf --alias flint \
  -ngl all -c 65536 -np 1 -fa on -ctk f16 -ctv f16 --jinja \
  --temp 1 --top-p 0.95 --top-k 20 --min-p 0
Der Befehl ist in
main.pyfest eingetragen (Zeile 58), und keine Env-Variable und kein Flag ändern ihn. Für einen Worker mit 24 GB änderst du dort-c 65536in-c 16384. Lass--swa-fullweg, wie es die Model Card sagt.
Zeit bis bereit
| Schritt | RTX 5090 | RTX 4090 |
|---|---|---|
| CUDA-Build von llama.cpp, frische Maschine | 7 min 13 s (-j 46) | 6 min 26 s |
ensure() bis bereit, frisch | 129,5 s (Download etwa 114 s mit etwa 200 MB/s, Laden etwa 6 s) | 126,9 s (Download etwa 113 s, Laden 5,3 s) |
| Warmer Neustart (Binary gebaut, Gewichte im Cache) | 13,5 s (Laden 4,6 s); Stufen der Leiter auf der langsamen 5090 13,8 bis 14,8 s | nicht gemessen |
Geschwindigkeit
| Host und Konfiguration | Decode, pro Anfrage | llama-bench | Prefill |
|---|---|---|---|
RTX 5090, 64K, nativer 120a-Build | 194 bis 216 tok/s (lange Ausgaben etwa 210) | tg128 239,8, pp512 6.217 | 7.352 tok/s bei 17.557 Tokens |
RTX 5090, PTX-Build (89-virtual) | tg128 216,1, pp512 6.495 | ||
| RTX 4090, 16K | 154 bis 170 tok/s (etwa 167) | tg128 181,2, pp512 5.658 | 6.230 tok/s bei 8.807 Tokens |
| Langsame RTX 5090, 64K, 32K, 16K | 26,6 bis 28,4 tok/s | tg128 28,8 (NVFP4), 29,3 (Q4_1), pp512 2.593 | 2.726 tok/s bei 17.557 Tokens |
Das CMake von llama.cpp wählt auf Blackwell von selbst CMAKE_CUDA_ARCHITECTURES=120a, und der native Build war etwa 11 % schneller als PTX-JIT. NVFP4 lief auch auf Ada (sm_89, die 4090). Auf der 5090 dauerte eine Coding-Antwort mit 374 Tokens 3,0 s.
KV-Schätzung: 14 Full-Attention-Layer x 4 KV-Heads x 128 x 2 (K und V) x 2 Bytes = 28.672 Bytes pro Token, etwa 0,9 GiB bei 32K und 1,75 GiB bei 64K.
Vollständige VRAM-Leiter
| Ziel | Konfiguration | Spitzen-VRAM (llama-server) | Geschwindigkeit | Ausgabe OK | Echte Karte |
|---|---|---|---|---|---|
| RTX 5090 32 GB | NVFP4, -c 65536, F16 KV, -ngl all | 23.872 MiB | etwa 210 tok/s, Agent 5,9 s | ja | ja |
| RTX 5090 32 GB (langsamer Host) | NVFP4, -c 32768 | 22.922 MiB | 27,3 tok/s | ja | ja |
| RTX 5090 32 GB (langsamer Host) | NVFP4, -c 16384 | 22.458 MiB | 27,5 tok/s | ja | ja |
| RTX 4090 24 GB | NVFP4, -c 16384, F16 KV, -ngl all | 22.316 MiB von 23.028 | etwa 167 tok/s, Agent 5,7 und 6,3 s | ja | ja |
| RTX 4090 24 GB | NVFP4, -c 32768 | OOM beim Laden | cudaMalloc failed: out of memory | nein | ja |
| Grenze etwa 16 GB (langsame 5090) | NVFP4, -c 32768, --n-cpu-moe 18 | 16.116 MiB | 4,57 tok/s, Anfrage 111 s | ja, zu langsam | emuliert |
| Grenze etwa 15 GB (langsame 5090) | NVFP4, -c 32768, --n-cpu-moe 22 -t 12 | 14.388 MiB | etwa 5,9 tok/s, 503 nach 120 s, zweimal | nein | emuliert |
Der Fehlschlag der 4090 bei 32K:
ggml_backend_cuda_buffer_type_alloc_buffer: allocating 87.50 MiB on device 0: cudaMalloc failed: out of memory
failed to allocate buffer for kv cache
Das SDK meldete daraufhin failed to become ready: bootstrap step failed.
Nicht ausprobiert: Karten mit 12 GB, RTX 3090 (kein Bestand, als wir es versucht haben), die 5090 über 64K, irgendeine Karte mit 48 GB, der volle Kontext von 262K, Nebenläufigkeit über -np 1.
Qualität (unsere Prompts, kein Benchmark)
- Coding-Agent-Schleife: 7 von 7 Läufen auf 3 Maschinen haben den Bug behoben, immer 5 Turns, 559 bis 654 Tokens, die Tests nie angefasst.
- Tool-Call-JSON jedes Mal gültig, mit parallelen Aufrufen. In einem separaten Tools-Bench gab unser vorgefertigtes
read_filefür jeden Pfad denselben Text zurück (unser Bug). Das Modell hat es bemerkt ("suspiciously identical") und 6 Turns weitergesucht, statt zu antworten. merge_intervals: korrekt, mit drei Asserts, in 5 Läufen.- Ein eingeschleuster Off-by-one in einer Funktion
chunks: 3 von 3 gefunden. - Versteckter String
FLINT-4471-NVFP4: 3 von 3 gefunden bei 8,8K und 17,5K Tokens. Rechen-Nebenfrage 2 von 3 richtig (helper_175(2)mit 171 beantwortet, korrekt 113).
Demo-Video
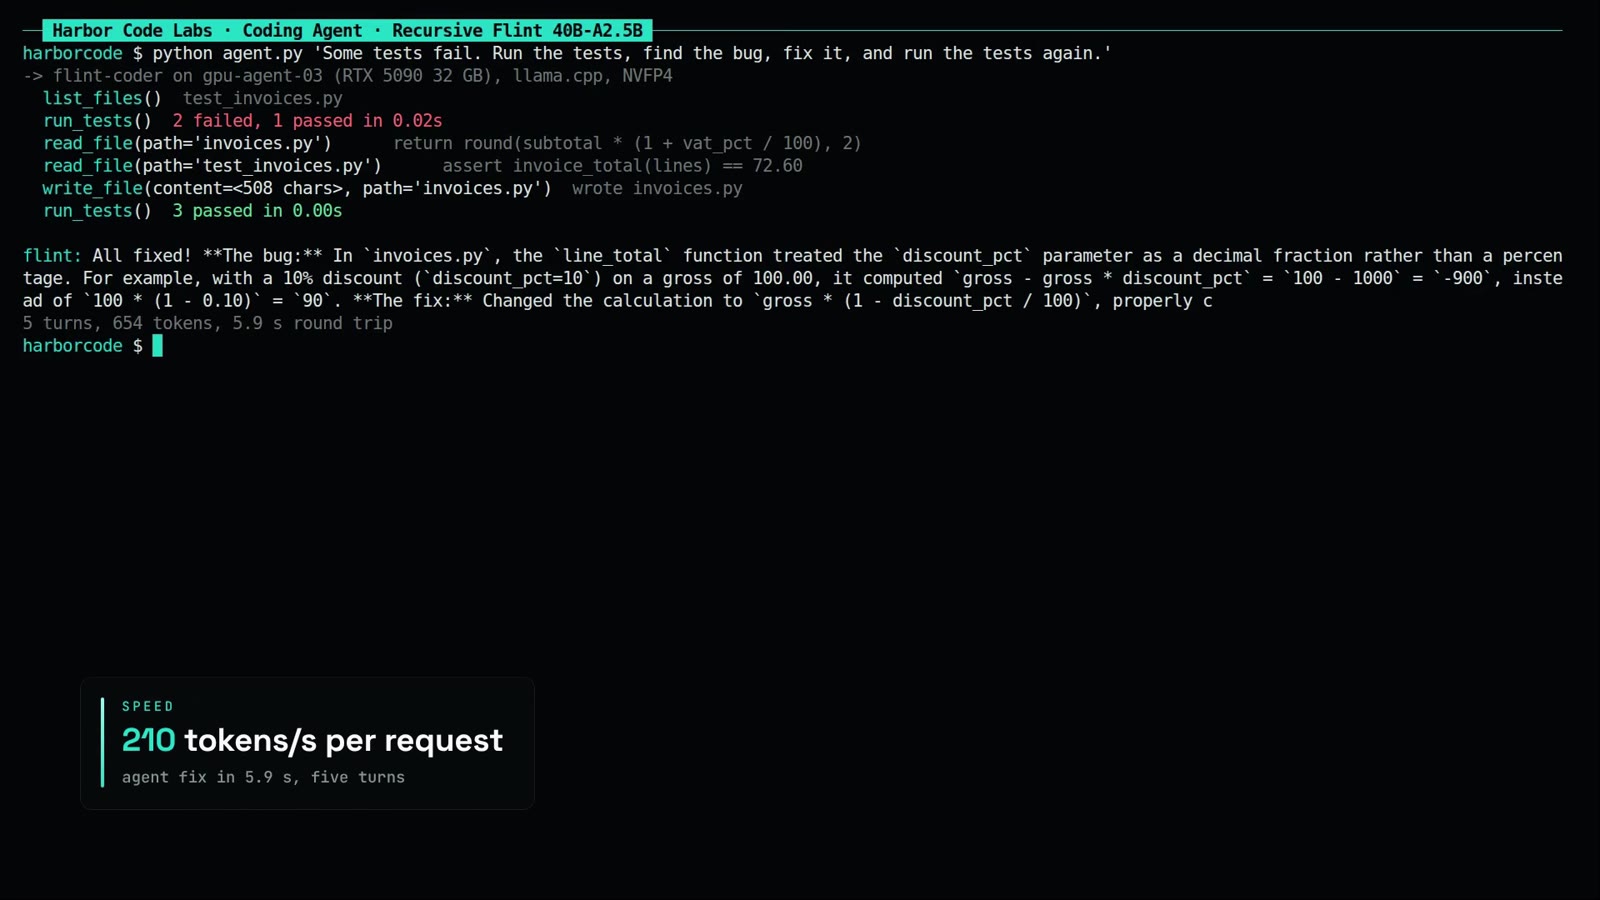
72,9 s, 1080p, mit Sprecher, aufgenommen auf der gesunden 5090: der Workload im Panel, das fehlerhafte Modul, die Agent-Schleife (5 Turns, 654 Tokens, 5,9 s, 3 bestanden). Eine frühere Aufnahme auf der langsamen 5090 wurde ersetzt.
Offene Probleme und Status
- llama.cpp-Version. Flint braucht
b11803oder neuer, und der Worker nimmt einen Tag, keinen Commit. Status: upstream gelöst, offen auf unserer Seite (Worker-Standardb9748und README noch nicht aktualisiert), mit dem Tag von uns nicht getestet. Unsere SDK-README verlangt einen Tag, dera37cc461enthält, odermaster; ihr Hinweis, dass es keinen Release-Tag gab, ist veraltet, undb11803dort zu nennen steht noch aus. - Langsamer Host. Eine RTX 5090 decodierte 27 bis 29 tok/s mit derselben Datei und demselben Commit, auch mit Q4_1.
nvidia-smi dmonzeigte SM 100 %, Speicher 0 bis 6 %, 399 W bei ihrem Limit von 400 W. Eine zweite 5090 lief in llama-bench 8,3-mal schneller (tg128 239,8 gegen 28,8). Ursache nicht eingegrenzt (das Power-Limit und der Treiber 580.178 sind die sichtbaren Unterschiede). Die Plattform meldete sie als gesund, und nichts prüft die GPU-Leistung beim Bootstrap. Status: offen. - Nutzbarer Speicher bei 24 GB. Die 4090 stellt 23.028 MiB bereit. Bei 16K belegte llama-server 22.316 MiB; von 16K auf 32K kamen auf der langsamen 5090 464 MiB hinzu (22.458 auf 22.922), und der Treiber hält Speicher außerhalb des Prozesses (eine 5090 im Leerlauf zeigte 1.039 MiB belegt), also passt NVFP4 mit 32K Kontext nicht. Status: eine Grenze, nimm 16K.
- Sync-Timeout. Der Sync-Timeout des Endpoints von 120 s gibt bei langsamen Konfigurationen wie Experten-Offload auf die CPU 503 zurück. Status: offen.
- Build von Hand. Das Target
llama-serverscheitert anllama-ui-assets, wenn nicht alle 8 UI-Stub-Dateien existieren (der Worker legt sie an). Status: betrifft nur Builds von Hand. - Reasoning in
content. Mit diesem Build und Template über unseren Endpoint kommt der Reasoning-Text incontentan, undreasoning_contentfehlt. Reasoning-Tokens zählen inusage.completion_tokensund gegenmax_tokens(das Beispiel nutzt 16.384). Die Client-Konfigurationen von Recursive nutzen ein Generierungsbudget von 65.536 Tokens und bitten darum,reasoning_contentbeim erneuten Abspielen des Verlaufs zu behalten. Status: offen.
Grenzen
Eine Anfrage nach der anderen, sieben Agent-Läufe, unsere eigenen Prompts. Sampling mit Temperatur 1.0, top-p 0.95, top-k 20, wie Recursive es empfiehlt. Benchmarks sind vom Hersteller gemeldet. Die emulierten Stufen liefen auf dem langsamen Host. Keine echte Karte mit 16 GB oder 12 GB wurde getestet.
Credits
Recursive (Modell, NVFP4- und INT4-Dateien, SGLang-Kit, rec). alexey-rsi (llama.cpp-PRs #30928 und #30929). CISC und ggerganov (haben #30928 freigegeben). CISC und danbev (haben #30929 freigegeben). ggerganov (#30861, die MoE-Skalierung pro Experte, die der Flint-Support nutzt). Unser Teil: das Deployment auf InferenceKey, das SDK-Beispiel, die Messungen und das Video.
Quellen
- Model Card von RecursiveSI/flint samt
config.jsonundsglang/README.md - RecursiveSI/flint-nvfp4-gguf
- RecursiveSI/flint-int4-gguf
- RecursiveSI/flint-int4
- llama.cpp PR #30928
- llama.cpp PR #30929
- recursive-oss/rec
- InferenceKey-SDK-Beispiel
- Wo wir es entdeckt haben: Thread auf r/LocalLLaMA