Flint, un modelo de código entrenado desde cero, mueve su bucle de agente en una RTX 4090
Flint de Recursive en nuestras GPUs: 210 tokens/s en una RTX 5090 con 64K de contexto, 167 en una RTX 4090 con 16K, y el bug arreglado en 7 de 7 pruebas.
El kit de servidor de Recursive para Flint a precisión completa pide una tarjeta de centro de datos con al menos 141 GB de memoria. Nosotros hemos hecho funcionar el fichero comprimido oficial de Flint, con su bucle de agente de código, en una RTX 4090 de 24 GB, una tarjeta pensada para jugar. Flint es el nuevo modelo para agentes de código de Recursive, y ese fichero pesa 22,9 GB. Lo cargamos en una RTX 5090 de 32 GB y en la 4090, las dos en nuestro propio cloud. En la 5090, Flint arregló un bug que habíamos metido a propósito en un proyecto de código pequeño, en cinco pasos y unos seis segundos. La 4090 hizo el mismo trabajo en más o menos el mismo tiempo, escribiendo un 20 % más despacio, pero solo con un contexto más corto (lo que tiene presente a la vez). Con el doble de contexto se quedó sin sitio antes de empezar. Recursive entrenó Flint desde cero, y la licencia es Apache 2.0. Si sirves agentes de código en tus propias GPUs, es un modelo que puedes ejecutar y modificar en una tarjeta que alquilas por horas.
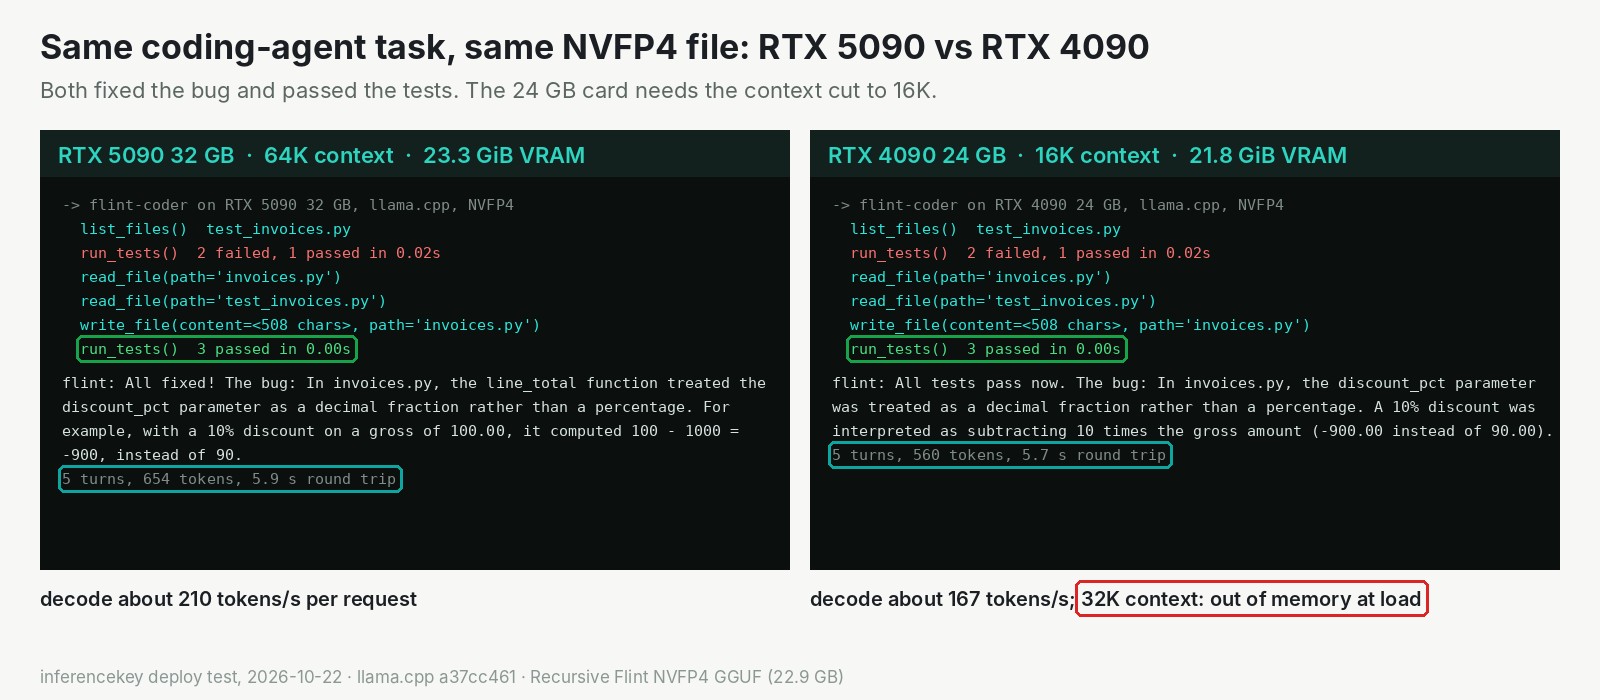
Misma tarea, mismo fichero y misma respuesta en las dos tarjetas. El recuadro rojo marca dónde se para la tarjeta pequeña: 32K de contexto no entran.
| RTX 5090, 32 GB | RTX 4090, 24 GB | |
|---|---|---|
| Texto que puede tener presente (contexto) | 64K tokens | 16K tokens (32K no entraron) |
| Memoria de la tarjeta usada | unos 23,3 de 32 GiB | unos 21,8 de 24 GiB |
| Velocidad de escritura | unos 210 tokens/s | unos 167 tokens/s |
| Bug plantado arreglado | sí, 5 turnos, 5,9 s | sí, 5 turnos, 5,7 s |
Entrenado desde cero, con 6 de 256 especialistas despiertos por cada palabra
Flint es un modelo grande que trabaja al coste de uno pequeño. Tiene 39,8B parámetros (los números que forman un modelo), pero cada token (trozo de palabra) que escribe usa solo unos 2,5B. El truco se llama mezcla de expertos. Imagina un grupo de sesión con 256 músicos en plantilla. Para cada trozo de palabra, el director llama a los 6 que mejor le van, más un batería de la casa que toca en todas las canciones. Los otros 250 esperan en el camerino a que les llegue el turno. Pero todos tienen que estar en el edificio, y por eso el modelo entero debe caber en memoria aunque la mayor parte esté descansando.
A diferencia de los modelos de código que hemos probado hace poco, Flint no está construido sobre el modelo de otra empresa. Recursive lo entrenó por su cuenta, desde el primer paso, con conocimiento hasta junio de 2026. Tiene una arquitectura propia, así que llama.cpp, el motor en el que lo ejecutamos, necesitó código nuevo para cargarlo.
Recursive declara un 74,2 % en SWE-bench Verified. Esa prueba le da a un agente informes de bugs reales de proyectos de código abierto y solo cuenta un arreglo cuando pasan los tests del propio proyecto. También declara un 54,9 % en una segunda prueba de tareas en la línea de comandos. Son cifras de Recursive y no las hemos reproducido. No corresponden al fichero comprimido que ejecutamos, y no hemos medido cuánta calidad se pierde con la compresión. Nuestra pregunta era más concreta: ¿qué necesita Flint para funcionar en una tarjeta que un equipo pequeño puede alquilar?
El kit de servidor de Recursive necesita una tarjeta de centro de datos con 141 GB o más. El fichero comprimido de 22,9 GB es el camino barato. Funciona con llama.cpp. Recursive lo probó en varias máquinas NVIDIA, de centro de datos y de escritorio, y recomienda al menos 48 GB de memoria. Esa cifra cubre el contexto completo de Flint, 262.144 tokens.
La prueba: dos tarjetas de juego, una petición cada vez
Queríamos la respuesta más pequeña. Ejecutamos el fichero comprimido oficial en una RTX 5090 de 32 GB y en una RTX 4090 de 24 GB de nuestro cloud, y recortamos el contexto hasta que el modelo entró. En la 5090 eso fueron 64K tokens, la cuarta parte de la longitud completa. En la 4090, 16K.
El soporte en llama.cpp llegó justo a tiempo. El cambio que le enseña la arquitectura de Flint (PR #30928) lo escribió alexey-rsi y se fusionó el 21 de octubre. Empezamos nuestra prueba a la mañana siguiente.
La tarea principal es la que un agente de código hace todo el día. Le dimos a Flint un proyecto diminuto con un módulo de facturas cuyo código de descuentos trataba un porcentaje como una fracción, y dos tests que fallaban. Flint tenía cuatro herramientas: listar los ficheros, leer un fichero, escribir un fichero y pasar los tests. Tenía que encontrar el bug, arreglarlo y demostrar el arreglo. Repetimos esa ejecución siete veces en tres máquinas. También escondimos una palabra clave corta dentro de prompts largos de 8,8K y 17,5K tokens, para comprobar que el modelo sigue encontrando cosas cuando lee mucho.
Nuestras siete ejecuciones son un bug plantado en un proyecto de juguete, no un benchmark. Trabajamos por debajo de lo que recomienda Recursive: con 64K o 16K de contexto, Flint no está preparado para sesiones largas de agente. Todas las pruebas enviaron una petición cada vez. No probamos una tarjeta real de 16 GB o de 12 GB, ni el contexto completo de 262K. Las tarjetas más pequeñas que aparecen más abajo están emuladas en una máquina lenta, así que sus velocidades son inciertas.
Resultados: cinco turnos y tres tests superados en unos seis segundos
Flint arregló el bug en las siete ejecuciones, y siempre de la misma manera. Listó los ficheros y pasó los tests, que fallaron. Leyó el módulo y el fichero de tests, escribió el arreglo, volvió a pasar los tests y vio tres en verde. Después explicó el error de porcentaje frente a fracción. Son cinco turnos, y nunca tocó los tests para que pasaran. En la 5090, el bucle entero tardó 5,9 segundos.
Para una sola persona, la velocidad en la 5090 se siente instantánea. Flint escribía unos 210 tokens por segundo, más o menos 150 palabras por segundo. Una respuesta de código de 374 tokens volvió en tres segundos. Para estos modelos, leer es más rápido que escribir. Flint se tragó un prompt de 17.557 tokens, el tamaño aproximado de un documento de diseño largo, en menos de dos segundos y medio. Con 64K de contexto, la tarjeta usaba unos 23,3 GiB de sus 32.
Los detalles también aguantaron. Todas las llamadas a herramientas que envió eran válidas, y leyó los dos ficheros en un solo turno. Encontró la palabra escondida en los tres prompts largos. Una respuesta secundaria estuvo mal: al pedirle el resultado de una pequeña función auxiliar, la ejecución en la 5090 dijo 171 cuando la respuesta correcta es 113. Las otras dos ejecuciones acertaron.
Hay un resultado que va aquí para que los 210 no parezcan un golpe de suerte. Nuestra primera RTX 5090 ejecutó el mismo fichero con la misma compilación de llama.cpp a 27 tokens por segundo, unas 8 veces más despacio. Nuestra segunda 5090, en otra máquina, dio los 210 con el mismo fichero, así que la lentitud venía de esa máquina, no del modelo ni de su formato. Las diferencias visibles eran un límite de potencia de 400 W y un driver más antiguo. Nuestro cloud daba esa tarjeta por sana, y nada comprueba la velocidad de la GPU cuando arranca una máquina. Estado: abierto, causa raíz sin aislar.
Qué GPU: una RTX 4090 de 24 GB funciona con 16K, y 32K no entran
La tarjeta más pequeña que funcionó es la RTX 4090 de 24 GB. Con 16K de contexto y el modelo entero en la tarjeta, ocupó toda su memoria utilizable salvo unos 0,7 GiB. Escribía unos 167 tokens por segundo, un 20 % más despacio que la 5090. Hizo el mismo bucle de agente en 5,7 y 6,3 segundos, con tres tests superados cada vez. En tareas cortas de agente no notarías la diferencia.
Al doblar el contexto a 32K se rompió. El modelo cargó, después no pudo reservar el último pellizco de memoria de trabajo, menos de 0,1 GiB, y se paró antes de servir una sola petición. Solo el fichero ocupa 21,3 GiB, y la tarjeta deja usar unos 22,5 GiB. Así que 16K bastaron para una tarea como la nuestra, no para una sesión larga en un código grande.
Por debajo de 24 GB solo emulamos tarjetas más pequeñas, limitando la memoria en la 5090 lenta y pasando parte de los especialistas a la memoria principal de la máquina. Con un límite de unos 16 GB, Flint respondió, pero a 4,6 tokens por segundo, y una petición tardó 111 segundos. Con un límite de unos 15 GB escribía unos 6 tokens por segundo, y nuestro endpoint se rindió dos veces al llegar a su límite de dos minutos. Contamos las dos como fallos para uso interactivo.
En InferenceKey: listo en 13,5 segundos en caliente, tras una compilación de 7 minutos
La tarjeta es tuya por horas, y tú eliges lo que se ejecuta en ella. En InferenceKey, el worker es el pequeño programa de la máquina con GPU que descarga el modelo y arranca el motor. Para Flint, su modo llama.cpp integrado sirvió el fichero oficial sin código propio. El mismo endpoint respondió a las llamadas a herramientas del agente en el formato de OpenAI que ya hablan las herramientas de código.
El primer arranque en una máquina recién creada tardó unos nueve minutos. Siete se fueron en compilar llama.cpp para la tarjeta. Descargar el fichero de 22,9 GB llevó unos dos más, y cargarlo, unos seis segundos. A partir de ahí, un reinicio con todo en su sitio estuvo listo en 13,5 segundos.
Hay dos problemas con los que te vas a encontrar.
El primero es la versión de llama.cpp. La versión por defecto del worker, b9748, es anterior a Flint. Compilamos el commit de la fusión a mano, porque creíamos que ninguna versión publicada lo incluía. Fue un error nuestro: la versión b11803 es el mismo código, publicada antes de que empezara la prueba. Configura el worker con b11803 o posterior. Estado: abierto por nuestra parte. Todavía hay que actualizar la versión por defecto del worker (b9748) y el README del ejemplo. No hemos ejecutado el worker con b11803.
El segundo es dónde acaba el razonamiento del modelo. Flint razona antes de responder, y con esta compilación ese razonamiento llega dentro del texto de la respuesta en lugar de en su propio campo. Las herramientas de código configuradas como sugiere Recursive lo buscan en otro sitio y no lo van a encontrar. Además, el razonamiento cuenta contra tu presupuesto de tokens. Estado: abierto.
¿Merece la pena? Sí, para tareas cortas de agente en una tarjeta de 24 o 32 GB
Si quieres un agente de código abierto en hardware propio o alquilado, Flint merece una prueba hoy mismo. Una RTX 5090 de 32 GB tiene sitio para una tarea mediana, y una RTX 4090 de 24 GB, para tareas cortas.
Si tus sesiones de agente son largas, con códigos grandes y cientos de llamadas a herramientas, cuenta con más memoria.
Gracias a Recursive por crear Flint y a alexey-rsi por su soporte en llama.cpp. Lo vimos en un hilo de r/LocalLLaMA.
Ejecuta python main.py desde el ejemplo de Flint del SDK para repetir el bucle de arreglar el bug en tu propio worker NVIDIA. Necesita el SDK compilado desde el repo, 32 GB o más para sus 64K por defecto y llama.cpp b11803 o posterior. Cuenta con unos siete minutos para la primera compilación y una descarga de 22,9 GB.
Para ingenieros
Modelo y ficheros
- RecursiveSI/flint:
FlintForCausalLM, 39,8B en total, unos 2,5B activos por token contando la cabeza de salida (unos 2,2B solo el cuerpo). 49 capas: 2 densas (mlp_only_layers [0,1]) y 47 MoE con 256 expertos enrutados, 6 por token, más un experto compartido (shared_expert_intermediate_size 1024). 35 capas de ventana deslizante (ventana 513) y 14 de atención completa. 32 cabezas de query, 4 cabezas KV, head_dim 128, hidden 2048, vocabulario de 150.144,max_position_embeddings262.144. Router sigmoide, RMSNorm QK por cabeza, attention sinks aprendidos por cabeza (softmax_type "learnable"), RoPE solo en las capas de ventana deslizante. Entrenado desde cero con preentrenamiento, mid-training, SFT y RL. Conocimiento hasta junio de 2026. No se indica el número de tokens. Todavía no incluye código de modelado para Transformers. Checkpoint BF16 de unos 80 GB. - Evaluaciones del fabricante (declaradas por él, sin verificar por nosotros): Terminal-Bench 2.1 54,9 % (Terminus 2), SWE-bench Verified 74,2 % y SWE-bench Pro v2 89,7 % (mini-swe-agent). Media de pass@1 sobre al menos cinco intentos, temperatura 1,0, top-p 0,95, top-k 20. Las soluciones de Terminal-Bench sacadas de la web se cuentan como fallos. Las cifras de la competencia solo están en una imagen de un gráfico, así que no las extrajimos.
- flint-nvfp4-gguf:
flint-nvfp4.gguf, 22.863.084.160 bytes, pesos, tokenizador y plantilla de chat en un solo fichero, para llama.cpp sobre CUDA. Los autores dan como probadas B300, RTX PRO 6000 Blackwell, RTX Spark y DGX Spark, y recomiendan al menos 48 GB de memoria de GPU (o memoria unificada en Spark). Su comando de ejemplo usa-c 262144; nosotros trabajamos por debajo de esa recomendación. llama-bench lo da como 21.29 GiB, 39.79 B params. - flint-int4-gguf:
flint-int4-q4_1.gguf, 25.992.966.976 bytes, Q4_1, pensado para Apple Silicon con Metal y 48 GB de memoria unificada. Solo lo ejecutamos en llama-bench, en la máquina lenta. - flint-int4: MLX INT4 (afín en grupos de 64, embeddings INT8), unos 22,6 GB, para mlx-lm.
- Kit de SGLang (
sglang/en el repo principal, SGLang 0.5.16): una GPU con al menos 141 GB por réplica (B300, B200 o H200), "80 GB GPUs are not supported", driver 580 o posterior. Los scripts de servicio usan--context-length 262144 --tool-call-parser flint --reasoning-parser flint. Los autores no han validado pesos y KV cuantizados, TP/EP ni speculative decoding. - recursive-oss/rec: motor Apache-2.0 para Flint en Apple Silicon (M4 Pro, M5 Pro, M5 Max, 48 GB o más), API compatible con OpenAI; dice decodificar entre 1,4 y 2,6 veces más rápido que llama.cpp en un M4 Pro (cifra suya).
Soporte en llama.cpp
- PR #30928 "models: Add Flint model (FlintForCausalLM)" de alexey-rsi, fusionada el 2026-10-21T21:26:22Z, commit de fusión
a37cc46104eb50900d5ab4a9ba02a0abdac039db, +319/-7 en 18 ficheros, aprobada por CISC y ggerganov. Usa como apaño el escalado adaptativo de activación de expertos de #30861, y la PR indica que ese autoescalado cuesta entre un 10 y un 30 % de velocidad, algo que se abordará más adelante (no lo hemos medido). La PR declara que Codex ayudó de forma sustancial en la implementación. - PR #30929 "jinja: support hexadecimal string escapes" (alexey-rsi, fusionada el 2026-10-21T16:04:37Z, aprobada por CISC y danbev) la necesita la plantilla de chat.
- La versión
b11803(publicada el 2026-10-21T22:30:59Z) es idéntica aa37cc461. b11804 y posteriores también la incluyen.v0.7.0va 134 commits por detrás.
Nuestro montaje
- Tarjetas en nuestro cloud: RTX 5090 32 GB (driver 595.91.07, 575 W), RTX 4090 24 GB (23.028 MiB utilizables, driver 595.91.07, 450 W), y una primera RTX 5090 (driver 580.178.04, límite de potencia de 400 W) que resultó ser una máquina lenta.
- Un manager local de InferenceKey desde
mainen5c08ab03, al que los workers llegaban por túneles de desarrollo. Producción sin tocar. - Entorno del worker:
INFERENCEKEY_LLAMACPP_TAG=flint-a37cc461,INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000,CMAKE_BUILD_PARALLEL_LEVEL,CUDACXX. - llama.cpp compilado a mano en
a37cc461en la ruta de instalación del worker/opt/inferencekey/llamacpp-cuda/flint-a37cc461-cuda<arch>/. El worker encontró ahíbuild/bin/llama-servery lo reutilizó. Su tag por defecto esb9748, y clona congit clone --branch <tag>, que acepta un nombre de tag o de rama, no un commit.
Despliegue paso a paso
-
Clona el SDK y abre examples/flint-coding-agent-llamacpp-private-nvidia (
main.py,README.md,.env.example,requirements.txt, commit1654d272). -
Copia
.env.examplea.env, rellénalo y exporta las variables a tu shell (main.pylas lee del entorno y no carga.envpor su cuenta):INFERENCEKEY_SDK_TOKEN=... INFERENCEKEY_API_KEY=... INFERENCEKEY_PROJECT=... IK_WORKER_ID=... # private NVIDIA worker, 32 GB or more for the 64K default # optional INFERENCEKEY_BASE_URL=... IK_KEEP_ALIVE=1 # keep the deployment after the run -
En el worker, configura una versión de llama.cpp que incluya Flint y dale tiempo a la primera compilación:
INFERENCEKEY_LLAMACPP_TAG=b11803          # or newer; we used a hand build at a37cc461
INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000
CMAKE_BUILD_PARALLEL_LEVEL=<cores>
# Blackwell needs the CUDA toolkit with nvcc 12.8 or newer
El README del ejemplo pide un tag que contenga
a37cc461, omaster. Su nota de que ningún tag de versión incluía la PR cuando hicimos la prueba está desfasada:b11803coincide con el commit de fusión. No hemos ejecutado el worker conb11803en sí. -
Instala y ejecuta. El SDK aún no está en PyPI (la línea
inferencekeyderequirements.txtestá comentada), así que primero compílalo en local, como explican el README del ejemplo y../CONTRIBUTING.md:python -m venv .venv && . .venv/bin/activate pip install maturin ( cd ../../bindings/python && maturin develop --release ) pip install -r requirements.txt set -a; . ./.env; set +a python main.pymain.pyllama aensure()conBackend.LLAMACPP, espera hasta 3.600 s a que esté listo, pide una funciónmerge_intervals, ejecuta el bucle de agente de código conlist_files,read_file,write_fileyrun_testsconfinados en un directorio temporal, escribeoutputs/answers.jsony borra el despliegue salvo conIK_KEEP_ALIVE=1. -
El comando que despliega:
llama-server -hf RecursiveSI/flint-nvfp4-gguf --hf-file flint-nvfp4.gguf --alias flint \
  -ngl all -c 65536 -np 1 -fa on -ctk f16 -ctv f16 --jinja \
  --temp 1 --top-p 0.95 --top-k 20 --min-p 0
El comando está fijo en
main.py(línea 58), y ninguna variable de entorno ni flag lo cambia. Para un worker de 24 GB, cambia ahí-c 65536por-c 16384. Deja--swa-fullsin poner, como dice la card del modelo.
Tiempo hasta estar listo
| Paso | RTX 5090 | RTX 4090 |
|---|---|---|
| Compilación CUDA de llama.cpp, máquina nueva | 7 min 13 s (-j 46) | 6 min 26 s |
ensure() hasta listo, en frío | 129,5 s (descarga de unos 114 s a unos 200 MB/s, carga de unos 6 s) | 126,9 s (descarga de unos 113 s, carga de 5,3 s) |
| Reinicio en caliente (binario compilado, pesos en caché) | 13,5 s (carga de 4,6 s); peldaños de la escalera en la 5090 lenta, de 13,8 a 14,8 s | sin medir |
Velocidad
| Máquina y configuración | Decodificación, por petición | llama-bench | Prefill |
|---|---|---|---|
RTX 5090, 64K, compilación nativa 120a | de 194 a 216 tok/s (salidas largas, unos 210) | tg128 239,8, pp512 6.217 | 7.352 tok/s con 17.557 tokens |
RTX 5090, compilación PTX (89-virtual) | tg128 216,1, pp512 6.495 | ||
| RTX 4090, 16K | de 154 a 170 tok/s (unos 167) | tg128 181,2, pp512 5.658 | 6.230 tok/s con 8.807 tokens |
| RTX 5090 lenta, 64K, 32K, 16K | de 26,6 a 28,4 tok/s | tg128 28,8 (NVFP4), 29,3 (Q4_1), pp512 2.593 | 2.726 tok/s con 17.557 tokens |
El CMake de llama.cpp elige solo CMAKE_CUDA_ARCHITECTURES=120a en Blackwell, y la compilación nativa fue un 11 % más rápida que el JIT de PTX. NVFP4 también funcionó en Ada (sm_89, la 4090). En la 5090, una respuesta de código de 374 tokens tardó 3,0 s.
Estimación del KV: 14 capas de atención completa x 4 cabezas KV x 128 x 2 (K y V) x 2 bytes = 28.672 bytes por token, unos 0,9 GiB con 32K y 1,75 GiB con 64K.
Escalera completa de VRAM
| Objetivo | Configuración | Pico de VRAM (llama-server) | Velocidad | Salida correcta | Tarjeta real |
|---|---|---|---|---|---|
| RTX 5090 32 GB | NVFP4, -c 65536, KV F16, -ngl all | 23.872 MiB | unos 210 tok/s, agente 5,9 s | sí | sí |
| RTX 5090 32 GB (máquina lenta) | NVFP4, -c 32768 | 22.922 MiB | 27,3 tok/s | sí | sí |
| RTX 5090 32 GB (máquina lenta) | NVFP4, -c 16384 | 22.458 MiB | 27,5 tok/s | sí | sí |
| RTX 4090 24 GB | NVFP4, -c 16384, KV F16, -ngl all | 22.316 MiB de 23.028 | unos 167 tok/s, agente 5,7 y 6,3 s | sí | sí |
| RTX 4090 24 GB | NVFP4, -c 32768 | OOM al cargar | cudaMalloc failed: out of memory | no | sí |
| Límite de unos 16 GB (5090 lenta) | NVFP4, -c 32768, --n-cpu-moe 18 | 16.116 MiB | 4,57 tok/s, petición de 111 s | sí, demasiado lento | emulada |
| Límite de unos 15 GB (5090 lenta) | NVFP4, -c 32768, --n-cpu-moe 22 -t 12 | 14.388 MiB | unos 5,9 tok/s, 503 tras 120 s, dos veces | no | emulada |
El fallo de la 4090 con 32K:
ggml_backend_cuda_buffer_type_alloc_buffer: allocating 87.50 MiB on device 0: cudaMalloc failed: out of memory
failed to allocate buffer for kv cache
Después, el SDK lanzó failed to become ready: bootstrap step failed.
Sin probar: tarjetas de 12 GB, RTX 3090 (sin stock cuando lo intentamos), la 5090 por encima de 64K, cualquier tarjeta de 48 GB, el contexto completo de 262K y concurrencia por encima de -np 1.
Calidad (nuestros prompts, no un benchmark)
- Bucle de agente de código: 7 de 7 ejecuciones en 3 máquinas arreglaron el bug, siempre en 5 turnos, de 559 a 654 tokens, sin tocar nunca los tests.
- JSON de las llamadas a herramientas válido siempre, con llamadas en paralelo. En otra prueba de herramientas aparte, nuestro
read_filesimulado devolvía el mismo texto para cualquier ruta (un bug nuestro). El modelo se dio cuenta ("suspiciously identical") y siguió buscando durante 6 turnos en lugar de responder. merge_intervals: correcto, con tres asserts, en 5 ejecuciones.- Un off-by-one plantado en una función
chunks: encontrado 3 de 3. - Cadena oculta
FLINT-4471-NVFP4: encontrada 3 de 3 con 8,8K y 17,5K tokens. Pregunta aritmética secundaria acertada 2 de 3 (helper_175(2)respondió 171, la correcta es 113).
Vídeo de la demo
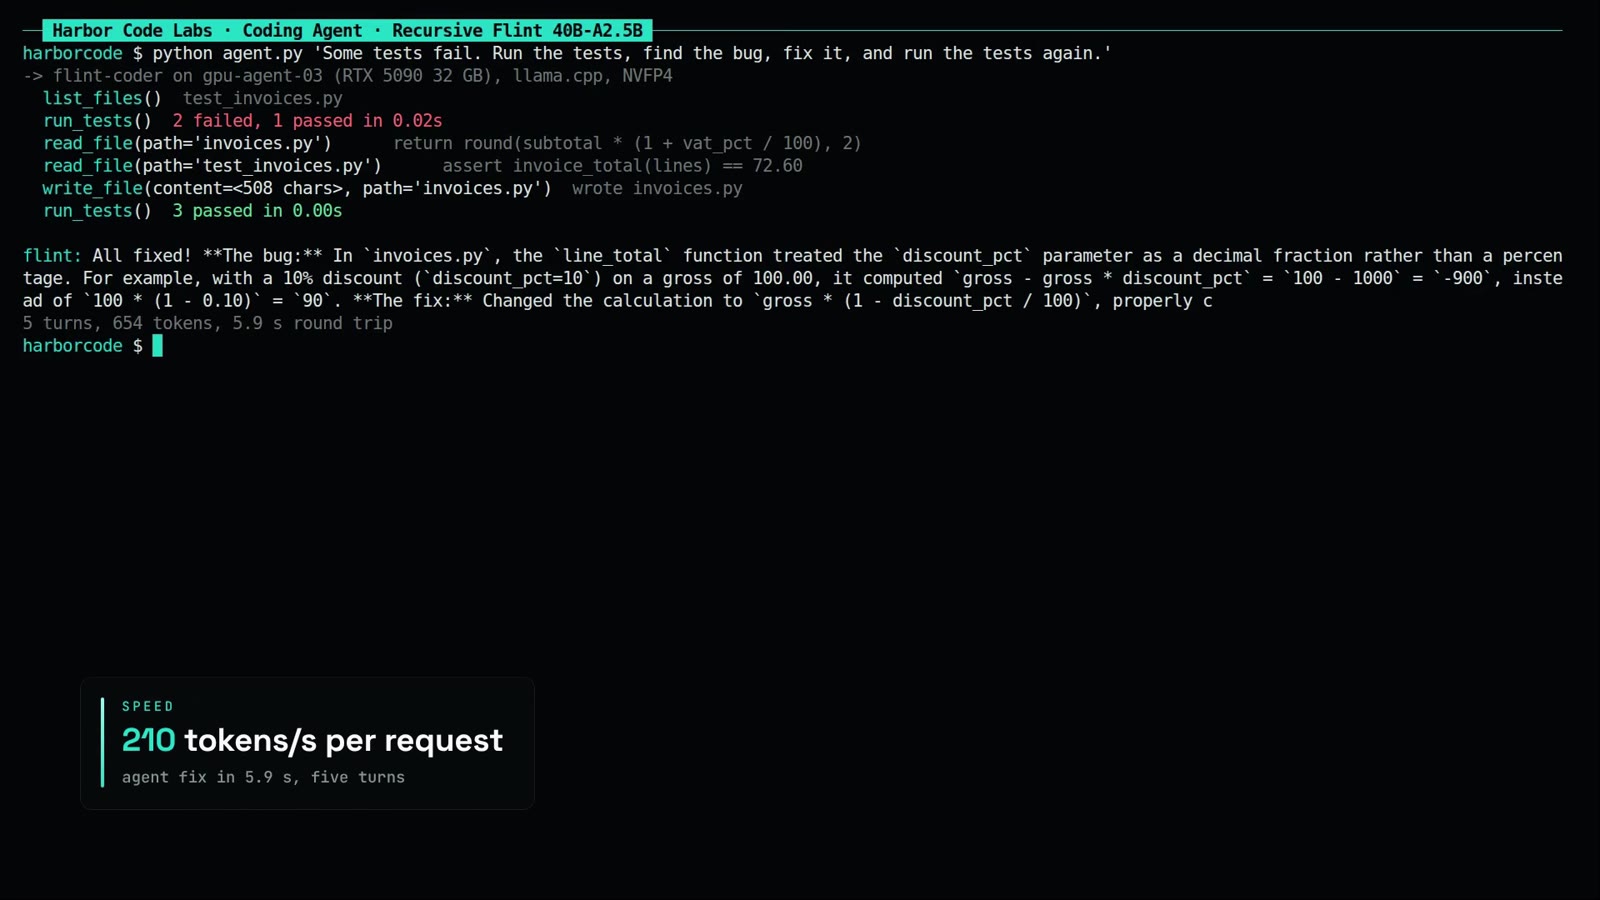
72,9 s, 1080p, narrado, grabado en la 5090 sana: el workload en el panel, el módulo con el bug y el bucle del agente (5 turnos, 654 tokens, 5,9 s, 3 superados). Sustituimos una toma anterior grabada en la 5090 lenta.
Problemas pendientes y estado
- Versión de llama.cpp. Flint necesita
b11803o posterior, y el worker acepta un tag, no un commit. Estado: resuelto upstream, abierto por nuestra parte (la versión por defecto del worker,b9748, y el README aún sin actualizar), sin probar por nosotros con el tag. El README de nuestro SDK pide un tag que contengaa37cc461omaster; su nota de que no existía ningún tag de versión está desfasada, y falta nombrar ahíb11803. - Máquina lenta. Una RTX 5090 decodificaba entre 27 y 29 tok/s con el mismo fichero y el mismo commit, también con Q4_1.
nvidia-smi dmonmostraba SM al 100 %, memoria del 0 al 6 % y 399 W con su límite de 400 W. Una segunda 5090 fue 8,3 veces más rápida en llama-bench (tg128 239,8 frente a 28,8). Causa raíz sin aislar (el límite de potencia y el driver 580.178 son las diferencias visibles). La plataforma la daba por sana, y nada comprueba el rendimiento de la GPU en el arranque. Estado: abierto. - Memoria utilizable de 24 GB. La 4090 deja usar 23.028 MiB. Con 16K, llama-server usó 22.316 MiB; pasar de 16K a 32K añadió 464 MiB en la 5090 lenta (de 22.458 a 22.922), y el driver ocupa memoria fuera del proceso (una 5090 en reposo mostraba 1.039 MiB usados), así que NVFP4 con 32K de contexto no entra. Estado: es un límite, usa 16K.
- Timeout síncrono. El timeout síncrono de 120 s del endpoint devuelve 503 con configuraciones lentas, como descargar expertos a la CPU. Estado: abierto.
- Compilación a mano. El target
llama-serverfalla enllama-ui-assetssalvo que existan los 8 ficheros stub de la UI (el worker los crea). Estado: solo afecta a compilaciones a mano. - Razonamiento en
content. Con esta compilación y esta plantilla a través de nuestro endpoint, el texto del razonamiento llega dentro decontenty faltareasoning_content. Los tokens de razonamiento cuentan enusage.completion_tokensy contramax_tokens(el ejemplo usa 16.384). Las configuraciones de cliente de Recursive usan un presupuesto de generación de 65.536 tokens y piden conservarreasoning_contental reenviar el historial. Estado: abierto.
Límites
Una petición cada vez, siete ejecuciones del agente, prompts nuestros. Muestreo con temperatura 1,0, top-p 0,95 y top-k 20, como recomienda Recursive. Los benchmarks son los que declara el fabricante. Los peldaños emulados se ejecutaron en la máquina lenta. No probamos ninguna tarjeta real de 16 GB ni de 12 GB.
Créditos
Recursive (modelo, ficheros NVFP4 e INT4, kit de SGLang, rec). alexey-rsi (PRs #30928 y #30929 de llama.cpp). CISC y ggerganov (aprobaron #30928). CISC y danbev (aprobaron #30929). ggerganov (#30861, el escalado MoE por experto que usa el soporte de Flint). Lo nuestro: el despliegue en InferenceKey, el ejemplo del SDK, las mediciones y el vídeo.
Fuentes
- Card del modelo RecursiveSI/flint, con su
config.jsony susglang/README.md - RecursiveSI/flint-nvfp4-gguf
- RecursiveSI/flint-int4-gguf
- RecursiveSI/flint-int4
- PR #30928 de llama.cpp
- PR #30929 de llama.cpp
- recursive-oss/rec
- Ejemplo del SDK de InferenceKey
- Dónde lo vimos: hilo de r/LocalLLaMA