Flint, un modèle de code entraîné de zéro, fait tourner sa boucle d'agent sur une seule RTX 4090
Flint de Recursive sur nos GPU : 210 tokens/s sur RTX 5090 à 64K de contexte, 167 sur RTX 4090 à 16K, un bug piégé corrigé dans 7 essais sur 7.
Le kit serveur de Recursive pour Flint en pleine précision demande une carte de centre de données avec au moins 141 GB de mémoire. Nous avons fait tourner le fichier compressé officiel de Flint et sa boucle d'agent de code sur une RTX 4090 de 24 GB, une carte conçue pour le jeu vidéo. Flint est le nouveau modèle d'agent de code de Recursive, et ce fichier pèse 22,9 GB. Nous l'avons chargé sur une RTX 5090 de 32 GB et sur la 4090, toutes deux sur notre propre cloud. Sur la 5090, Flint a corrigé un bug glissé exprès dans un petit projet de code en cinq étapes et environ six secondes. La 4090 a fait le même travail dans à peu près le même temps, en écrivant environ 20 % moins vite, mais seulement avec un contexte plus court (ce qu'il garde en tête). Avec le double de contexte, elle a manqué de place avant même de démarrer. Recursive a entraîné Flint de zéro, et la licence est Apache 2.0. Si vous servez des agents de code sur vos propres GPU, c'est un modèle que vous pouvez faire tourner et modifier sur une carte louée à l'heure.
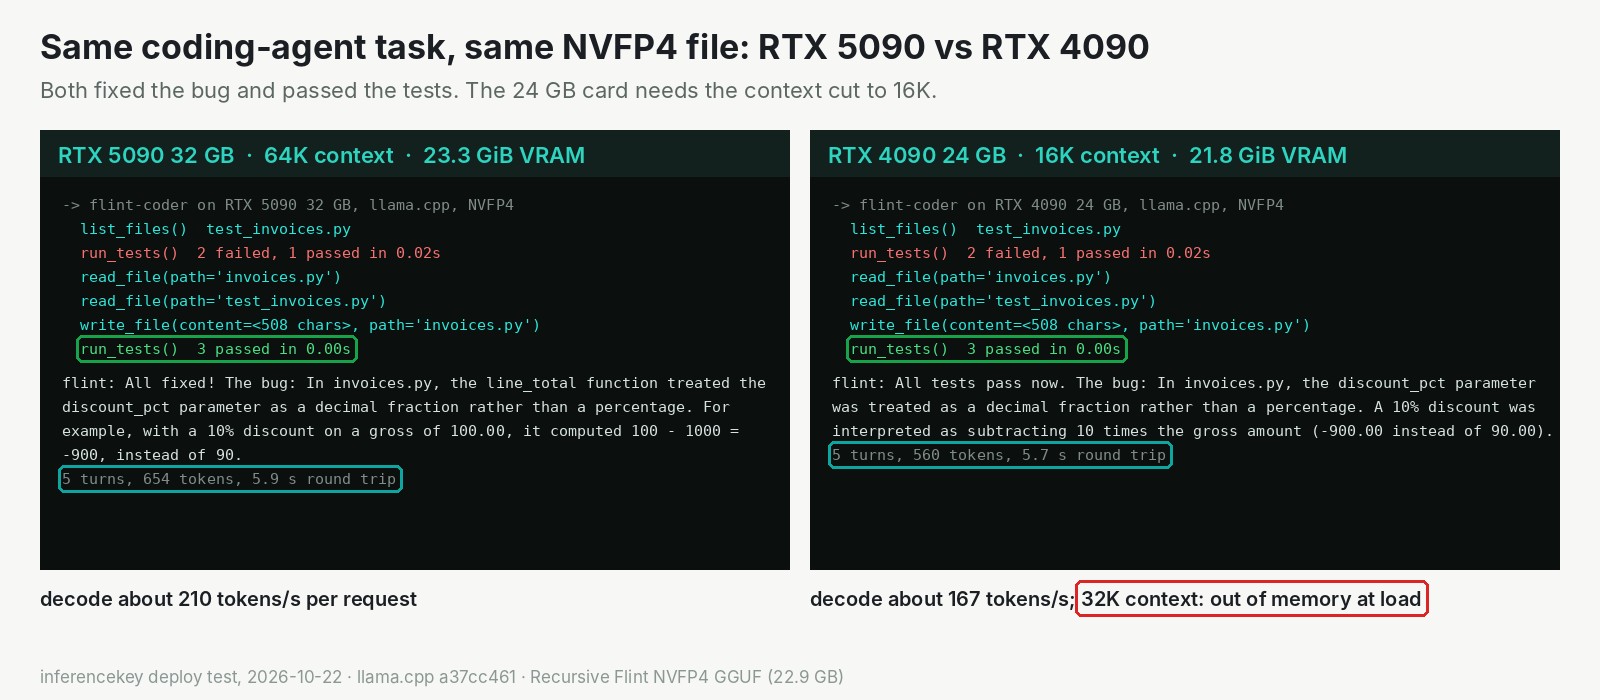
Même tâche, même fichier, même réponse sur les deux cartes. Le cadre rouge marque l'endroit où la plus petite carte s'arrête : 32K de contexte ne tiennent pas.
| RTX 5090, 32 GB | RTX 4090, 24 GB | |
|---|---|---|
| Texte qu'elle peut garder en tête (contexte) | 64K tokens | 16K tokens (32K ne tenaient pas) |
| Mémoire de la carte utilisée | environ 23,3 sur 32 GiB | environ 21,8 sur 24 GiB |
| Vitesse d'écriture | environ 210 tokens/s | environ 167 tokens/s |
| Bug piégé corrigé | oui, 5 tours, 5,9 s | oui, 5 tours, 5,7 s |
Entraîné de zéro, avec 6 spécialistes sur 256 réveillés pour chaque mot
Flint est un gros modèle qui travaille au prix d'un petit. Il contient 39,8 milliards de paramètres (les nombres qui composent un modèle), mais chaque token (morceau de mot) qu'il écrit n'en utilise qu'environ 2,5 milliards. L'astuce s'appelle un mélange d'experts (mixture of experts). Imaginez un orchestre de studio avec 256 musiciens sur la liste. Pour chaque morceau de mot, le chef appelle les 6 qui conviennent le mieux, plus un batteur maison qui joue sur tous les titres. Les 250 autres attendent en coulisses leur tour. Tous doivent quand même être dans le bâtiment, et c'est pour cela que le modèle entier doit tenir en mémoire, même si la plus grande partie se repose.
Contrairement aux modèles de code que nous avons testés récemment, Flint ne repose pas sur le modèle d'une autre entreprise. Recursive a entraîné Flint lui-même, dès la toute première étape, avec des connaissances jusqu'à juin 2026. Il a sa propre architecture, si bien que llama.cpp, le moteur sur lequel nous l'avons fait tourner, a eu besoin de nouveau code pour le charger.
Recursive annonce 74,2 % sur SWE-bench Verified. Ce test donne à un agent de vrais rapports de bug tirés de projets open source et ne compte une correction que si les propres tests du projet passent. Recursive annonce aussi 54,9 % sur un second test de tâches en ligne de commande. Ce sont les chiffres de Recursive et nous ne les avons pas reproduits. Ce ne sont pas des scores du fichier compressé que nous avons utilisé, et nous n'avons pas mesuré combien de qualité la compression fait perdre. Notre question était plus étroite : de quoi Flint a-t-il besoin pour tourner sur une carte qu'une petite équipe peut louer ?
Le kit serveur de Recursive a besoin d'une carte de centre de données avec 141 GB ou plus. Le fichier compressé de 22,9 GB est la voie la moins chère. Il tourne sur llama.cpp. Recursive l'a testé sur plusieurs machines NVIDIA, de centre de données et de bureau, et recommande au moins 48 GB de mémoire. Ce chiffre couvre le contexte complet de Flint, 262 144 tokens.
Le test : deux cartes de jeu, une requête à la fois
Nous voulions la réponse la plus modeste. Nous avons fait tourner le fichier compressé officiel sur une RTX 5090 de 32 GB et une RTX 4090 de 24 GB sur notre cloud, et réduit le contexte jusqu'à ce que le modèle tienne. Sur la 5090, cela voulait dire 64K tokens, un quart de la longueur complète. Sur la 4090, 16K.
Le support dans llama.cpp est arrivé juste à temps. La modification qui lui apprend l'architecture de Flint (PR #30928) a été écrite par alexey-rsi et fusionnée le 21 octobre. Nous avons commencé notre test le lendemain matin.
La tâche principale est celle qu'un agent de code fait toute la journée. Nous avons donné à Flint un tout petit projet avec un module de factures dont le code de remise traitait un pourcentage comme une fraction, et deux tests qui échouaient. Flint avait quatre outils : lister les fichiers, lire un fichier, écrire un fichier et lancer les tests. Il devait trouver le bug, le corriger et prouver la correction. Nous avons répété cet essai sept fois sur trois machines. Nous avons aussi caché un court mot de code dans de longs prompts de 8,8K et 17,5K tokens, pour vérifier que le modèle trouve encore les choses quand il lit beaucoup.
Nos sept essais portent sur un seul bug piégé dans un projet jouet, ce n'est pas un benchmark. Nous sommes restés en dessous de ce que recommande Recursive : avec 64K ou 16K de contexte, Flint n'est pas configuré pour de longues sessions d'agent. Chaque test envoyait une requête à la fois. Nous n'avons essayé ni une vraie carte de 16 GB ou de 12 GB, ni le contexte complet de 262K. Les petites cartes plus bas sont émulées sur une machine lente, donc leurs vitesses sont incertaines.
Résultats : cinq tours et trois tests au vert en environ six secondes
Flint a corrigé le bug dans les sept essais, et de la même façon à chaque fois. Il a listé les fichiers et lancé les tests, qui ont échoué. Il a lu le module et le fichier de test, écrit la correction, relancé les tests et vu trois tests passer. Puis il a expliqué l'erreur entre pourcentage et fraction. Cela fait cinq tours, et il n'a jamais modifié les tests pour les faire passer. Sur la 5090, la boucle entière a pris 5,9 secondes.
Pour une seule personne, la vitesse sur la 5090 paraissait instantanée. Flint écrivait environ 210 tokens par seconde, à peu près 150 mots par seconde. Une réponse de code de 374 tokens revenait en trois secondes. Pour ces modèles, lire va plus vite qu'écrire. Flint a absorbé un prompt de 17 557 tokens, à peu près la taille d'un long document de conception, en moins de deux secondes et demie. Avec 64K de contexte, la carte utilisait environ 23,3 GiB de ses 32.
Les détails ont tenu aussi. Chaque appel d'outil qu'il a envoyé était valide, et il a lu les deux fichiers en un seul tour. Il a trouvé le mot de code caché dans les trois longs prompts. Une réponse annexe était fausse : quand on lui a demandé de calculer une petite fonction utilitaire, l'essai sur la 5090 a répondu 171 alors que la bonne réponse est 113. Les deux autres essais ont donné la bonne.
Un résultat a sa place ici pour que les 210 ne passent pas pour un coup de chance. Notre première RTX 5090 a fait tourner le même fichier et la même build de llama.cpp à 27 tokens par seconde, environ 8 fois plus lentement. Notre seconde 5090, sur une autre machine, a donné les 210 avec le même fichier, donc la lenteur venait de cette machine, pas du modèle ni de son format. Les différences visibles étaient une limite de puissance à 400 W et un pilote plus ancien. Notre cloud signalait cette carte comme saine, et rien ne vérifie la vitesse du GPU au démarrage d'une machine. Statut : ouvert, cause racine non isolée.
Quel GPU : une RTX 4090 de 24 GB fonctionne à 16K, et 32K ne tient pas
La plus petite carte qui a fonctionné est la RTX 4090 de 24 GB. Avec 16K de contexte et le modèle entier sur la carte, elle a rempli toute sa mémoire utilisable sauf environ 0,7 GiB. Elle écrivait environ 167 tokens par seconde, environ 20 % moins vite que la 5090. Elle a fait tourner la même boucle d'agent en 5,7 et 6,3 secondes, avec trois tests au vert à chaque fois. Pour des tâches d'agent courtes, vous ne verriez pas la différence.
Doubler le contexte à 32K l'a fait tomber. Le modèle s'est chargé, puis n'a pas réussi à réserver son dernier petit bout de mémoire de travail, moins de 0,1 GiB, et s'est arrêté avant de servir une seule requête. Le fichier seul occupe 21,3 GiB, et la carte n'expose qu'environ 22,5 GiB. Donc 16K suffisaient pour une tâche comme la nôtre, pas pour une longue session dans une grosse base de code.
En dessous de 24 GB, nous avons seulement émulé des cartes plus petites, en plafonnant la mémoire sur la 5090 lente et en déplaçant une partie des spécialistes vers la mémoire principale de la machine. Avec un plafond proche de 16 GB, Flint répondait, mais à 4,6 tokens par seconde, et une requête a pris 111 secondes. Avec un plafond proche de 15 GB, il écrivait environ 6 tokens par seconde, et notre endpoint a abandonné deux fois après sa limite de deux minutes. Nous comptons les deux comme des échecs pour un usage interactif.
Sur InferenceKey : prêt en 13,5 secondes à chaud, après une compilation de 7 minutes
La carte est à vous à l'heure, et vous choisissez ce qui tourne dessus. Sur InferenceKey, le worker est le petit programme sur la machine GPU qui récupère le modèle et démarre le moteur. Pour Flint, son mode llama.cpp intégré a servi le fichier officiel sans code sur mesure. Le même endpoint a répondu aux appels d'outils de l'agent au format OpenAI que les outils de code parlent déjà.
Le premier démarrage sur une machine neuve a pris environ neuf minutes. Sept d'entre elles sont passées à compiler llama.cpp pour la carte. Télécharger le fichier de 22,9 GB a pris environ deux minutes de plus, et le charger environ six secondes. Ensuite, un redémarrage avec tout en place était prêt en 13,5 secondes.
Deux problèmes sont ceux que vous rencontrerez.
Le premier est la version de llama.cpp. La version par défaut du worker, b9748, est antérieure à Flint. Nous avons compilé le commit de fusion à la main, parce que nous pensions qu'aucune version publiée ne le contenait. C'était notre erreur : la release b11803 est le même code, publiée avant le début de notre test. Configurez le worker sur b11803 ou plus récent. Statut : ouvert de notre côté. La version par défaut de notre worker (b9748) et le README de l'exemple doivent encore être mis à jour. Nous n'avons pas fait tourner le worker avec b11803.
Le second est l'endroit où atterrit la réflexion du modèle. Flint raisonne avant de répondre, et avec cette build ce raisonnement arrive dans le texte de la réponse au lieu d'avoir son propre champ. Les outils de code configurés comme le suggère Recursive le cherchent à un endroit séparé et ne le trouveront pas. Le raisonnement compte aussi dans votre budget de tokens. Statut : ouvert.
Faut-il l'utiliser ? Oui pour des tâches d'agent courtes sur une carte de 24 ou 32 GB
Si vous voulez un agent de code ouvert sur du matériel que vous possédez ou louez, Flint vaut la peine d'être essayé dès aujourd'hui. Une RTX 5090 de 32 GB a de la place pour une tâche moyenne, et une RTX 4090 de 24 GB pour des tâches courtes.
Si vos sessions d'agent durent longtemps, sur de grosses bases de code et des centaines d'appels d'outils, prévoyez plus de mémoire.
Merci à Recursive d'avoir construit Flint et à alexey-rsi pour son support dans llama.cpp. Nous l'avons repéré dans un fil sur r/LocalLLaMA.
Lancez python main.py depuis l'exemple Flint du SDK pour répéter la boucle de correction de bug sur votre propre worker NVIDIA. Il faut le SDK compilé depuis le dépôt, 32 GB ou plus pour son contexte par défaut de 64K, et llama.cpp b11803 ou plus récent. Comptez environ sept minutes pour la première compilation et un téléchargement de 22,9 GB.
Pour les ingénieurs
Modèle et fichiers
- RecursiveSI/flint :
FlintForCausalLM, 39.8B au total, environ 2.5B actifs par token en comptant la tête de sortie (environ 2.2B pour le corps seul). 49 couches : 2 denses (mlp_only_layers [0,1]) et 47 MoE avec 256 experts routés, 6 par token, plus un expert partagé (shared_expert_intermediate_size 1024). 35 couches à fenêtre glissante (fenêtre de 513) et 14 couches à attention complète. 32 têtes de requête, 4 têtes KV, head_dim 128, hidden 2048, vocabulaire de 150 144,max_position_embeddings262 144. Routeur sigmoïde, RMSNorm QK par tête, attention sinks appris par tête (softmax_type "learnable"), RoPE uniquement sur les couches à fenêtre glissante. Entraîné de zéro en passant par le préentraînement, le mid-training, le SFT et le RL. Connaissances jusqu'à juin 2026. Nombre de tokens d'entraînement non indiqué. Code de modélisation Transformers pas encore inclus. Checkpoint BF16 d'environ 80 GB. - Évaluations de l'éditeur (déclarées par lui, non vérifiées par nous) : Terminal-Bench 2.1 54,9 % (Terminus 2), SWE-bench Verified 74,2 % et SWE-bench Pro v2 89,7 % (mini-swe-agent). Pass@1 moyen sur au moins cinq tentatives, température 1,0, top-p 0,95, top-k 20. Les solutions de Terminal-Bench récupérées sur le web sont comptées comme des échecs. Les scores des concurrents ne figurent que dans une image de graphique, donc nous ne les avons pas extraits.
- flint-nvfp4-gguf :
flint-nvfp4.gguf, 22 863 084 160 octets, poids, tokenizer et chat template dans un seul fichier, pour llama.cpp sur CUDA. Les auteurs listent B300, RTX PRO 6000 Blackwell, RTX Spark et DGX Spark comme testés, et recommandent au moins 48 GB de mémoire GPU (ou de mémoire unifiée sur Spark). Leur commande d'exemple utilise-c 262144; nous sommes restés en dessous de cette recommandation. llama-bench le rapporte comme 21.29 GiB, 39.79 B params. - flint-int4-gguf :
flint-int4-q4_1.gguf, 25 992 966 976 octets, Q4_1, pensé pour Apple Silicon avec Metal et 48 GB de mémoire unifiée. Nous ne l'avons fait tourner que dans llama-bench, sur la machine lente. - flint-int4 : MLX INT4 (affine par groupes de 64, embeddings INT8), environ 22,6 GB, pour mlx-lm.
- Kit SGLang (
sglang/dans le dépôt principal, SGLang 0.5.16) : un GPU avec au moins 141 GB par réplique (B300, B200 ou H200), "80 GB GPUs are not supported", pilote 580 ou plus récent. Les scripts de service utilisent--context-length 262144 --tool-call-parser flint --reasoning-parser flint. Poids et KV quantifiés, TP/EP et décodage spéculatif non validés par les auteurs. - recursive-oss/rec : moteur Apache-2.0 pour Flint sur Apple Silicon (M4 Pro, M5 Pro, M5 Max, 48 GB ou plus), API compatible OpenAI, annonce un décodage 1,4 à 2,6 fois plus rapide que llama.cpp sur M4 Pro (leur chiffre).
Support dans llama.cpp
- PR #30928 "models: Add Flint model (FlintForCausalLM)" par alexey-rsi, fusionnée le 2026-10-21T21:26:22Z, commit de fusion
a37cc46104eb50900d5ab4a9ba02a0abdac039db, +319/-7 dans 18 fichiers, approuvée par CISC et ggerganov. Elle utilise la mise à l'échelle adaptative de l'activation des experts de #30861 comme contournement, et la PR signale un ralentissement de 10 à 30 % dû à cette mise à l'échelle automatique, à traiter dans des PR ultérieures (non mesuré par nous). La PR indique que Codex a largement aidé à l'implémentation. - PR #30929 "jinja: support hexadecimal string escapes" (alexey-rsi, fusionnée le 2026-10-21T16:04:37Z, approuvée par CISC et danbev) est nécessaire au chat template.
- La release
b11803(publiée le 2026-10-21T22:30:59Z) est identique àa37cc461. b11804 et les suivantes la contiennent aussi.v0.7.0a 134 commits de retard.
Notre configuration
- Cartes sur notre cloud : RTX 5090 32 GB (pilote 595.91.07, 575 W), RTX 4090 24 GB (23 028 MiB utilisables, pilote 595.91.07, 450 W), et une première RTX 5090 (pilote 580.178.04, limite de puissance à 400 W) qui s'est révélée être une machine lente.
- Un manager InferenceKey local depuis
mainà5c08ab03, joint par les workers via des tunnels de développement. Production jamais touchée. - Env du worker :
INFERENCEKEY_LLAMACPP_TAG=flint-a37cc461,INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000,CMAKE_BUILD_PARALLEL_LEVEL,CUDACXX. - llama.cpp compilé à la main à
a37cc461dans le chemin d'installation du worker/opt/inferencekey/llamacpp-cuda/flint-a37cc461-cuda<arch>/. Le worker y a trouvébuild/bin/llama-serveret l'a réutilisé. Son tag par défaut estb9748, et il clone avecgit clone --branch <tag>, qui accepte un nom de tag ou de branche, pas un commit.
Déploiement pas à pas
-
Clonez le SDK et ouvrez examples/flint-coding-agent-llamacpp-private-nvidia (
main.py,README.md,.env.example,requirements.txt, commit1654d272). -
Copiez
.env.examplevers.env, remplissez-le et exportez les variables dans votre shell (main.pyles lit dans l'environnement et ne charge pas.envlui-même) :INFERENCEKEY_SDK_TOKEN=... INFERENCEKEY_API_KEY=... INFERENCEKEY_PROJECT=... IK_WORKER_ID=... # private NVIDIA worker, 32 GB or more for the 64K default # optional INFERENCEKEY_BASE_URL=... IK_KEEP_ALIVE=1 # keep the deployment after the run -
Sur le worker, configurez une version de llama.cpp qui contient Flint, et laissez du temps à la première compilation :
INFERENCEKEY_LLAMACPP_TAG=b11803          # or newer; we used a hand build at a37cc461
INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000
CMAKE_BUILD_PARALLEL_LEVEL=<cores>
# Blackwell needs the CUDA toolkit with nvcc 12.8 or newer
Le README de l'exemple demande un tag qui contient
a37cc461, oumaster. Sa note selon laquelle aucun tag de release ne contenait la PR au moment de notre test est dépassée :b11803correspond au commit de fusion. Nous n'avons pas fait tourner le worker avecb11803lui-même. -
Installez et lancez. Le SDK n'est pas encore sur PyPI (la ligne
inferencekeyderequirements.txtest commentée), donc compilez-le d'abord en local, comme le décrivent le README de l'exemple et../CONTRIBUTING.md:python -m venv .venv && . .venv/bin/activate pip install maturin ( cd ../../bindings/python && maturin develop --release ) pip install -r requirements.txt set -a; . ./.env; set +a python main.pymain.pyappelleensure()avecBackend.LLAMACPP, attend jusqu'à 3 600 s que le déploiement soit prêt, demande une fonctionmerge_intervals, lance la boucle d'agent de code aveclist_files,read_file,write_fileetrun_testsconfinés à un répertoire temporaire, écritoutputs/answers.json, et supprime le déploiement sauf siIK_KEEP_ALIVE=1. -
La commande qu'il déploie :
llama-server -hf RecursiveSI/flint-nvfp4-gguf --hf-file flint-nvfp4.gguf --alias flint \
  -ngl all -c 65536 -np 1 -fa on -ctk f16 -ctv f16 --jinja \
  --temp 1 --top-p 0.95 --top-k 20 --min-p 0
La commande est codée en dur dans
main.py(ligne 58), et aucune variable d'environnement ni aucun flag ne la modifie. Pour un worker de 24 GB, remplacez-y-c 65536par-c 16384. Laissez--swa-fullnon défini, comme le dit la fiche du modèle.
Temps jusqu'à prêt
| Étape | RTX 5090 | RTX 4090 |
|---|---|---|
| Compilation CUDA de llama.cpp, machine neuve | 7 min 13 s (-j 46) | 6 min 26 s |
ensure() jusqu'à prêt, à froid | 129,5 s (téléchargement environ 114 s à environ 200 MB/s, chargement environ 6 s) | 126,9 s (téléchargement environ 113 s, chargement 5,3 s) |
| Redémarrage à chaud (binaire compilé, poids en cache) | 13,5 s (chargement 4,6 s) ; paliers de l'échelle sur la 5090 lente de 13,8 à 14,8 s | non mesuré |
Vitesse
| Machine et configuration | Décodage, par requête | llama-bench | Prefill |
|---|---|---|---|
RTX 5090, 64K, build native 120a | 194 à 216 tok/s (sorties longues environ 210) | tg128 239,8, pp512 6 217 | 7 352 tok/s à 17 557 tokens |
RTX 5090, build PTX (89-virtual) | tg128 216,1, pp512 6 495 | ||
| RTX 4090, 16K | 154 à 170 tok/s (environ 167) | tg128 181,2, pp512 5 658 | 6 230 tok/s à 8 807 tokens |
| RTX 5090 lente, 64K, 32K, 16K | 26,6 à 28,4 tok/s | tg128 28,8 (NVFP4), 29,3 (Q4_1), pp512 2 593 | 2 726 tok/s à 17 557 tokens |
Le CMake de llama.cpp choisit de lui-même CMAKE_CUDA_ARCHITECTURES=120a sur Blackwell, et la build native était environ 11 % plus rapide que le JIT PTX. NVFP4 a aussi tourné sur Ada (sm_89, la 4090). Sur la 5090, une réponse de code de 374 tokens a pris 3,0 s.
Estimation du KV : 14 couches à attention complète x 4 têtes KV x 128 x 2 (K et V) x 2 octets = 28 672 octets par token, environ 0,9 GiB à 32K et 1,75 GiB à 64K.
Échelle VRAM complète
| Cible | Configuration | VRAM max (llama-server) | Vitesse | Sortie correcte | Vraie carte |
|---|---|---|---|---|---|
| RTX 5090 32 GB | NVFP4, -c 65536, KV F16, -ngl all | 23 872 MiB | environ 210 tok/s, agent 5,9 s | oui | oui |
| RTX 5090 32 GB (machine lente) | NVFP4, -c 32768 | 22 922 MiB | 27,3 tok/s | oui | oui |
| RTX 5090 32 GB (machine lente) | NVFP4, -c 16384 | 22 458 MiB | 27,5 tok/s | oui | oui |
| RTX 4090 24 GB | NVFP4, -c 16384, KV F16, -ngl all | 22 316 MiB sur 23 028 | environ 167 tok/s, agent 5,7 et 6,3 s | oui | oui |
| RTX 4090 24 GB | NVFP4, -c 32768 | OOM au chargement | cudaMalloc failed: out of memory | non | oui |
| Plafond d'environ 16 GB (5090 lente) | NVFP4, -c 32768, --n-cpu-moe 18 | 16 116 MiB | 4,57 tok/s, requête de 111 s | oui, trop lent | émulée |
| Plafond d'environ 15 GB (5090 lente) | NVFP4, -c 32768, --n-cpu-moe 22 -t 12 | 14 388 MiB | environ 5,9 tok/s, 503 après 120 s, deux fois | non | émulée |
L'échec de la 4090 à 32K :
ggml_backend_cuda_buffer_type_alloc_buffer: allocating 87.50 MiB on device 0: cudaMalloc failed: out of memory
failed to allocate buffer for kv cache
Le SDK a ensuite levé failed to become ready: bootstrap step failed.
Non essayé : cartes de 12 GB, RTX 3090 (pas de stock au moment de l'essai), la 5090 au-delà de 64K, toute carte de 48 GB, le contexte complet de 262K, une concurrence supérieure à -np 1.
Qualité (nos prompts, pas un benchmark)
- Boucle d'agent de code : 7 essais sur 7 sur 3 machines ont corrigé le bug, toujours en 5 tours, de 559 à 654 tokens, sans jamais toucher aux tests.
- JSON des appels d'outils valide à chaque fois, avec des appels parallèles. Dans un banc d'outils séparé, notre
read_filefactice renvoyait le même texte pour chaque chemin (notre bug). Le modèle l'a remarqué ("suspiciously identical") et a continué à chercher pendant 6 tours au lieu de répondre. merge_intervals: correct avec trois asserts dans 5 essais.- Un décalage d'une unité glissé exprès dans une fonction
chunks: trouvé 3 fois sur 3. - Chaîne cachée
FLINT-4471-NVFP4: trouvée 3 fois sur 3 à 8,8K et 17,5K tokens. Question annexe d'arithmétique juste 2 fois sur 3 (helper_175(2)a répondu 171, la bonne réponse est 113).
Vidéo de démo
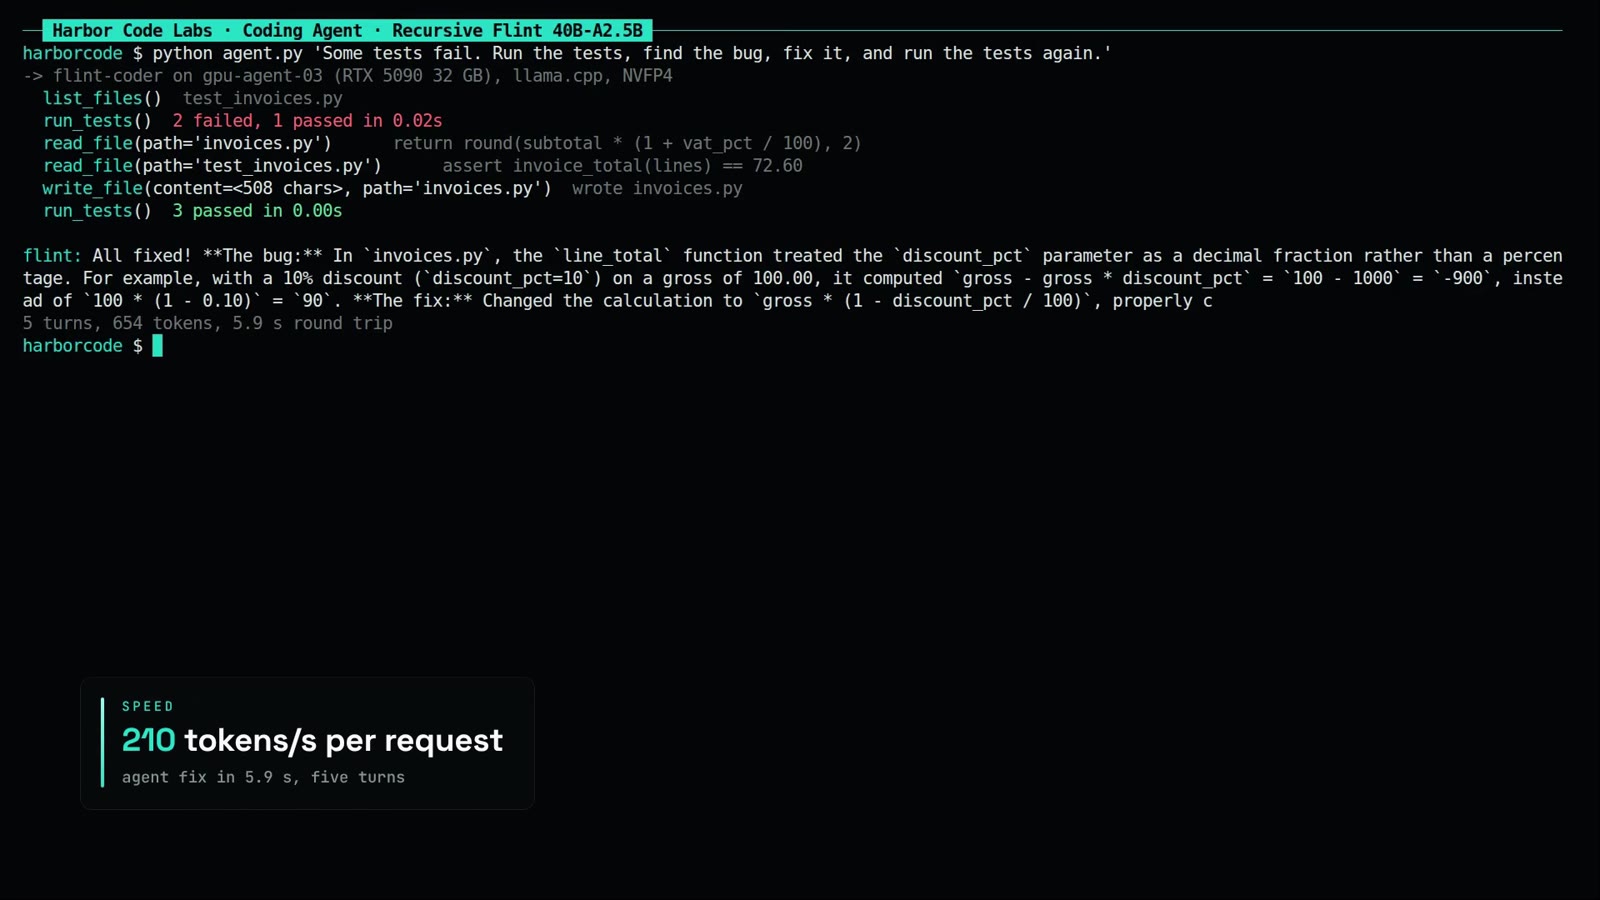
72,9 s, 1080p, narrée, enregistrée sur la 5090 saine : le workload dans le panneau, le module bogué, la boucle d'agent (5 tours, 654 tokens, 5,9 s, 3 tests au vert). Une prise antérieure sur la 5090 lente a été remplacée.
Problèmes restants et statut
- Version de llama.cpp. Flint a besoin de
b11803ou plus récent, et le worker prend un tag, pas un commit. Statut : résolu en amont, ouvert de notre côté (valeur par défaut du workerb9748et README pas encore mis à jour), non testé par nous avec le tag. Le README de notre SDK demande un tag contenanta37cc461oumaster; sa note selon laquelle aucun tag de release n'existait est dépassée, et y nommerb11803reste à faire. - Machine lente. Une RTX 5090 décodait à 27 à 29 tok/s avec le même fichier et le même commit, et aussi avec Q4_1.
nvidia-smi dmonmontrait SM 100 %, mémoire de 0 à 6 %, 399 W pour sa limite de 400 W. Une seconde 5090 tournait 8,3 fois plus vite dans llama-bench (tg128 239,8 contre 28,8). Cause racine non isolée (la limite de puissance et le pilote 580.178 sont les différences visibles). La plateforme la signalait comme saine, et rien ne vérifie les performances du GPU au bootstrap. Statut : ouvert. - Mémoire utilisable de 24 GB. La 4090 expose 23 028 MiB. À 16K, llama-server utilisait 22 316 MiB ; passer de 16K à 32K a ajouté 464 MiB sur la 5090 lente (de 22 458 à 22 922), et le pilote garde de la mémoire hors du processus (une 5090 au repos affichait 1 039 MiB utilisés), donc NVFP4 avec 32K de contexte ne tient pas. Statut : une limite, utilisez 16K.
- Timeout synchrone. Le timeout synchrone de 120 s de l'endpoint renvoie 503 pour les configurations lentes comme le déchargement des experts sur CPU. Statut : ouvert.
- Compilation à la main. La cible
llama-serveréchoue àllama-ui-assetssi les 8 fichiers stub de l'UI n'existent pas tous (le worker les crée). Statut : n'affecte que les compilations à la main. - Raisonnement dans
content. Avec cette build et ce template via notre endpoint, le texte de raisonnement arrive danscontentetreasoning_contentest absent. Les tokens de raisonnement comptent dansusage.completion_tokenset dansmax_tokens(l'exemple utilise 16 384). Les configurations client de Recursive utilisent un budget de génération de 65 536 tokens et demandent de conserverreasoning_contentlorsqu'on rejoue l'historique. Statut : ouvert.
Limites
Une requête à la fois, sept essais d'agent, nos propres prompts. Échantillonnage à température 1,0, top-p 0,95, top-k 20, comme le recommande Recursive. Les benchmarks sont ceux annoncés par l'éditeur. Les paliers émulés ont tourné sur la machine lente. Aucune vraie carte de 16 GB ou de 12 GB n'a été testée.
Crédits
Recursive (modèle, fichiers NVFP4 et INT4, kit SGLang, rec). alexey-rsi (PR llama.cpp #30928 et #30929). CISC et ggerganov (ont approuvé #30928). CISC et danbev (ont approuvé #30929). ggerganov (#30861, la mise à l'échelle MoE par expert qu'utilise le support de Flint). Notre part : le déploiement sur InferenceKey, l'exemple du SDK, les mesures et la vidéo.
Sources
- Fiche du modèle RecursiveSI/flint, avec son
config.jsonet sonsglang/README.md - RecursiveSI/flint-nvfp4-gguf
- RecursiveSI/flint-int4-gguf
- RecursiveSI/flint-int4
- llama.cpp PR #30928
- llama.cpp PR #30929
- recursive-oss/rec
- Exemple du SDK InferenceKey
- Où nous l'avons repéré : fil r/LocalLLaMA