Ming-Image Design est un modèle 6B qui a culminé à 64 GiB, et la transparence a marché dans une variante de prompt sur six
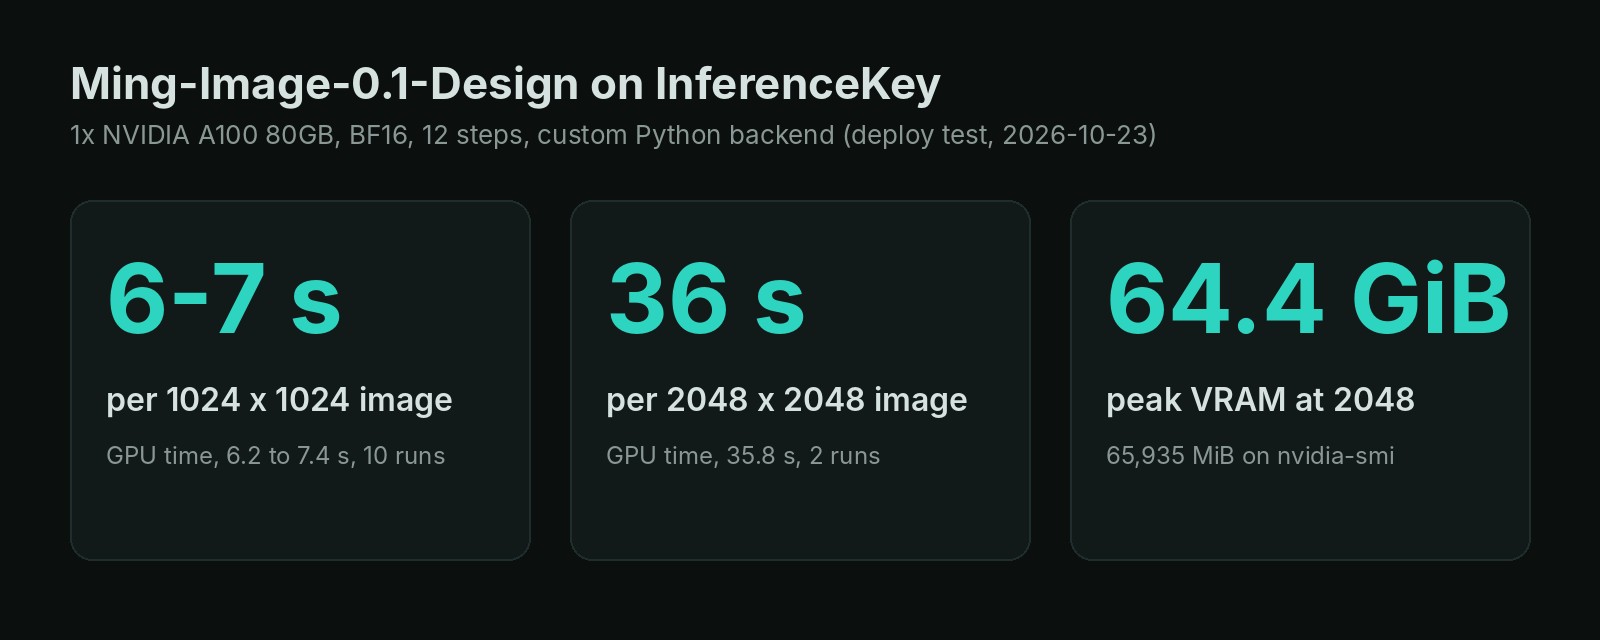
Ming-Image-0.1-Design sur une A100 de 80 GB : 6 à 7 s par image en 1024, 36 s en 2048, pic de 64,4 GiB, un PNG transparent sur six variantes.
"Un modèle text-to-image de 6B pour les interfaces, les infographies, les affiches et d'autres visuels riches en texte", dit la fiche du modèle Ming-Image-0.1-Design. Le dépôt pèse 53 GB. Sur une NVIDIA A100 de 80 GB, il a rempli 64,4 des 80 GiB de mémoire de la carte. C'est le premier constat : avec tout le modèle sur la carte, c'est un travail pour une carte de 80 GB, pas pour la carte de 12 GB que laisse imaginer le chiffre de 6B. Sur cette carte, il a fait un écran d'application en 1024 x 1024 en 6 à 7 secondes et une affiche en 2048 x 2048 en 36. Le second constat concerne son numéro fétiche, les PNG à fond transparent. Sur six variantes de prompt essayées, une seule est revenue transparente, et seulement avec la phrase déclencheuse des auteurs seule sur la première ligne. Le modèle et son code sont sous licence MIT, vous pouvez donc livrer ce qu'il produit.
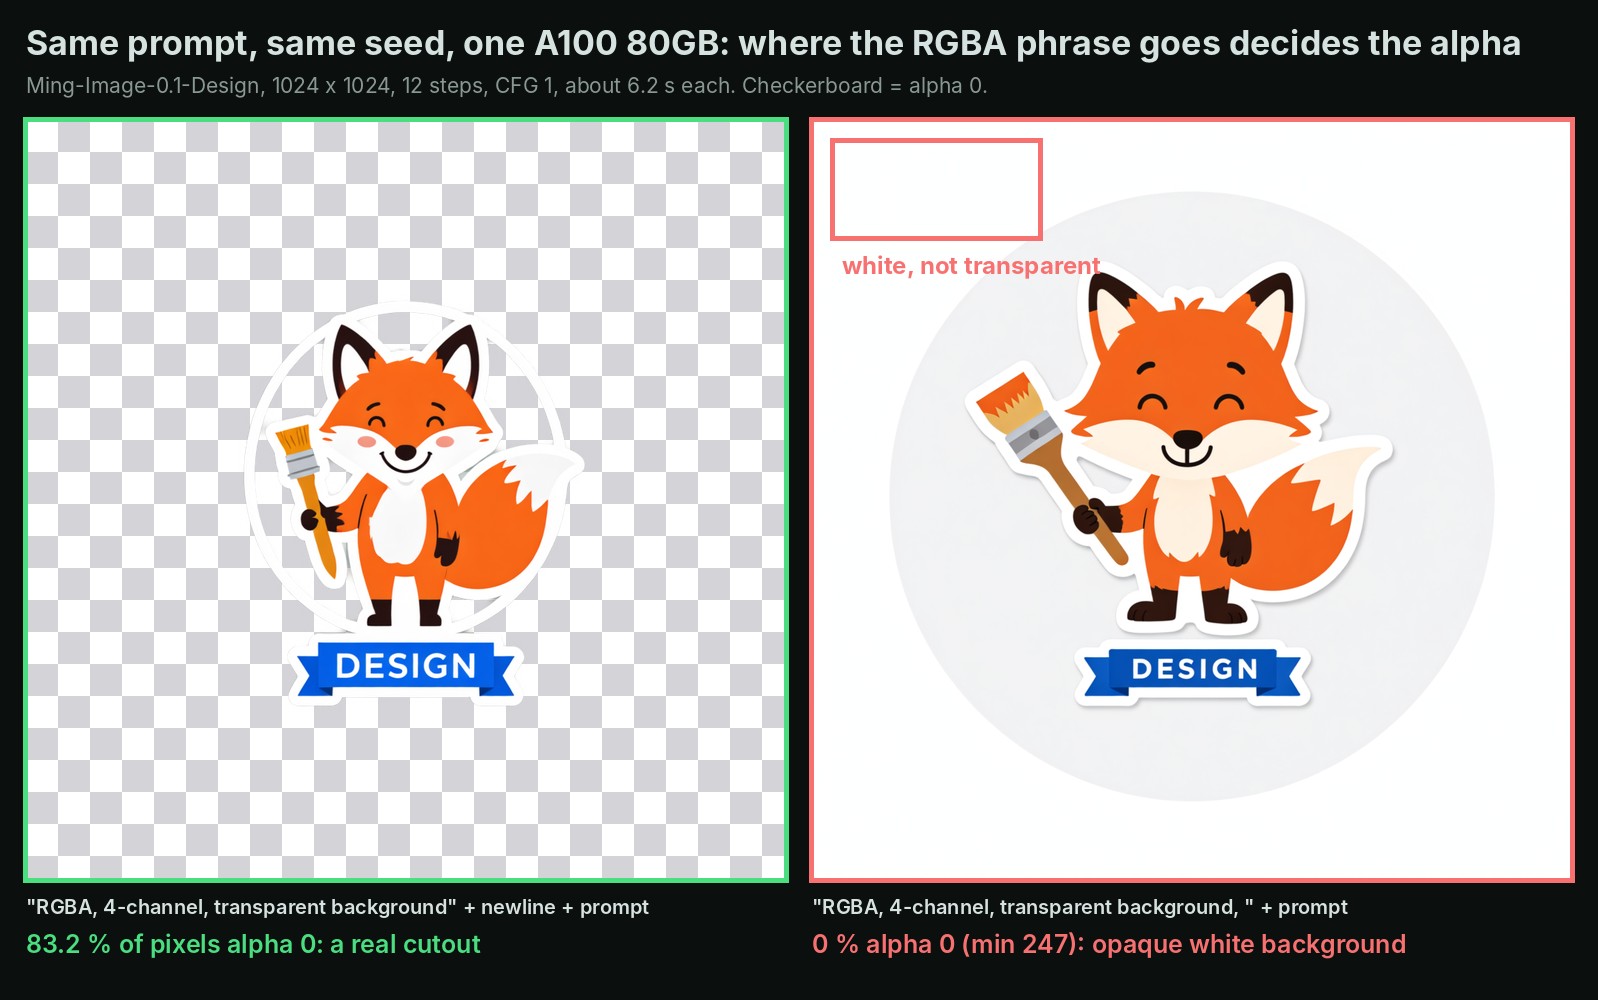
Même prompt, même départ aléatoire : le retour à la ligne est la seule différence. Le damier marque les pixels entièrement transparents.
Le 6B, c'est le chanteur, et le camion transporte 41 GB de plus
Ming-Image-0.1-Design est annoncé comme une affiche de concert qui ne nomme que le chanteur. Le camion doit quand même transporter la batterie, les amplis et le bassiste. Le chanteur, ici, c'est la partie qui dessine : un modèle de 6 milliards de paramètres qui transforme du bruit en image en quelques passages, 12,3 GB sur disque. Derrière lui, il y a un modèle de langage de 34 GB qui lit votre prompt. Un connecteur de 6,2 GB transmet ce qu'il a compris au modèle de dessin. Un petit décodeur, 0,25 GB, transforme le résultat en pixels avec une quatrième couche pour la transparence. Au total, 52,9 GB.
Leur README sur GitHub le dit clairement : le déploiement minimal validé, c'est "one GPU with at least 80 GiB of memory". Le nombre de paramètres, lui, est ce qui a été répété.
Nous l'avons répété aussi. Nous avons repéré le modèle dans la vidéo d'actualités d'AI Search du 27 septembre. Elle décrit le modèle de base comme "12 gigabytes in size" et dit qu'il "should be able to fit on most mid-to-high-end GPUs". Notre propre catalogue de modèles a recopié ces 12 GB. C'est le chanteur seul. Nous voulions le vrai chiffre, donc nous l'avons fait tourner.
Ce qui rend le modèle intéressant malgré tout, c'est ce pour quoi il est fait. inclusionAI l'a entraîné pour le design chargé en texte : écrans d'application, tableaux de bord, infographies, affiches, slides. Il est censé placer vos mots là où un designer les mettrait. Chaque image revient en PNG avec un canal alpha, la couche qui dit à quel point chaque pixel est transparent. Un logo ou un autocollant peut donc atterrir sur une slide sans cadre blanc autour. Le modèle a été mis en ligne sur Hugging Face le 17 septembre et mis à jour pour la dernière fois le 14 octobre.
Le test : une A100 de 80 GB, 15 images, un essai chacune
C'est une vérification de comportement, pas un benchmark de qualité : un essai par prompt, avec nos propres prompts. Nous avons gardé la configuration validée par les auteurs : une NVIDIA A100 de 80 GB sur notre cloud, modèle non compressé, 12 passages par image. Nous l'avons servi via une copie de test d'InferenceKey construite depuis sa branche main actuelle, avec le code Python des auteurs en dessous. Nous n'avons pas appelé le service hébergé, considérez-le donc comme non testé là-bas.
Nous avons fait 15 images : sept mises en page et huit essais de transparence. Deux autres requêtes en 2048 ont échoué, pour une raison que nous expliquons plus loin.
Le modèle travaille à deux niveaux de résolution, 1024 et 2048. Demandez une autre taille et il dessine au niveau le plus proche puis redimensionne. Une slide en 1920 x 1080, par exemple, est dessinée en 1024.
Résultats : 6 à 7 secondes et moins d'un demi-centime par écran, 36 secondes et environ 2 centimes par affiche
En 1024 x 1024, la carte a passé 6,2 à 7,4 secondes par image sur 10 exécutions. En 2048 x 2048, elle a passé 35,8 secondes, deux fois. Quatre fois plus de pixels coûtent environ cinq fois plus de temps. Nous avons mesuré le script brut des auteurs, sans optimisation. vLLM-Omni annonce environ 2,2 s en 1024 sur deux H100 ; nous ne l'avons pas fait tourner.
| Taille | Temps de carte par image | De la requête à la réponse |
|---|---|---|
| 1024 x 1024 | 6.2 à 7.4 s | 7.0 à 8.9 s |
| 2048 x 2048 | 35.8 s | 41.5 à 44.0 s |
Une requête à la fois. "De la requête à la réponse" inclut le trajet via InferenceKey. Les chiffres complets, mémoire par taille comprise, sont en annexe.
Occupée sans arrêt, une carte fait environ 400 à 500 écrans par heure en 1024, ou 82 à 87 affiches en 2048. C'est une estimation à partir d'images isolées, pas d'une exécution soutenue. Une A100 de 80 GB se loue environ 1,4 à 1,8 dollar de l'heure. Votre facture revient à un quart ou un demi-centime par écran en 1024, et à environ 2 centimes par affiche en 2048.
La mémoire est le chiffre qui décide de votre carte. Chargé sur la carte, le modèle complet occupait 46,3 GiB avant toute image. Une image en 1024 a demandé 50,45 GiB au pic, et une en 2048 a poussé la carte à 64,4 GiB, ce qui laisse encore de la marge sur 80.
Le texte entre guillemets est sorti juste dans 5 mises en page sur 7, les mots que vous omettez sortent en charabia
Un texte court que vous écrivez entre guillemets est en général le texte que vous obtenez. Le texte que vous laissez au modèle est une décoration qui ressemble à des mots.
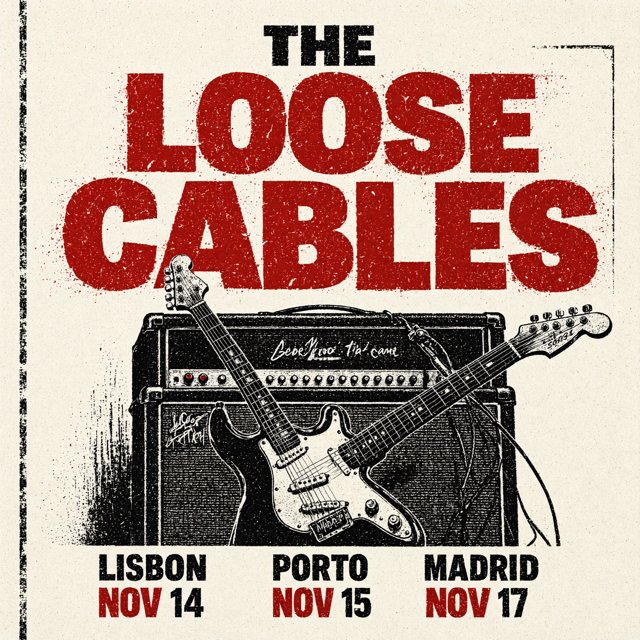
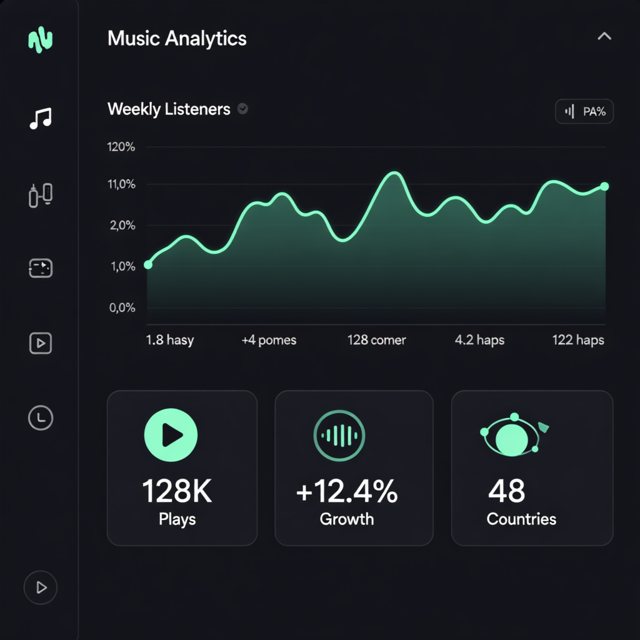
Chaque mot entre guillemets est juste. Les gribouillis sur l'ampli n'étaient pas dans le prompt.
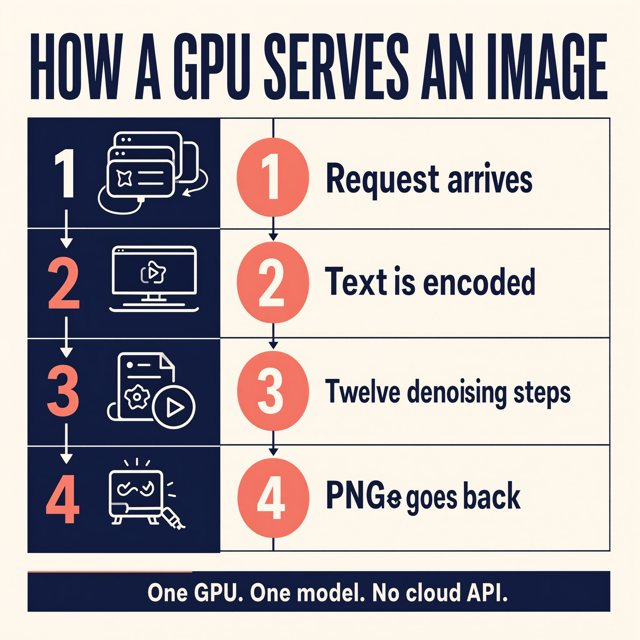
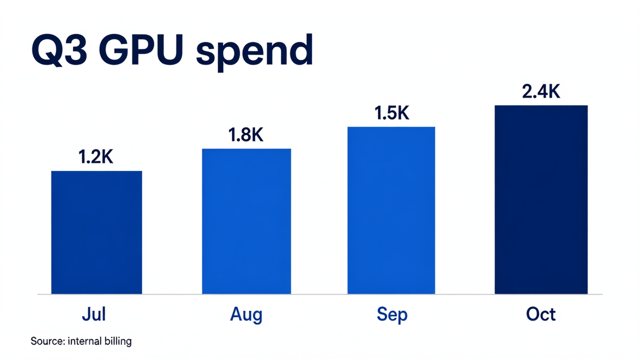
L'affiche de concert a eu juste le nom du groupe et les trois dates par ville. La slide, "Q3 GPU spend" avec quatre barres, leurs valeurs et les mois, est sortie avec chaque étiquette juste. Sur le tableau de bord, les trois cartes de stats que nous avions écrites en toutes lettres ("128K Plays", "+12.4% Growth", "48 Countries") étaient parfaites. Les axes et la légende du graphique, que nous n'avions pas précisés, se lisent comme un pseudo-texte convaincant. La landing page a fait pareil : titre, bouton et menu justes, sous-titre et cartes de fonctionnalités en charabia. Un écran d'accueil d'application a écrit "Grow Together" correctement. L'infographie était presque propre, avec un glyphe raté ("PNGe goes back") et des numéros d'étape dessinés deux fois.
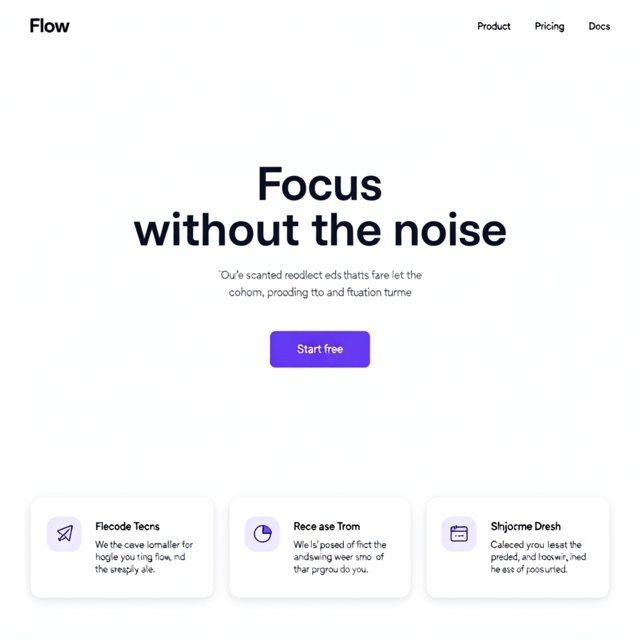
Les textes entre guillemets sont justes, tout le reste est un texte de remplissage qui a l'air vrai au premier coup d'œil.
C'est sur les longues listes qu'il a dérapé. Nous avons demandé un menu de café de 12 lignes avec les prix sur deux colonnes. Il a dessiné une seule colonne. Il a écrit "6.0l)" pour 6.00 et "1110.0" pour 11.00. Il a aussi ajouté une ligne de café que nous n'avions jamais demandée, "Bica 0.50".
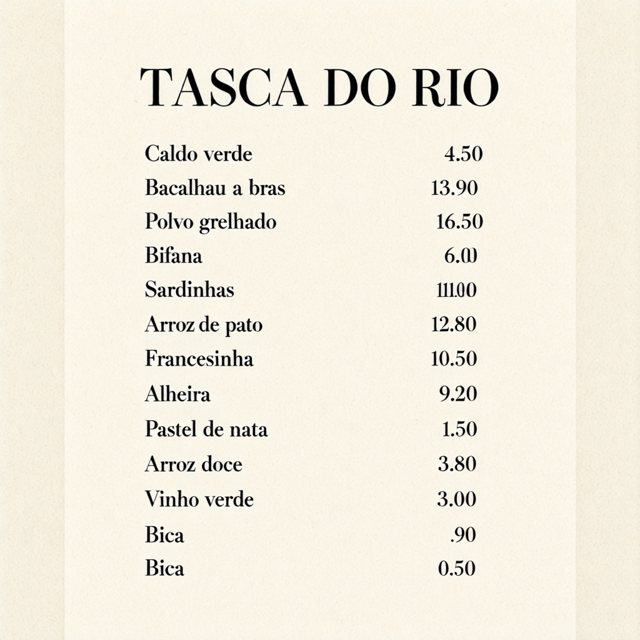
Deux prix faux et une ligne inventée.
Les auteurs recommandent de réécrire chaque prompt en une description structurée, façon Figma, avec un modèle de langage séparé avant qu'il n'arrive à Ming. Nous avons envoyé des prompts simples.
Transparence : une variante sur six, et seulement avec la phrase seule sur sa ligne
Une variante sur six est revenue transparente. Le retour à la ligne a compté sur une paire, mais il ne suffisait pas à lui seul.
Les auteurs publient dix phrases fixes et disent d'en mettre exactement une au début du prompt. Nous avons utilisé "RGBA, 4-channel, transparent background" seule sur la première ligne, puis la description de l'autocollant. Le renard est revenu avec 83,2 % de ses pixels entièrement transparents, un détourage propre. Il l'a fait deux fois : une fois avec notre propre prompt, une fois via l'option de transparence de notre serveur.
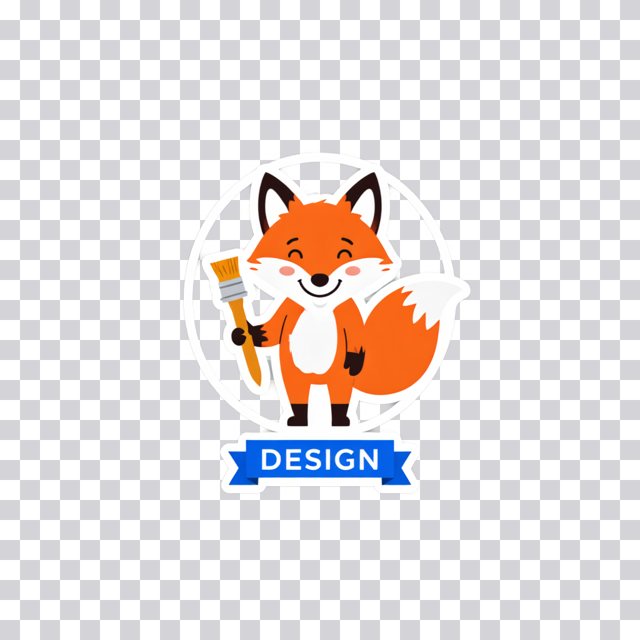
Avec une virgule après la phrase au lieu d'un retour à la ligne, le fond est revenu blanc uni, comme le montre l'image du début. Une icône d'application avec la même phrase seule sur sa ligne est revenue opaque. Trois autres combinaisons de phrase et de sujet aussi, toutes listées en annexe. Les prompts normaux renvoient quand même un PNG à quatre couches, surtout opaque, avec quelques pixels partiellement transparents.
Le code de notre serveur renvoie la part de pixels transparents avec chaque image, donc cette vérification tient en une ligne.
Quel GPU : une carte de 80 GB a marché, et rien de plus petit n'a été testé
La seule carte qui a marché est la seule que nous avons essayée, une vraie NVIDIA A100 de 80 GB, avec tout sur la carte. Les 80 GB sont donc l'exigence telle que les auteurs l'ont validée.
Nous avions prévu une seconde étape : plafonner la mémoire de l'A100 à 24 GB pour émuler une carte plus petite, avec le modèle de langage de 34 GB en attente dans la mémoire principale de l'ordinateur. Sur le papier, cela a du sens, parce que le modèle de langage ne travaille qu'une fois par prompt, au début. Changer le réglage n'a pas redémarré le modèle en cours, qui est resté entièrement sur la carte pendant sept minutes, donc l'étape n'a jamais tourné. Le bug de redémarrage est ouvert.
Sur InferenceKey : votre code d'images OpenAI peut appeler cette carte
Un programme qui demande déjà des images à OpenAI peut les demander à cette carte à la place, en changeant l'adresse, la clé et les réglages. Ming est livré comme un script Python, pas comme un serveur. Nous l'avons donc enveloppé dans un petit backend, du code qui charge un modèle une fois et répond aux requêtes. Le nôtre télécharge le code des auteurs à une version fixe et charge le modèle une fois avec leur chargeur. Ensuite, il appelle leur fonction de génération pour chaque requête.
Le premier démarrage a pris 157 secondes : environ 50 GB téléchargés en 69, chargés sur la carte en 23. Cette version a cassé à la première image, et nous n'avons pas chronométré un démarrage propre de la version corrigée. Un redémarrage après une mise à jour a pris 29 secondes.
Les versions exactes des bibliothèques des auteurs ne s'installent pas et ne tournent pas telles quelles sur Python 3.11 ; des versions un peu plus récentes règlent le problème, et l'exemple du SDK les embarque. Statut : corrigé dans l'exemple, ticket aux auteurs encore à ouvrir.
Un point rugueux sur lequel vous pourriez tomber vous aussi :
- Les grandes images peuvent être trop lourdes pour être renvoyées. Notre installation de test pouvait renvoyer au plus 8 MB par réponse. Deux images détaillées en 2048 sont sorties plus lourdes, ont été abandonnées, et l'appelant a attendu les 300 secondes complètes jusqu'à un timeout. Statut : le backend de l'exemple du SDK réduit maintenant le fichier jusqu'à ce qu'il passe, testé seulement sur des images enregistrées. La longue attente est ouverte.
Faut-il l'utiliser ? Oui pour du texte entre guillemets sur une carte de 80 GB, en vérifiant chaque détourage
- Si vous faites des maquettes d'application, des slides, des tableaux de bord ou des affiches avec un texte que vous pouvez écrire en toutes lettres, mettez chaque mot dont vous avez besoin entre guillemets.
- Si vous avez besoin de longues listes ou de chiffres exacts, comme un menu, une liste de prix ou un tableau, relisez chaque ligne.
- Si vous avez besoin d'éléments transparents, mettez la phrase seule sur sa ligne et vérifiez la couche alpha dans le code.
- Si votre carte a moins de 80 GB, prévoyez une carte de 80 GB pour l'instant.
- Si vous avez besoin d'une licence pour un produit, la MIT couvre l'usage commercial.
Pour faire un écran, une infographie et un autocollant sur votre machine NVIDIA, publiez le backend avec python publish.py et lancez IK_KEEP_ALIVE=1 python main.py depuis l'exemple du SDK. Il faut une carte de 80 GB dans un projet InferenceKey et environ 60 GB de disque.
Pour les ingénieurs
Modèle et fichiers
Fiche du modèle, GitHub (inclusionAI/Ming-Image), recette vLLM-Omni, Space de démo. Dépôt inclusionAI/Ming-Image-0.1-Design, créé le 2026-09-17T07:17:31Z, lastModified 2026-10-14T04:22:50Z, sha c57c49689d12ef7d4e24a170014f1dc43d3ce258, sans accès restreint, tag de licence mit, library_name: custom, 435 likes et 1 191 téléchargements le 2026-10-23. Les métadonnées safetensors de HF comptent 6 154 901 056 paramètres BF16, ce qui correspond au transformer seul.
| Composant | Ce que c'est | Taille |
|---|---|---|
mllm/ | BailingMM2 : Ling bailing_moe_v2, 20 couches, 256 experts, 8 actifs, hidden 2048, plus un ViT Qwen2.5 ; 7 shards | 34.018 GB |
transformer/ | DiffusionTransformer, dim 3840, 30 couches, 30 têtes ; 5 shards (le "6B") | 12.310 GB |
connector/ | Qwen2 1.5B en fp32 | 6.175 GB |
vae/ | AutoencoderKLQwenImage, 4 canaux d'entrée | 0.254 GB |
mlp/ | 0.125 GB | |
assets/ | 0.002 GB | |
| Total | 52.883 GB |
Scheduler FlowMatchEuler, shift 6. La recette vLLM-Omni décrit la même chose en Stage 0 (tour de vision Qwen2.5-VL plus le LM BailingMoeV2 de 20 couches, 256 tokens de requête d'image appris, états de requête plus états du VLM des couches 5, 12 et 20) et Stage 1 (le connecteur plus un DiT Z-Image de 30 couches avec un VAE RGBA Qwen-Image).
Il n'y a aucune logique RGBA côté prompt dans le code des auteurs : le VAE a 4 canaux et infer.py enregistre avec image.save en PNG, donc chaque image est RGBA et l'alpha dépend uniquement de ce que le modèle génère (processing_bailingmm2.py:165, infer.py:246-257).
Réglages
Fiche du modèle : 2048 x 2048 recommandé, 1024 x 1024 pour une génération plus rapide, 12 steps d'échantillonnage, CFG 1.0, BF16, "one CUDA GPU with 80 GiB VRAM (validated configuration)". Les niveaux text-to-image de infer.py sont (1024, 2048), 2048 par défaut, ratio d'aspect entre 1:4 et 4:1, niveau le plus proche selon sqrt(width*height). Valeurs par défaut : seed 42, bfloat16, attention eager, --num-gpus 1, --device-map balanced (le sharding multi-GPU du MLLM est pris en charge, nous ne l'avons pas essayé).
Les dix phrases de transparence (README, "Transparent-background generation tip") : en choisir exactement une et la mettre au début, sans les combiner. En anglais : RGBA, 4-channel, transparent background, isolated subject, alpha matte, no background, cutout PNG, alpha=0 outside the object, transparent canvas, not white, not checkerboard, production RGBA layer for compositing, plus cinq phrases en chinois.
Les auteurs recommandent un prompt JSON structuré façon Figma produit par un prompt enhancer (Ling-3.0-flash-VL ou qwen3.8-27B) exécuté en dehors de infer.py. Nous avons utilisé des prompts simples.
Les valeurs par défaut du testeur d'images du panneau (20 steps, guidance 4.5) ne sont pas les réglages de ce modèle : mettez 12 et 1.
Notre installation
Une NVIDIA A100-SXM4-80GB sur notre cloud (81 920 MiB, driver 595.71.05, limite de puissance 400 W, 32 vCPU, 125 GB de RAM dans le conteneur). La variante PCIe était en rupture de stock. Le worker a été amorcé par un manager InferenceKey local via des tunnels HTTP et TCP ; la production n'a jamais été touchée. Venv du backend : Python 3.11, torch 2.5.1, torchvision 0.20.1, transformers 4.57.1, diffusers 0.36.0, numpy 1.26.4, provisionné par uv. Code des auteurs au commit 3515cd7b1e3049fc517eed7d35020251cd06519a (2026-09-28), toujours le HEAD de main le 2026-10-23.
Déploiement pas à pas
L'exemple du SDK, commit 1e88edaa sur main (fichiers : README.md, backend.py, publish.py, main.py, requirements.txt, .env.example, .gitignore). Il vous faut un token SDK (INFERENCEKEY_SDK_TOKEN, control plane), une clé API (INFERENCEKEY_API_KEY, data plane), INFERENCEKEY_PROJECT, l'IK_WORKER_ID d'un worker NVIDIA privé (80 GB gardent tout le modèle sur le GPU) et, pour publish.py, en option INFERENCEKEY_TENANT_ID plus INFERENCEKEY_USER_TOKEN (ou téléversez dist/*.tar.gz dans le tableau de bord). Environ 53 GB de disque pour les poids plus un venv de 6 GB. Client en Python 3.9 ou plus récent ; le backend tourne en Python 3.11 provisionné par uv.
cp .env.example .env              # tokens, project, worker id
python publish.py                 # packages backend.py, registers "ming-image-design-text2image" (v0.1.4)
IK_KEEP_ALIVE=1 python main.py    # ensure(), wait_until_ready(), 3 pictures into ./outputs
main.py déploie le workload ming-image-design (tâche text2image, politique fixed, 1 réplique, config du workload ready_timeout_secs: 2400, request_timeout_secs: 900) et écrit outputs/ui-1024.png, outputs/infographic-2048.png et outputs/sticker-rgba-1024.png. Si le workload tourne déjà, appelez directement l'endpoint au lieu de relancer main.py (voir les problèmes).
Une requête d'autocollant transparent (nous avons appelé notre manager local ; le service hébergé accepte la même forme, mais nous ne l'avons pas appelé) :
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/ming-image-design/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "n": 1, "prompt": "A cartoon fox sticker holding a paintbrush above a ribbon that says \"DESIGN\"", "size": "1024x1024", "seed": 42, "steps": 12, "guidance_scale": 1.0, "background": "transparent", "output_format": "png"}'
background: "transparent" fait mettre au backend RGBA, 4-channel, transparent background seule sur la première ligne. La réponse est {data: [{b64_json}]} plus seconds (temps GPU), vram_peak_gib, bucket et transparent_fraction.
Backend
backend.py. Les backends prêts à l'emploi d'InferenceKey n'exécutent pas de scripts de modèle, d'où ce backend sur mesure. setup() télécharge le tarball du code de Ming-Image à 3515cd7b dans ~/.cache/ming-image-code/<sha>, lance snapshot_download de la révision c57c4968 (en sautant assets/), et charge BailingMM2NativeForConditionalGeneration.from_pretrained(..., torch_dtype=bf16, attn_implementation="eager", load_image_gen=True, device_map=<authors' 1-GPU plan>) plus le processor. process() lit prompt, size ou width/height, steps/num_inference_steps (12), guidance_scale (1.0), seed, background, output_format (png ou webp, les deux gardent l'alpha) et appelle le run_generation des auteurs. Les modes mémoire auto, gpu, lowvram (couches MoE du LLM sur CPU via le device map), minimal (aussi le connecteur et une partie du DiT sous cpu_offload d'accelerate, tiling du VAE) et le plafond MING_VRAM_LIMIT_GIB (torch.cuda.set_per_process_memory_fraction) sont écrits mais n'ont jamais tourné sur un GPU. Versions pendant le test : 0.1.0 (versions épinglées des auteurs), 0.1.1 (numpy 1.26.4), 0.1.2 (torch 2.5.1), 0.1.3 (phrase RGBA seule sur sa ligne, testée), 0.1.4 (baisse progressive de la qualité WebP pour les résultats de plus de 8 MB, commitée, testée hors ligne seulement).
Délai de disponibilité
- Démarrage à froid avec le paquet 0.1.0 : le SDK indique
ready after 157 s(venv neuf environ 60 s ; log du backenddownload 69.1s, load 23.4s, memory mode gpu (budget 78.3 GiB), weights in VRAM 46.3 GiB; environ 50 GB téléchargés, assets sautés, à environ 0,7 GB/s). Ce paquet a ensuite échoué à la première requête (bug torch ci-dessous). - Paquet 0.1.2, torch remplacé dans le venv existant : 6 min 46 s de
uv pip install, puisdownload 8.3s, load 21.6s. - Recyclage à chaud après la publication de 0.1.3 : 29 s (
download 4.6s, load 20.9s). - Un démarrage à froid propre avec le paquet final n'a pas été chronométré.
Mesures
Temps GPU mesuré dans le backend avec cuda.synchronize() ; aller-retour du client HTTP au manager local. 12 steps, CFG 1, une requête à la fois, attention eager, pas de flash-attn, pas de compilation, pas de cache de steps (une pile optimisée devrait être plus rapide ; non mesuré).
| Cas | Niveau | GPU s | Aller-retour s | Pic alloué torch GiB | Sortie |
|---|---|---|---|---|---|
| ui-1024 (premier appel) | 1024 | 7.397 | 14.73 | 50.45 | png |
| infographic-2048 | 2048 | 35.849 | 41.49 | 62.84 | png, 2.1 MB |
| autocollant, phrase + virgule | 1024 | 6.257 | 7.45 | 50.45 | png, opaque |
| fox-zh-nl / fox-en-nl / mug-cutout-nl / logo-zh2 | 1024 | 6.237 / 6.236 / 6.199 / 6.178 | 7.34 / 7.47 / 7.85 / 7.10 | 50.45 | png |
| tableau de bord | 1024 | 7.135 | 8.39 | 50.45 | png |
| poster-2048 | 2048 | 35.807 | 44.03 | 62.84 | WebP avec perte (PNG et WebP sans perte au-dessus du plafond) |
| logo, background transparent | 1024 | 6.232 | 7.11 | 50.45 | png, opaque |
| tasse, background transparent | 2048 | exécuté | 504 après 300.02 | n/a | résultat de 10.6 MB refusé |
| slide 1920x1080 | 1024 | 5.774 | 7.03 | 49.95 | png |
| menu | 1024 | 6.381 | 8.87 | 50.45 | png |
| menu | 2048 | exécuté | 504 après 300.02 | n/a | résultat de 15.5 MB refusé |
| autocollant, background transparent (phrase + retour à la ligne) | 1024 | 6.224 | 7.47 | 50.45 | png, 83.2 % alpha 0 |
| testeur du panneau, accueil plante | 1024 | n/a | 8 397 ms dans le panneau | n/a | png |
| testeur du panneau, renard avec virgule | 1024 | n/a | 7 292 ms dans le panneau | n/a | opaque |
Environ 2,2 à 2,4 it/s en 1024 et environ 2,8 s/step en 2048. Surcoût de la plateforme d'environ 0,8 à 2,5 s en 1024 (7,3 s au tout premier appel) et de 5,6 à 8,2 s en 2048 (payload plus gros). Mémoire de la carte via nvidia-smi toutes les secondes (2 736 échantillons) : au repos avec le modèle chargé 47 843 MiB, pic de 65 935 MiB à 06:11:33Z pendant l'infographie en 2048 ; torch a réservé jusqu'à 63,88 GiB ; pic de puissance de la carte 450,55 W pour une limite annoncée de 400 W.
Tests de transparence
Alpha vérifié avec PIL sur chaque PNG.
| Phrase et placement | Sujet | Résultat |
|---|---|---|
RGBA, 4-channel, transparent background + retour à la ligne | autocollant de renard | 83.17 % alpha 0 (deux fois : prompt brut, et option background du backend) |
même phrase + , sur la même ligne | autocollant de renard | opaque, alpha min 247 |
带透明通道,4通道RGBA图像 + retour à la ligne | autocollant de renard | opaque |
透明背景,alpha通道,无底图 + espace | icône d'application | opaque |
cutout PNG, alpha=0 outside the object + retour à la ligne | tasse | opaque |
RGBA, 4-channel, transparent background + retour à la ligne (v0.1.3) | icône d'application | opaque, alpha 253 à 255 |
Les prompts normaux renvoient du RGBA avec un alpha de 195 à 255. Une seed par prompt ; on ne sait pas si cela se généralise.
Échelle de VRAM
| Cible | Config | Pic | Temps par sortie | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| A100-SXM4-80GB (exécution principale) | gpu, BF16, tout résident, 12 steps, CFG 1 | 65 935 MiB carte (64.4 GiB) / 62.84 GiB torch en 2048 ; 50.45 GiB en 1024 | 35.8 s (2048), 6.2 à 7.4 s (1024) | oui | réel |
| plafond de 24 GB sur l'A100 | lowvram (couches MoE du LLM sur CPU), MING_VRAM_LIMIT_GIB=23 | n/a | n/a | non exécuté | émulé (prévu) |
L'échelon de 24 GB n'a pas tourné : ensure() avec seulement config.env modifié n'a pas recyclé le backend en cours (toujours memory mode gpu 7 minutes après 06:30:46Z), et l'échelon s'est arrêté là. Non essayés : plafonds de 48, 24 et 16 GB, toute vraie carte grand public, toute quantification. L'estimation lowvram (environ 18 GiB de poids plus 4 à 16 GiB d'activations) est une piste, pas un résultat.
Qualité, détails supplémentaires
Nos propres prompts, un échantillon chacun, chaque image lue à la main. Au-delà du récit : le titre de l'infographie, trois autres étiquettes d'étape et le pied de page étaient justes, et ses numéros d'étape apparaissent à la fois simples et entourés ; la note de bas de la slide "Source: internal billing" était juste.
Vidéo de démo
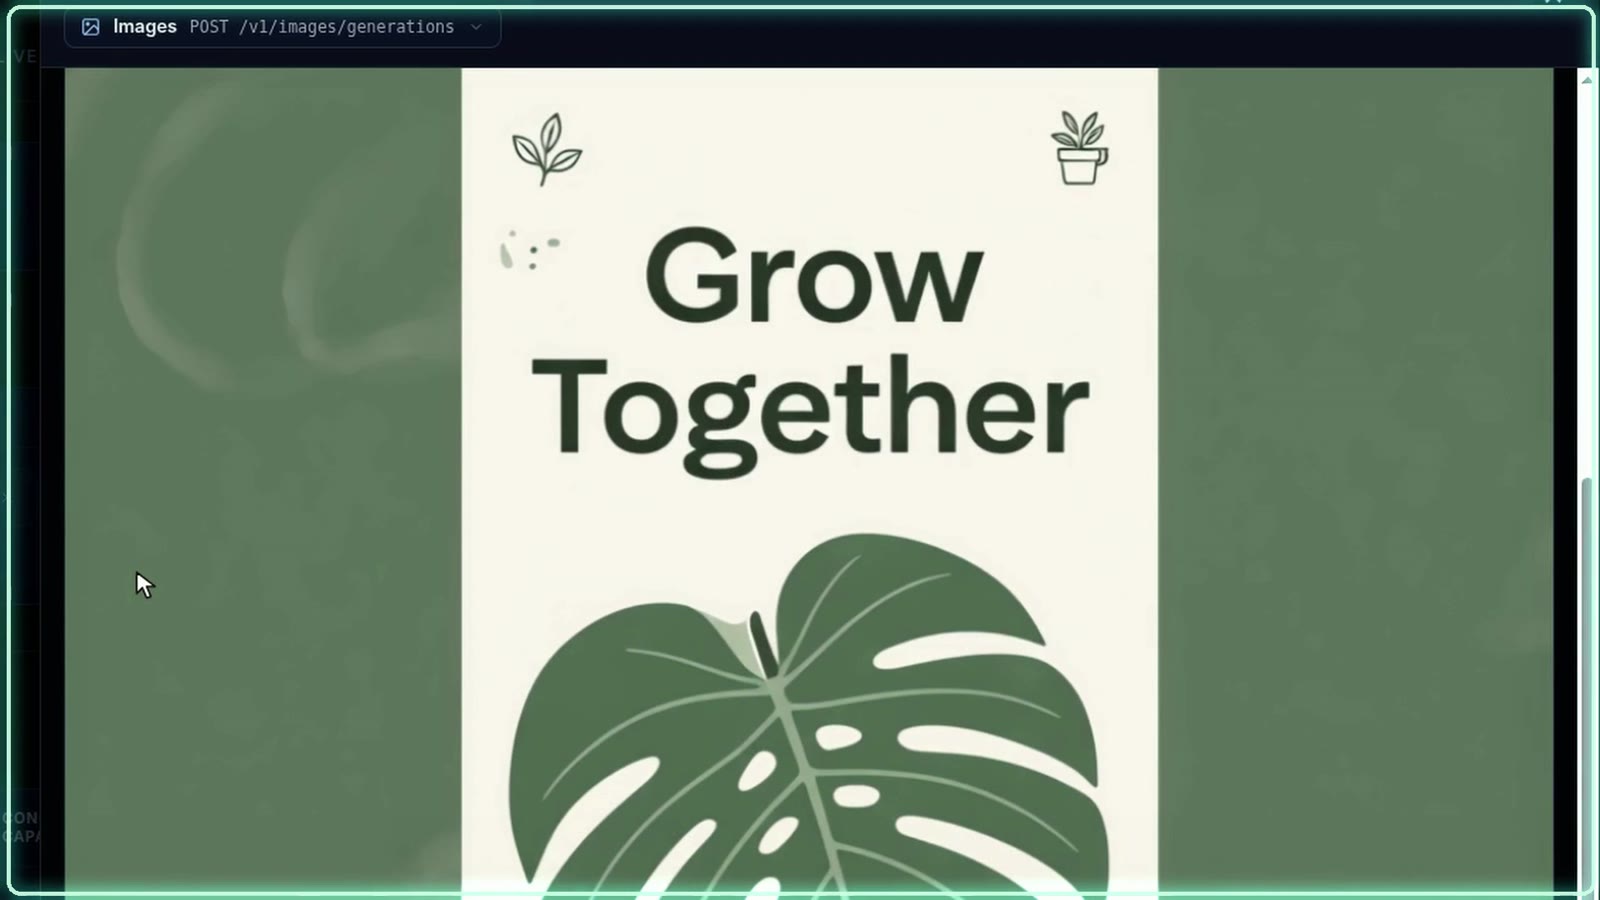
Cliquez pour lire le MP4 (104 s, narré). La vue Workloads montre Ming-Image-0.1-Design sur gpu-design-01 (1x NVIDIA A100-SXM4-80GB, Fixed, Healthy). Le testeur d'images, à 12 steps et guidance 1, fait l'écran d'accueil à la plante en 8 397 ms, puis l'autocollant de renard avec la phrase suivie d'une virgule en 7 292 ms, qui revient opaque. L'entreprise du panneau, Lumen Design Co, est un compte de démo inventé.
Problèmes restants et statut
- Les versions épinglées des auteurs ne tournent pas telles quelles.
numpy==1.23.1n'a pas de wheel CPython 3.11 (uva commencé à le compiler depuis les sources) ; corrigé avec numpy 1.26.4.torch==2.4.0avecdiffusers==0.36.0échoue à la première requête avecTypeError: scaled_dot_product_attention() got an unexpected keyword argument 'enable_gqa'(attention_dispatch.pyde diffusers ligne 1814, appelé depuisdiffusion/transformer.pyde Ming ligne 133) ; corrigé avec torch 2.5.1 et torchvision 0.20.1. Statut : corrigé dans l'exemple du SDK ; ticket sur inclusionAI/Ming-Image à ouvrir. - Remplacer torch dans un venv de backend existant a pris 6 min 46 s, parce que le worker a réutilisé le chemin du venv et lancé
uv pip installpar-dessus. Statut : ouvert. - Les résultats de plus de 8 MB sont abandonnés (des messages de 10 610 209 et 15 530 594 octets ont dépassé le
max_payloadde JetStream, 8 MB sur le conteneur NATS de notre pile de test ; la limite du service hébergé n'a pas été vérifiée) et le client attend 300,02 s pour un504 inference_timeout. Statut : le backend 0.1.4 baisse la qualité WebP par paliers (90, 82, 74, 66, 58, 50), testé hors ligne seulement ; la plateforme attend toujours le timeout complet, ouvert. - Relancer
ensure()+wait_until_ready()sur un workload déjà prêt a attendu 10 minutes sans aucun événement (worker :custom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel). Statut : ouvert ; appelez directement l'endpoint si le workload tourne. - Changer seulement
config.envavecensure()n'a pas recyclé le backend sur mesure en cours. Voir l'échelle de VRAM ci-dessus. Statut : ouvert. - Bruit de log sans conséquence : attributs de config inattendus sur
AutoencoderKLQwenImage(scaling_factor,shift_factor) et surDiffusionTransformer(siglip_feat_dim), et unRuntimeWarningde runpy.
Alternatives que nous n'avons pas testées
- vLLM-Omni.
vllm serve inclusionAI/Ming-Image-0.1-Design --omni --deploy-config vllm_omni/deploy/ming_image.yaml --port 8091,/v1/chat/completionscompatible OpenAI avecmodalities: ["image"]. Environnement : CUDA 13.0, vLLM 0.29.0, vLLM-Omni commit6daf5b30f, "2x H100 80GB (1xH100 to be validated)". Benchmark sur 2x H100 (1024, 12 steps, CFG 1, concurrence 1) : 2,219 s de bout en bout sans cache, 2,068 s avec TeaCache 0.30, 1,698 s avec Cache-DiT 0.16 (SSIM 0,853). Le tableau indique vLLM 0.30.0 alors que l'environnement dit 0.29.0. Notes : une requête à la fois, la première requête par forme paie la compilation et la capture des CUDA graphs, tailles divisibles par 16,negative_promptnon vide rejeté, les sorties gardent quatre canaux RGBA. Pas comparable à nos chiffres eager sur une seule A100. - Le Space de démo de hugging-apps. Gradio sur ZeroGPU (l'API indique
zero-a10g, le code demande la taillexlarge, donc le vrai GPU n'est pas vérifié), niveaux 1024 et 2048, steps de 4 à 24 (12 par défaut). Il réimplémente le pipeline à partir de la PR #8021 de vLLM-Omni au lieu d'appelerinfer.py, et lance le CFG dès queguidance_scale > 0, ce qui double le batch du DiT à 1.0. Ses notes qui disent que le dépôt GitHub renvoie 404 et que les phrases RGBA ne sont pas publiées sont périmées. Utile pour essayer des prompts avant de louer une carte : il montre les images, pas la vitesse. - Ming-Image-0.1-Design-Layer, l'amélioration de prompt, la concurrence, d'autres ratios d'aspect, le sharding multi-GPU.
Limites
15 images (13 par API, 2 depuis le panneau) plus 2 requêtes échouées, un échantillon par prompt, nos propres prompts, une seed. Un seul type de carte, une requête à la fois. Le rang au classement affiché dans la fiche du modèle et cité dans la vidéo d'AI Search n'a pas été vérifié par nous.
Crédits
inclusionAI a construit et publié Ming-Image-0.1-Design sous MIT, avec le code d'inférence et les phrases de transparence. Le modèle réutilise des éléments de la famille MoE Ling, l'encodeur de vision de Qwen2.5, un connecteur Qwen2, la conception du diffusion transformer de Z-Image (selon la recette vLLM-Omni) et le VAE de Qwen-Image. L'équipe vLLM-Omni a écrit la recette de service et son benchmark. hugging-apps a publié le Space de démo. AI Search est l'endroit où nous avons repéré le modèle. Notre part : le backend sur mesure, le déploiement sur InferenceKey, les corrections de dépendances et les mesures.
Sources
- Fiche du modèle inclusionAI/Ming-Image-0.1-Design et son API avec blobs
- inclusionAI/Ming-Image sur GitHub, requirements.txt
- Recette Ming-Image de vLLM-Omni
- hugging-apps/ming-image-0-1-design-demo
- Vidéo d'actualités d'AI Search, 2026-09-27, segment Ming Image à partir de 2:10
- Exemple du SDK, commit 1e88edaa