Ming-Image Design ist ein 6B-Modell mit 64 GiB Spitze, und Transparenz klappte in einer von sechs Prompt-Varianten
Ming-Image-0.1-Design auf einer A100 mit 80 GB: 6 bis 7 s pro 1024er-Bild, 36 s bei 2048, Spitze 64,4 GiB, ein transparentes PNG aus sechs Prompt-Varianten.
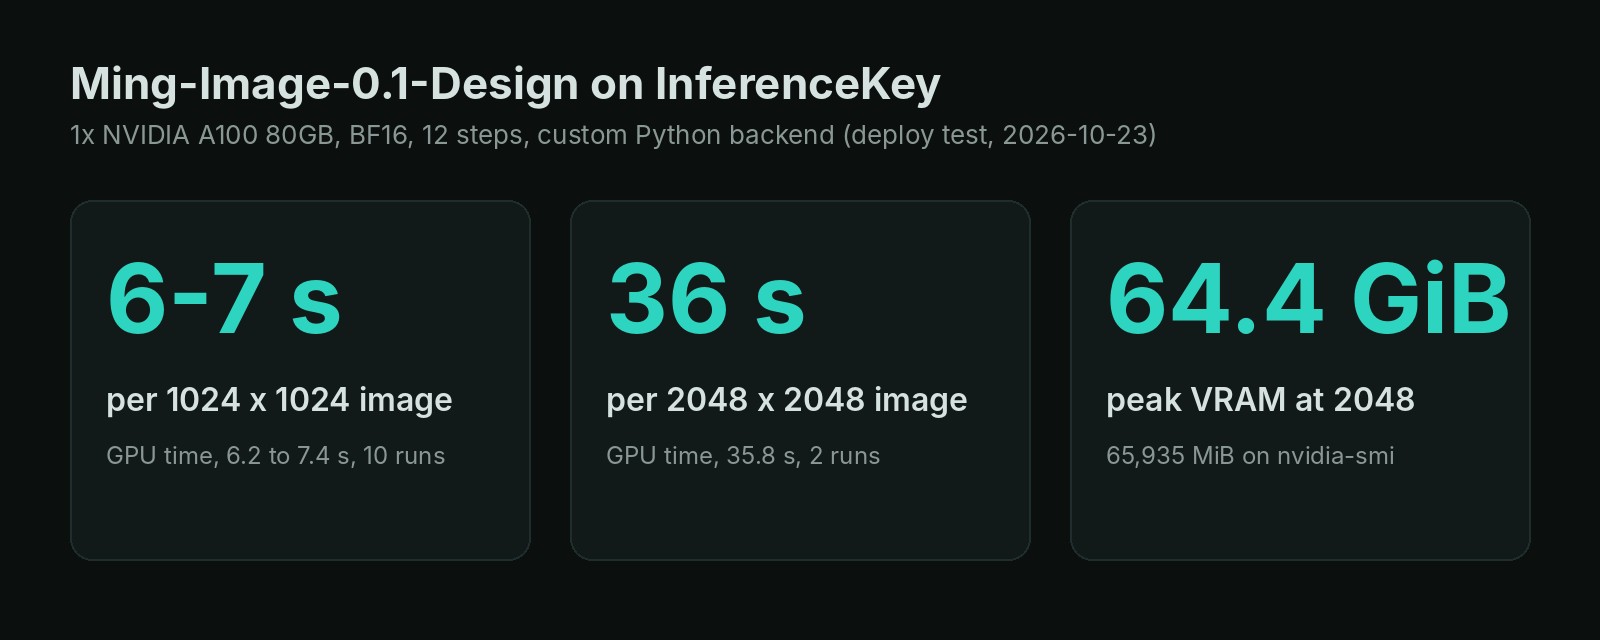
„A 6B text-to-image model for UI, infographics, posters, and other text-rich visual designs“, sagt die Model Card von Ming-Image-0.1-Design. Das Repo ist 53 GB groß. Auf einer NVIDIA A100 mit 80 GB belegte es 64,4 der 80 GiB Speicher der Karte. Das ist der erste Befund: Mit dem ganzen Modell auf der Karte ist das ein Job für eine 80-GB-Karte, nicht für die 12-GB-Karte, die die Angabe 6B nahelegt. Auf dieser Karte machte es einen App-Screen in 1024 x 1024 in 6 bis 7 Sekunden und ein Plakat in 2048 x 2048 in 36. Der zweite Befund betrifft sein Paradestück, PNGs mit transparentem Hintergrund. Von sechs Prompt-Varianten, die wir probiert haben, kam eine transparent zurück, und nur mit der Trigger-Phrase der Autoren allein in der ersten Zeile. Modell und Code stehen unter MIT-Lizenz, du darfst also ausliefern, was es erzeugt.
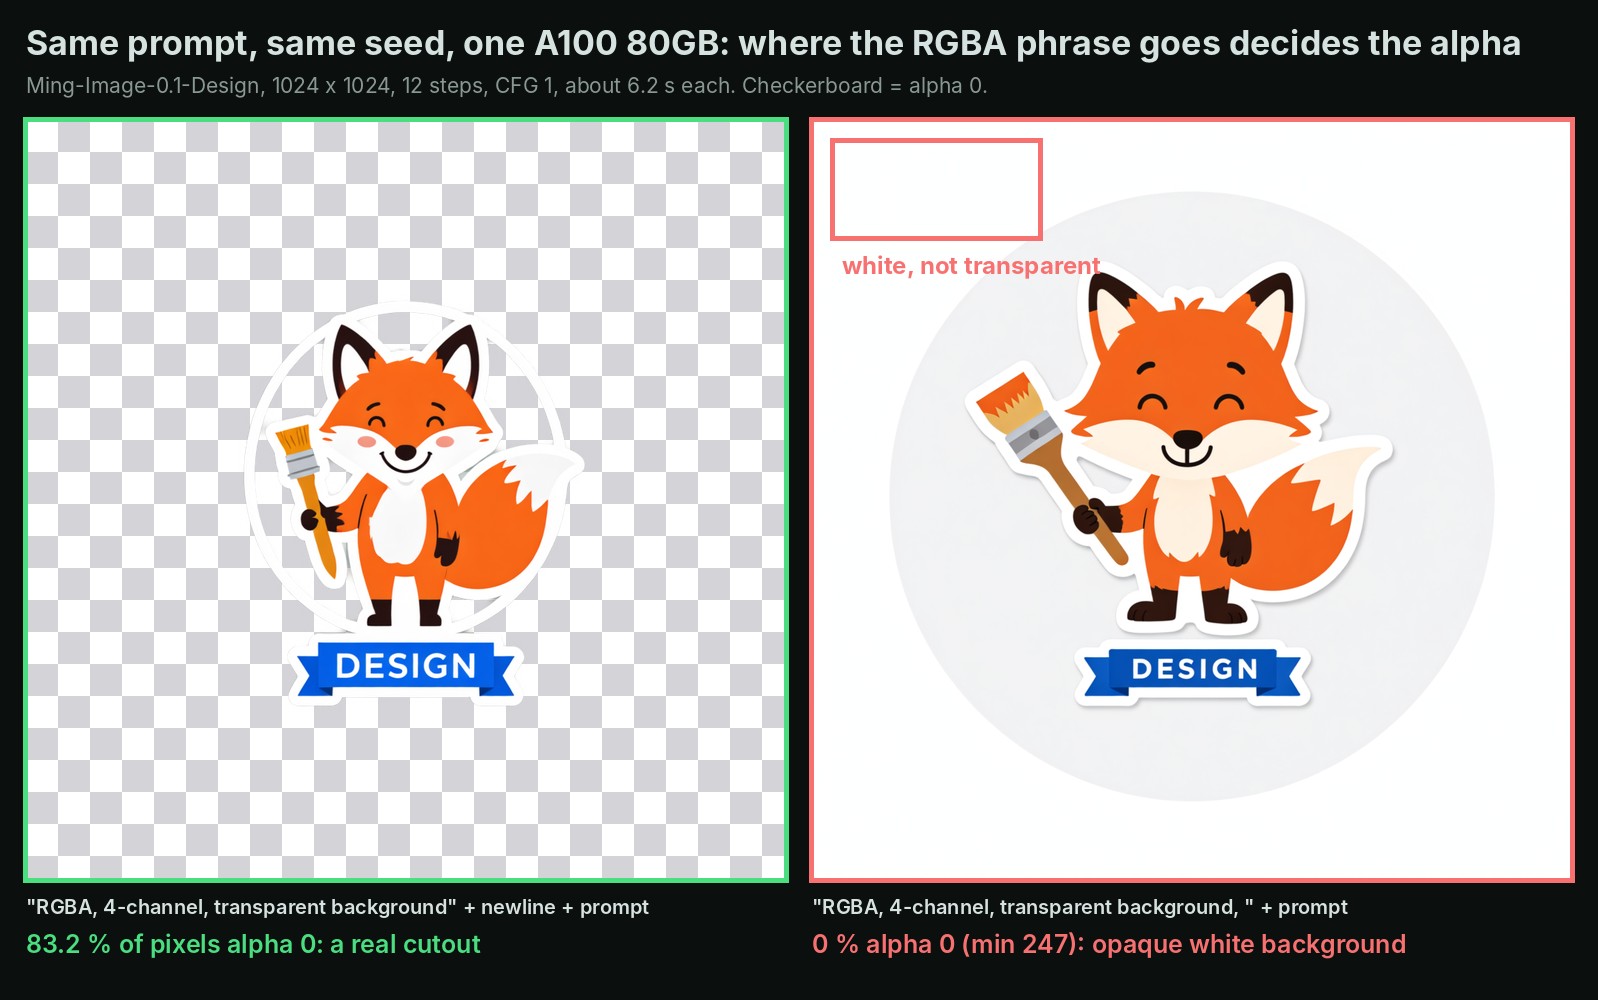
Gleicher Prompt, gleicher zufälliger Start: Der Zeilenumbruch ist der einzige Unterschied. Das Schachbrettmuster markiert voll transparente Pixel.
Die 6B sind der Sänger, und im Van liegen 41 GB mehr
Ming-Image-0.1-Design wird beworben wie ein Konzertplakat, das nur den Sänger nennt. Der Van muss trotzdem das Schlagzeug, die Verstärker und den Bassisten mitnehmen. Der Sänger ist hier der Teil, der die Leute zieht: ein Modell mit 6 Milliarden Parametern, das in ein paar Durchgängen aus Rauschen ein Bild macht, 12,3 GB auf der Platte. Dahinter sitzt ein Sprachmodell mit 34 GB, das deinen Prompt liest. Ein Connector mit 6,2 GB reicht weiter, was es verstanden hat, an das zeichnende Modell. Ein kleiner Decoder, 0,25 GB, macht aus dem Ergebnis Pixel, mit einer vierten Ebene für Transparenz. Alles zusammen: 52,9 GB.
Ihre GitHub-README sagt es klar: Das kleinste validierte Deployment ist „one GPU with at least 80 GiB of memory.“ Weitererzählt wurde die Parameterzahl.
Wir haben sie auch weitererzählt. Entdeckt haben wir das Modell im News-Video von AI Search vom 27. September. Dort heißt es, das Basismodell sei „12 gigabytes in size“ und „should be able to fit on most mid-to-high-end GPUs.“ Unser eigener Modellkatalog hat diese 12 GB übernommen. Das ist der Sänger allein. Wir wollten die echte Zahl, also haben wir es laufen lassen.
Was den Aufwand lohnt, ist das, wofür das Modell gebaut ist. inclusionAI hat es für textlastiges Design trainiert: App-Screens, Dashboards, Infografiken, Plakate, Folien. Es soll deine Wörter dorthin setzen, wo eine Designerin sie hinsetzen würde. Jedes Bild kommt als PNG mit Alphakanal zurück, der Ebene, die sagt, wie durchsichtig jedes Pixel ist. So landet ein Logo oder ein Sticker ohne weißen Kasten drumherum auf einer Folie. Das Modell erschien am 17. September auf Hugging Face und wurde zuletzt am 14. Oktober aktualisiert.
Der Test: eine A100 mit 80 GB, 15 Bilder, je ein Versuch
Das ist ein Verhaltenstest, kein Qualitäts-Benchmark: ein Versuch pro Prompt, unsere eigenen Prompts. Wir haben das validierte Setup der Autoren beibehalten: eine NVIDIA A100 mit 80 GB in unserer Cloud, unkomprimiertes Modell, 12 Durchgänge pro Bild. Bereitgestellt haben wir es über eine Testkopie von InferenceKey, gebaut aus dem aktuellen main-Branch, mit dem Python-Code der Autoren darunter. Den gehosteten Dienst haben wir nicht aufgerufen, dort gilt es also als ungetestet.
Wir haben 15 Bilder gemacht: sieben Layouts und acht Transparenzversuche. Zwei weitere Anfragen bei 2048 sind gescheitert, aus einem Grund, den wir weiter unten erklären.
Das Modell arbeitet auf zwei Auflösungsstufen, 1024 und 2048. Fragst du eine andere Größe an, zeichnet es auf der näheren Stufe und skaliert. Eine Folie in 1920 x 1080 wird zum Beispiel bei 1024 gezeichnet.
Ergebnisse: 6 bis 7 Sekunden und unter einem halben Cent pro Screen, 36 Sekunden und etwa 2 Cent pro Plakat
Bei 1024 x 1024 brauchte die Karte über 10 Läufe 6,2 bis 7,4 Sekunden pro Bild. Bei 2048 x 2048 waren es 35,8 Sekunden, zweimal. Viermal so viele Pixel kosten etwa fünfmal so viel Zeit. Gemessen haben wir das schlichte Skript der Autoren, ohne Tuning. vLLM-Omni meldet etwa 2,2 s bei 1024 auf zwei H100; das haben wir nicht laufen lassen.
| Größe | Kartenzeit pro Bild | Anfrage bis Antwort |
|---|---|---|
| 1024 x 1024 | 6.2 bis 7.4 s | 7.0 bis 8.9 s |
| 2048 x 2048 | 35.8 s | 41.5 bis 44.0 s |
Eine Anfrage nach der anderen. „Anfrage bis Antwort“ enthält den Weg durch InferenceKey. Alle Zahlen, auch der Speicher pro Größe, stehen im Anhang.
Ohne Pause ausgelastet macht eine Karte etwa 400 bis 500 Screens pro Stunde bei 1024 oder 82 bis 87 Plakate bei 2048. Das ist eine Schätzung aus Einzelbildern, kein Dauerlauf. Eine A100 mit 80 GB kostet zur Miete etwa 1,4 bis 1,8 Dollar pro Stunde. Deine Rechnung liegt damit bei einem Viertel bis einem halben Cent pro 1024er-Screen und bei etwa 2 Cent pro 2048er-Plakat.
Der Speicher ist die Zahl, die über deine Karte entscheidet. Auf die Karte geladen belegte das ganze Modell 46,3 GiB, bevor überhaupt ein Bild entstand. Ein Bild in 1024 brauchte an der Spitze 50,45 GiB, eines in 2048 trieb die Karte auf 64,4 GiB, was auf 80 noch Luft lässt.
Zitierter Text kam in 5 von 7 Layouts richtig, Wörter, die du weglässt, kommen als Kauderwelsch
Kurzer Text, den du in Anführungszeichen schreibst, ist meist auch der Text, den du bekommst. Text, den du dem Modell überlässt, ist Dekoration, die wie Wörter aussieht.
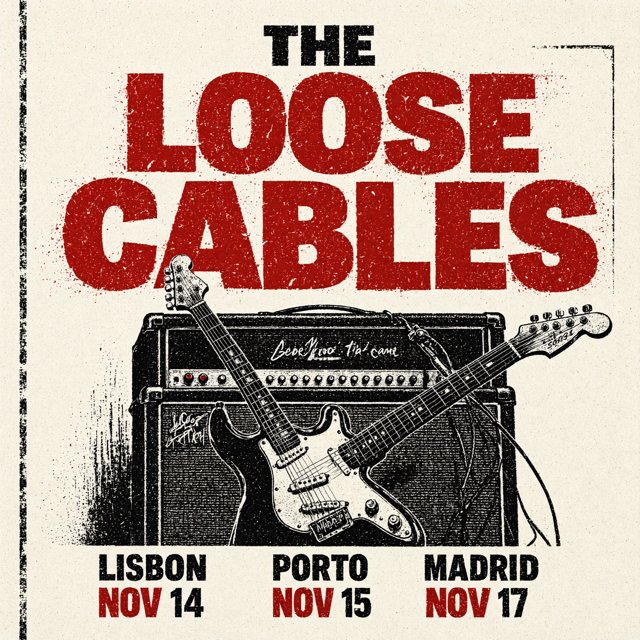
Jedes zitierte Wort richtig. Das Gekritzel auf dem Verstärker stand nicht im Prompt.
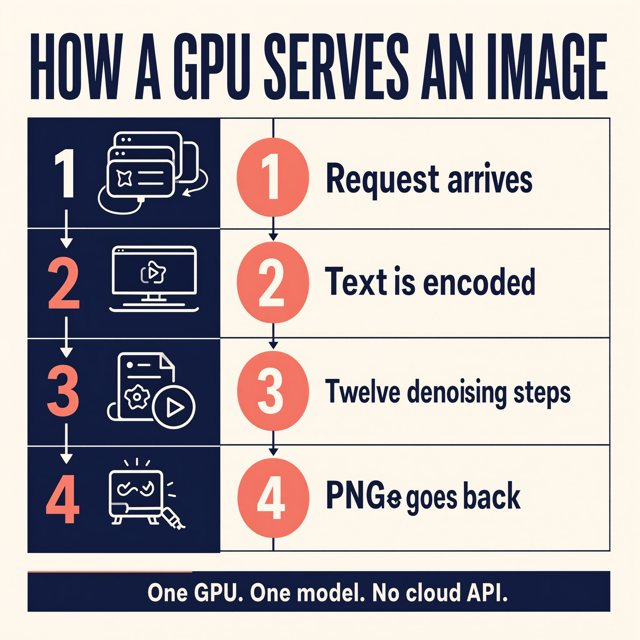
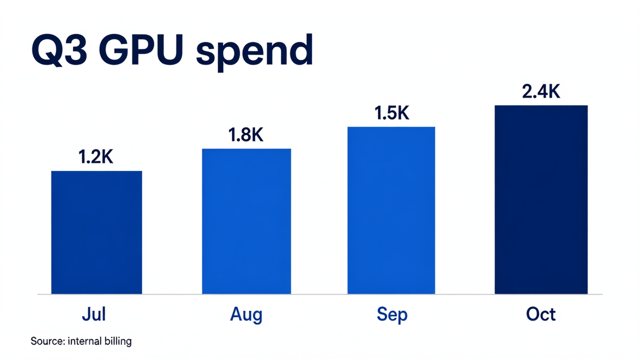
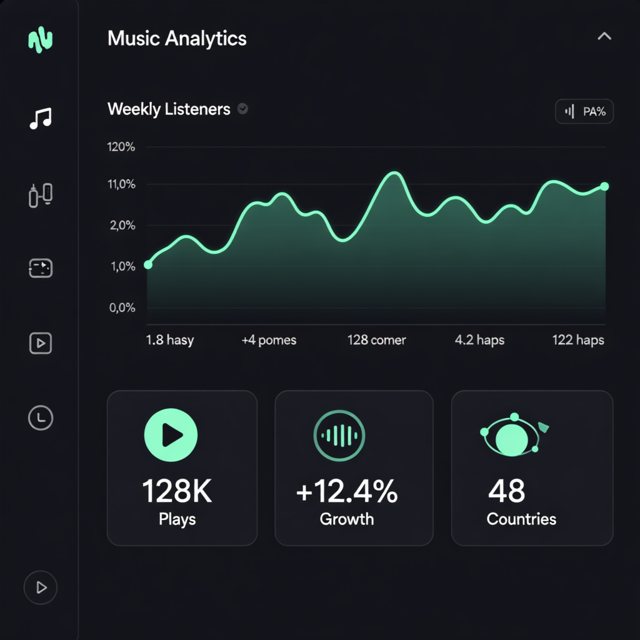
Das Konzertplakat hatte Bandname und drei Städtedaten richtig. Die Folie, „Q3 GPU spend“ mit vier Balken, ihren Werten und den Monaten, kam mit jeder Beschriftung richtig heraus. Auf dem Dashboard waren die drei Kennzahlkarten, die wir ausgeschrieben hatten („128K Plays“, „+12.4% Growth“, „48 Countries“), perfekt. Achsen und Legende des Diagramms, die wir nicht vorgegeben hatten, lasen sich wie überzeugender Pseudotext. Die Landingpage machte es genauso: Überschrift, Button und Menü richtig, Unterzeile und Feature-Karten Kauderwelsch. Ein Onboarding-Screen einer App schrieb „Grow Together“ richtig. Die Infografik war fast sauber, mit einem Glyphenfehler („PNGe goes back“) und doppelt gezeichneten Schrittnummern.
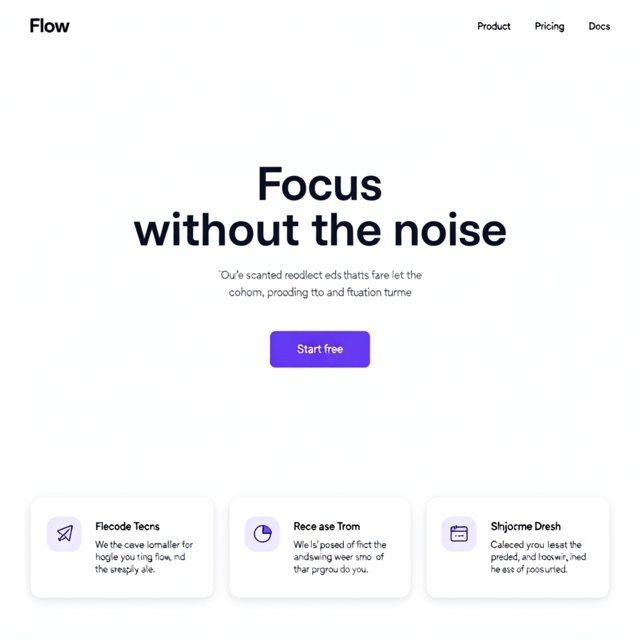
Zitierte Strings richtig, alles andere Platzhaltertext, der auf den ersten Blick echt aussieht.
Bei langen Listen ist es ausgerutscht. Wir wollten eine Café-Speisekarte mit 12 Zeilen und Preisen in zwei Spalten. Es zeichnete eine Spalte. Es schrieb „6.0l)“ für 6.00 und „1110.0“ für 11.00. Außerdem fügte es eine Kaffeezeile hinzu, die wir nie verlangt hatten, „Bica 0.50“.
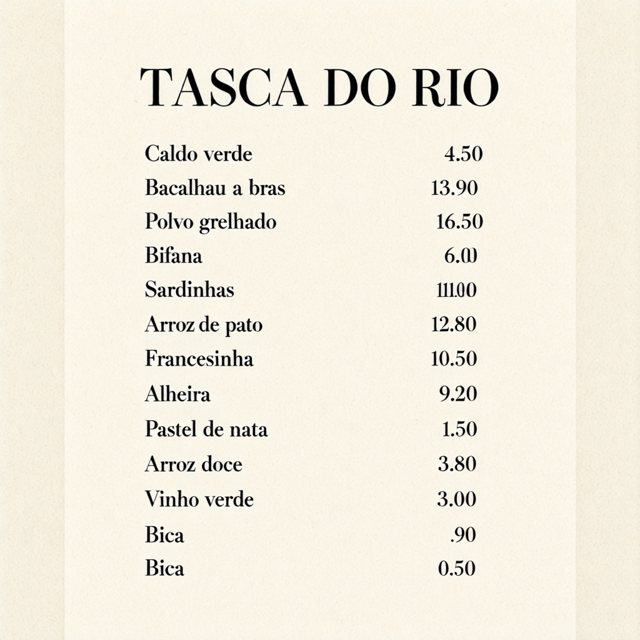
Zwei Preise falsch und eine erfundene Zeile.
Die Autoren empfehlen, jeden Prompt mit einem separaten Sprachmodell in eine strukturierte Beschreibung im Figma-Stil umzuschreiben, bevor er bei Ming ankommt. Wir haben einfache Prompts geschickt.
Transparenz: eine Variante von sechs, und nur mit der Phrase in einer eigenen Zeile
Eine Variante von sechs kam transparent zurück. Bei einem Paar machte der Zeilenumbruch den Unterschied, aber allein reichte er nicht.
Die Autoren veröffentlichen zehn feste Phrasen und sagen, man solle genau eine an den Anfang des Prompts setzen. Wir haben „RGBA, 4-channel, transparent background“ allein in die erste Zeile gesetzt, dann die Beschreibung des Stickers. Der Fuchs kam mit 83,2 % voll transparenten Pixeln zurück, ein sauberer Freisteller. Das klappte zweimal: einmal mit unserem eigenen Prompt, einmal über die Transparenzoption unseres Servers.
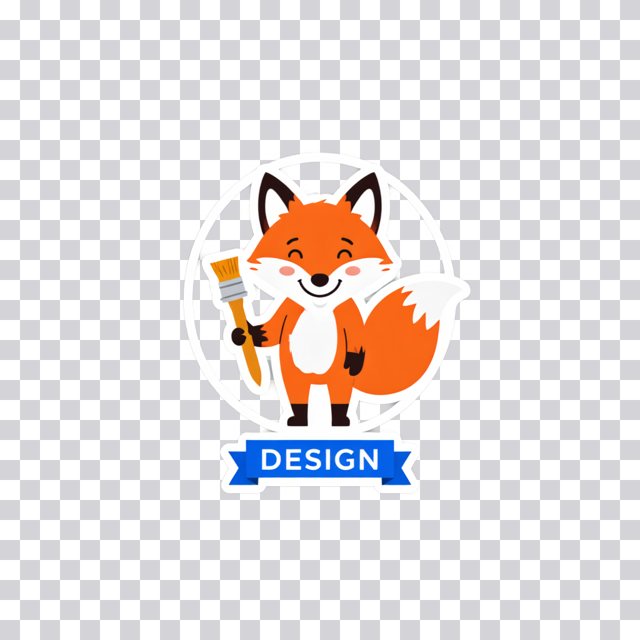
Mit einem Komma statt eines Zeilenumbruchs nach der Phrase kam der Hintergrund deckend weiß zurück, wie das Bild oben zeigt. Ein App-Icon mit derselben Phrase in einer eigenen Zeile kam deckend zurück. Drei weitere Kombinationen aus Phrase und Motiv ebenfalls, alle im Anhang aufgelistet. Normale Prompts liefern trotzdem ein PNG mit vier Ebenen, größtenteils deckend, mit einigen teilweise durchsichtigen Pixeln.
Unser Server-Code liefert mit jedem Bild den Anteil transparenter Pixel, die Prüfung ist also eine Zeile.
Welche GPU: eine Karte mit 80 GB lief, nichts Kleineres wurde getestet
Die einzige Karte, die lief, ist die einzige, die wir probiert haben, eine echte NVIDIA A100 mit 80 GB, mit allem auf der Karte. 80 GB sind also die Anforderung, so wie die Autoren sie validiert haben.
Wir hatten einen zweiten Schritt geplant: den Speicher der A100 auf 24 GB begrenzen, um eine kleinere Karte zu emulieren, und das 34-GB-Sprachmodell im Hauptspeicher des Rechners warten lassen. Auf dem Papier ergibt das Sinn, denn das Sprachmodell arbeitet nur einmal pro Prompt, am Anfang. Die Änderung der Einstellung hat das laufende Modell nicht neu gestartet, es blieb sieben Minuten lang komplett auf der Karte, also lief der Schritt nie. Der Neustart-Bug ist offen.
Auf InferenceKey: dein OpenAI-Bildcode kann diese Karte aufrufen
Ein Programm, das schon Bilder bei OpenAI anfragt, kann stattdessen diese Karte fragen, mit geänderter Adresse, Key und Einstellungen. Ming kommt als Python-Skript, nicht als Server. Also haben wir es in ein kleines Backend verpackt, Code, der ein Modell einmal lädt und Anfragen beantwortet. Unseres lädt den Code der Autoren in einer festen Version herunter und lädt das Modell einmal mit ihrem Loader. Dann ruft es für jede Anfrage ihre Generierungsfunktion auf.
Der erste Start dauerte 157 Sekunden: etwa 50 GB in 69 heruntergeladen, in 23 auf die Karte geladen. Diese Version brach beim ersten Bild ab, und einen sauberen Start der reparierten Version haben wir nicht gemessen. Ein Neustart nach einem Update dauerte 29 Sekunden.
Die exakten Bibliotheksversionen der Autoren lassen sich auf Python 3.11 nicht wie angegeben installieren und ausführen; etwas neuere beheben das, und das SDK-Beispiel liefert diese mit. Status: im Beispiel behoben, Issue an die Autoren noch nicht eingereicht.
Eine Unebenheit, über die du auch stolpern kannst:
- Große Bilder können zu groß zum Zurückschicken sein. Unser Test-Setup konnte höchstens 8 MB pro Antwort zurückschicken. Zwei detailreiche 2048er-Bilder wurden größer, wurden verworfen, und der Aufrufer wartete die vollen 300 Sekunden bis zum Timeout. Status: Das Backend im SDK-Beispiel verkleinert die Datei jetzt, bis sie passt, nur an gespeicherten Bildern getestet. Das lange Warten ist offen.
Solltest du es nutzen? Ja für zitierten Text auf einer 80-GB-Karte, mit einer Prüfung bei jedem Freisteller
- Wenn du App-Mockups, Folien, Dashboards oder Plakate mit Text machst, den du ausschreiben kannst, setze jedes Wort, das du brauchst, in Anführungszeichen.
- Wenn du lange Listen oder exakte Zahlen brauchst, etwa eine Speisekarte, eine Preisliste oder eine Tabelle, lies jede Zeile.
- Wenn du transparente Assets brauchst, setze die Phrase in eine eigene Zeile und prüfe die Alpha-Ebene im Code.
- Wenn deine Karte unter 80 GB hat, plane vorerst eine 80-GB-Karte ein.
- Wenn du eine Lizenz für ein Produkt brauchst, MIT deckt kommerzielle Nutzung ab.
Um auf deinem NVIDIA-Rechner einen Screen, eine Infografik und einen Sticker zu machen, veröffentliche das Backend mit python publish.py und starte IK_KEEP_ALIVE=1 python main.py aus dem SDK-Beispiel. Du brauchst eine 80-GB-Karte in einem InferenceKey-Projekt und etwa 60 GB Plattenplatz.
Für Ingenieure
Modell und Dateien
Model Card, GitHub (inclusionAI/Ming-Image), vLLM-Omni-Rezept, Demo-Space. Repo inclusionAI/Ming-Image-0.1-Design, erstellt 2026-09-17T07:17:31Z, lastModified 2026-10-14T04:22:50Z, sha c57c49689d12ef7d4e24a170014f1dc43d3ce258, nicht gated, Lizenz-Tag mit, library_name: custom, 435 Likes und 1.191 Downloads am 23.10.2026. Die safetensors-Metadaten auf HF zählen 6.154.901.056 BF16-Parameter, was genau dem Transformer allein entspricht.
| Komponente | Was es ist | Größe |
|---|---|---|
mllm/ | BailingMM2: Ling bailing_moe_v2, 20 Layer, 256 Experten, 8 aktiv, hidden 2048, plus ein Qwen2.5-ViT; 7 Shards | 34.018 GB |
transformer/ | DiffusionTransformer, dim 3840, 30 Layer, 30 Heads; 5 Shards (die „6B“) | 12.310 GB |
connector/ | Qwen2 1.5B in fp32 | 6.175 GB |
vae/ | AutoencoderKLQwenImage, 4 Eingangskanäle | 0.254 GB |
mlp/ | 0.125 GB | |
assets/ | 0.002 GB | |
| Gesamt | 52.883 GB |
Scheduler FlowMatchEuler, Shift 6. Das vLLM-Omni-Rezept beschreibt dasselbe als Stage 0 (Qwen2.5-VL-Vision-Tower plus das BailingMoeV2-LM mit 20 Layern, 256 gelernte Image-Query-Tokens, Query-States plus VLM-States aus den Layern 5, 12 und 20) und Stage 1 (der Connector plus ein Z-Image-DiT mit 30 Layern und einem Qwen-Image-RGBA-VAE).
Im Code der Autoren gibt es keine RGBA-Logik auf der Prompt-Seite: Das VAE hat 4 Kanäle und infer.py speichert mit image.save als PNG, also ist jedes Bild RGBA, und das Alpha hängt nur davon ab, was das Modell erzeugt (processing_bailingmm2.py:165, infer.py:246-257).
Einstellungen
Model Card: 2048 x 2048 empfohlen, 1024 x 1024 für schnellere Generierung, 12 Sampling-Schritte, CFG 1.0, BF16, „one CUDA GPU with 80 GiB VRAM (validated configuration)“. Die Text-to-Image-Buckets von infer.py sind (1024, 2048), Standard 2048, Seitenverhältnis zwischen 1:4 und 4:1, nächster Bucket nach sqrt(width*height). Standardwerte: Seed 42, bfloat16, Attention eager, --num-gpus 1, --device-map balanced (Multi-GPU-Sharding des MLLM wird unterstützt, wir haben es nicht probiert).
Die zehn Transparenz-Phrasen (README, „Transparent-background generation tip“): genau eine wählen und an den Anfang setzen, nicht kombinieren. Englisch: RGBA, 4-channel, transparent background, isolated subject, alpha matte, no background, cutout PNG, alpha=0 outside the object, transparent canvas, not white, not checkerboard, production RGBA layer for compositing, plus fünf chinesische Phrasen.
Die Autoren empfehlen einen strukturierten JSON-Prompt im Figma-Stil von einem Prompt-Enhancer (Ling-3.0-flash-VL oder qwen3.8-27B), der außerhalb von infer.py läuft. Wir haben einfache Prompts verwendet.
Die Standardwerte des Bildtesters im Panel (20 Schritte, Guidance 4.5) sind nicht die Einstellungen dieses Modells: Setze 12 und 1.
Unser Setup
Eine NVIDIA A100-SXM4-80GB in unserer Cloud (81.920 MiB, Treiber 595.71.05, Power-Limit 400 W, 32 vCPU, 125 GB RAM im Container). Die PCIe-Variante war nicht verfügbar. Der Worker wurde von einem lokalen InferenceKey-Manager über HTTP- und TCP-Tunnel gebootstrappt; die Produktion wurde nie angefasst. Backend-venv: Python 3.11, torch 2.5.1, torchvision 0.20.1, transformers 4.57.1, diffusers 0.36.0, numpy 1.26.4, bereitgestellt mit uv. Code der Autoren auf Commit 3515cd7b1e3049fc517eed7d35020251cd06519a (2026-09-28), am 23.10.2026 immer noch der HEAD von main.
Deployment Schritt für Schritt
Das SDK-Beispiel, Commit 1e88edaa auf main (Dateien: README.md, backend.py, publish.py, main.py, requirements.txt, .env.example, .gitignore). Du brauchst ein SDK-Token (INFERENCEKEY_SDK_TOKEN, Control Plane), einen API-Key (INFERENCEKEY_API_KEY, Data Plane), INFERENCEKEY_PROJECT, die IK_WORKER_ID eines privaten NVIDIA-Workers (mit 80 GB bleibt das ganze Modell auf der GPU) und für publish.py optional INFERENCEKEY_TENANT_ID plus INFERENCEKEY_USER_TOKEN (oder du lädst dist/*.tar.gz im Dashboard hoch). Etwa 53 GB Plattenplatz für die Gewichte plus ein venv mit 6 GB. Client mit Python 3.9 oder neuer; das Backend läuft auf Python 3.11, bereitgestellt mit uv.
cp .env.example .env              # tokens, project, worker id
python publish.py                 # packages backend.py, registers "ming-image-design-text2image" (v0.1.4)
IK_KEEP_ALIVE=1 python main.py    # ensure(), wait_until_ready(), 3 pictures into ./outputs
main.py deployt den Workload ming-image-design (Task text2image, Policy fixed, 1 Replica, Workload-Config ready_timeout_secs: 2400, request_timeout_secs: 900) und schreibt outputs/ui-1024.png, outputs/infographic-2048.png und outputs/sticker-rgba-1024.png. Wenn der Workload schon läuft, ruf den Endpoint direkt auf, statt main.py erneut zu starten (siehe Probleme).
Eine Anfrage für einen transparenten Sticker (wir haben unseren lokalen Manager aufgerufen; der gehostete Dienst nimmt dieselbe Form an, auch wenn wir ihn nicht aufgerufen haben):
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/ming-image-design/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "n": 1, "prompt": "A cartoon fox sticker holding a paintbrush above a ribbon that says \"DESIGN\"", "size": "1024x1024", "seed": 42, "steps": 12, "guidance_scale": 1.0, "background": "transparent", "output_format": "png"}'
background: "transparent" sorgt dafür, dass das Backend RGBA, 4-channel, transparent background allein in die erste Zeile setzt. Die Antwort ist {data: [{b64_json}]} plus seconds (GPU-Zeit), vram_peak_gib, bucket und transparent_fraction.
Backend
backend.py. Die fertigen Backends von InferenceKey führen keine Modellskripte aus, daher dieses eigene. setup() lädt das Code-Tarball von Ming-Image auf 3515cd7b nach ~/.cache/ming-image-code/<sha> herunter, führt snapshot_download der Revision c57c4968 aus (ohne assets/) und lädt BailingMM2NativeForConditionalGeneration.from_pretrained(..., torch_dtype=bf16, attn_implementation="eager", load_image_gen=True, device_map=<authors' 1-GPU plan>) plus den Processor. process() liest prompt, size oder width/height, steps/num_inference_steps (12), guidance_scale (1.0), seed, background, output_format (png oder webp, beide behalten das Alpha) und ruft run_generation der Autoren auf. Die Speichermodi auto, gpu, lowvram (MoE-LLM-Layer per Device Map auf der CPU), minimal (zusätzlich der Connector und ein Teil des DiT unter accelerate cpu_offload, VAE-Tiling) und die Grenze MING_VRAM_LIMIT_GIB (torch.cuda.set_per_process_memory_fraction) sind geschrieben, liefen aber nie auf einer GPU. Versionen während des Tests: 0.1.0 (Pins der Autoren), 0.1.1 (numpy 1.26.4), 0.1.2 (torch 2.5.1), 0.1.3 (RGBA-Phrase in eigener Zeile, getestet), 0.1.4 (stufenweise niedrigere WebP-Qualität für Ergebnisse über 8 MB, committet, nur offline getestet).
Zeit bis bereit
- Kaltstart mit Paket 0.1.0: SDK
ready after 157 s(frisches venv etwa 60 s; Backend-Logdownload 69.1s, load 23.4s, memory mode gpu (budget 78.3 GiB), weights in VRAM 46.3 GiB; etwa 50 GB heruntergeladen, Assets übersprungen, mit etwa 0,7 GB/s). Dieses Paket scheiterte dann bei der ersten Anfrage (torch-Bug unten). - Paket 0.1.2, torch im bestehenden venv getauscht: 6 min 46 s
uv pip install, danndownload 8.3s, load 21.6s. - Hot Recycle nach dem Veröffentlichen von 0.1.3: 29 s (
download 4.6s, load 20.9s). - Ein sauberer Kaltstart mit dem finalen Paket wurde nicht gemessen.
Messungen
GPU-Zeit im Backend gemessen mit cuda.synchronize(); Round Trip vom HTTP-Client zum lokalen Manager. 12 Schritte, CFG 1, eine Anfrage nach der anderen, Eager Attention, kein flash-attn, keine Kompilierung, kein Step-Caching (ein optimierter Stack sollte schneller sein; nicht gemessen).
| Fall | Bucket | GPU s | Round Trip s | torch Spitze allokiert GiB | Ausgabe |
|---|---|---|---|---|---|
| ui-1024 (erster Aufruf) | 1024 | 7.397 | 14.73 | 50.45 | png |
| infographic-2048 | 2048 | 35.849 | 41.49 | 62.84 | png, 2.1 MB |
| Sticker, Phrase + Komma | 1024 | 6.257 | 7.45 | 50.45 | png, deckend |
| fox-zh-nl / fox-en-nl / mug-cutout-nl / logo-zh2 | 1024 | 6.237 / 6.236 / 6.199 / 6.178 | 7.34 / 7.47 / 7.85 / 7.10 | 50.45 | png |
| Dashboard | 1024 | 7.135 | 8.39 | 50.45 | png |
| poster-2048 | 2048 | 35.807 | 44.03 | 62.84 | verlustbehaftetes WebP (PNG und verlustfreies WebP über der Grenze) |
| Logo, background transparent | 1024 | 6.232 | 7.11 | 50.45 | png, deckend |
| Tasse, background transparent | 2048 | lief | 504 nach 300.02 | n/a | Ergebnis mit 10.6 MB abgelehnt |
| Folie 1920x1080 | 1024 | 5.774 | 7.03 | 49.95 | png |
| Speisekarte | 1024 | 6.381 | 8.87 | 50.45 | png |
| Speisekarte | 2048 | lief | 504 nach 300.02 | n/a | Ergebnis mit 15.5 MB abgelehnt |
| Sticker, background transparent (Phrase + Zeilenumbruch) | 1024 | 6.224 | 7.47 | 50.45 | png, 83.2 % Alpha 0 |
| Panel-Tester, Pflanzen-Onboarding | 1024 | n/a | 8,397 ms im Panel | n/a | png |
| Panel-Tester, Fuchs mit Komma | 1024 | n/a | 7,292 ms im Panel | n/a | deckend |
Etwa 2,2 bis 2,4 it/s bei 1024 und etwa 2,8 s/Schritt bei 2048. Plattform-Overhead etwa 0,8 bis 2,5 s bei 1024 (7,3 s beim allerersten Aufruf) und 5,6 bis 8,2 s bei 2048 (größere Nutzlast). Kartenspeicher aus nvidia-smi jede Sekunde (2.736 Samples): im Leerlauf mit geladenem Modell 47.843 MiB, Spitze 65.935 MiB um 06:11:33Z während der 2048er-Infografik; torch reservierte bis zu 63,88 GiB; Spitzenleistung der Karte 450,55 W bei einem gemeldeten Limit von 400 W.
Transparenztests
Alpha mit PIL bei jedem PNG geprüft.
| Phrase und Platzierung | Motiv | Ergebnis |
|---|---|---|
RGBA, 4-channel, transparent background + Zeilenumbruch | Fuchs-Sticker | 83.17 % Alpha 0 (zweimal: roher Prompt und die Option background des Backends) |
dieselbe Phrase + , in derselben Zeile | Fuchs-Sticker | deckend, Alpha min 247 |
带透明通道,4通道RGBA图像 + Zeilenumbruch | Fuchs-Sticker | deckend |
透明背景,alpha通道,无底图 + Leerzeichen | App-Icon | deckend |
cutout PNG, alpha=0 outside the object + Zeilenumbruch | Tasse | deckend |
RGBA, 4-channel, transparent background + Zeilenumbruch (v0.1.3) | App-Icon | deckend, Alpha 253 bis 255 |
Normale Prompts liefern RGBA mit Alpha 195 bis 255. Ein Seed pro Prompt; ob sich das verallgemeinern lässt, ist unbekannt.
VRAM-Leiter
| Ziel | Konfiguration | Spitze | Zeit pro Ausgabe | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| A100-SXM4-80GB (Hauptlauf) | gpu, BF16, alles resident, 12 Schritte, CFG 1 | 65,935 MiB Karte (64.4 GiB) / 62.84 GiB torch bei 2048; 50.45 GiB bei 1024 | 35.8 s (2048), 6.2 bis 7.4 s (1024) | ja | echt |
| 24-GB-Grenze auf der A100 | lowvram (MoE-LLM-Layer auf der CPU), MING_VRAM_LIMIT_GIB=23 | n/a | n/a | nicht gelaufen | emuliert (geplant) |
Die 24-GB-Stufe lief nicht: ensure() mit nur geändertem config.env hat das laufende Backend nicht recycelt (immer noch memory mode gpu 7 Minuten nach 06:30:46Z), und die Stufe wurde dort abgebrochen. Nicht probiert: Grenzen bei 48, 24 und 16 GB, irgendeine echte Consumer-Karte, irgendeine Quantisierung. Die Schätzung für lowvram (etwa 18 GiB Gewichte plus 4 bis 16 GiB Aktivierungen) ist ein Hinweis, kein Ergebnis.
Qualität, weitere Details
Unsere eigenen Prompts, je ein Sample, jedes Bild von Hand gelesen. Über den Fließtext hinaus: Titel, drei weitere Schrittbeschriftungen und Fußzeile der Infografik waren richtig, und ihre Schrittnummern erscheinen sowohl schlicht als auch eingekreist; die Fußnote der Folie „Source: internal billing“ war richtig.
Demo-Video
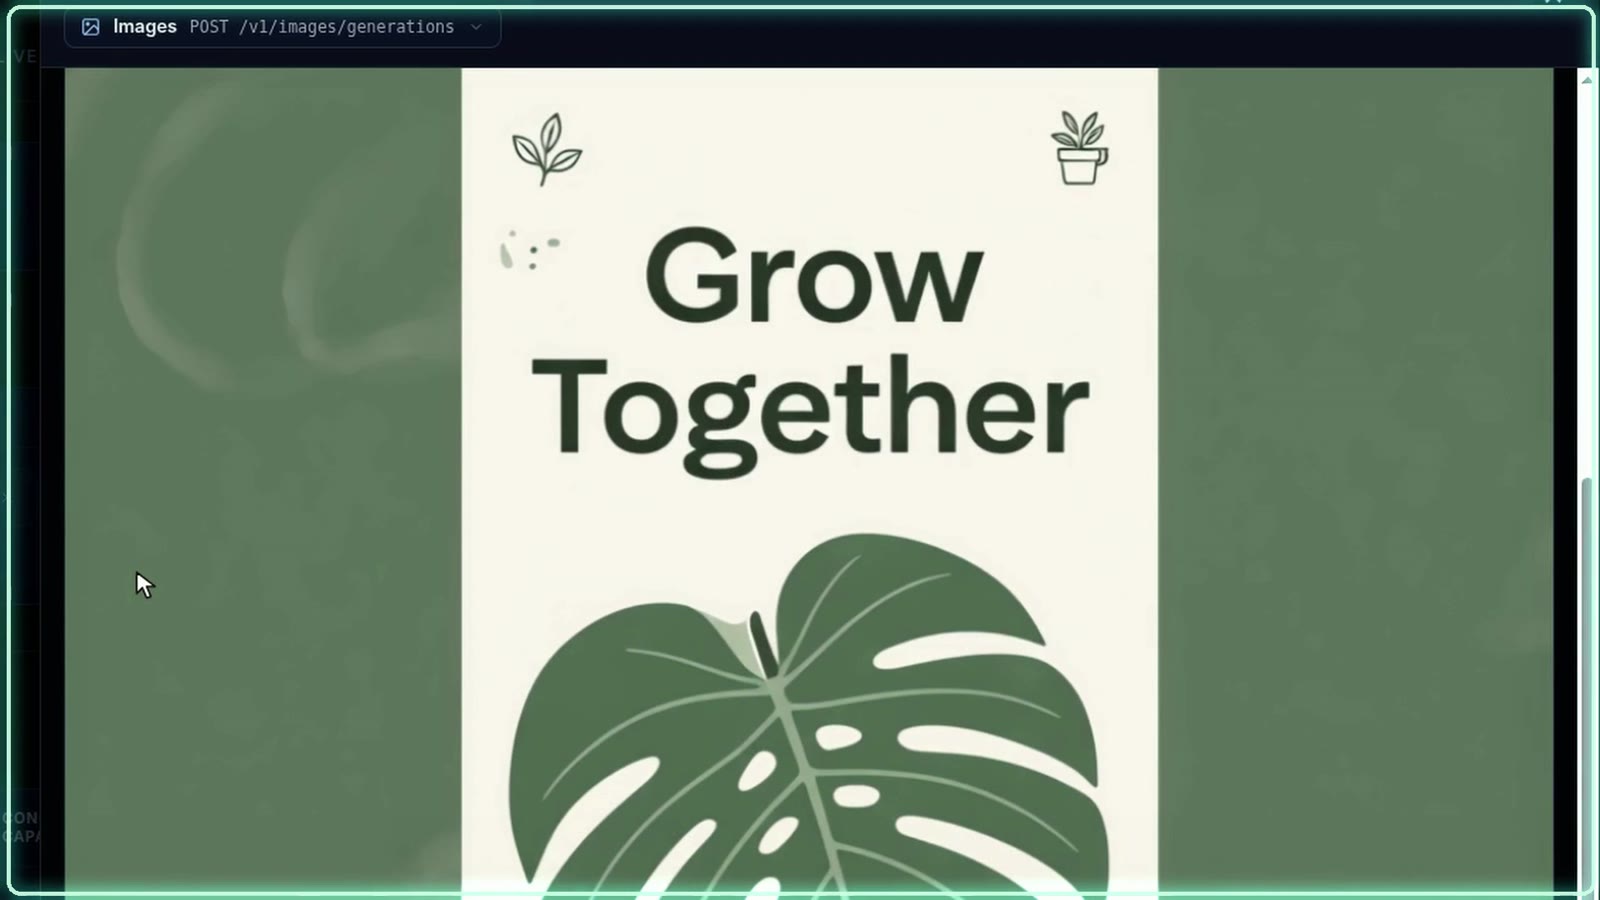
Klicken, um das MP4 abzuspielen (104 s, mit Sprecher). Die Ansicht Workloads zeigt Ming-Image-0.1-Design auf gpu-design-01 (1x NVIDIA A100-SXM4-80GB, Fixed, Healthy). Der Bildtester macht mit 12 Schritten und Guidance 1 den Pflanzen-Onboarding-Screen in 8.397 ms, dann den Fuchs-Sticker mit der Phrase und einem Komma dahinter in 7.292 ms, der deckend zurückkommt. Die Firma im Panel, Lumen Design Co, ist ein erfundenes Demo-Konto.
Offene Probleme und Status
- Die Pins der Autoren laufen nicht wie gepinnt.
numpy==1.23.1hat kein Wheel für CPython 3.11 (uvfing an, es aus dem Quellcode zu kompilieren); behoben mit numpy 1.26.4.torch==2.4.0mitdiffusers==0.36.0scheitert bei der ersten Anfrage mitTypeError: scaled_dot_product_attention() got an unexpected keyword argument 'enable_gqa'(diffusersattention_dispatch.pyZeile 1814, aufgerufen aus Mingsdiffusion/transformer.pyZeile 133); behoben mit torch 2.5.1 und torchvision 0.20.1. Status: im SDK-Beispiel behoben; Issue bei inclusionAI/Ming-Image noch einzureichen. - Der Tausch von torch in einem bestehenden Backend-venv dauerte 6 min 46 s, weil der Worker den venv-Pfad wiederverwendete und
uv pip installdarüber laufen ließ. Status: offen. - Ergebnisse über 8 MB werden verworfen (Nachrichten mit 10.610.209 und 15.530.594 Bytes überschritten JetStream
max_payload, 8 MB auf dem NATS-Container unseres Test-Stacks; das Limit im gehosteten Dienst wurde nicht geprüft), und der Client wartet 300,02 s auf ein504 inference_timeout. Status: Backend 0.1.4 senkt die WebP-Qualität stufenweise (90, 82, 74, 66, 58, 50), nur offline getestet; die Plattform wartet weiterhin den vollen Timeout ab, offen. - Ein erneutes
ensure()+wait_until_ready()gegen einen schon bereiten Workload wartete 10 Minuten ohne Event (Worker:custom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel). Status: offen; ruf den Endpoint direkt auf, wenn der Workload läuft. - Nur
config.envmitensure()zu ändern hat das laufende Custom Backend nicht recycelt. Siehe die VRAM-Leiter oben. Status: offen. - Harmloses Log-Rauschen: unerwartete Config-Attribute bei
AutoencoderKLQwenImage(scaling_factor,shift_factor) und beiDiffusionTransformer(siglip_feat_dim) sowie ein runpy-RuntimeWarning.
Alternativen, die wir nicht getestet haben
- vLLM-Omni.
vllm serve inclusionAI/Ming-Image-0.1-Design --omni --deploy-config vllm_omni/deploy/ming_image.yaml --port 8091, OpenAI-kompatibles/v1/chat/completionsmitmodalities: ["image"]. Umgebung: CUDA 13.0, vLLM 0.29.0, vLLM-Omni-Commit6daf5b30f, „2x H100 80GB (1xH100 to be validated)“. Benchmark auf 2x H100 (1024, 12 Schritte, CFG 1, Concurrency 1): 2,219 s End-to-End ohne Cache, 2,068 s mit TeaCache 0.30, 1,698 s mit Cache-DiT 0.16 (SSIM 0,853). Die Tabelle nennt vLLM 0.30.0, die Umgebung 0.29.0. Hinweise: eine Anfrage nach der anderen, die erste Anfrage pro Form zahlt für Kompilierung und CUDA-Graph-Capture, Größen durch 16 teilbar, ein nicht leerernegative_promptwird abgelehnt, die Ausgaben behalten vier RGBA-Kanäle. Nicht vergleichbar mit unseren Eager-Zahlen auf einer einzelnen A100. - Der Demo-Space von hugging-apps. Gradio auf ZeroGPU (die API meldet
zero-a10g, der Code fordert Größexlargean, die echte GPU ist also nicht bestätigt), Buckets 1024 und 2048, 4 bis 24 Schritte (Standard 12). Er implementiert die Pipeline aus vLLM-Omni PR #8021 neu, stattinfer.pyaufzurufen, und fährt CFG, sobaldguidance_scale > 0, was den DiT-Batch bei 1.0 verdoppelt. Seine Hinweise, das GitHub-Repo liefere 404 und die RGBA-Phrasen seien unveröffentlicht, sind veraltet. Nützlich, um Prompts auszuprobieren, bevor du eine Karte mietest: Er zeigt die Bilder, nicht die Geschwindigkeit. - Ming-Image-0.1-Design-Layer, Prompt-Enhancement, Concurrency, andere Seitenverhältnisse, Multi-GPU-Sharding.
Grenzen
15 Bilder (13 per API, 2 aus dem Panel) plus 2 gescheiterte Anfragen, ein Sample pro Prompt, unsere eigenen Prompts, ein Seed. Ein Kartentyp, eine Anfrage nach der anderen. Den Leaderboard-Rang, den die Model Card zeigt und das Video von AI Search zitiert, haben wir nicht geprüft.
Credits
inclusionAI hat Ming-Image-0.1-Design gebaut und unter MIT veröffentlicht, mit dem Inferenz-Code und den Transparenz-Phrasen. Das Modell verwendet Teile aus der Ling-MoE-Familie, den Vision-Encoder von Qwen2.5, einen Qwen2-Connector, das Design des Z-Image-Diffusion-Transformers (laut vLLM-Omni-Rezept) und das Qwen-Image-VAE. Das vLLM-Omni-Team hat das Serving-Rezept und seinen Benchmark geschrieben. hugging-apps hat den Demo-Space veröffentlicht. Bei AI Search haben wir das Modell entdeckt. Unser Teil: das Custom Backend, das Deployment auf InferenceKey, die Abhängigkeits-Fixes und die Messungen.