Ming-Image Design es un modelo de 6B que llegó a 64 GiB, y la transparencia funcionó en una variante de prompt de seis
Ming-Image-0.1-Design en una A100 de 80 GB: de 6 a 7 s por imagen de 1024, 36 s a 2048, pico de 64,4 GiB y un PNG transparente de seis variantes.
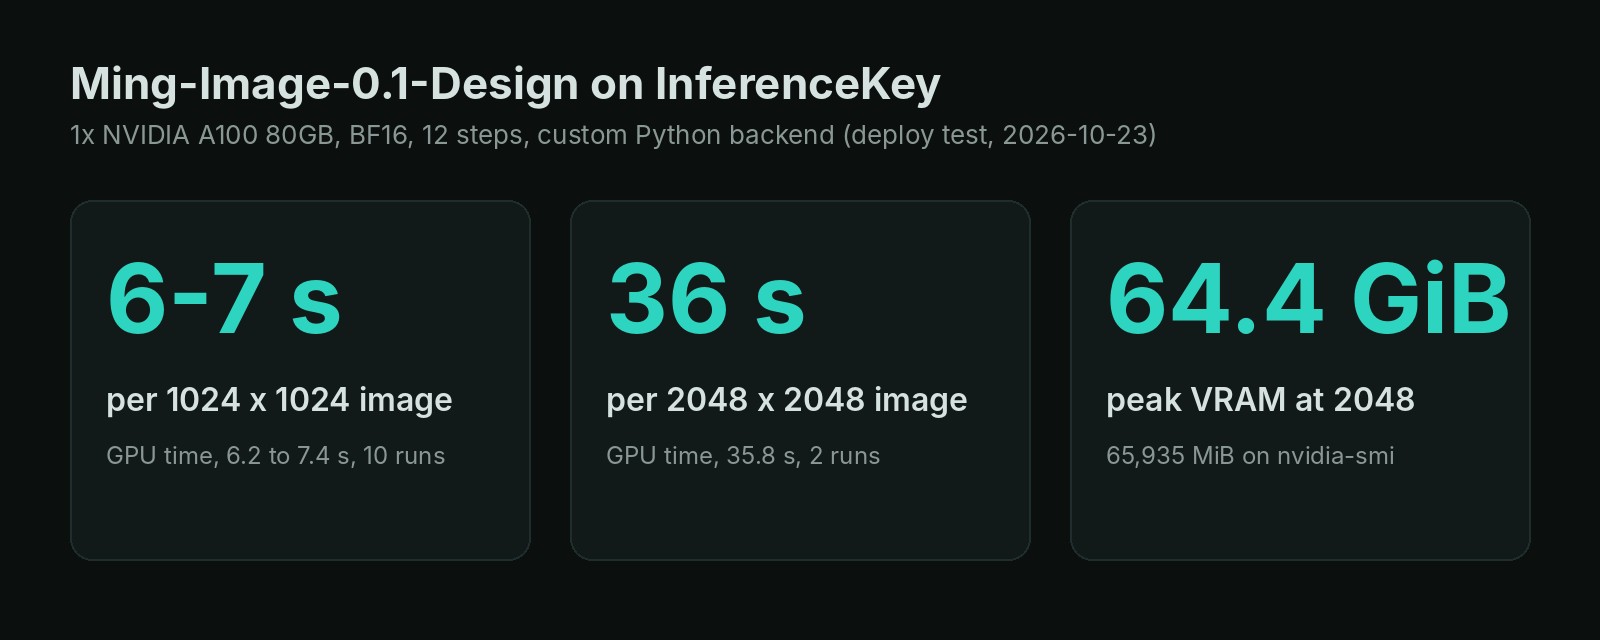
"Un modelo de texto a imagen de 6B para UI, infografías, carteles y otros diseños visuales con mucho texto", dice la ficha del modelo de Ming-Image-0.1-Design. El repo ocupa 53 GB. En una NVIDIA A100 de 80 GB llenó 64,4 de los 80 GiB de memoria de la tarjeta. Ese es el primer hallazgo: con el modelo entero en la tarjeta, esto es trabajo para una tarjeta de 80 GB, no para la de 12 GB que sugiere la cifra de 6B. En esa tarjeta hizo una pantalla de app de 1024 x 1024 en 6 a 7 segundos y un cartel de 2048 x 2048 en 36. El segundo hallazgo tiene que ver con su número estrella, los PNG con fondo transparente. De seis variantes de prompt que probamos, una salió transparente, y solo con la frase de activación de los autores sola en la primera línea. El modelo y su código tienen licencia MIT, así que puedes vender lo que haga.
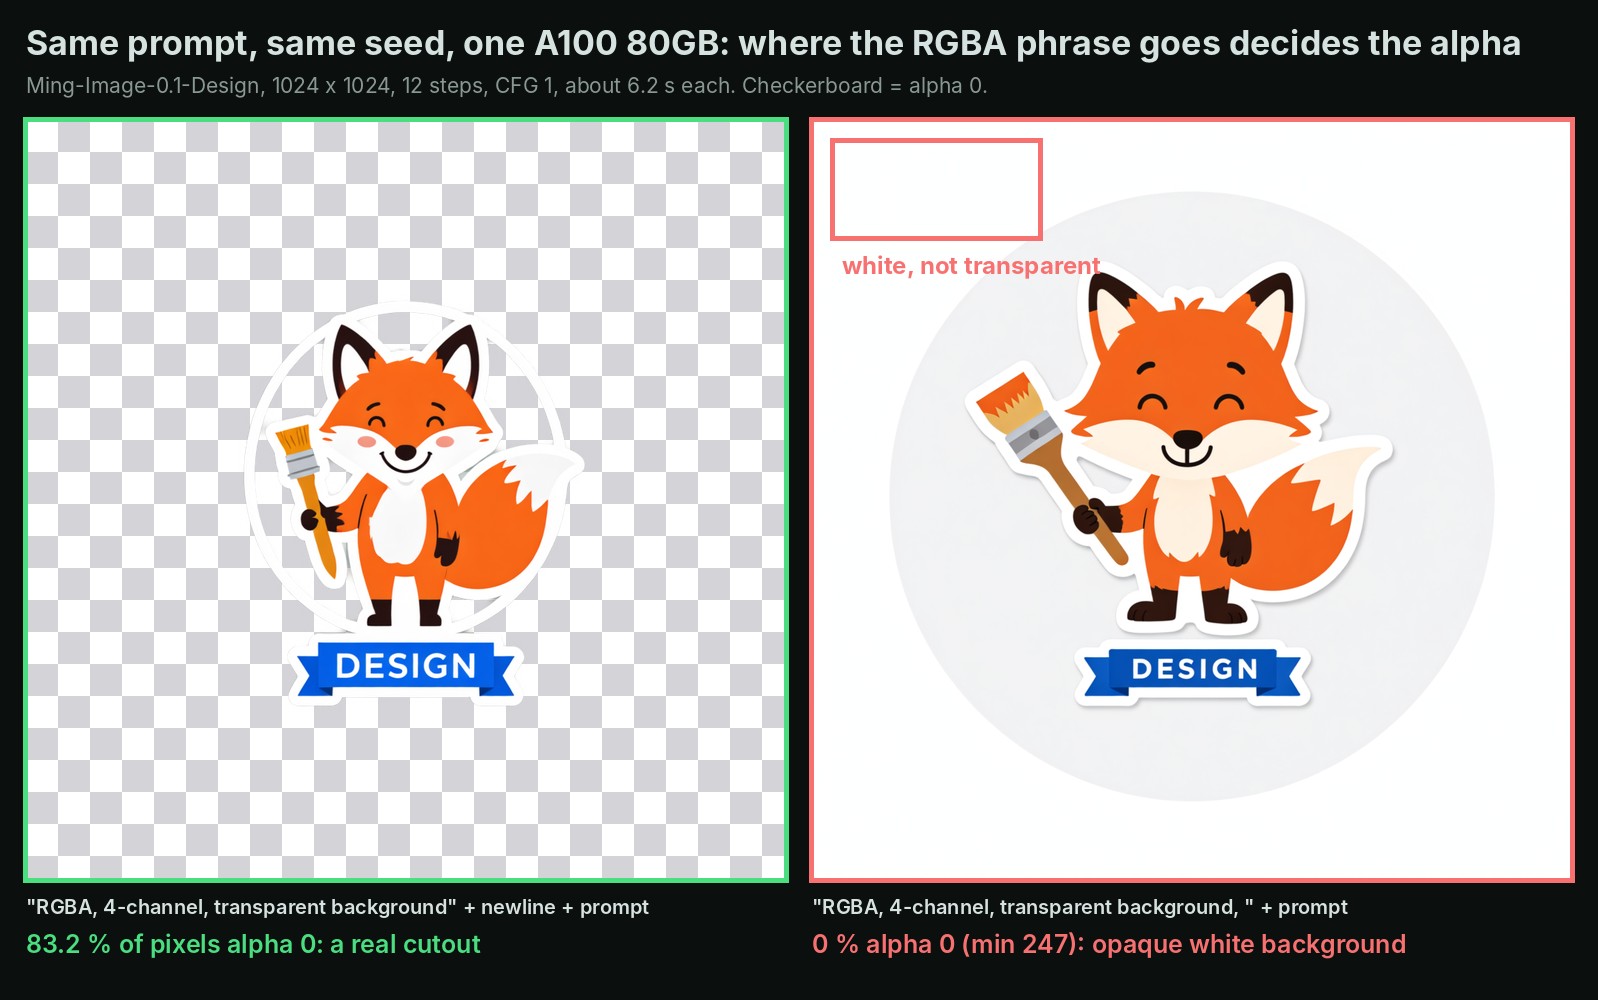
Mismo prompt, mismo punto de partida aleatorio: el salto de línea es la única diferencia. El damero marca los píxeles totalmente transparentes.
Los 6B son el cantante, y la furgoneta carga 41 GB más
Ming-Image-0.1-Design se anuncia como un cartel de concierto que solo nombra al cantante. La furgoneta tiene que llevar igualmente la batería, los amplis y al bajista. El cantante aquí es la parte que atrae al público: un modelo de 6B parámetros que convierte ruido en una imagen en unas pocas pasadas, 12,3 GB en disco. Detrás va un modelo de lenguaje de 34 GB que lee tu prompt. Un conector de 6,2 GB le pasa lo que ha entendido al modelo que dibuja. Un decodificador pequeño, de 0,25 GB, convierte el resultado en píxeles con una cuarta capa para la transparencia. En total, 52,9 GB.
Su README de GitHub lo dice sin rodeos: el despliegue mínimo validado es "una GPU con al menos 80 GiB de memoria". El número de parámetros es lo que se repitió.
Nosotros también lo repetimos. Vimos el modelo en el vídeo de noticias de AI Search del 27 de septiembre. Describe el modelo base como de "12 gigabytes" y dice que "debería caber en la mayoría de GPU de gama media y alta". Nuestro propio catálogo de modelos copió esos 12 GB. Son el cantante solo. Queríamos la cifra real, así que lo pusimos a funcionar.
Lo que hace que el modelo merezca la pena es aquello para lo que está hecho. inclusionAI lo entrenó para diseño con mucho texto: pantallas de apps, dashboards, infografías, carteles, diapositivas. Está pensado para colocar tus palabras donde las pondría un diseñador. Cada imagen sale como un PNG con canal alfa, la capa que dice cuánto se transparenta cada píxel. Así un logo o un sticker pueden ir a una diapositiva sin un recuadro blanco alrededor. El modelo se subió a Hugging Face el 17 de septiembre y se actualizó por última vez el 14 de octubre.
La prueba: una A100 de 80 GB, 15 imágenes, un intento cada una
Esto es una comprobación de comportamiento, no un benchmark de calidad: un intento por prompt, prompts nuestros. Mantuvimos la configuración validada por los autores: una NVIDIA A100 de 80 GB en nuestra nube, el modelo sin comprimir, 12 pasadas por imagen. Lo servimos a través de una copia de prueba de InferenceKey compilada desde su rama main actual, con el propio código Python de los autores por debajo. No llamamos al servicio alojado, así que considéralo sin probar ahí.
Hicimos 15 imágenes: siete layouts y ocho intentos de transparencia. Otras dos peticiones a 2048 fallaron por un motivo que explicamos más abajo.
El modelo trabaja con dos niveles de resolución, 1024 y 2048. Si pides otro tamaño, dibuja en el nivel más cercano y reescala. Una diapositiva de 1920 x 1080, por ejemplo, se dibuja a 1024.
Resultados: de 6 a 7 segundos y menos de medio céntimo por pantalla, 36 segundos y unos 2 céntimos por cartel
A 1024 x 1024 la tarjeta tardó de 6,2 a 7,4 segundos por imagen en 10 ejecuciones. A 2048 x 2048 tardó 35,8 segundos, las dos veces. Cuatro veces los píxeles costaron unas cinco veces el tiempo. Medimos el script tal cual de los autores, sin optimizar. vLLM-Omni publica unos 2,2 s a 1024 en dos H100; nosotros no lo ejecutamos.
| Tamaño | Tiempo de tarjeta por imagen | De la petición a la respuesta |
|---|---|---|
| 1024 x 1024 | de 6,2 a 7,4 s | de 7,0 a 8,9 s |
| 2048 x 2048 | 35,8 s | de 41,5 a 44,0 s |
Una petición cada vez. "De la petición a la respuesta" incluye el paso por InferenceKey. Las cifras completas, con la memoria por tamaño, en el apéndice.
Ocupada sin parar, una tarjeta hace unas 400 a 500 pantallas por hora a 1024, o de 82 a 87 carteles a 2048. Es una estimación a partir de imágenes sueltas, no de una ejecución sostenida. Una A100 de 80 GB se alquila por unos 1,4 a 1,8 dólares la hora. La factura sale de un cuarto a medio céntimo por pantalla de 1024, y unos 2 céntimos por cartel de 2048.
La memoria es la cifra que decide tu tarjeta. Cargado en la tarjeta, el modelo entero ocupó 46,3 GiB antes de hacer ninguna imagen. Una imagen de 1024 necesitó 50,45 GiB en su pico, y una de 2048 llevó la tarjeta a 64,4 GiB, que todavía deja margen sobre 80.
El texto entre comillas salió bien en 5 de 7 layouts, las palabras que no escribes salen como galimatías
El texto corto que escribes entre comillas suele ser el texto que obtienes. El texto que dejas al modelo es decoración que parece letras.
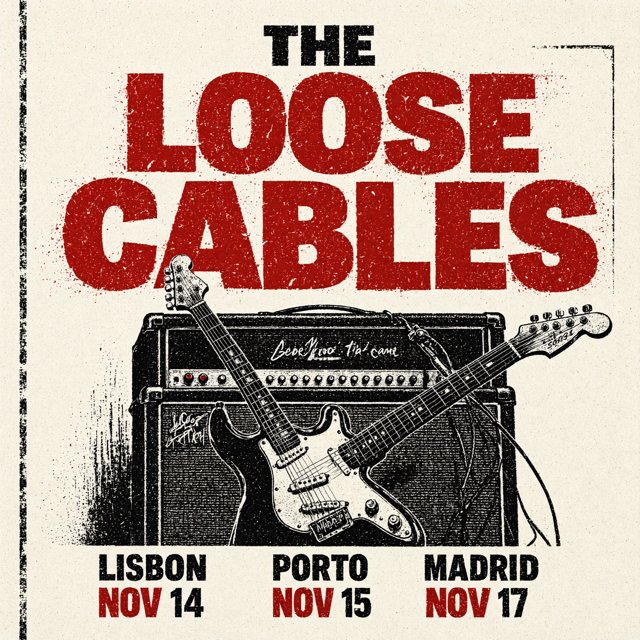
Todas las palabras entre comillas bien. Los garabatos del ampli no estaban en el prompt.
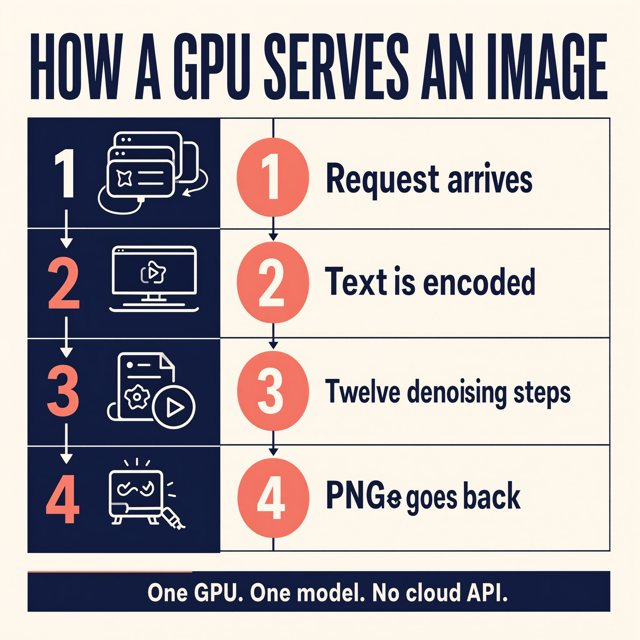
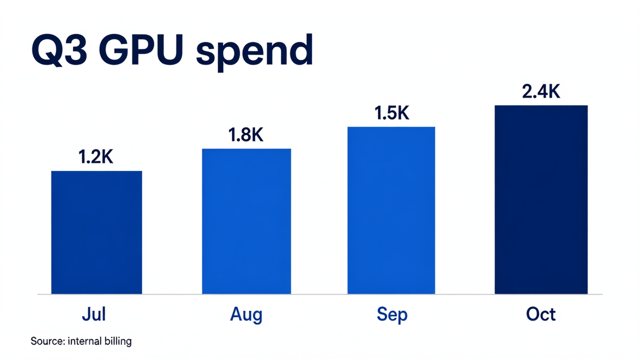
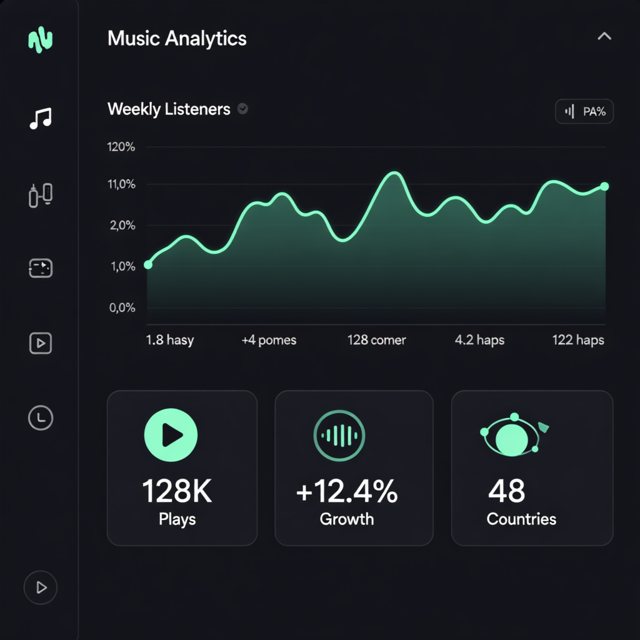
El cartel del concierto acertó el nombre del grupo y las fechas de las tres ciudades. La diapositiva, "Q3 GPU spend" con cuatro barras, sus valores y los meses, salió con todas las etiquetas bien. En el dashboard, las tres tarjetas de cifras que escribimos ("128K Plays", "+12.4% Growth", "48 Countries") quedaron perfectas. Los ejes y la leyenda del gráfico, que no especificamos, salieron como un pseudotexto convincente. La landing page hizo lo mismo: titular, botón y menú bien, subtítulo y tarjetas de funcionalidades en galimatías. Una pantalla de onboarding de una app escribió bien "Grow Together". La infografía salió casi limpia, con un fallo de glifo ("PNGe goes back") y los números de los pasos dibujados dos veces.
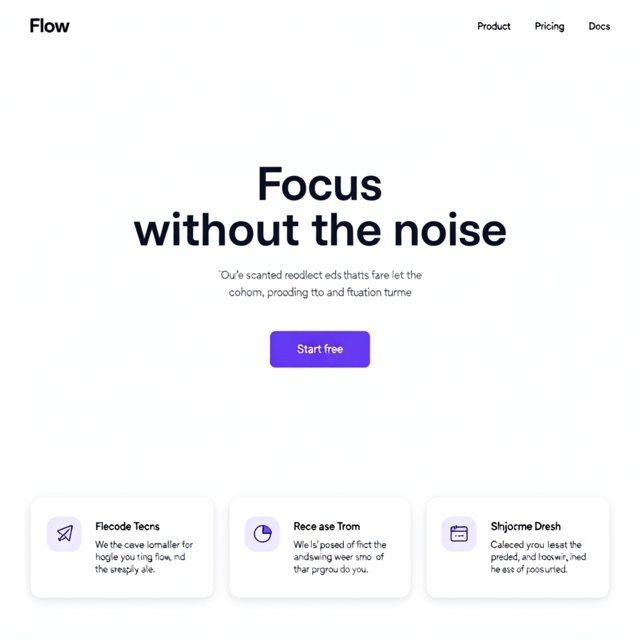
Las cadenas entre comillas bien, todo lo demás texto de relleno que a primera vista parece real.
Las listas largas son donde patinó. Pedimos la carta de un café de 12 líneas con precios en dos columnas. Dibujó una columna. Escribió "6.0l)" en lugar de 6.00 y "1110.0" en lugar de 11.00. También añadió una línea de café que nunca pedimos, "Bica 0.50".
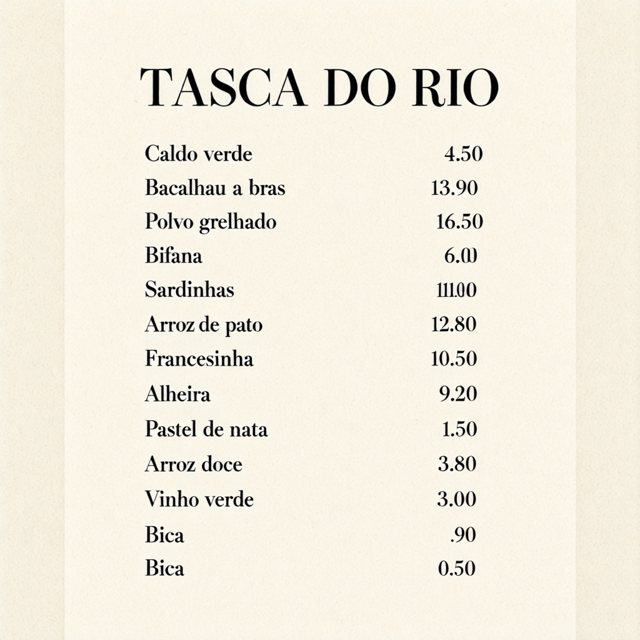
Dos precios mal y una línea inventada.
Los autores recomiendan reescribir cada prompt como una descripción estructurada, al estilo de Figma, con un modelo de lenguaje aparte antes de que llegue a Ming. Nosotros enviamos prompts normales.
Transparencia: una variante de seis, y solo con la frase en su propia línea
Una variante de seis salió transparente. El salto de línea importó en una pareja, pero no bastó por sí solo.
Los autores publican diez frases fijas y piden poner exactamente una al principio del prompt. Usamos "RGBA, 4-channel, transparent background" sola en la primera línea y después la descripción del sticker. El zorro salió con el 83,2 % de sus píxeles totalmente transparentes, un recorte limpio. Lo hizo dos veces: una con nuestro propio prompt y otra con la opción de transparencia de nuestro servidor.
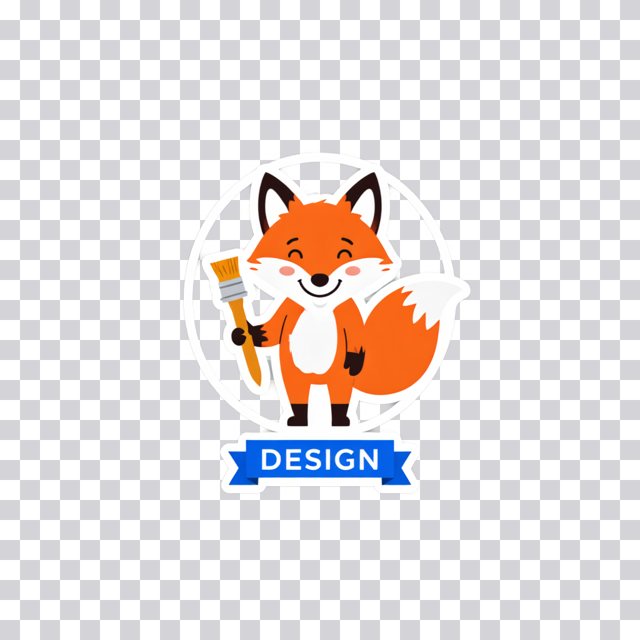
Con una coma después de la frase en lugar de un salto de línea, el fondo salió blanco sólido, como muestra la imagen del principio. Un icono de app con la misma frase en su propia línea salió opaco. Otras tres combinaciones de frase y tema también, todas listadas en el apéndice. Los prompts normales siguen devolviendo un PNG de cuatro capas, casi todo opaco, con algunos píxeles parcialmente transparentes.
Nuestro código de servidor devuelve la proporción de píxeles transparentes con cada imagen, así que esa comprobación es una línea.
Qué GPU: una tarjeta de 80 GB funcionó, y no se probó nada más pequeño
La única tarjeta que funcionó es la única que probamos, una NVIDIA A100 real de 80 GB, con todo en la tarjeta. Así que 80 GB es el requisito tal y como lo validaron los autores.
Habíamos planeado un segundo paso: limitar la memoria de la A100 a 24 GB para emular una tarjeta más pequeña, con el modelo de lenguaje de 34 GB esperando en la memoria principal del ordenador. Sobre el papel tiene sentido, porque el modelo de lenguaje solo trabaja una vez por prompt, al principio. Cambiar el ajuste no reinició el modelo en marcha, que siguió entero en la tarjeta durante siete minutos, así que el paso nunca se ejecutó. El bug del reinicio sigue abierto.
En InferenceKey: tu código de imágenes de OpenAI puede llamar a esta tarjeta
Un programa que ya pide imágenes a OpenAI puede pedírselas a esta tarjeta, cambiando la dirección, la clave y los ajustes. Ming se distribuye como un script de Python, no como un servidor. Así que lo envolvimos en un backend pequeño, código que carga un modelo una vez y responde peticiones. El nuestro descarga el código de los autores en una versión fija y carga el modelo una vez con su cargador. Después llama a su función de generación en cada petición.
El primer arranque tardó 157 segundos: unos 50 GB descargados en 69 y cargados en la tarjeta en 23. Esa versión falló en la primera imagen, y no cronometramos un arranque limpio de la versión corregida. Un reinicio tras una actualización tardó 29 segundos.
Las versiones exactas de librerías de los autores no se instalan y ejecutan tal cual en Python 3.11; unas algo más nuevas lo arreglan, y el ejemplo del SDK trae esas. Estado: arreglado en el ejemplo, issue a los autores pendiente de abrir.
Un detalle sin pulir con el que también te puedes encontrar:
- Las imágenes grandes pueden ser demasiado grandes para devolverlas. Nuestro montaje de prueba podía devolver como mucho 8 MB por respuesta. Dos imágenes detalladas de 2048 salieron más grandes, se descartaron, y quien llamaba esperó los 300 segundos completos hasta un timeout. Estado: el backend del ejemplo del SDK ahora reduce el fichero hasta que cabe, probado solo con imágenes guardadas. La espera larga sigue abierta.
¿Deberías usarlo? Sí para texto entre comillas en una tarjeta de 80 GB, revisando cada recorte
- Si haces maquetas de apps, diapositivas, dashboards o carteles con texto que puedes escribir, pon entre comillas cada palabra que necesites.
- Si necesitas listas largas o números exactos, como una carta, una lista de precios o una tabla, lee cada línea.
- Si necesitas recursos transparentes, pon la frase en su propia línea y comprueba la capa alfa en código.
- Si tu tarjeta tiene menos de 80 GB, de momento cuenta con una tarjeta de 80 GB.
- Si necesitas una licencia para un producto, MIT cubre el uso comercial.
Para hacer una pantalla, una infografía y un sticker en tu máquina NVIDIA, publica el backend con python publish.py y ejecuta IK_KEEP_ALIVE=1 python main.py desde el ejemplo del SDK. Necesita una tarjeta de 80 GB en un proyecto de InferenceKey y unos 60 GB de disco.
Para ingenieros
Modelo y ficheros
Ficha del modelo, GitHub (inclusionAI/Ming-Image), receta de vLLM-Omni, Space de demo. Repo inclusionAI/Ming-Image-0.1-Design, creado el 2026-09-17T07:17:31Z, lastModified 2026-10-14T04:22:50Z, sha c57c49689d12ef7d4e24a170014f1dc43d3ce258, sin acceso restringido, etiqueta de licencia mit, library_name: custom, 435 likes y 1.191 descargas a 2026-10-23. Los metadatos safetensors de HF cuentan 6.154.901.056 parámetros BF16, que coinciden con el transformer solo.
| Componente | Qué es | Tamaño |
|---|---|---|
mllm/ | BailingMM2: Ling bailing_moe_v2, 20 capas, 256 expertos, 8 activos, hidden 2048, más un ViT de Qwen2.5; 7 shards | 34,018 GB |
transformer/ | DiffusionTransformer, dim 3840, 30 capas, 30 heads; 5 shards (los "6B") | 12,310 GB |
connector/ | Qwen2 1.5B en fp32 | 6,175 GB |
vae/ | AutoencoderKLQwenImage, 4 canales de entrada | 0,254 GB |
mlp/ | 0,125 GB | |
assets/ | 0,002 GB | |
| Total | 52,883 GB |
Scheduler FlowMatchEuler, shift 6. La receta de vLLM-Omni describe lo mismo como Stage 0 (torre de visión de Qwen2.5-VL más el LM BailingMoeV2 de 20 capas, 256 tokens de consulta de imagen aprendidos, estados de consulta más estados del VLM de las capas 5, 12 y 20) y Stage 1 (el conector más un DiT Z-Image de 30 capas con un VAE RGBA de Qwen-Image).
En el código de los autores no hay lógica RGBA del lado del prompt: el VAE tiene 4 canales e infer.py guarda con image.save como PNG, así que cada imagen es RGBA y el alfa depende solo de lo que genere el modelo (processing_bailingmm2.py:165, infer.py:246-257).
Ajustes
Ficha del modelo: 2048 x 2048 recomendado, 1024 x 1024 para generar más rápido, 12 pasos de muestreo, CFG 1,0, BF16, "una GPU CUDA con 80 GiB de VRAM (configuración validada)". Los buckets de texto a imagen de infer.py son (1024, 2048), 2048 por defecto, relación de aspecto entre 1:4 y 4:1, bucket más cercano por sqrt(width*height). Valores por defecto: semilla 42, bfloat16, atención eager, --num-gpus 1, --device-map balanced (el reparto del MLLM entre varias GPU está soportado, no lo probamos).
Las diez frases de transparencia (README, "Transparent-background generation tip"): elige exactamente una y ponla al principio, sin combinarlas. En inglés: RGBA, 4-channel, transparent background, isolated subject, alpha matte, no background, cutout PNG, alpha=0 outside the object, transparent canvas, not white, not checkerboard, production RGBA layer for compositing, más cinco frases en chino.
Los autores recomiendan un prompt JSON estructurado al estilo de Figma salido de un prompt enhancer (Ling-3.0-flash-VL o qwen3.8-27B) que se ejecuta fuera de infer.py. Nosotros usamos prompts normales.
Los valores por defecto del probador de imágenes del panel (20 pasos, guidance 4,5) no son los de este modelo: pon 12 y 1.
Nuestro montaje
Una NVIDIA A100-SXM4-80GB en nuestra nube (81.920 MiB, driver 595.71.05, límite de consumo de 400 W, 32 vCPU, 125 GB de RAM en el contenedor). La variante PCIe no tenía stock. El worker lo arrancó un manager local de InferenceKey a través de túneles HTTP y TCP; producción no se tocó en ningún momento. Venv del backend: Python 3.11, torch 2.5.1, torchvision 0.20.1, transformers 4.57.1, diffusers 0.36.0, numpy 1.26.4, aprovisionado con uv. Código de los autores en el commit 3515cd7b1e3049fc517eed7d35020251cd06519a (2026-09-28), que seguía siendo el HEAD de main el 2026-10-23.
Despliegue paso a paso
El ejemplo del SDK, commit 1e88edaa en main (ficheros: README.md, backend.py, publish.py, main.py, requirements.txt, .env.example, .gitignore). Necesitas un token del SDK (INFERENCEKEY_SDK_TOKEN, control plane), una API key (INFERENCEKEY_API_KEY, data plane), INFERENCEKEY_PROJECT, el IK_WORKER_ID de un worker NVIDIA privado (con 80 GB el modelo entero se queda en la GPU) y, para publish.py, opcionalmente INFERENCEKEY_TENANT_ID más INFERENCEKEY_USER_TOKEN (o subir dist/*.tar.gz en el dashboard). Unos 53 GB de disco para los pesos más un venv de 6 GB. Cliente con Python 3.9 o superior; el backend corre en Python 3.11 aprovisionado con uv.
cp .env.example .env              # tokens, project, worker id
python publish.py                 # packages backend.py, registers "ming-image-design-text2image" (v0.1.4)
IK_KEEP_ALIVE=1 python main.py    # ensure(), wait_until_ready(), 3 pictures into ./outputs
main.py despliega el workload ming-image-design (task text2image, política fixed, 1 réplica, config del workload ready_timeout_secs: 2400, request_timeout_secs: 900) y escribe outputs/ui-1024.png, outputs/infographic-2048.png y outputs/sticker-rgba-1024.png. Si el workload ya está levantado, llama directamente al endpoint en lugar de volver a ejecutar main.py (ver problemas).
Una petición de sticker transparente (llamamos a nuestro manager local; el servicio alojado acepta la misma forma, aunque no lo llamamos):
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/ming-image-design/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "n": 1, "prompt": "A cartoon fox sticker holding a paintbrush above a ribbon that says \"DESIGN\"", "size": "1024x1024", "seed": 42, "steps": 12, "guidance_scale": 1.0, "background": "transparent", "output_format": "png"}'
background: "transparent" hace que el backend ponga RGBA, 4-channel, transparent background sola en la primera línea. La respuesta es {data: [{b64_json}]} más seconds (tiempo de GPU), vram_peak_gib, bucket y transparent_fraction.
Backend
backend.py. Los backends ya hechos de InferenceKey no ejecutan scripts de modelos, de ahí este a medida. setup() descarga el tarball del código de Ming-Image en 3515cd7b a ~/.cache/ming-image-code/<sha>, ejecuta snapshot_download de la revisión c57c4968 (saltándose assets/) y carga BailingMM2NativeForConditionalGeneration.from_pretrained(..., torch_dtype=bf16, attn_implementation="eager", load_image_gen=True, device_map=<authors' 1-GPU plan>) más el processor. process() lee prompt, size o width/height, steps/num_inference_steps (12), guidance_scale (1.0), seed, background, output_format (png o webp, los dos conservan el alfa) y llama a run_generation de los autores. Los modos de memoria auto, gpu, lowvram (capas MoE del LLM en CPU a través del device map), minimal (también el conector y parte del DiT bajo cpu_offload de accelerate, tiling del VAE) y el límite MING_VRAM_LIMIT_GIB (torch.cuda.set_per_process_memory_fraction) están escritos pero nunca se ejecutaron en una GPU. Versiones durante la prueba: 0.1.0 (pins de los autores), 0.1.1 (numpy 1.26.4), 0.1.2 (torch 2.5.1), 0.1.3 (frase RGBA en su propia línea, probada), 0.1.4 (bajada escalonada de calidad WebP para resultados de más de 8 MB, en el commit, probada solo offline).
Tiempo hasta estar listo
- Arranque en frío con el paquete 0.1.0: el SDK dice
ready after 157 s(venv nuevo unos 60 s; log del backenddownload 69.1s, load 23.4s, memory mode gpu (budget 78.3 GiB), weights in VRAM 46.3 GiB; unos 50 GB descargados, sin assets, a unos 0,7 GB/s). Ese paquete falló después en la primera petición (bug de torch, más abajo). - Paquete 0.1.2, torch cambiado dentro del venv existente: 6 min 46 s de
uv pip install, despuésdownload 8.3s, load 21.6s. - Reciclado en caliente tras publicar 0.1.3: 29 s (
download 4.6s, load 20.9s). - No se cronometró un arranque en frío limpio con el paquete final.
Mediciones
Tiempo de GPU medido en el backend con cuda.synchronize(); ida y vuelta del cliente HTTP al manager local. 12 pasos, CFG 1, una petición cada vez, atención eager, sin flash-attn, sin compilación, sin caché de pasos (un stack optimizado debería ser más rápido; no medido).
| Caso | Bucket | GPU s | Ida y vuelta s | Pico asignado por torch GiB | Salida |
|---|---|---|---|---|---|
| ui-1024 (primera llamada) | 1024 | 7,397 | 14,73 | 50,45 | png |
| infographic-2048 | 2048 | 35,849 | 41,49 | 62,84 | png, 2,1 MB |
| sticker, frase + coma | 1024 | 6,257 | 7,45 | 50,45 | png, opaco |
| fox-zh-nl / fox-en-nl / mug-cutout-nl / logo-zh2 | 1024 | 6,237 / 6,236 / 6,199 / 6,178 | 7,34 / 7,47 / 7,85 / 7,10 | 50,45 | png |
| dashboard | 1024 | 7,135 | 8,39 | 50,45 | png |
| poster-2048 | 2048 | 35,807 | 44,03 | 62,84 | WebP con pérdida (PNG y WebP sin pérdida por encima del límite) |
| logo, background transparent | 1024 | 6,232 | 7,11 | 50,45 | png, opaco |
| taza, background transparent | 2048 | se ejecutó | 504 tras 300,02 | n/d | resultado de 10,6 MB rechazado |
| diapositiva 1920x1080 | 1024 | 5,774 | 7,03 | 49,95 | png |
| carta | 1024 | 6,381 | 8,87 | 50,45 | png |
| carta | 2048 | se ejecutó | 504 tras 300,02 | n/d | resultado de 15,5 MB rechazado |
| sticker, background transparent (frase + salto de línea) | 1024 | 6,224 | 7,47 | 50,45 | png, 83,2 % alfa 0 |
| probador del panel, onboarding de la planta | 1024 | n/d | 8.397 ms en el panel | n/d | png |
| probador del panel, zorro con coma | 1024 | n/d | 7.292 ms en el panel | n/d | opaco |
Unas 2,2 a 2,4 it/s a 1024 y unos 2,8 s/paso a 2048. Sobrecarga de la plataforma de unos 0,8 a 2,5 s a 1024 (7,3 s en la primerísima llamada) y de 5,6 a 8,2 s a 2048 (payload más grande). Memoria de la tarjeta con nvidia-smi cada segundo (2.736 muestras): en reposo con el modelo cargado 47.843 MiB, pico de 65.935 MiB a las 06:11:33Z durante la infografía de 2048; torch reservó hasta 63,88 GiB; pico de consumo de la placa de 450,55 W frente a un límite declarado de 400 W.
Pruebas de transparencia
Alfa comprobado con PIL en cada PNG.
| Frase y colocación | Tema | Resultado |
|---|---|---|
RGBA, 4-channel, transparent background + salto de línea | sticker del zorro | 83,17 % alfa 0 (dos veces: prompt en bruto y la opción background del backend) |
misma frase + , en la misma línea | sticker del zorro | opaco, alfa mínimo 247 |
带透明通道,4通道RGBA图像 + salto de línea | sticker del zorro | opaco |
透明背景,alpha通道,无底图 + espacio | icono de app | opaco |
cutout PNG, alpha=0 outside the object + salto de línea | taza | opaco |
RGBA, 4-channel, transparent background + salto de línea (v0.1.3) | icono de app | opaco, alfa de 253 a 255 |
Los prompts normales devuelven RGBA con alfa de 195 a 255. Una semilla por prompt; no se sabe si esto se generaliza.
Escalera de VRAM
| Objetivo | Config | Pico | Tiempo por salida | Salida OK | Real o emulado |
|---|---|---|---|---|---|
| A100-SXM4-80GB (ejecución principal) | gpu, BF16, todo residente, 12 pasos, CFG 1 | 65.935 MiB en la tarjeta (64,4 GiB) / 62,84 GiB torch a 2048; 50,45 GiB a 1024 | 35,8 s (2048), de 6,2 a 7,4 s (1024) | sí | real |
| Límite de 24 GB en la A100 | lowvram (capas MoE del LLM en CPU), MING_VRAM_LIMIT_GIB=23 | n/d | n/d | no ejecutado | emulado (planeado) |
El peldaño de 24 GB no se ejecutó: ensure() cambiando solo config.env no recicló el backend en marcha (seguía en memory mode gpu 7 minutos después de las 06:30:46Z), y el peldaño se paró ahí. Sin probar: límites de 48, 24 y 16 GB, cualquier tarjeta de consumo real, cualquier cuantización. La estimación de lowvram (unos 18 GiB de pesos más de 4 a 16 GiB de activaciones) es una pista, no un resultado.
Calidad, más detalle
Prompts nuestros, una muestra de cada uno, cada imagen leída a mano. Además de lo contado arriba: el título de la infografía, las otras tres etiquetas de pasos y el pie estaban bien, y sus números de paso aparecen tanto normales como dentro de un círculo; la nota al pie de la diapositiva, "Source: internal billing", estaba bien.
Vídeo de demo
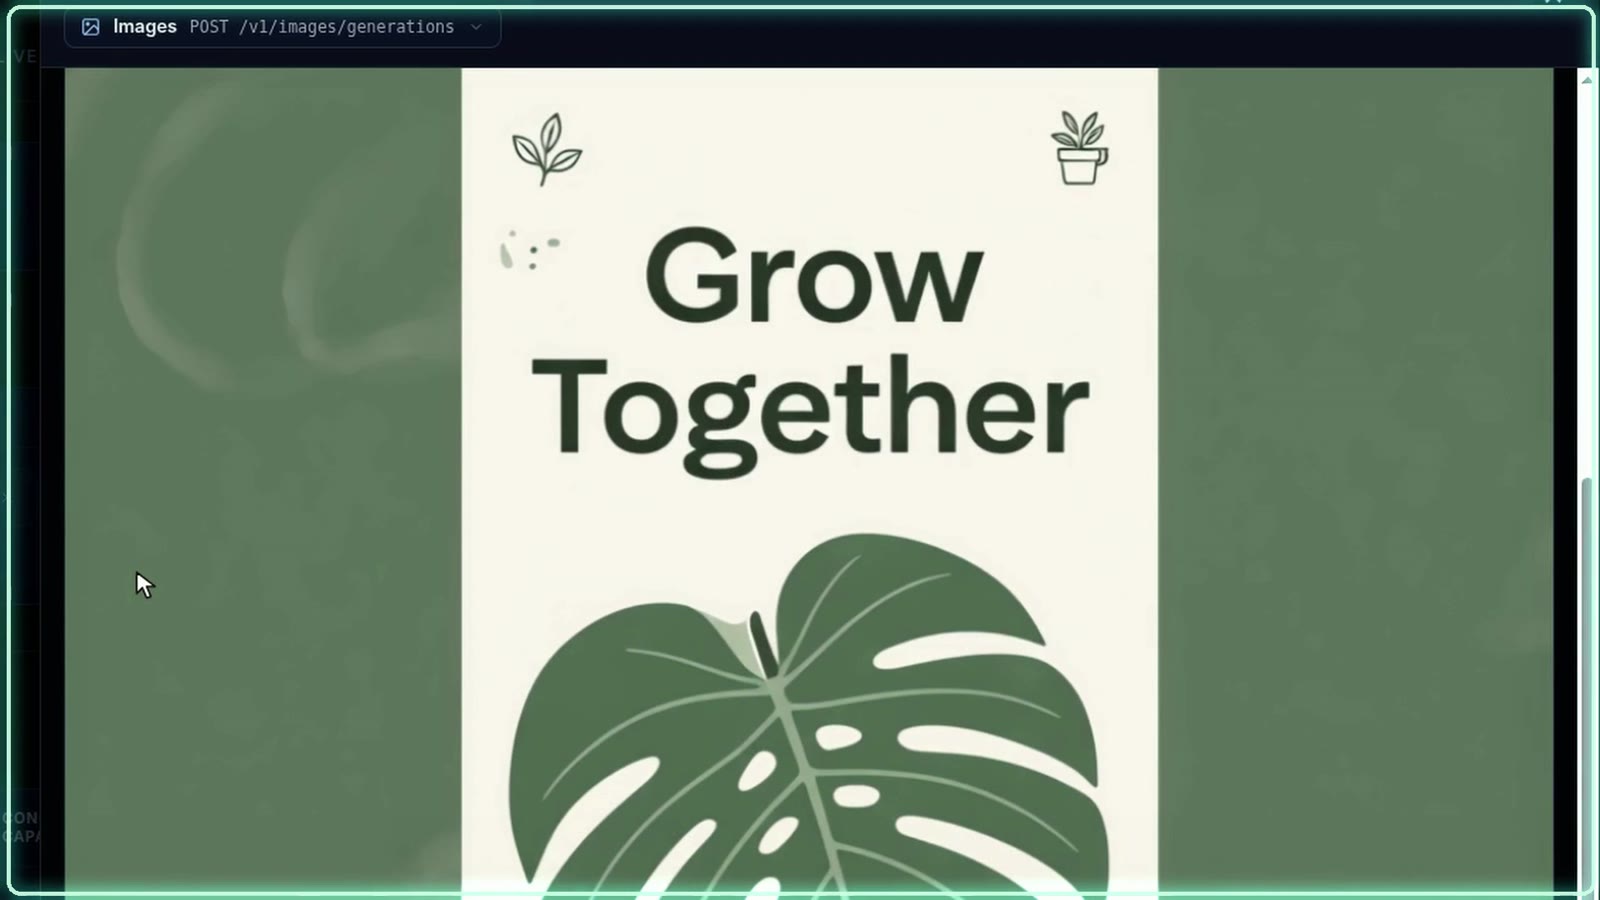
Haz clic para reproducir el MP4 (104 s, narrado). La vista Workloads muestra Ming-Image-0.1-Design en gpu-design-01 (1x NVIDIA A100-SXM4-80GB, Fixed, Healthy). El probador de imágenes, con 12 pasos y guidance 1, hace la pantalla de onboarding de la planta en 8.397 ms, y después el sticker del zorro con la frase seguida de una coma en 7.292 ms, que sale opaco. La empresa del panel, Lumen Design Co, es una cuenta de demo inventada.
Problemas pendientes y estado
- Los pins de los autores no funcionan tal cual.
numpy==1.23.1no tiene wheel para CPython 3.11 (uvempezó a compilarlo desde el código fuente); arreglado con numpy 1.26.4.torch==2.4.0condiffusers==0.36.0falla en la primera petición conTypeError: scaled_dot_product_attention() got an unexpected keyword argument 'enable_gqa'(línea 1814 deattention_dispatch.pyde diffusers, llamada desde la línea 133 dediffusion/transformer.pyde Ming); arreglado con torch 2.5.1 y torchvision 0.20.1. Estado: arreglado en el ejemplo del SDK; issue en inclusionAI/Ming-Image pendiente de abrir. - Cambiar torch dentro de un venv de backend existente tardó 6 min 46 s, porque el worker reutilizó la ruta del venv y ejecutó
uv pip installencima. Estado: abierto. - Los resultados de más de 8 MB se descartan (mensajes de 10.610.209 y 15.530.594 bytes superaron el
max_payloadde JetStream, 8 MB en el contenedor NATS de nuestro stack de prueba; no se comprobó el límite del servicio alojado) y el cliente espera 300,02 s hasta un504 inference_timeout. Estado: el backend 0.1.4 baja la calidad WebP por escalones (90, 82, 74, 66, 58, 50), probado solo offline; la plataforma sigue esperando el timeout completo, abierto. - Volver a ejecutar
ensure()+wait_until_ready()contra un workload ya listo esperó 10 minutos sin ningún evento (worker:custom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel). Estado: abierto; llama directamente al endpoint si el workload está levantado. - Cambiar solo
config.envconensure()no recicló el backend a medida en marcha. Ver la escalera de VRAM más arriba. Estado: abierto. - Ruido inofensivo en los logs: atributos de config inesperados en
AutoencoderKLQwenImage(scaling_factor,shift_factor) y enDiffusionTransformer(siglip_feat_dim), y unRuntimeWarningde runpy.
Alternativas que no probamos
- vLLM-Omni.
vllm serve inclusionAI/Ming-Image-0.1-Design --omni --deploy-config vllm_omni/deploy/ming_image.yaml --port 8091,/v1/chat/completionscompatible con OpenAI conmodalities: ["image"]. Entorno: CUDA 13.0, vLLM 0.29.0, commit6daf5b30fde vLLM-Omni, "2x H100 80GB (1xH100 to be validated)". Benchmark en 2x H100 (1024, 12 pasos, CFG 1, concurrencia 1): 2,219 s de principio a fin sin caché, 2,068 s con TeaCache 0.30, 1,698 s con Cache-DiT 0.16 (SSIM 0,853). La tabla indica vLLM 0.30.0 mientras que el entorno dice 0.29.0. Notas: una petición cada vez, la primera petición de cada forma paga la compilación y la captura de CUDA graphs, tamaños divisibles por 16, se rechaza unnegative_promptno vacío, las salidas conservan los cuatro canales RGBA. No es comparable con nuestras cifras en eager sobre una sola A100. - El Space de demo de hugging-apps. Gradio sobre ZeroGPU (la API informa
zero-a10g, el código pide el tamañoxlarge, así que la GPU real no está verificada), buckets de 1024 y 2048, de 4 a 24 pasos (12 por defecto). Reimplementa el pipeline a partir de la PR #8021 de vLLM-Omni en lugar de llamar ainfer.py, y aplica CFG siempre queguidance_scale > 0, lo que duplica el batch del DiT con 1.0. Sus notas que dicen que el repo de GitHub da 404 y que las frases RGBA no están publicadas están desfasadas. Sirve para probar prompts antes de alquilar una tarjeta: enseña las imágenes, no la velocidad. - Ming-Image-0.1-Design-Layer, mejora de prompts, concurrencia, otras relaciones de aspecto, reparto entre varias GPU.
Límites
15 imágenes (13 por API, 2 desde el panel) más 2 peticiones fallidas, una muestra por prompt, prompts nuestros, una semilla. Un tipo de tarjeta, una petición cada vez. No comprobamos la posición en el leaderboard que muestra la ficha del modelo y que cita el vídeo de AI Search.
Créditos
inclusionAI creó y publicó Ming-Image-0.1-Design bajo MIT, con el código de inferencia y las frases de transparencia. El modelo reutiliza piezas de la familia Ling MoE, el encoder de visión de Qwen2.5, un conector Qwen2, el diseño del diffusion transformer de Z-Image (según la receta de vLLM-Omni) y el VAE de Qwen-Image. El equipo de vLLM-Omni escribió la receta de servicio y su benchmark. hugging-apps publicó el Space de demo. AI Search es donde vimos el modelo. Lo nuestro: el backend a medida, el despliegue en InferenceKey, los arreglos de dependencias y las mediciones.
Fuentes
- Ficha del modelo inclusionAI/Ming-Image-0.1-Design y su API con blobs
- inclusionAI/Ming-Image en GitHub, requirements.txt
- Receta de Ming-Image de vLLM-Omni
- hugging-apps/ming-image-0-1-design-demo
- Vídeo de noticias de AI Search, 2026-09-27, segmento de Ming Image desde el 2:10
- Ejemplo del SDK, commit 1e88edaa