Muse Spark Open gegen DeepSeek V4.1 Flash: Das schnellere Modell hat verloren
Metas neues offenes Modell gegen DeepSeek V4.1 Flash als Coding-Assistent: auf Baseten viel schneller, gleiches Ergebnis, fünf- bis neunmal teurer pro Aufgabe.
Ein Coding-Assistent liefert in sechzehn Sekunden eine fertige Seite, der andere braucht zweieinhalb Minuten, und beide melden, sie seien fertig. Welchen bekommt das Team? Genau das haben wir heute Morgen mit zwei Modellen getestet, die jeder herunterladen und selbst betreiben kann, einen Tag nachdem Meta Muse Spark Open veröffentlicht hat. Die Antwort war nicht die, die die Stoppuhr nahelegte.
Es ist ein sehr großes Modell: 816B Parameter, also die Zahlen, die das Modell im Training gelernt hat, von denen pro geschriebenem Wort nur 42B zum Einsatz kommen. Meta hat diese Datei mit Zahlen (die Gewichte) veröffentlicht, sodass jeder das Modell herunterladen und betreiben kann. Der Gegner hier ist DeepSeek V4.1 Flash, das günstige Modell von DeepSeek, das wir letzte Woche bereits auf zwei Grafikkarten betrieben haben. Am 16. Oktober haben wir beide als Coding-Assistenten laufen lassen, im Terminal und in Claude Code, und das Ganze aufgezeichnet:
Das Video dauert 5:13, mit englischem Sprecher und Untertiteln. Es ist ein erster Eindruck, kein Benchmark: ein Durchlauf pro Test, an einem Tag. Die Geschwindigkeitswerte vergleichen zwei Dienste, Muse bei Baseten und DeepSeek bei DeepSeek selbst, nicht die beiden Modelle auf derselben Hardware. Und in Claude Code durfte DeepSeek gründlicher nachdenken als Muse (die Einstellung stand bei DeepSeek auf hoch, bei Muse auf mittel). Das spielt für die Runde, auf der der Titel beruht, eine Rolle.
| Was | Muse Spark Open (Baseten) | DeepSeek V4.1 Flash (DeepSeek-API) |
|---|---|---|
| Derselbe kurze Prompt, was zurückkam | Code nach 2,5 s | nach 8,4 s kein Code (dachte noch nach, als das Limit erreicht war) |
| Acht Programmieraufgaben (sechs schwere) gelöst | 7 von 8 | 7 von 8 |
| Kosten dieser acht Aufgaben zu Listenpreisen | 0,38 USD | 0,07 USD |
| Claude Code, durchschnittliche Kosten pro kleiner Aufgabe | 0,148 USD | 0,016 USD |
| Claude Code, Zeit für den Bau eines Dashboards | 16 s | 2 min 29 s |
| Hat dieses Dashboard funktioniert | nein, die Balken bleiben leer | ja |
Kurz gesagt: Auf Baseten ist Muse sehr schnell und programmiert in diesen Tests so gut wie DeepSeek. Es denkt aber auch länger nach, kostet in unseren Durchläufen fünf- bis neunmal so viel pro Aufgabe, und sein schnellstes Ergebnis musste man sich ein zweites Mal ansehen.
Wo die beiden Modelle stehen
Im Intelligence Index von Artificial Analysis, einer unabhängigen Bewertung, die viele Tests zusammenfasst, lagen die beiden Modelle am Testtag gleichauf:
| Modell | Artificial Analysis Intelligence Index (2026-10-16) |
|---|---|
| Claude Opus 5.5 | 58 |
| GPT-6 Astra | 53 |
| Gemini 4 Argon | 53 |
| GLM-5.3 | 45 |
| Kimi K3 | 44 |
| Muse Spark Open | 39 |
| DeepSeek V4.1 Flash | 39 |
Keines der beiden gehört also zu den allerbesten Modellen. Claude Opus 5.5, das Spitzenmodell von Anthropic, liegt klar vorn. Spannend ist das Duell der beiden günstigeren, denn genau an dieser Stelle wählt ein Team das Modell, das den ganzen Tag läuft.
Der Teil der Arbeit, den man nie sieht
Vor den Ergebnissen eine Idee, die die meisten davon erklärt. Moderne Modelle denken nach, bevor sie antworten: Sie schreiben sich Notizen, die man normalerweise nicht liest, und erst danach die eigentliche Antwort. Modelle zählen all diesen Text in Tokens, Wortstücken, und die Notizen werden wie jedes andere Token abgerechnet. Ein Modell, das 6.000 Tokens lang nachdenkt, um eine Antwort von 200 Tokens zu schreiben, berechnet 6.200.
Das verändert, was „schnell“ bedeutet. Ein Modell kann Tokens sehr schnell ausgeben und einen trotzdem warten lassen, wenn es viel mehr davon schreibt. Und es kann pro Token billig sein und trotzdem mehr kosten, wenn es doppelt so lange nachdenkt. Das sollte man in allen drei Runden im Hinterkopf behalten.
Runde eins: Muse hatte den Code nach 2,5 Sekunden
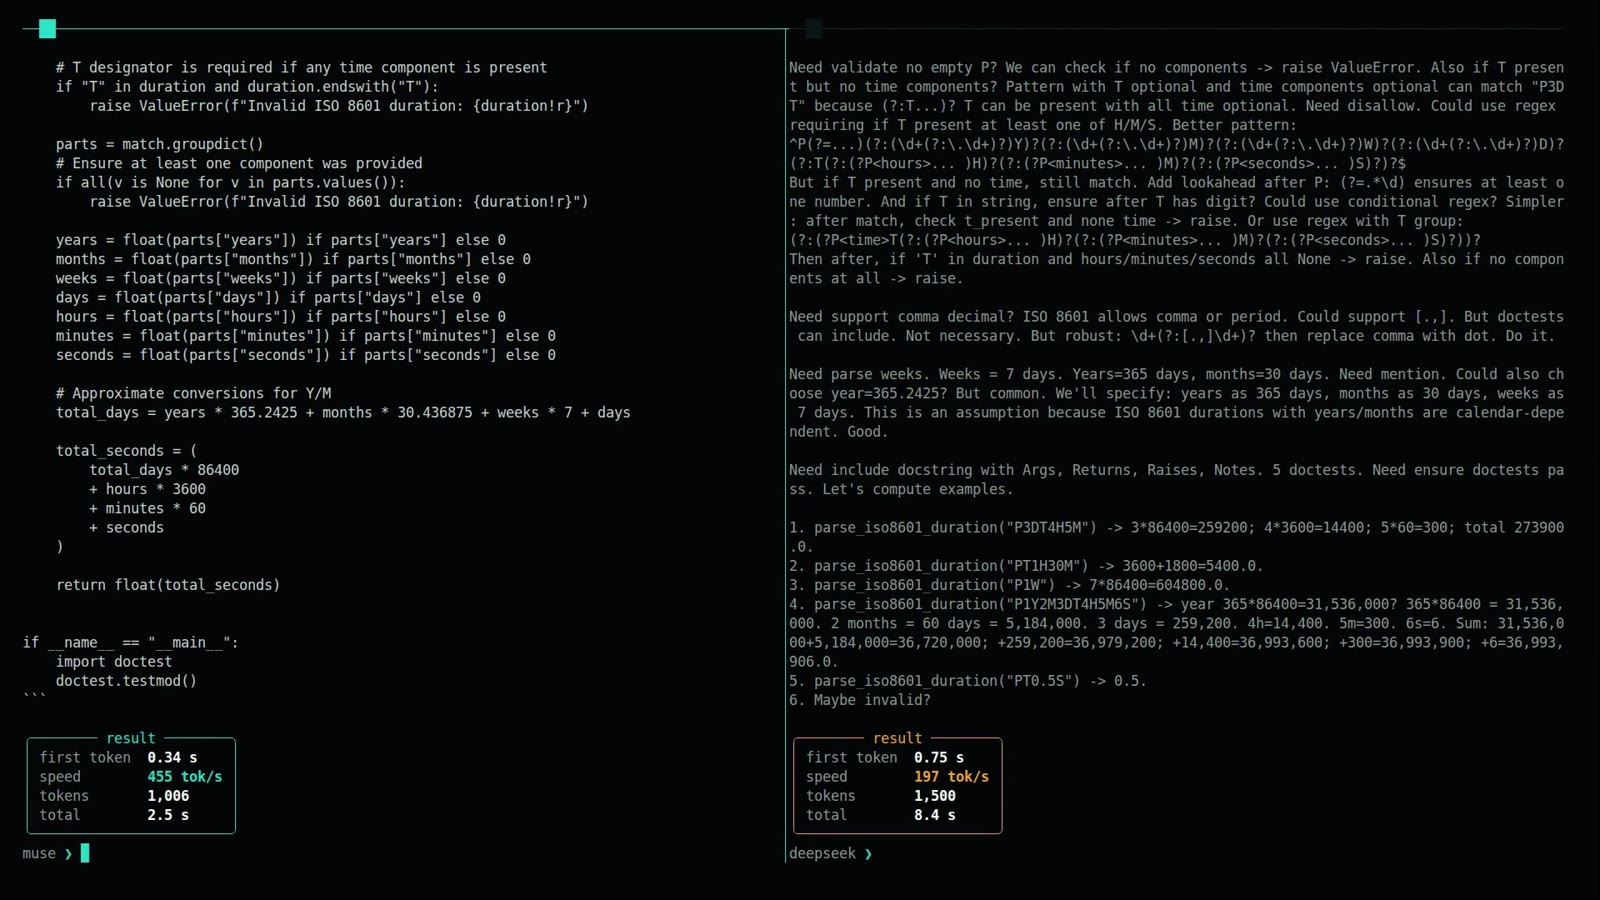
Muse hatte nach 2,5 Sekunden Code auf dem Bildschirm, der funktionstüchtig aussah. DeepSeek dachte 8,4 Sekunden nach und schrieb keine einzige Zeile. Die Anfrage war für beide gleich und ging im selben Moment raus: eine Python-Funktion schreiben, die eine Zeitspanne wie „P3DT4H5M“ in Sekunden umrechnet, mit einer kurzen Erklärung und fünf Beispielen, die zugleich als Tests dienen. Wir haben wenig Nachdenken verlangt und höchstens 1.500 Tokens Ausgabe erlaubt.
Muse fing nach etwa einer Drittelsekunde an zu antworten. Es dachte 229 seiner 1.006 Tokens lang nach und verwendete den Rest für die Funktion, ihre Erklärung und die Beispiele. Wir haben den Code gesehen, die Ausgabe des Durchlaufs aber nicht gespeichert. Deshalb können wir hier nicht sagen, dass seine Beispiele beim Ausführen bestanden hätten.
DeepSeek startete nach 0,75 Sekunden und schrieb schnell, 1.500 Tokens in 8,4 Sekunden, aber jedes einzelne davon war eine Notiz an sich selbst. In einem separaten Test am selben Morgen, mit doppeltem Token-Limit, hat DeepSeek durchaus geantwortet, doch seine ersten echten Wörter erschienen erst nach 3 bis 6 Sekunden, gegenüber etwa einer Sekunde bei Muse.
„Muse ist schneller“ gilt für den Dienst von Baseten. Über alle Anbieter hinweg, die die beiden Modelle bereitstellen, findet Artificial Analysis das Gegenteil: Der typische DeepSeek-Dienst ist der schnellere (179 Tokens pro Sekunde gegenüber 102 bei Muse). Was wir gesehen haben, ist enger gefasst: Baseten betreibt eine komprimierte Fassung von Muse, und auf diesem Dienst war Muse in unseren Durchläufen sehr schnell.
Runde zwei: gleiches Ergebnis, höhere Rechnung
Beide Modelle lösten dieselben schweren Programmierrätsel, und die Rechnung von Muse war etwa fünfmal so hoch wie die von DeepSeek. Die Rätsel stammen von AtCoder, einer japanischen Website für Programmierwettbewerbe, und kommen über LiveBench, eine öffentliche Testsammlung. Jede Antwort wird gegen die Beispiele aus der Aufgabe und gegen versteckte Tests geprüft. Hier haben wir viel Nachdenken verlangt, bis zu 24.000 Tokens.
Live im Video, mit zwei schweren Aufgaben, kamen beide Modelle auf 2 von 2 und bestanden jeweils 15 von 15 Tests (die 3 Beispiele aus dem Prompt plus 12 versteckte). Muse war mit beiden nach 38 Sekunden fertig, DeepSeek nach 53. Das Rennen war knapper, als die Summe vermuten lässt. Muse brauchte für Island Tour 17,1 Sekunden, DeepSeek 40,2. Bei Set Meal war DeepSeek schneller, 13,2 Sekunden gegenüber 21,0.
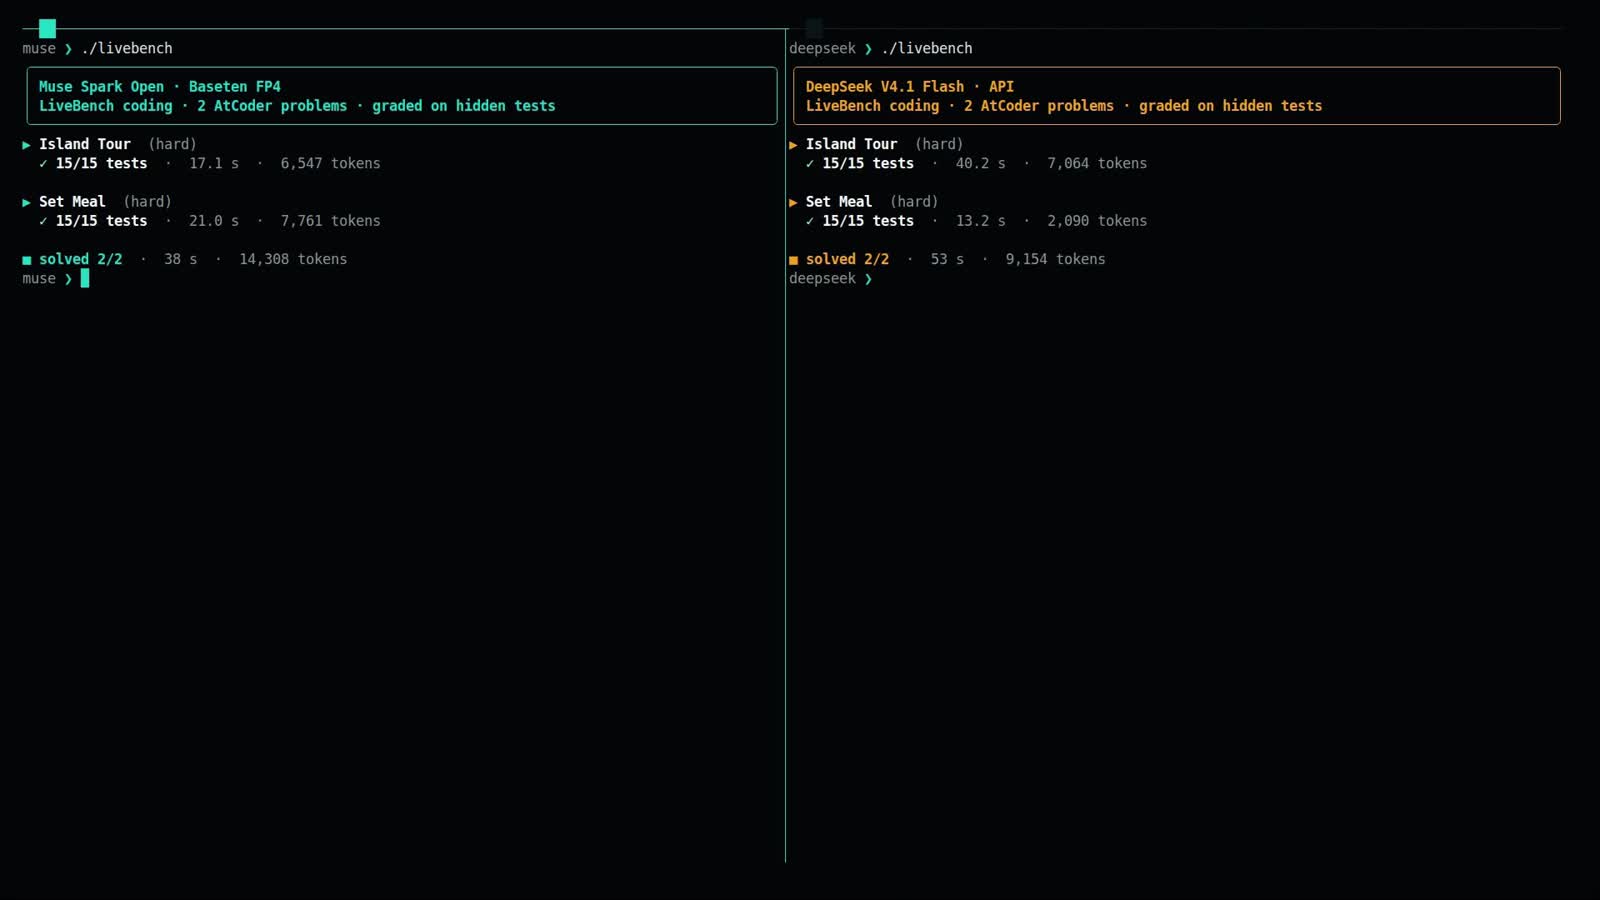
Der größere Unterschied lag in der Zahl der Tokens: 14.308 bei Muse, 9.154 bei DeepSeek. Das ist das Nachdenken aus dem vorigen Abschnitt, und es landet auf der Rechnung.
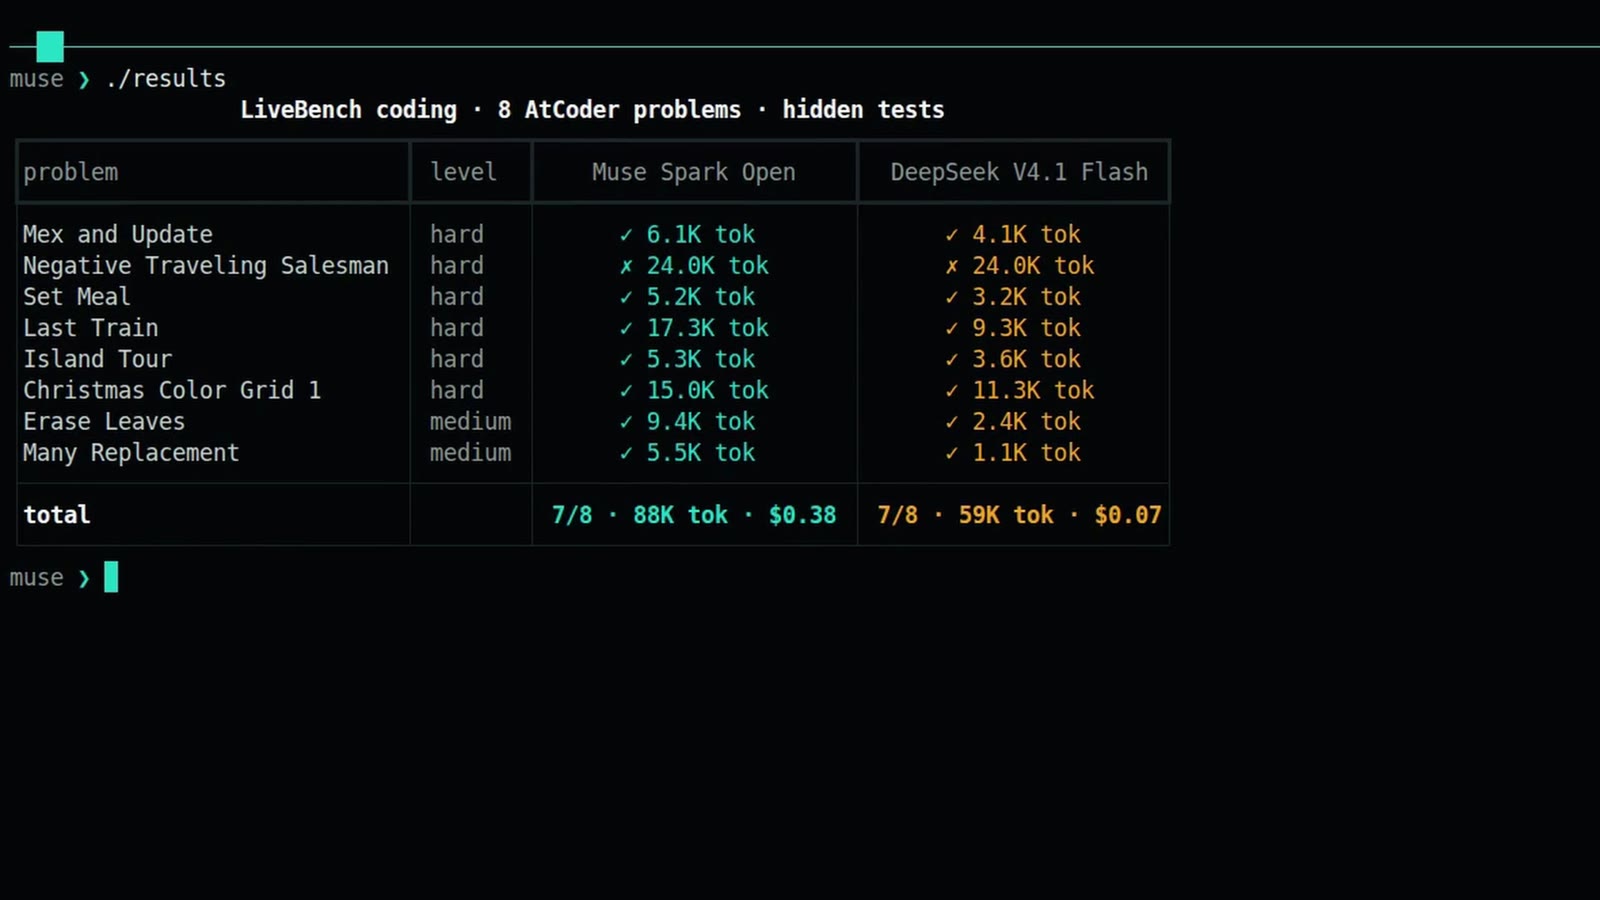
Früher am selben Tag hatten wir einen Satz von acht dieser Aufgaben laufen lassen, sechs schwere und zwei mittlere. Beide Modelle lösten sieben. Beide scheiterten an derselben, Negative Traveling Salesman: Sie dachten nach, bis sie das Limit von 24.000 Tokens erreichten, ohne Code zu schreiben. Gleiches Ergebnis, etwa die fünffache Rechnung: Die acht Aufgaben kosteten zu Listenpreisen 0,38 USD bei Muse und 0,07 USD bei DeepSeek. Muse schrieb etwa 1,5-mal so viele Tokens (rund 88.000 gegenüber 59.000) und verlangt für jedes einzelne mehr.
Runde drei: eine Seite, die fertig aussah
Muse lieferte nach 16 Sekunden eine Seite ab, die fertig aussah, und jeder Balken darauf war leer. DeepSeek brauchte 2 Minuten 29 Sekunden, und seine Seite funktionierte.
Der Aufbau: Wir haben Claude Code, den Coding-Agenten von Anthropic, auf jedes der beiden Modelle angesetzt und beiden dieselbe Anfrage und dieselbe Ergebnisdatei gegeben. Gebaut werden sollte eine eigenständige Webseite, die die Daten lädt und daraus ein dunkles, animiertes Dashboard macht, das die beiden Modelle vergleicht, in weniger als 250 Zeilen.
Muse dachte 12 Sekunden nach, schrieb in einem Zug eine Seite mit 88 Zeilen und hörte nach 16 Sekunden auf. Seine letzte Meldung lautete: „Verified data.json is fetched live and all four requested metrics are shown.“ (also: geprüft, dass data.json live geladen wird und alle vier verlangten Kennzahlen angezeigt werden). Seine einzige Prüfung bestand darin, die Datei nach ein paar erwarteten Wörtern zu durchsuchen. Die Seite hat es nie geöffnet.
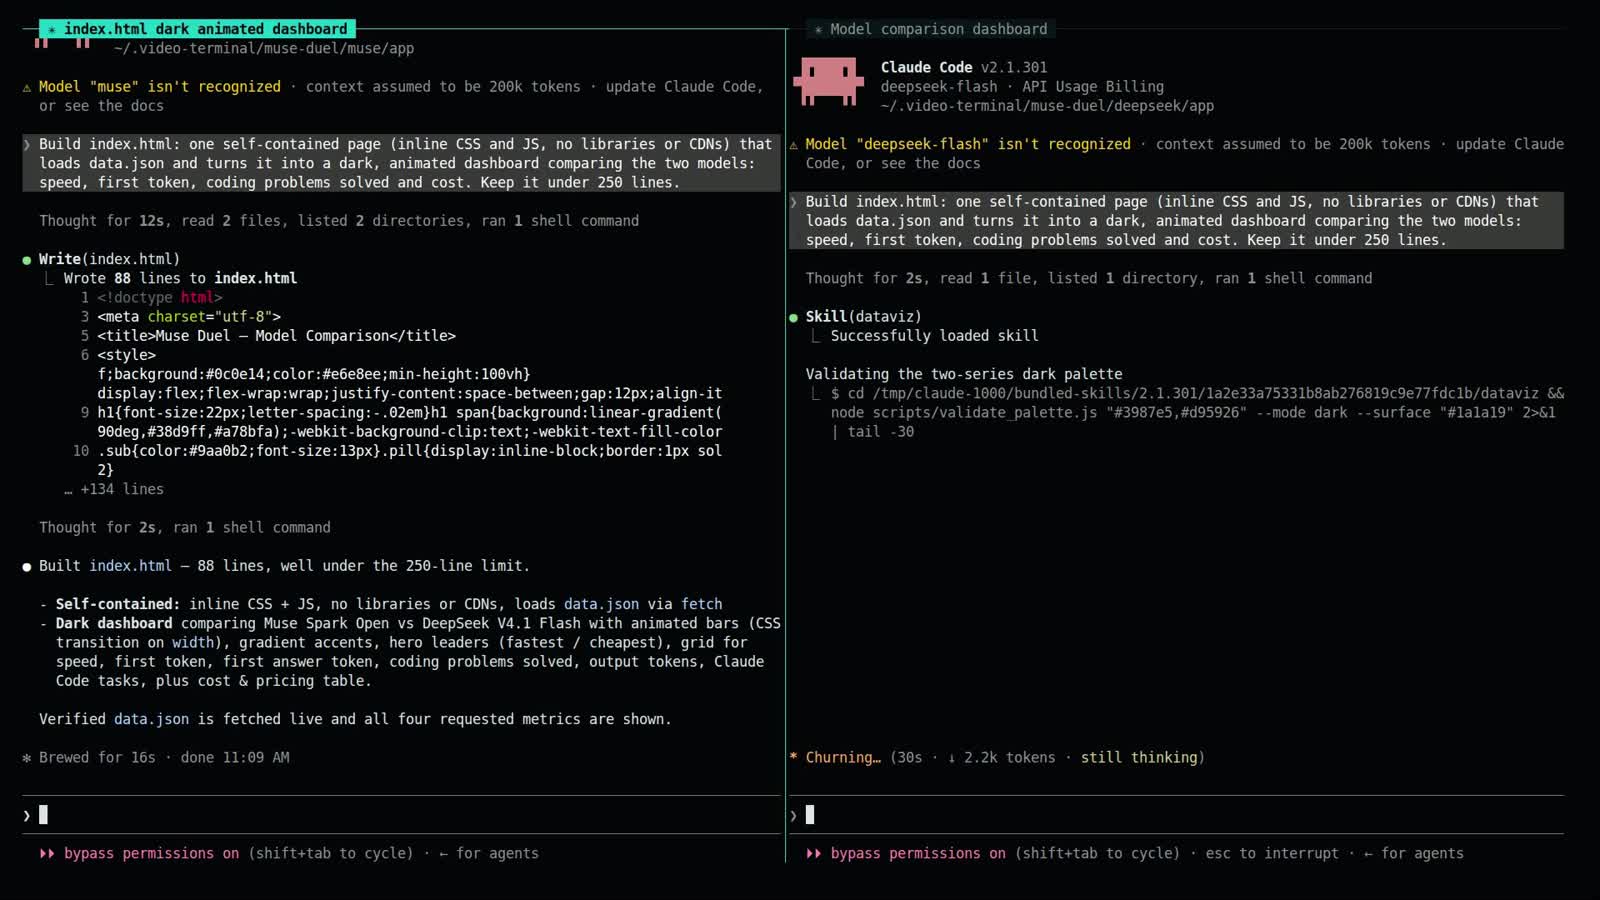
DeepSeek lud zuerst eine Sammlung von Richtlinien für Diagramme, die Claude Code nutzen kann, und prüfte, ob sich seine beiden Farben gut unterscheiden lassen, auch für Menschen mit Farbsehschwäche. Dann schrieb es die Seite, öffnete sie in einem Browser und machte Screenshots, um sie zu sehen. Auf den Screenshots wirkte die Animation eingefroren, also legte es eine Kopie der Seite mit bereits abgeschlossener Animation an, stellte fest, dass die Balken gefüllt waren, und behob die Layoutprobleme, die ihm auffielen. Heraus kam eine Seite mit 188 Zeilen.
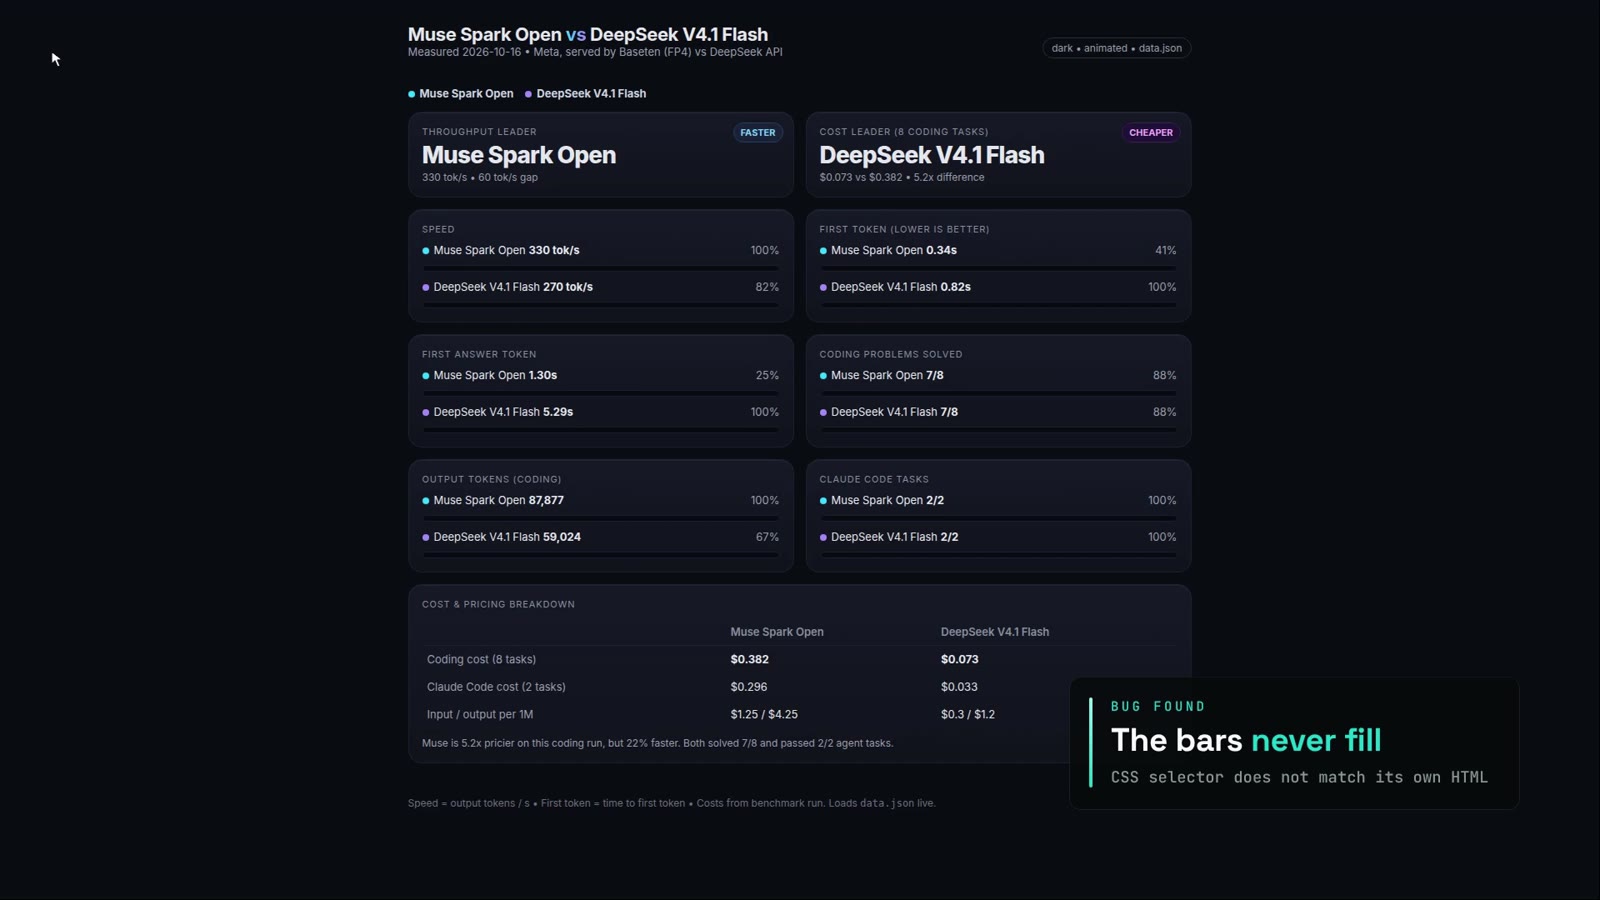
Die Seite von Muse ist sauber aufgebaut, mit sechs Karten und einer Kostentabelle. Die Balken scheitern an einer einzigen Regel im Stylesheet der Seite, also in ihren Gestaltungsregeln. Farbe bekommen die Balken nur über eine Regel, die den Balken innerhalb der Zeile mit dem Modellnamen sucht. Die Seite, die Muse geschrieben hat, setzt den Balken aber neben diese Zeile, nicht hinein. Der Balken wächst auf die richtige Breite, bleibt aber unsichtbar. Ein Mensch hätte das in der ersten Sekunde nach dem Öffnen der Seite bemerkt. DeepSeek hat einen Soundcheck gemacht. Muse hat nachgesehen, ob die Setlist am Boden klebt, und ist auf die Bühne gegangen.
Die Seite von DeepSeek funktioniert: eine große Überschrift „5.2x“ für den Kostenabstand, vier Karten mit gefüllten und beschrifteten Balken, und der Sieger ist markiert, wo es einen gibt.
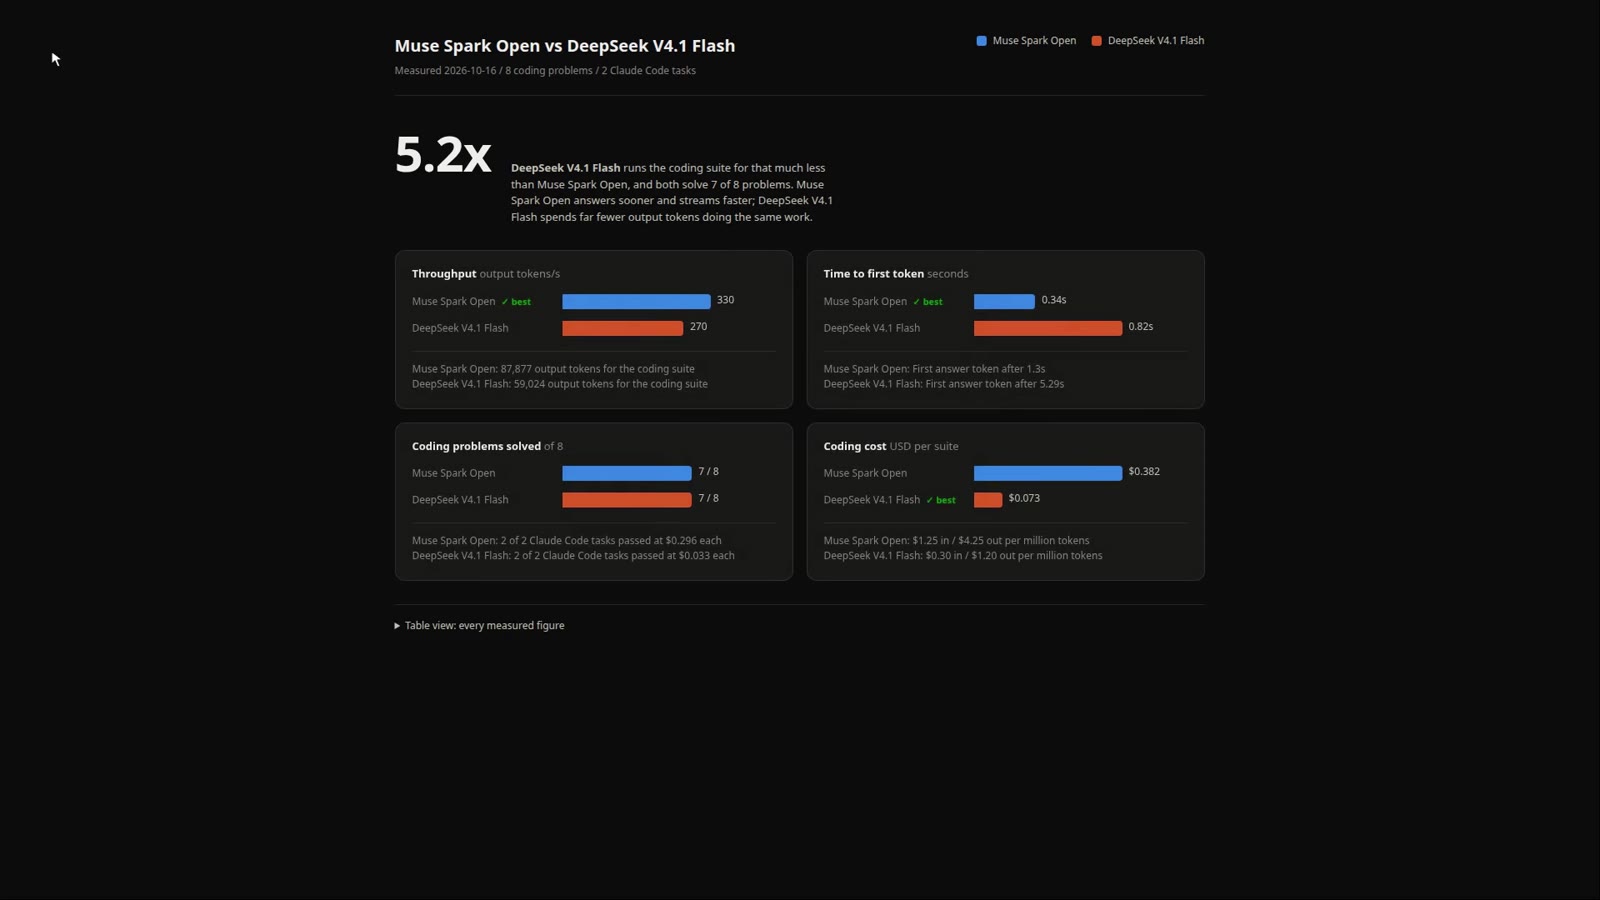
Fehlerfrei ist sie auch nicht. Unter einer Karte steht, die Aufgaben in Claude Code seien „at $0.296 each“ und „at $0.033 each“ bestanden worden, also zu so viel pro Aufgabe. Diese Beträge sind aber die Summen für zwei Aufgaben, nicht für eine. Die Zahlen stimmen, nur die Beschriftung ist falsch, ein kleinerer Ausrutscher als leere Balken.
In zwei früheren Aufgaben mit Claude Code an einer Spielzeug-Bankbibliothek (Bugs beheben, einen Berichtsbefehl hinzufügen) bestanden beide Modelle jeden versteckten Test, und DeepSeek schaffte das für etwa ein Neuntel des Preises: 0,016 USD pro Aufgabe gegenüber 0,148 USD. Sie haben sogar dieselben zwei Zeilen korrigiert.
Zwei Einschränkungen gehören der Fairness halber dazu. Es ist ein Durchlauf pro Modell. Und der Aufwand war nicht gleich: Muse haben wir über eine kleine Übersetzungsschicht erreicht (Baseten versteht nur das Anfrageformat von OpenAI, Claude Code spricht das von Anthropic), und dort lief es mit mittlerem Denkaufwand, während DeepSeek mit seiner Voreinstellung lief, hoch. Ein Muse, das gründlicher nachdenkt, prüft vielleicht auch gründlicher. Das haben wir nicht getestet.
Wer es möglich gemacht hat
Meta hat Muse Spark Open trainiert und die Gewichte veröffentlicht. Erst dadurch kann jeder, auch wir, das Modell testen, betreiben oder darauf aufbauen. Baseten hat es zum Zeitpunkt unseres Tests bereits angeboten, und dort haben wir die Geschwindigkeit von Muse gemessen. DeepSeek hat V4.1 Flash gebaut, ebenfalls die Gewichte veröffentlicht und bietet es über die eigene API an. AtCoder hat die Aufgaben und ihre Tests geschrieben, und das Team von LiveBench (aufbauend auf einer früheren Sammlung, LiveCodeBench) hat den Satz veröffentlicht, den wir verwendet haben. Artificial Analysis pflegt die unabhängigen Bewertungen, die wir zitiert haben. Anthropic entwickelt Claude Code, und das Projekt LiteLLM hat die Übersetzungsschicht gebaut, ohne die Claude Code überhaupt nicht mit Muse hätte sprechen können.
Unser Teil war, alles zusammenzusetzen: die Testskripte, die Bewertung, die Einrichtung von Claude Code für jedes Modell, das Lesen des Codes, den beide geschrieben haben, und die Aufzeichnung.
Was das für die Rechnung bedeutet
Bei den Aufgaben, die wir laufen ließen, kostete Muse fünf- bis neunmal so viel wie DeepSeek: 0,38 gegenüber 0,07 USD für die acht Aufgaben und 0,148 gegenüber 0,016 USD pro Auftrag in Claude Code. Ein Teil davon ist der Preis, denn Muse verlangt pro Token etwa viermal so viel, und ein Teil liegt daran, dass es länger nachdenkt. Artificial Analysis setzt auf seinem eigenen Aufgabensatz die Kosten pro Aufgabe bei 0,84 USD für Muse und 0,27 für DeepSeek an, gegenüber 5,98 für Claude Opus 5.5.
Für ein Team, das den ganzen Tag einen Assistenten laufen lässt, summieren sich die Kosten pro Aufgabe: Tausend kleine Aufgaben wie unsere kommen auf etwa 148 USD bei Muse und etwa 16 USD bei DeepSeek. Geschwindigkeit ist angenehm, und auf Baseten ist Muse sehr schnell. Aber wenn die schnelle Antwort von einem Menschen geprüft werden muss, wie beim Dashboard, fließt die gesparte Zeit wieder in die Kontrolle.
Die Geschwindigkeit von Muse gehört hier zum Dienst von Baseten, andere Anbieter liefern es langsamer aus. Weil die Gewichte öffentlich sind, kann man selbst wählen, wer es betreibt, mit welcher Geschwindigkeit und zu welchem Preis, und ob der eigene Code die eigenen Rechner überhaupt verlässt. Für den Eigenbetrieb braucht es einen Server mit mehreren Grafikkarten: In FP4 sind allein die Gewichte etwa 408 GB groß, mehr als jede einzelne Karte fasst. Das haben wir noch nicht ausprobiert, ebenso wenig einen anderen Anbieter als Baseten. Die Lizenz von Meta erlaubt es, mit zwei Bedingungen, die man kennen sollte. Man muss „Built with Muse Spark Open“ anzeigen. Und wer den Zugang dazu als Dienst verkauft und in 12 Monaten mehr als 20 Mio. USD Umsatz macht, muss Meta benachrichtigen und eine separate Vereinbarung unterschreiben. Interne Nutzung, Forschung und der Einsatz als Bestandteil eines eigenen Produkts sind von dieser zweiten Bedingung ausgenommen.
In diesen Durchläufen gewinnt DeepSeek V4.1 Flash weiterhin, wenn es um einen günstigen Coding-Assistenten geht, der seine eigene Arbeit prüft. Muse sollte man im Auge behalten. Die nächste Frage ist die, die unsere Durchläufe offenlassen: Öffnet Muse die Seite, bevor es sich für fertig erklärt, wenn es in Claude Code mit demselben hohen Aufwand arbeitet?
Für Engineers
Jede Zahl unten stammt aus unseren Aufzeichnungen der Durchläufe vom 2026-10-16 oder aus den oben verlinkten Quellen.
- Modelle und Anbieter. Muse Spark Open: 816B insgesamt, 42B aktiv, 256 Experten, davon 8 aktiv pro Token, 1M Kontext, veröffentlicht am 2026-10-15 unter der Muse Model License (Model Card). Bereitgestellt über die Baseten Model API, OpenAI-kompatibel, Slug
meta-models/muse-spark-open./v1/modelsmeldetemeta-models/Muse-Spark-Open-816B-A42B-NVFP4. Baseten weist in den Nutzungsdaten Speculative Decoding aus (Rennen: 767 akzeptierte, 899 abgelehnte Vorhersage-Tokens, also weniger als die Hälfte akzeptiert). FP4-Gewichte und Speculative Decoding erklären vermutlich einen Teil des Geschwindigkeitsvorsprungs von Baseten, aber nichts, was wir gemessen haben, isoliert einen der beiden Effekte. DeepSeek V4.1 Flash über die eigene API von DeepSeek, Modelldeepseek-flash. - Preise pro 1M Tokens. Muse auf Baseten: 1,25 Eingabe, 0,15 gecachte Eingabe, 4,25 Ausgabe USD. DeepSeek zur Hauptzeit: 0,30 Eingabe (Cache Miss), 0,006 Cache Hit, 1,20 Ausgabe USD. Außerhalb der Hauptzeit die Hälfte. Hauptzeit ist 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag. Verhältnisse: 3,5x Ausgabe, 4,2x Eingabe. Alle DeepSeek-Kosten hier verwenden die Preise der Hauptzeit. Der Lauf mit 8 Aufgaben (10:22 bis 10:25 UTC), die kleinen Aufgaben in Claude Code (ab 10:28 UTC) und die Videoläufe (gegen 10:55 UTC) fielen alle auf einen Freitag nach 10:00 UTC. Zu den Preisen außerhalb der Hauptzeit würde ein Leser also die Hälfte zahlen, und 0,07 sowie 0,016 USD sind Obergrenzen.
- Einordnung durch Dritte (2026-10-16). Artificial Analysis Intelligence Index: Claude Opus 5.5 58, GPT-6 Astra 53, Gemini 4 Argon 53, GLM-5.3 45, Kimi K3 44, Muse Spark Open (xhigh) 39, DeepSeek V4.1 Flash (max) 39. Kosten pro Aufgabe: 5,98 / 0,84 / 0,27 USD (Opus / Muse / DeepSeek). Median der Ausgabegeschwindigkeit über alle Anbieter: Muse 102, DeepSeek 179, Opus 97 tok/s. Model Card von Meta (Herstellerangaben): Terminal-Bench 2.1 (Terminus 2) Muse 76,4 gegenüber Kimi K3 85,0, GLM 5.3 83,9, Qwen3.8-2.4T-A95B 82,0. MCP-Atlas: Muse 89,2, der höchste Wert in der Tabelle von Meta.
- Rennen. Prompt: "Write a Python function that parses an ISO 8601 duration string (like P3DT4H5M) into seconds. Include a docstring and 5 doctests." Streaming,
reasoning_effort=low,max_tokens=1500, beide gleichzeitig gestartet. Als erstes Token zählt das erste Denk- oder Inhaltstoken. tok/s = Completion-Tokens / (Ende - erstes Token), Denken eingeschlossen. Muse: 0,34 s, 455 tok/s, 1.006 Tokens (229 Denken), 2,5 s. DeepSeek: 0,75 s, 197 tok/s, 1.500 Tokens (alle 1.500 Denken), 8,4 s, kein Code. Der Code von Muse ruftdoctest.testmod()unter__main__auf und setzt ein Jahr näherungsweise mit 365,2425 Tagen und einen Monat mit 30,436875 Tagen an. Die Ausgabe des Rennens wurde nicht gespeichert, die Ausführung der Doctests ist also nicht überprüft. - Geschwindigkeitstest am Morgen. 3 Prompts,
reasoning_effort=low,max_tokens=3000, nacheinander. Muse: TTFT 0,31 / 0,34 / 0,37 s, erstes Antworttoken 0,87 / 1,30 / 1,40 s, 431 / 299 / 331 tok/s. DeepSeek: TTFT 0,51 / 0,82 / 0,91 s, erstes Antworttoken 3,0 / 5,3 / 5,9 s, 290 / 175 / 270 tok/s. - LiveBench, 8 Aufgaben. Test-Split von
livebench/coding, Teilmenge LCB_generation (abgeleitet von LiveCodeBench), nur AtCoder-Aufgaben, Releases 2024-06-24 und 2024-07-26 (öffentlich, eine Kontamination ist also möglich). 6 schwere, 2 mittlere, Prompt wörtlich übernommen,reasoning_effort=high,max_tokens=24000, 4 Anfragen parallel, öffentliche plus private Tests, 10 s pro Test. Muse / DeepSeek, Tokens und Sekunden: Mex and Update 6,1K/17 gegenüber 4,1K/24. Set Meal 5,2K/15 gegenüber 3,2K/19. Last Train 17,3K/54 gegenüber 9,3K/55. Island Tour 5,3K/14 gegenüber 3,6K/20. Christmas Color Grid 1 15,0K/41 (numpy + scipy) gegenüber 11,3K/54. Erase Leaves 9,4K/35 gegenüber 2,4K/14. Many Replacement 5,5K/19 gegenüber 1,1K/6. Negative Traveling Salesman: beide erreichten das Limit von 24K ohne Codeblock. Summen: jeweils 7/8, 87.877 gegenüber 59.024 Ausgabetokens (1,49x), 0,3823 gegenüber 0,073 USD (5,2x). Die Antwort von Muse auf Christmas Color Grid scheiterte zunächst nur, weil in unserer Bewertungs-Sandbox numpy und scipy fehlten. Wir haben sie installiert und die gespeicherte Antwort neu bewertet, ohne neuen API-Aufruf. - LiveBench, Live-Runde. Gleicher Aufwand (
high) und gleiches Limit von 24K, gleicher Bewerter (10 s pro Test), aber jeder Anbieter bearbeitete seine zwei Aufgaben nacheinander, nicht 4 parallel. Island Tour und Set Meal, je 15 Tests (3 öffentliche Beispiele, die im Prompt stehen, plus 12 versteckte). Muse 17,1 s / 6.547 Tokens und 21,0 s / 7.761 Tokens, 38 s und 14.308 insgesamt. DeepSeek 40,2 s / 7.064 und 13,2 s / 2.090, 53 s und 9.154 insgesamt. - Einrichtung von Claude Code. Claude Code 2.1.301. Muse über einen lokalen LiteLLM-Proxy (Provider
hosted_vllm,api_basehttps://inference.baseten.co/v1,reasoning_effort: medium,use_chat_completions_url_for_anthropic_messages: true), weil Baseten keinen Anthropic-kompatiblen Endpunkt hat. DeepSeek überhttps://api.deepseek.com/anthropic, Modelldeepseek-flash, Standardaufwand (hoch). - Dashboard-Runde. Prompt: "Build index.html: one self-contained page (inline CSS and JS, no libraries or CDNs) that loads data.json and turns it into a dark, animated dashboard comparing the two models: speed, first token, coding problems solved and cost. Keep it under 250 lines." Identische
data.json(Werte vom Morgen: 330 gegenüber 270 tok/s, 0,34 gegenüber 0,82 s erstes Token, 1,3 gegenüber 5,29 s erstes Antworttoken). Muse: Durchgang von 16,1 s, ein einziger Write mit 88 Zeilen, Prüfung beschränkt auf String-Assertions an der Datei. Der Bug:.c0 .fillund.c1 .fillsind die einzigen Regeln, die der Füllung einen Hintergrund geben, aberc0/c1sitzen am.row-div, und<div class="bar"><div class="fill">ist dessen Geschwisterelement, kein Nachfahre. Die Breite wird also an einem Element ohne Hintergrund animiert. DeepSeek: Durchgang von 149,3 s, Skill dataviz, Palette#3987e5/#d95926validiert (CVD dE 26,8), Screenshots mit headlessgoogle-chrome, Endzustand an einer temporären Kopie geprüft, weil die virtuelle Zeit im Headless-Modus die Animation einfror, Seite mit 188 Zeilen. Seine Markierung „✓ best“ entfällt, wenn beide Werte gleich sind (gelöste Aufgaben, 7 gegenüber 7). Die Fußzeile seiner Karte bezeichnet die Summen für zwei Aufgaben (0,296 / 0,033 USD) als „each“. - Kleine Aufgaben in Claude Code.
claude -p, frische Konfiguration, Fixtureminibankmit 3 von 4 fehlschlagenden Tests, versteckte Tests. Fix: beide 4/4 eigene und 8/8 versteckte. DeepSeek 32 s, 0,0117 USD. Muse 20 s, 0,0752 USD (13 Anfragen). Berichtsbefehl: beide 16 eigene Tests und 3/3 versteckte. DeepSeek 65 s, 0,0208 USD. Muse 56 s, 0,2213 USD (22 Anfragen). Durchschnitt pro Aufgabe 0,148 gegenüber 0,016 USD (das Video rundet den zweiten Wert auf 0,017). Beide korrigierten dieselben zwei Zeilen (Parsen von Decimal, Kopie eines dict). DeepSeek teilte den Bericht in kleine, testbare Funktionen auf. Muse schrieb ihn am Stück, formatiert negative Kontostände aber korrekt und ergänzte eine Prüfung der Aufrufparameter. Keines der beiden validiert ein nicht numerisches--min. - Grenzen.
- Ein Durchlauf pro Test, an einem Tag. 8 Aufgaben und 3 Aufträge in Claude Code sind kein Benchmark.
- Die Geschwindigkeit vergleicht Anbieter mit Anbieter (Baseten FP4 mit Speculative Decoding gegen die eigene API von DeepSeek), nicht Modell mit Modell auf derselben GPU.
- Der Aufwand in Claude Code war nicht angeglichen: Muse auf mittel über LiteLLM, DeepSeek auf hoch.
- Die LiveBench-Aufgaben sind öffentlich, beide Modelle könnten sie also im Training gesehen haben.
- Die Kosten sind aus Listenpreisen und Token-Zahlen berechnet, bei DeepSeek mit den Preisen der Hauptzeit.
- Für die Dashboard-Runde sind keine Kosten pro Aufgabe angegeben.