Muse Spark Open frente a DeepSeek V4.1 Flash: perdió el modelo más rápido
El nuevo modelo abierto de Meta contra DeepSeek V4.1 Flash para programar: mucho más rápido en Baseten, misma nota y de cinco a nueve veces el coste por tarea.
Si un asistente de programación te entrega una página terminada en dieciséis segundos y el otro tarda dos minutos y medio, y los dos dicen que han acabado, ¿cuál le darías a tu equipo? Hicimos esa prueba esta mañana con dos modelos que cualquiera puede descargar y ejecutar, un día después de que Meta publicara Muse Spark Open, y la respuesta no fue la que sugería el cronómetro.
Es un modelo muy grande: 816B parámetros, los números que el modelo aprendió durante el entrenamiento, de los que solo usa 42B para cada palabra que escribe. Meta ha publicado ese fichero de números (los pesos), así que cualquiera puede descargar el modelo y ejecutarlo. Su rival aquí es DeepSeek V4.1 Flash, el modelo barato de DeepSeek, que la semana pasada ya hicimos funcionar en dos tarjetas gráficas. El 16 de octubre pusimos a los dos a trabajar como asistentes de programación, en un terminal y dentro de Claude Code, y lo grabamos:
El vídeo dura 5:13, con voz en off y subtítulos en inglés. Esto es una primera impresión, no un benchmark: una sola ejecución por prueba, en un solo día. Las cifras de velocidad comparan dos servicios, Muse servido por Baseten y DeepSeek servido por la propia DeepSeek, no los dos modelos sobre el mismo hardware. Y dentro de Claude Code dejamos que DeepSeek pensara más que Muse (el ajuste era alto para DeepSeek y medio para Muse), lo que pesa en la ronda en la que se apoya el título.
| Qué | Muse Spark Open (Baseten) | DeepSeek V4.1 Flash (API de DeepSeek) |
|---|---|---|
| Mismo prompt corto, qué devolvió | código en 2,5 s | ningún código tras 8,4 s (seguía pensando cuando llegó al límite) |
| Ocho problemas de programación (seis difíciles) resueltos | 7 de 8 | 7 de 8 |
| Coste de esos ocho problemas a precio de tarifa | 0,38 USD | 0,07 USD |
| Claude Code, coste medio por tarea pequeña | 0,148 USD | 0,016 USD |
| Claude Code, tiempo para construir un dashboard | 16 s | 2 min 29 s |
| ¿Funcionaba ese dashboard? | no, las barras se quedan vacías | sí |
En resumen: en Baseten, Muse es muy rápido y programa igual de bien que DeepSeek en estas pruebas. También piensa más, en nuestras ejecuciones cuesta de cinco a nueve veces más por tarea, y su trabajo más rápido necesitaba que alguien lo revisara.
Dónde está cada modelo
En el Intelligence Index de Artificial Analysis, una puntuación independiente que combina muchas pruebas, los dos modelos estaban empatados el día de la prueba:
| Modelo | Artificial Analysis Intelligence Index (2026-10-16) |
|---|---|
| Claude Opus 5.5 | 58 |
| GPT-6 Astra | 53 |
| Gemini 4 Argon | 53 |
| GLM-5.3 | 45 |
| Kimi K3 | 44 |
| Muse Spark Open | 39 |
| DeepSeek V4.1 Flash | 39 |
Así que ninguno está entre los mejores. Claude Opus 5.5, el modelo principal de Anthropic, va muy por delante. La pelea interesante es entre los dos más baratos, porque ese es el hueco en el que un equipo elige el modelo que va a usar todo el día.
La parte del trabajo que nunca ves
Antes de los resultados, una idea que explica casi todos. Los modelos actuales piensan antes de responder: escriben notas para sí mismos, que normalmente no lees, y solo después escriben la respuesta. Los modelos cuentan todo ese texto en tokens, trozos de palabra, y las notas se cobran como cualquier otro token. Un modelo que piensa 6.000 tokens para escribir una respuesta de 200 te cobra 6.200.
Eso cambia lo que significa "rápido". Un modelo puede soltar tokens muy deprisa y aun así hacerte esperar si escribe muchos más, y puede ser barato por token y aun así salirte más caro si piensa el doble. Tenlo en cuenta en las tres rondas.
Primera ronda: Muse tenía el código en 2,5 segundos
A los 2,5 segundos Muse tenía en pantalla un código con buena pinta. DeepSeek pasó 8,4 segundos pensando y no llegó a escribir ni una línea. La petición era la misma para los dos y salió en el mismo instante: escribir una función de Python que convierta un intervalo de tiempo como "P3DT4H5M" en segundos, con una explicación breve y cinco ejemplos que sirvan también de tests. Pedimos poco razonamiento y permitimos como mucho 1.500 tokens de salida.
Muse empezó a responder en un tercio de segundo, más o menos. Dedicó a pensar 229 de sus 1.006 tokens y el resto a la función, su explicación y los ejemplos. Vimos el código, pero no guardamos la salida de esa ejecución, así que aquí no podemos afirmar que sus ejemplos pasaran al ejecutarlos.
DeepSeek arrancó en 0,75 segundos y escribió rápido, 1.500 tokens en 8,4 segundos, pero todos eran notas para sí mismo. En otra prueba de esa misma mañana, con el doble de límite de tokens, DeepSeek sí respondió, pero sus primeras palabras de verdad tardaron entre 3 y 6 segundos en aparecer, frente a un segundo aproximadamente en Muse.
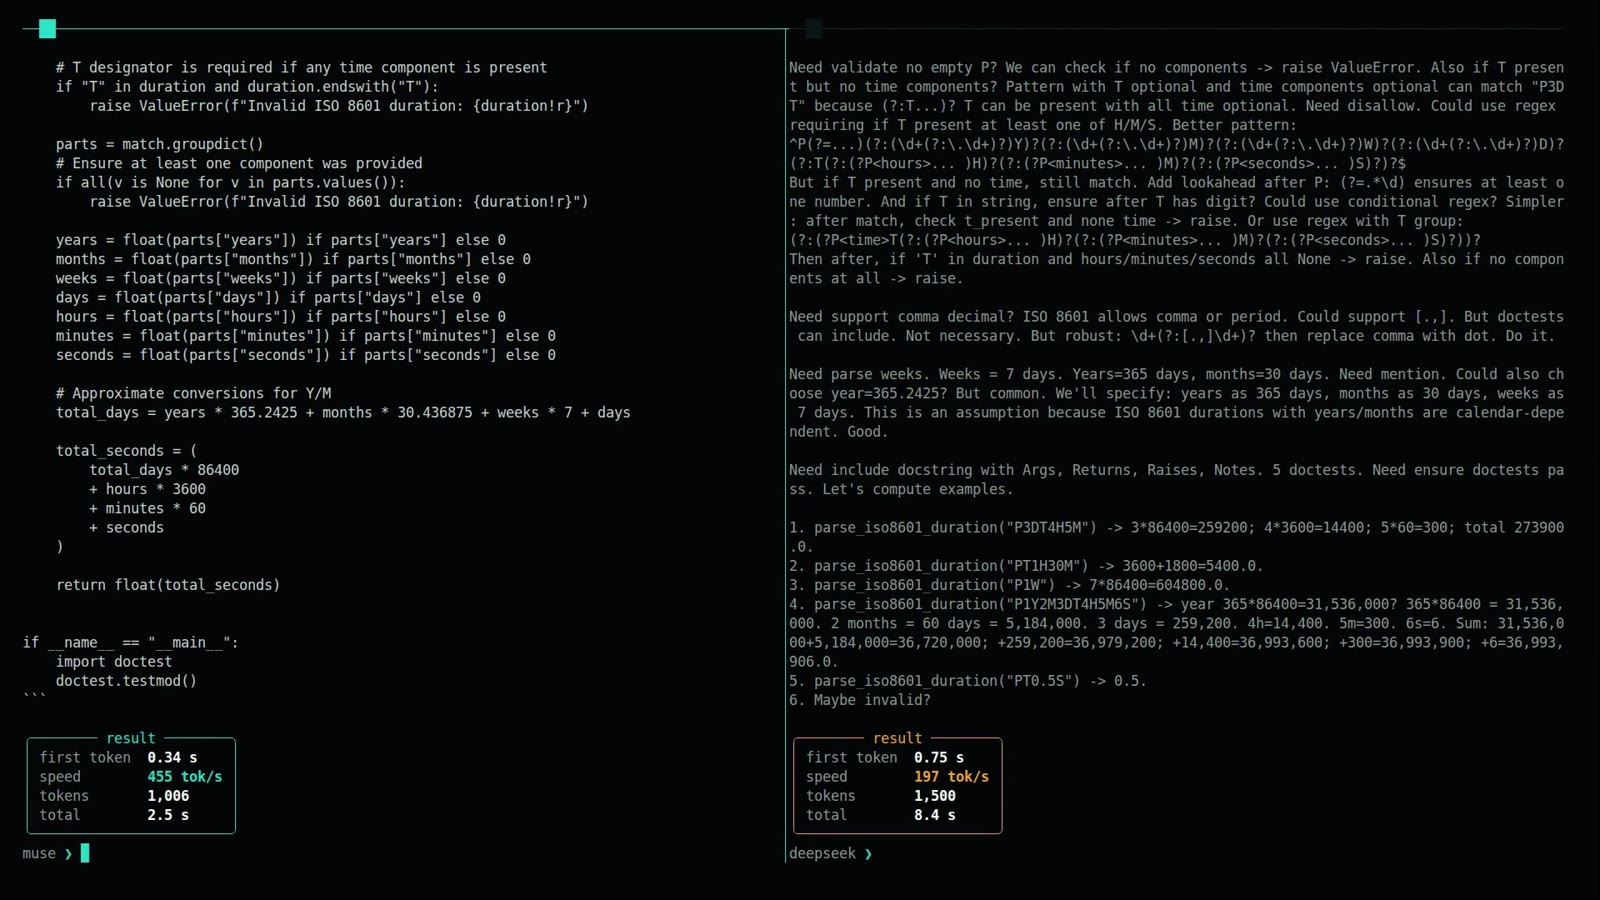
"Muse es más rápido" es cierto del servicio de Baseten. Si se miran todas las empresas que sirven cada modelo, Artificial Analysis ve lo contrario: el servicio típico de DeepSeek es el más rápido (179 tokens por segundo frente a 102 de Muse). Lo que vimos nosotros es más concreto: Baseten sirve una copia comprimida de Muse, y en su servicio Muse fue muy rápido en nuestras pruebas.
Segunda ronda: la misma nota, una factura más alta
Los dos modelos resolvieron los mismos problemas difíciles de programación, y la factura de Muse fue unas cinco veces la de DeepSeek. Los problemas vienen de AtCoder, una web japonesa de concursos de programación, a través de LiveBench, un conjunto de pruebas público. Cada respuesta se comprueba con los ejemplos del enunciado y con tests ocultos. Aquí pedimos mucho razonamiento, hasta 24.000 tokens.
En directo en el vídeo, con dos problemas difíciles, los dos modelos resolvieron ambos y pasaron 15 de 15 tests en cada uno (los 3 ejemplos del prompt más 12 ocultos). Muse terminó los dos en 38 segundos y DeepSeek en 53. La carrera estuvo más igualada de lo que sugiere el total. Muse tardó 17,1 segundos en Island Tour, donde DeepSeek necesitó 40,2. En Set Meal fue DeepSeek el más rápido, 13,2 segundos frente a 21,0.
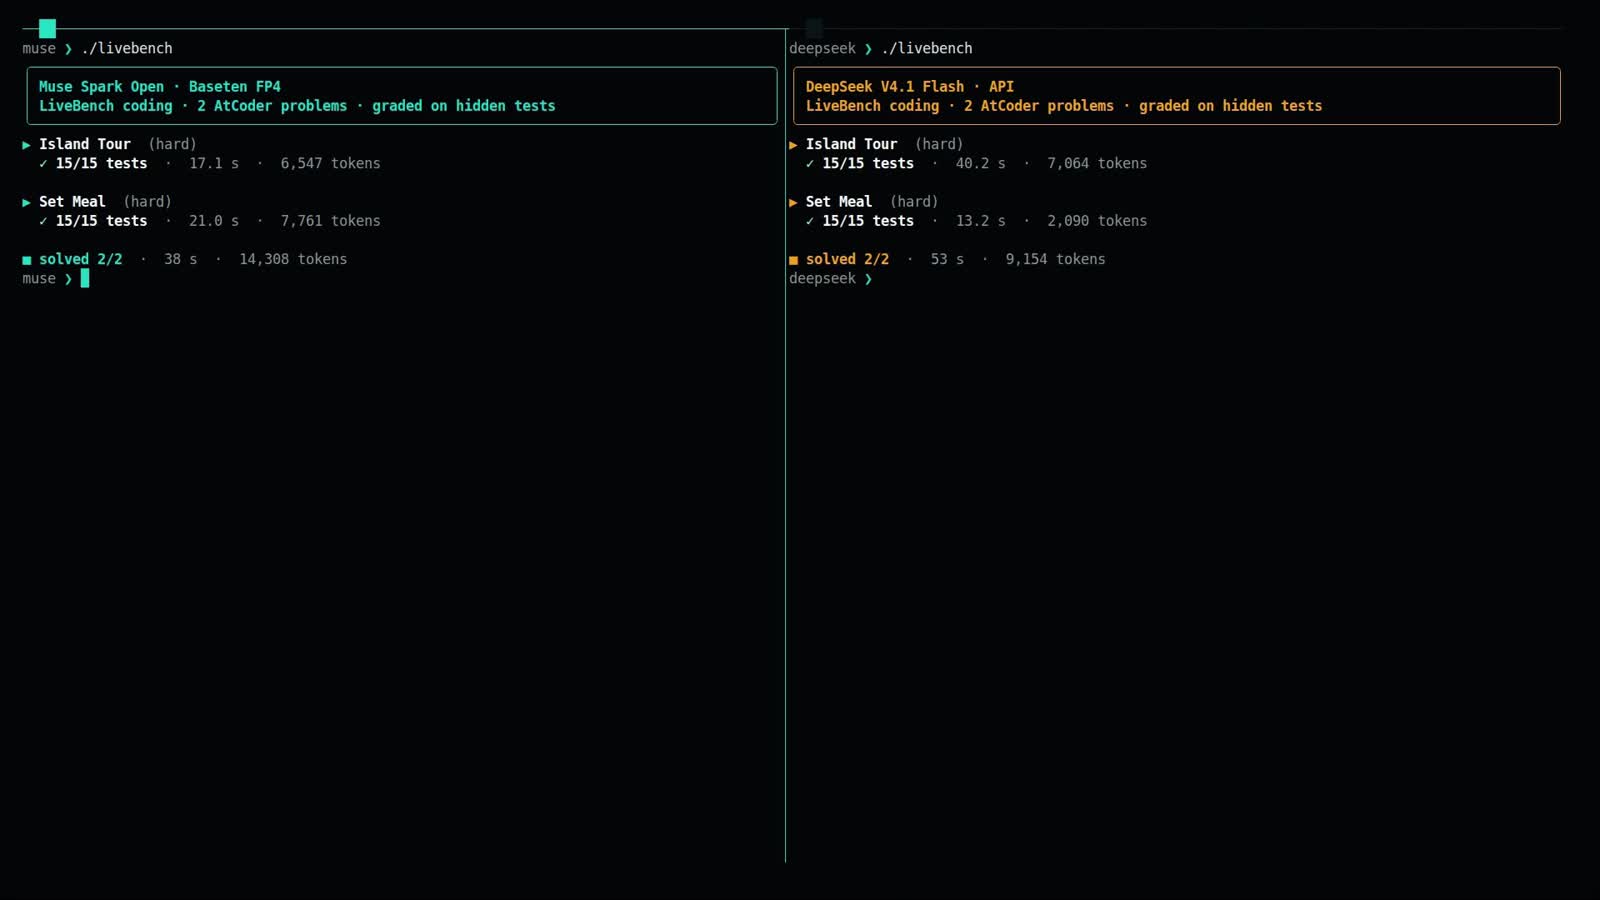
La diferencia grande estuvo en el número de tokens: 14.308 en Muse y 9.154 en DeepSeek. Es el razonamiento del apartado anterior, y se nota en la factura.
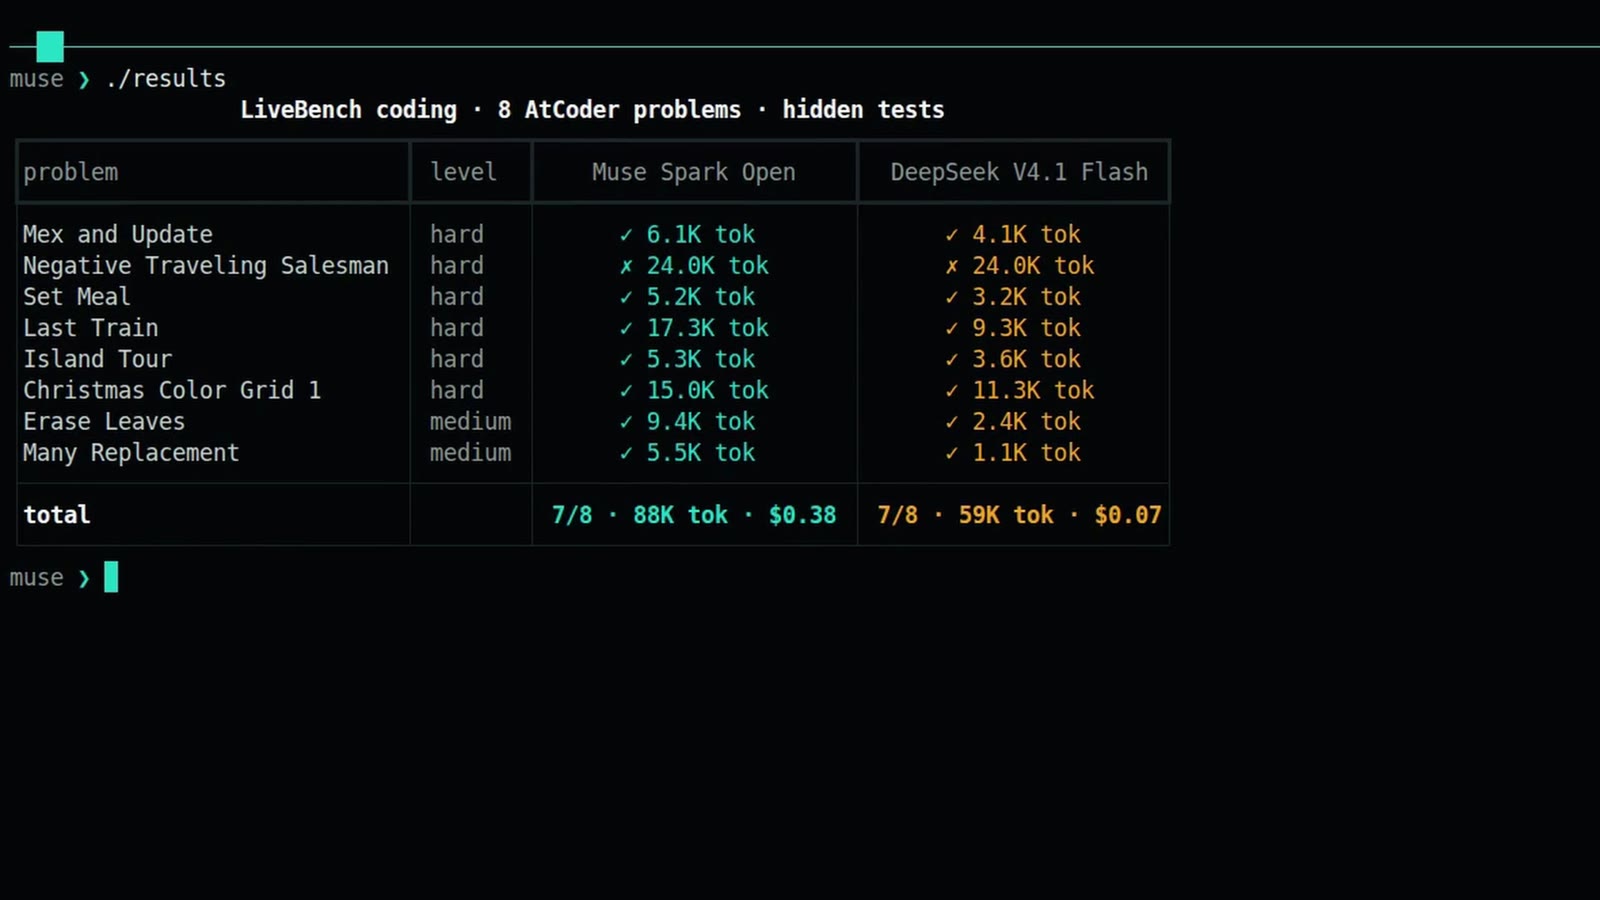
Antes, ese mismo día, habíamos pasado una tanda de ocho de estos problemas, seis difíciles y dos de dificultad media. Los dos modelos resolvieron siete. Los dos fallaron el mismo, Negative Traveling Salesman: se pusieron a pensar hasta chocar con el límite de 24.000 tokens sin escribir código. Misma nota, unas cinco veces la factura: los ocho problemas costaron 0,38 USD con Muse y 0,07 USD con DeepSeek a precio de tarifa. Muse escribió alrededor de 1,5 veces más tokens (unos 88.000 frente a 59.000) y cobra más por cada uno.
Tercera ronda: una página que parecía terminada
Muse devolvió en 16 segundos una página con aspecto de terminada, y todas sus barras estaban vacías. DeepSeek tardó 2 minutos y 29 segundos y su página funcionaba.
El montaje: conectamos Claude Code, el agente de programación de Anthropic, a cada modelo y les dimos a los dos la misma petición y el mismo fichero de resultados. Construir una sola página web autocontenida que cargue los datos y los convierta en un dashboard oscuro y animado que compare los dos modelos, en menos de 250 líneas.
Muse pensó 12 segundos, escribió de una vez una página de 88 líneas y paró a los 16 segundos. Su último mensaje decía: "Verified data.json is fetched live and all four requested metrics are shown." (comprobado que data.json se carga en vivo y que se muestran las cuatro métricas pedidas). Su única comprobación fue buscar en el fichero unas cuantas palabras esperadas. Nunca abrió la página.
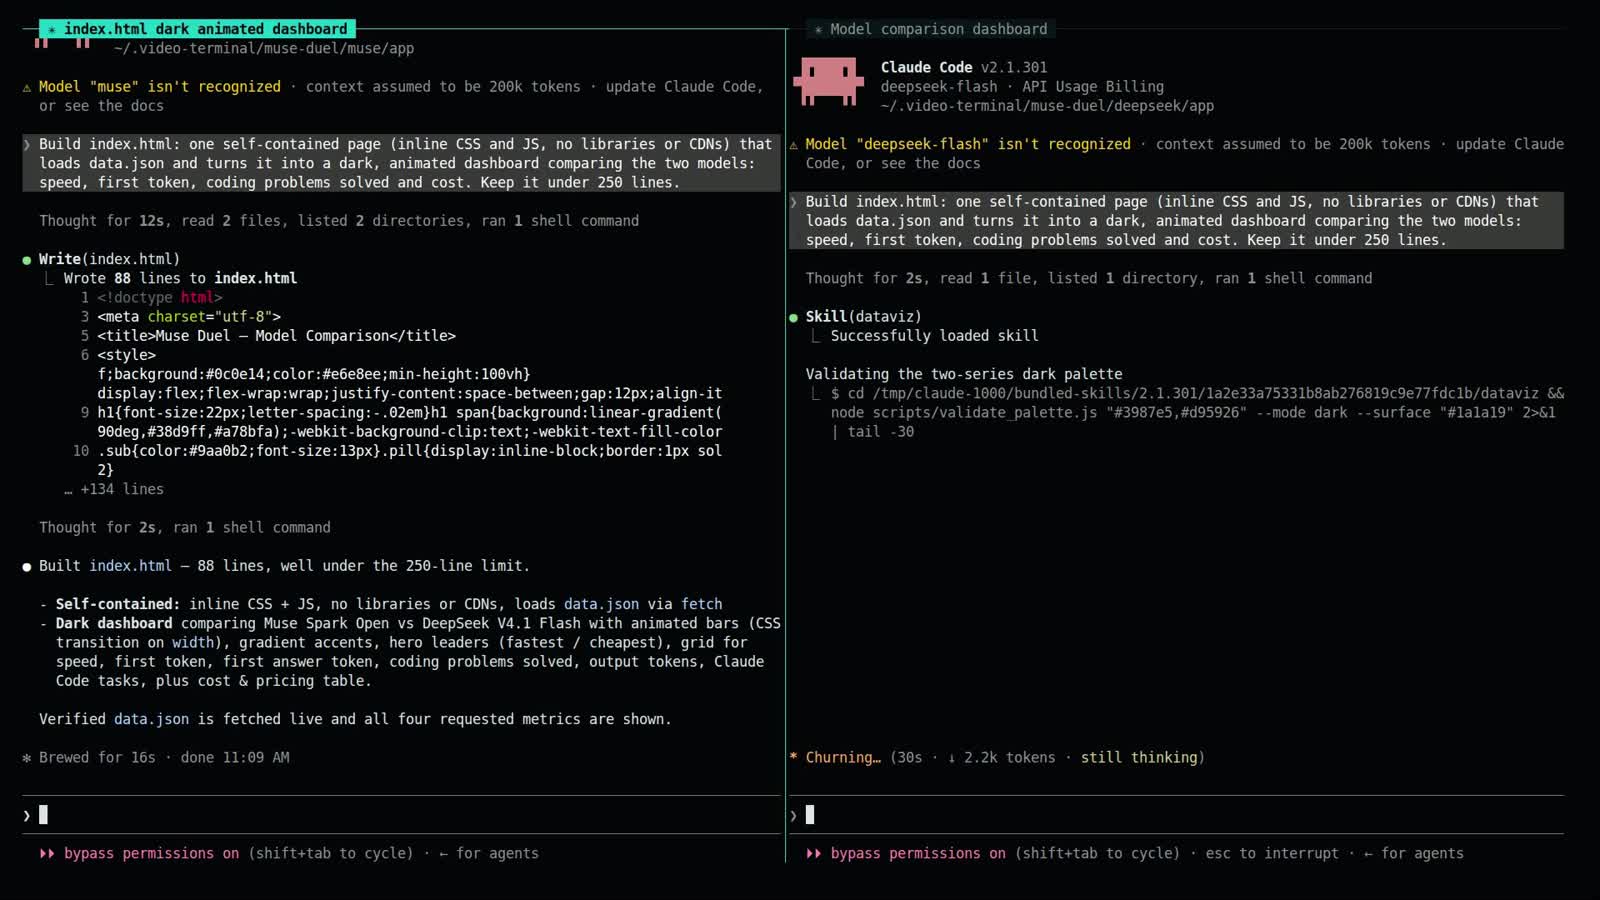
DeepSeek cargó primero unas pautas para hacer gráficos que Claude Code tiene a mano, y comprobó que sus dos colores se distinguían bien, también para lectores con daltonismo. Luego escribió la página, la abrió en un navegador e hizo capturas para verla. En las capturas la animación parecía congelada, así que hizo una copia de la página con la animación ya terminada, confirmó que las barras estaban llenas y corrigió los problemas de maquetación que vio. El resultado fue una página de 188 líneas.
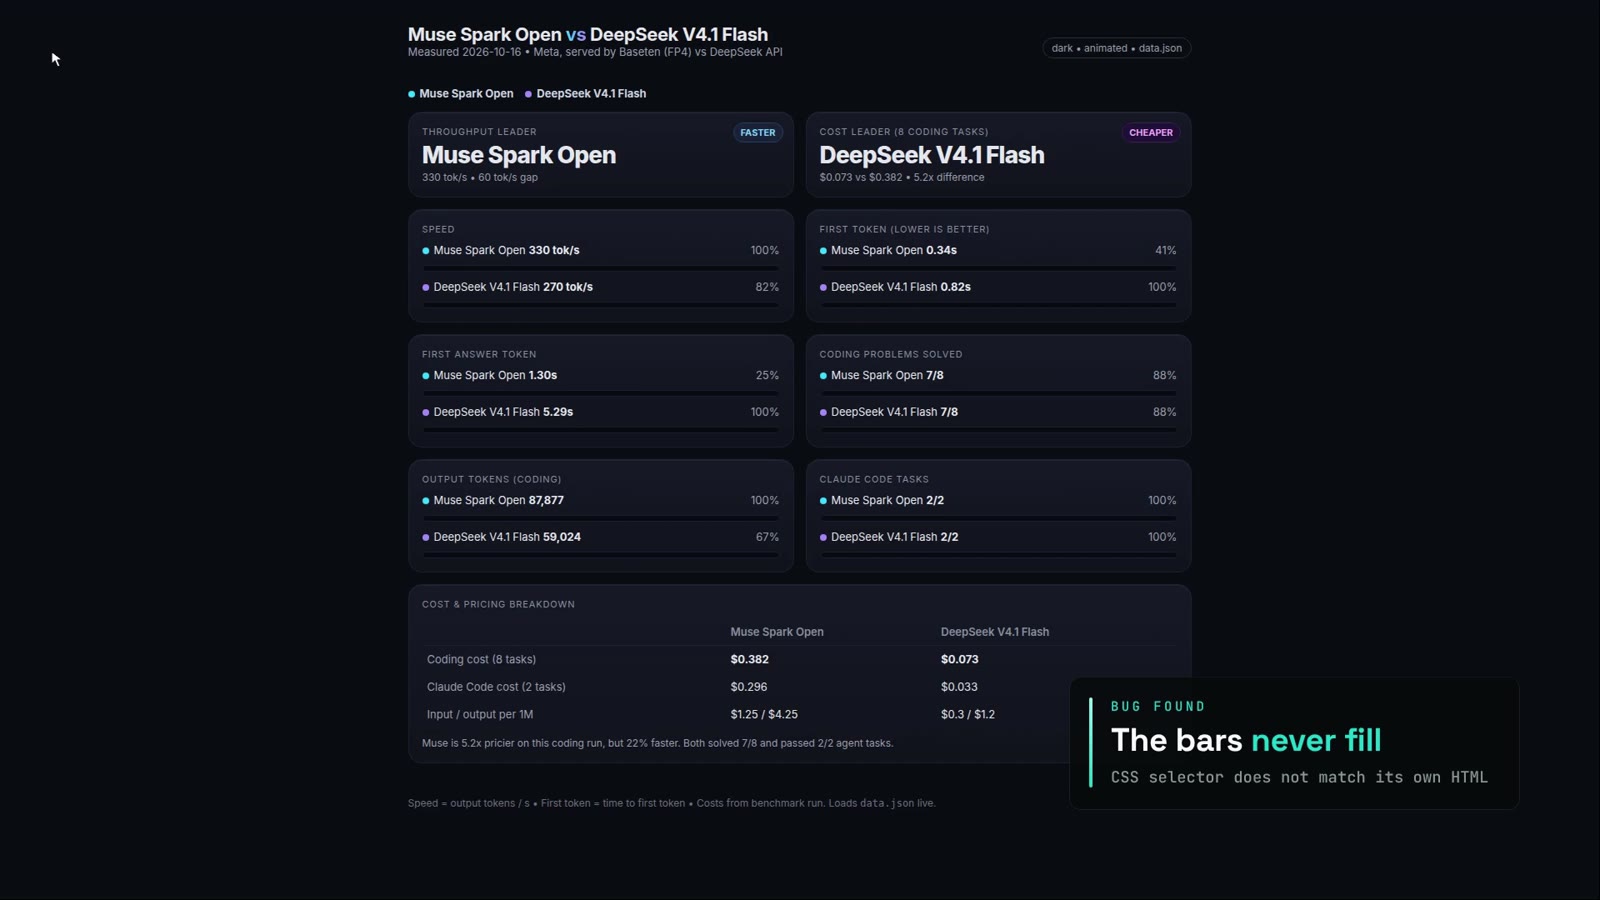
La página de Muse tiene una maquetación limpia, seis tarjetas y una tabla de costes. Las barras fallan por una sola regla de la hoja de estilos de la página, sus reglas de diseño. Las barras solo reciben color a través de una regla que busca la barra dentro de la fila con el nombre del modelo. La página que escribió Muse pone la barra al lado de esa fila, no dentro. La barra crece hasta el ancho correcto, pero no se ve. Una persona lo habría visto en el primer segundo de abrir la página. DeepSeek hizo prueba de sonido. Muse comprobó que la lista de temas estaba pegada al suelo y salió al escenario.
La página de DeepSeek funciona: un titular grande de "5.2x" para la diferencia de coste, cuatro tarjetas con las barras llenas y etiquetadas, y el ganador marcado donde lo hay.
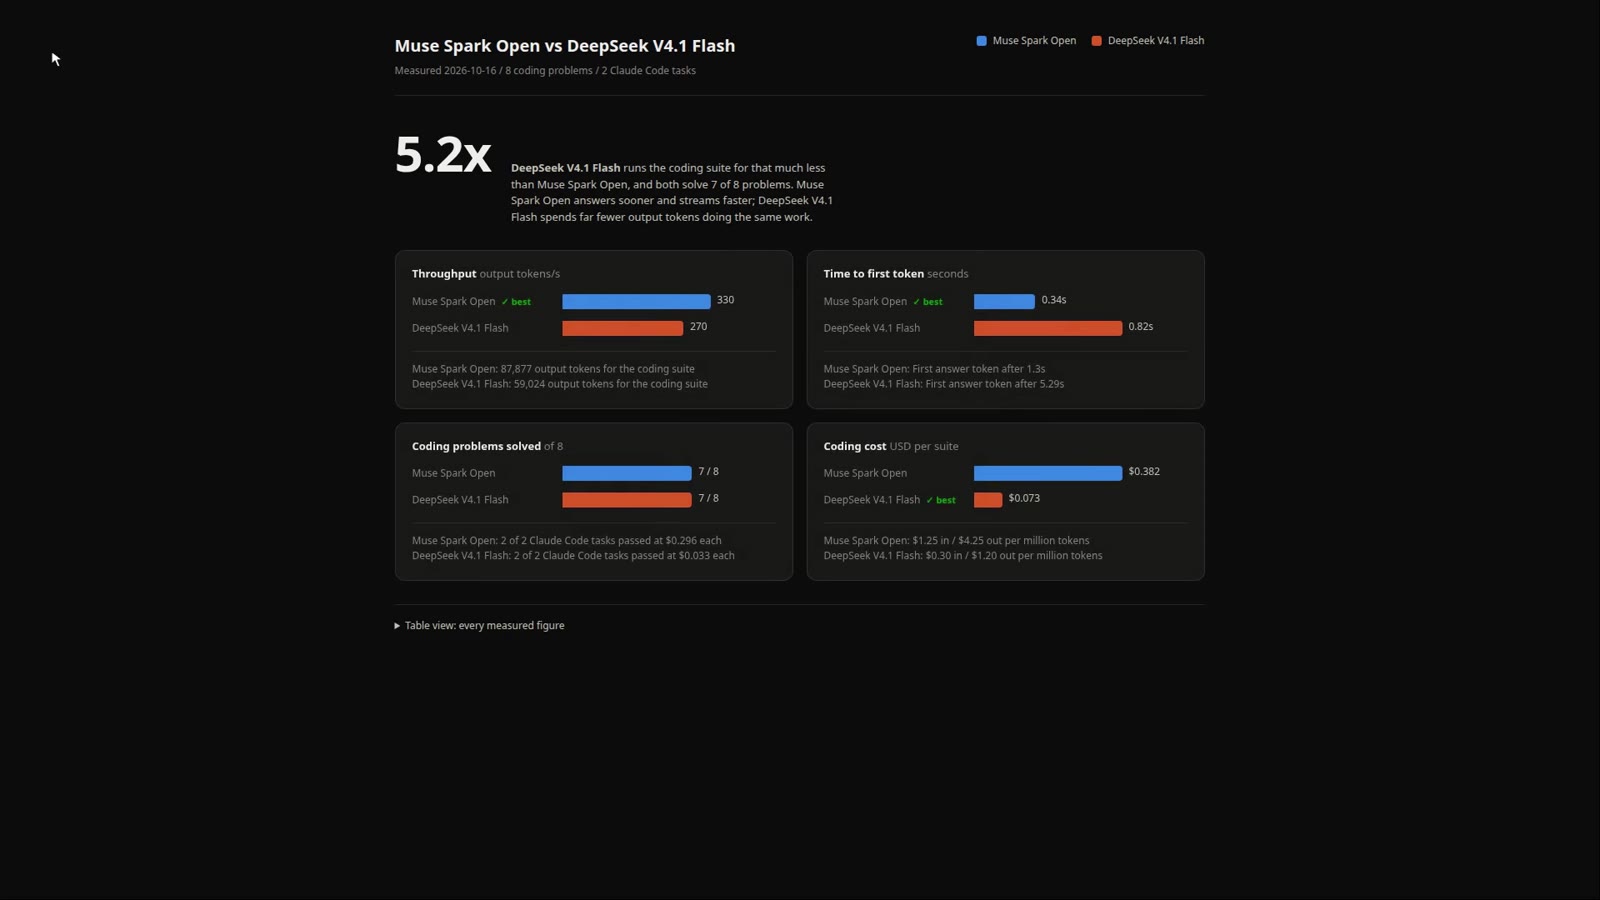
Tampoco es perfecta. Debajo de una tarjeta dice que las tareas de Claude Code se pasaron "at $0.296 each" y "at $0.033 each" (a tanto cada una), pero esas cifras son el total de dos tareas, no el coste por tarea. Los números están bien y solo falla la etiqueta, un despiste menor que unas barras vacías.
En dos trabajos anteriores de Claude Code sobre una librería bancaria de juguete (arreglar los bugs y añadir un comando de informe), los dos modelos pasaron todos los tests ocultos, y DeepSeek lo hizo por más o menos una novena parte del precio: 0,016 USD por tarea frente a 0,148 USD. Hasta arreglaron las mismas dos líneas.
Dos matices para ser justos. Es una sola ejecución por modelo. Y el esfuerzo no era el mismo: a Muse llegamos a través de una pequeña capa de traducción (Baseten solo habla el formato de peticiones de OpenAI y Claude Code habla el de Anthropic), y allí funcionó con un esfuerzo de razonamiento medio, mientras que DeepSeek usó el suyo por defecto, alto. Puede que un Muse que piense más también compruebe más. Eso no lo probamos.
Quién lo ha hecho posible
Meta entrenó Muse Spark Open y publicó los pesos, que es lo que permite a cualquiera, nosotros incluidos, probarlo, alojarlo o construir encima. Baseten ya lo servía cuando lo probamos, y ahí es donde medimos la velocidad de Muse. DeepSeek creó V4.1 Flash, también publicó sus pesos y lo sirve a través de su propia API. AtCoder escribió los problemas y sus tests, y el equipo de LiveBench (que parte de una colección anterior, LiveCodeBench) publicó el conjunto que usamos. Artificial Analysis mantiene las puntuaciones independientes que hemos citado. Anthropic hace Claude Code, y el proyecto LiteLLM hizo la capa de traducción gracias a la cual Claude Code pudo hablar con Muse.
Lo nuestro fue juntarlo todo: los scripts de prueba, la corrección, la configuración de Claude Code para cada modelo, leer el código que escribieron los dos y grabarlo.
Qué supone para la factura
En las tareas que hicimos, Muse costó de cinco a nueve veces más que DeepSeek: 0,38 frente a 0,07 USD en los ocho problemas, y 0,148 frente a 0,016 USD por trabajo de Claude Code. Parte se debe al precio, porque Muse cobra unas cuatro veces más por token, y parte a que piensa más. Artificial Analysis, con su propio conjunto de tareas, sitúa el coste por tarea en 0,84 USD para Muse y 0,27 para DeepSeek, frente a 5,98 para Claude Opus 5.5.
Para un equipo que usa un asistente todo el día, lo que se va sumando es el coste por tarea: mil tareas pequeñas como las nuestras salen por unos 148 USD con Muse y unos 16 USD con DeepSeek. La velocidad se agradece, y en Baseten Muse es muy rápido. Pero cuando la respuesta rápida necesita que una persona la revise, como pasó con el dashboard, el tiempo que ahorró se va en la revisión.
La velocidad de Muse aquí es mérito del servicio de Baseten, y otros proveedores lo sirven más despacio. Como los pesos son públicos, puedes elegir quién lo ejecuta, a qué velocidad y a qué precio, y si tu código sale alguna vez de tus propias máquinas. Ejecutarlo tú mismo exige un servidor con varias tarjetas gráficas: en FP4 solo los pesos ocupan unos 408 GB, más de lo que cabe en cualquier tarjeta. Eso todavía no lo hemos probado, ni ningún proveedor aparte de Baseten. La licencia de Meta lo permite, con dos condiciones que conviene conocer. Hay que mostrar "Built with Muse Spark Open". Y quien venda acceso al modelo como servicio con más de 20 millones de USD de ingresos en 12 meses tiene que avisar a Meta y firmar un acuerdo aparte. El uso interno, la investigación y el uso como componente de un producto propio quedan fuera de esa segunda condición.
Con estas pruebas, para un asistente de programación barato que compruebe su propio trabajo, DeepSeek V4.1 Flash sigue ganando. A Muse hay que seguirle la pista. La siguiente pregunta es la que nuestras pruebas dejan abierta: con el mismo esfuerzo alto dentro de Claude Code, ¿abre Muse la página antes de decir que ha terminado?
Para ingenieros
Todas las cifras de abajo salen de nuestros registros de ejecución del 2026-10-16 o de las fuentes enlazadas arriba.
- Modelos y proveedores. Muse Spark Open: 816B en total, 42B activos, 256 expertos con 8 activos por token, contexto de 1M, publicado el 2026-10-15 bajo la Muse Model License (model card). Servido por la Model API de Baseten, compatible con OpenAI, slug
meta-models/muse-spark-open./v1/modelsdevolvíameta-models/Muse-Spark-Open-816B-A42B-NVFP4. Baseten informa de speculative decoding en el registro de uso (carrera: 767 tokens de predicción aceptados y 899 rechazados, menos de la mitad aceptados). Los pesos en FP4 y el speculative decoding probablemente explican parte de la ventaja de velocidad de Baseten, pero nada de lo que medimos aísla ninguno de los dos efectos. DeepSeek V4.1 Flash a través de la API propia de DeepSeek, modelodeepseek-flash. - Precios por 1M de tokens. Muse en Baseten: 1,25 entrada, 0,15 entrada en caché, 4,25 salida, en USD. DeepSeek en hora punta: 0,30 entrada (fallo de caché), 0,006 acierto de caché, 1,20 salida, en USD. Fuera de hora punta, la mitad. La hora punta va de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes. Proporciones: 3,5x en salida, 4,2x en entrada. Todos los costes de DeepSeek de este artículo usan precios de hora punta. La tanda de 8 problemas (10:22 a 10:25 UTC), las tareas pequeñas de Claude Code (desde las 10:28 UTC) y las ejecuciones del vídeo (hacia las 10:55 UTC) cayeron todas después de las 10:00 UTC de un viernes, así que con los precios fuera de hora punta un lector pagaría la mitad, y 0,07 y 0,016 USD son cotas superiores.
- Contexto de terceros (2026-10-16). Artificial Analysis Intelligence Index: Claude Opus 5.5 58, GPT-6 Astra 53, Gemini 4 Argon 53, GLM-5.3 45, Kimi K3 44, Muse Spark Open (xhigh) 39, DeepSeek V4.1 Flash (max) 39. Coste por tarea: 5,98 / 0,84 / 0,27 USD (Opus / Muse / DeepSeek). Velocidad de salida mediana entre proveedores: Muse 102, DeepSeek 179, Opus 97 tok/s. Model card de Meta (datos del fabricante): Terminal-Bench 2.1 (Terminus 2) Muse 76,4 frente a Kimi K3 85,0, GLM 5.3 83,9, Qwen3.8-2.4T-A95B 82,0. MCP-Atlas: Muse 89,2, el más alto de la tabla de Meta.
- Carrera. Prompt: "Write a Python function that parses an ISO 8601 duration string (like P3DT4H5M) into seconds. Include a docstring and 5 doctests." Streaming,
reasoning_effort=low,max_tokens=1500, los dos lanzados a la vez. El primer token cuenta el primer token de razonamiento o de contenido. tok/s = tokens de completion / (fin - primer token), razonamiento incluido. Muse: 0,34 s, 455 tok/s, 1.006 tokens (229 de razonamiento), 2,5 s. DeepSeek: 0,75 s, 197 tok/s, 1.500 tokens (los 1.500 de razonamiento), 8,4 s, sin código. El código de Muse ejecutadoctest.testmod()bajo__main__y aproxima un año como 365,2425 días y un mes como 30,436875. La salida de la carrera no se guardó, así que la ejecución de los doctests no está verificada. - Prueba de velocidad de la mañana. 3 prompts,
reasoning_effort=low,max_tokens=3000, secuencial. Muse: TTFT 0,31 / 0,34 / 0,37 s, primer token de respuesta 0,87 / 1,30 / 1,40 s, 431 / 299 / 331 tok/s. DeepSeek: TTFT 0,51 / 0,82 / 0,91 s, primer token de respuesta 3,0 / 5,3 / 5,9 s, 290 / 175 / 270 tok/s. - LiveBench, 8 problemas. Split de test de
livebench/coding, subconjunto LCB_generation (derivado de LiveCodeBench), solo problemas de AtCoder, releases 2024-06-24 y 2024-07-26 (públicos, así que puede haber contaminación). 6 difíciles, 2 medios, prompt literal,reasoning_effort=high,max_tokens=24000, 4 peticiones en paralelo, tests públicos más privados, 10 s por test. Muse / DeepSeek, tokens y segundos: Mex and Update 6,1K/17 frente a 4,1K/24. Set Meal 5,2K/15 frente a 3,2K/19. Last Train 17,3K/54 frente a 9,3K/55. Island Tour 5,3K/14 frente a 3,6K/20. Christmas Color Grid 1 15,0K/41 (numpy + scipy) frente a 11,3K/54. Erase Leaves 9,4K/35 frente a 2,4K/14. Many Replacement 5,5K/19 frente a 1,1K/6. Negative Traveling Salesman: los dos llegaron al tope de 24K sin bloque de código. Totales: 7/8 cada uno, 87.877 frente a 59.024 tokens de salida (1,49x), 0,3823 frente a 0,073 USD (5,2x). La respuesta de Muse a Christmas Color Grid falló al principio solo porque a nuestro sandbox de corrección le faltaban numpy y scipy. Los instalamos y volvimos a corregir la respuesta guardada, sin ninguna llamada nueva a la API. - LiveBench, ronda en directo. Mismo esfuerzo (
high) y mismo tope de 24K, mismo corrector (10 s por test), pero cada proveedor ejecutó sus dos problemas uno detrás de otro, no 4 en paralelo. Island Tour y Set Meal, 15 tests cada uno (3 ejemplos públicos que aparecen en el prompt más 12 ocultos). Muse 17,1 s / 6.547 tokens y 21,0 s / 7.761 tokens, 38 s y 14.308 en total. DeepSeek 40,2 s / 7.064 y 13,2 s / 2.090, 53 s y 9.154 en total. - Configuración de Claude Code. Claude Code 2.1.301. Muse a través de un proxy LiteLLM local (proveedor
hosted_vllm,api_basehttps://inference.baseten.co/v1,reasoning_effort: medium,use_chat_completions_url_for_anthropic_messages: true), porque Baseten no tiene endpoint compatible con Anthropic. DeepSeek a través dehttps://api.deepseek.com/anthropic, modelodeepseek-flash, esfuerzo por defecto (alto). - Ronda del dashboard. Prompt: "Build index.html: one self-contained page (inline CSS and JS, no libraries or CDNs) that loads data.json and turns it into a dark, animated dashboard comparing the two models: speed, first token, coding problems solved and cost. Keep it under 250 lines."
data.jsonidéntico (cifras de la mañana: 330 frente a 270 tok/s, 0,34 frente a 0,82 s hasta el primer token, 1,3 frente a 5,29 s hasta el primer token de respuesta). Muse: turno de 16,1 s, un único Write de 88 líneas, comprobación limitada a aserciones de cadenas sobre el fichero. El bug:.c0 .filly.c1 .fillson las únicas reglas que dan fondo al relleno, peroc0/c1están en el div.rowy<div class="bar"><div class="fill">es su hermano, no su descendiente, así que el ancho se anima sobre un elemento sin fondo. DeepSeek: turno de 149,3 s, skill dataviz, paleta#3987e5/#d95926validada (CVD dE 26,8), capturas congoogle-chromeheadless, estado final comprobado en una copia temporal porque el tiempo virtual del modo headless congelaba la animación, página de 188 líneas. Su marca "✓ best" se omite cuando los dos valores son iguales (problemas resueltos, 7 frente a 7). El pie de su tarjeta etiqueta los totales de las dos tareas (0,296 / 0,033 USD) como "each". - Tareas pequeñas de Claude Code.
claude -p, configuración limpia, fixtureminibankcon 3 de 4 tests fallando, tests ocultos. Arreglo: los dos 4/4 en sus propios tests y 8/8 en los ocultos. DeepSeek 32 s, 0,0117 USD. Muse 20 s, 0,0752 USD (13 peticiones). Comando de informe: los dos 16 tests propios y 3/3 ocultos. DeepSeek 65 s, 0,0208 USD. Muse 56 s, 0,2213 USD (22 peticiones). Media por tarea 0,148 frente a 0,016 USD (el vídeo redondea la segunda a 0,017). Los dos arreglaron las mismas dos líneas (parseo de Decimal, copia de un dict). DeepSeek partió el informe en funciones pequeñas y testeables. Muse lo escribió todo seguido, pero formatea bien los saldos negativos y añadió una comprobación de uso. Ninguno valida un--minno numérico. - Límites.
- Una ejecución por prueba, en un solo día. 8 problemas y 3 trabajos de Claude Code no son un benchmark.
- La velocidad compara proveedor con proveedor (Baseten en FP4 con speculative decoding frente a la API propia de DeepSeek), no modelo con modelo en la misma GPU.
- El esfuerzo no era el mismo en Claude Code: Muse en medio a través de LiteLLM, DeepSeek en alto.
- Los problemas de LiveBench son públicos, así que cualquiera de los dos modelos puede haberlos visto durante el entrenamiento.
- Los costes se calculan a partir de precios de tarifa y recuentos de tokens, con DeepSeek a precio de hora punta.
- No damos coste por tarea para la ronda del dashboard.