MOSS-Image écrit juste menus et affiches, si on lui laisse 80 secondes
MOSS-Image, sous Apache 2.0, a écrit chaque mot juste en 80 s sur une A40. Un module turbo prend 9 s mais se trompe parfois. Environ 30 Go sur la carte.
Un menu avec quatre prix est un travail plus difficile pour un modèle d'image qu'un coucher de soleil. Iris-3B, le dernier modèle d'image que nous avons testé, a dessiné l'ardoise et oublié les points décimaux. MOSS-Image, un modèle ouvert conçu pour les textes longs dans les images, a écrit chaque mot juste dans tous nos tests de texte. Il lui a fallu environ 80 secondes par image sur une A40 louée. Un module turbo de la communauté produit les mêmes images en environ 9 secondes, et se trompe de mot de temps en temps. Si votre produit génère des affiches, des menus ou des visuels pour les réseaux sociaux, voilà le choix : 80 secondes publiables telles quelles, ou 9 secondes que quelqu'un doit relire. Le modèle et le module sont sous licence Apache 2.0, l'usage commercial est donc couvert. Entièrement chargé, il occupait environ 30 Go de mémoire sur la carte. Sous des limites émulées de 16 et 12 Go, il a produit l'image identique. Vous pouvez le faire tourner sur un GPU loué ou le vôtre.
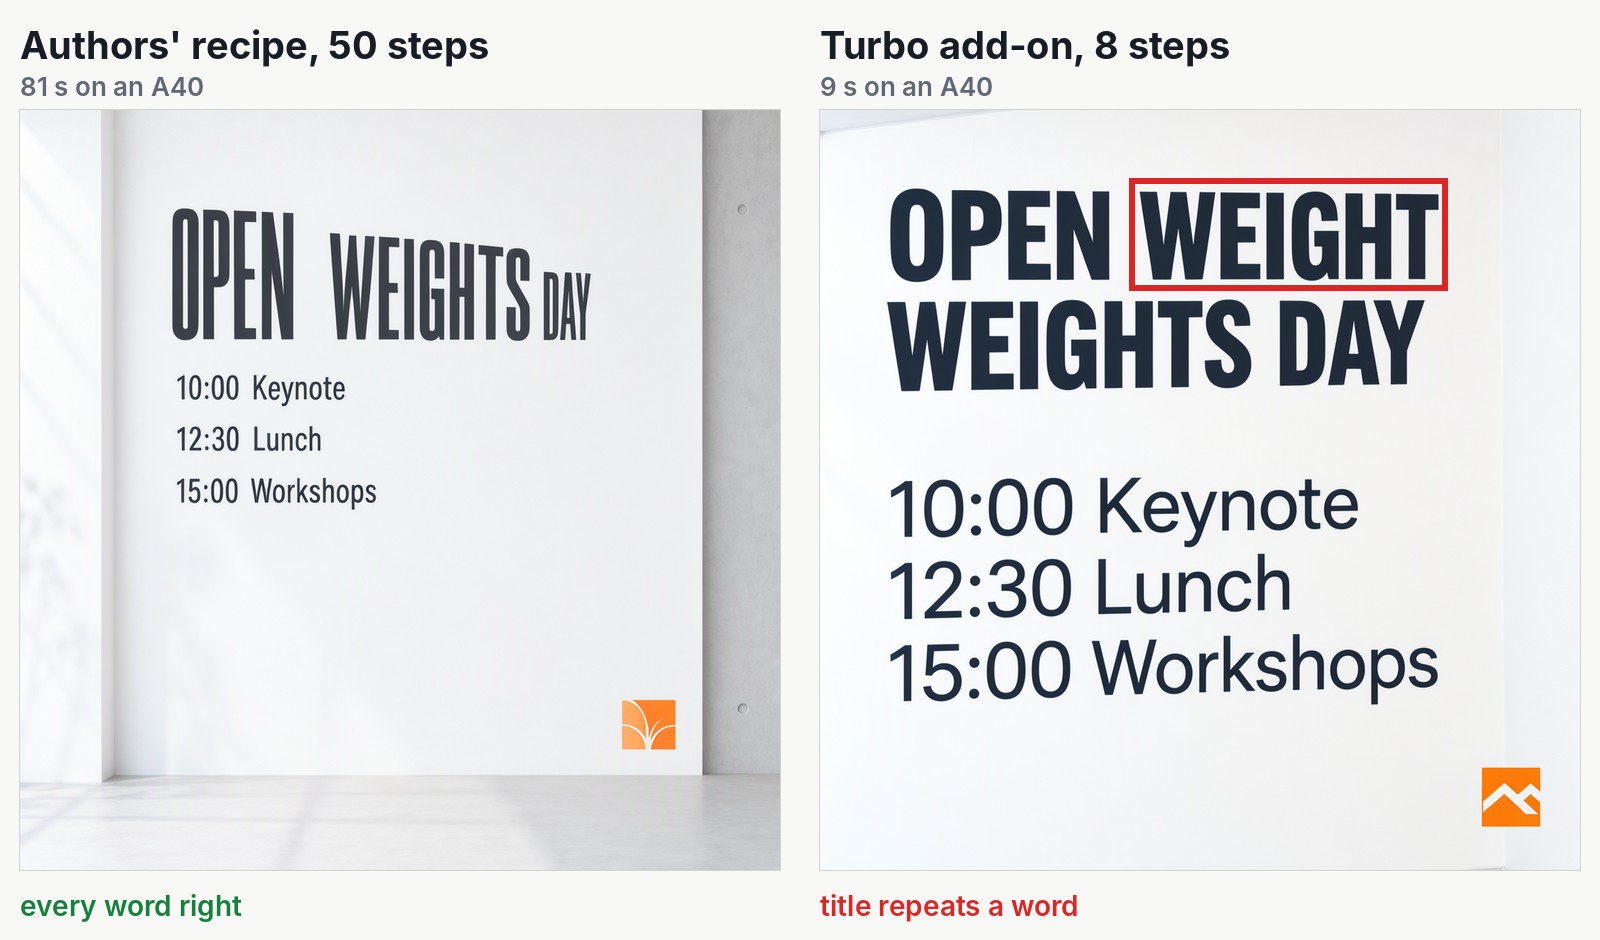
Même prompt, même point de départ aléatoire, même modèle chargé. Le cadre rouge marque la seule erreur de la version turbo sur cette affiche.
Un modèle ouvert conçu pour les mots et les mises en page
MOSS-Image vient d'OpenMOSS, chez MOSI.AI. Ses auteurs citent le texte dans l'image et les prompts longs comme ses fonctions principales. Pensez à un menu complet avec ses prix, une infographie avec une douzaine d'étiquettes ou un programme sur une affiche : précisément les images où les modèles trébuchent d'habitude.
Dans leur rapport technique, les auteurs ont construit leur propre test de textes longs dans les images. Selon eux, MOSS-Image écrit en moyenne 96,3 % du texte demandé, le meilleur score parmi les modèles dont les fichiers sont publics. C'est leur benchmark, prenez-le donc comme leur affirmation. Notre petit test va dans le même sens.
Vous pouvez aussi contrôler la mise en page. Au lieu d'une phrase, vous envoyez une courte description structurée : une légende pour toute l'image, puis une liste d'éléments, chacun avec son texte et un cadre sur le canevas. Les auteurs la disent expérimentale. Nous avons essayé deux mises en page, et les deux ont été respectées.
Chaque mot juste en 80 secondes, un mot à vérifier en 9
Nous avons généré 22 images avec MOSS-Image-SFT, un essai par prompt et une requête à la fois. La carte était une NVIDIA A40 avec 48 Go de mémoire, louée sur notre propre cloud. Les prompts étaient les nôtres : une affiche de conférence, une infographie, un menu sur ardoise, une note manuscrite en chinois, deux mises en page, une photo de rue et les mains d'un pianiste.
La recette des auteurs transforme un bruit aléatoire en image en 50 étapes. Elle a pris de 78 à 81 secondes par image d'environ un mégapixel. Elle a écrit juste chaque mot de l'affiche, de l'infographie, du menu et de la note en chinois. Le menu indiquait "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50" : quatre prix, quatre points décimaux.
Le module turbo vient de lodestones. C'est un fichier de 1,2 Go posé sur le modèle d'origine, et son auteur le présente comme un travail en cours. Il arrive au résultat en 8 étapes au lieu de 50, en 8,6 à 9,2 secondes, environ neuf fois plus vite. Il a réussi le menu, la note en chinois et les deux mises en page. Il s'est trompé deux fois dans le texte demandé : le titre de l'affiche ci-dessus, et "PNG bock" au lieu de "PNG back" sur l'infographie. Il a aussi inventé des enseignes à moitié illisibles dans la photo de rue. C'est un bon outil de brouillon, et un pari risqué pour une liste de prix que personne ne relit.
Environ 30 Go sur la carte, et les mêmes pixels sous des limites de 16 et 12 Go
Vous n'avez probablement pas besoin d'une carte de 48 Go. Le modèle se compose de deux parties qui travaillent en duo. Un lecteur de 17 Go, un modèle de langage, transforme votre prompt en description. Un peintre de 10 Go transforme le bruit en image. Le lecteur travaille un instant au début puis reste inactif, il peut donc attendre dans la mémoire principale de l'ordinateur.
Nous avons limité la mémoire que le modèle pouvait utiliser sur l'A40, pour qu'elle se comporte comme une carte de 16 ou 12 Go :
| Limite de mémoire | Pic de mémoire sur la carte | Recette des auteurs | Turbo |
|---|---|---|---|
| Aucune (vraie A40, 48 Go) | environ 30 Go | 80 s | 9 s |
| 16 Go (émulée) | environ 14 Go | 86 s | 13 s |
| 12 Go (émulée) | environ 11 Go | 160 s | 18 s |
Les exécutions limitées ont produit, octet pour octet, les mêmes fichiers que l'exécution avec tout sur la carte. L'affiche à 12 Go a donc toujours chaque mot juste, et l'affiche turbo garde son mot répété. Prévoyez environ 32 Go de mémoire principale : les configurations limitées en ont utilisé jusqu'à 22 Go.
Seule la taille de la mémoire était émulée, pas la vitesse d'une carte grand public, et l'ajustement n'est pas encore confirmé sur une vraie carte grand public, car les machines RTX 3080 Ti, RTX 5080 et RTX 4090 que nous avons louées n'ont pas pu être configurées.
À qui cela s'adresse
- Du texte qui doit être juste (un menu, un prix, une mention légale) : utilisez la recette en 50 étapes des auteurs. C'était le seul mode sans erreur dans notre test.
- De la vitesse pour les brouillons et les aperçus : utilisez le module turbo, et relisez chaque mot avant publication.
- Un GPU plus petit : essayez la configuration 16 Go sur une carte de 16 ou 24 Go. Sur une carte de 16 Go, c'est juste, avec environ 2 Go de marge.
- Un produit commercial : la licence Apache 2.0 du modèle et du module le couvre.
Pour générer des images à votre bureau, ComfyUI fait déjà tourner MOSS-Image et c'est le chemin le plus court. Nous voulions une API que d'autres programmes appellent, sur une carte que nous choisissons. Sur InferenceKey, une seule copie chargée a servi la recette et le module turbo, requête par requête. Elle était prête 63 secondes après la demande.
OpenMOSS a créé le modèle, lodestones a fait le module turbo, et nous l'avons repéré dans une vidéo d'AI Search. Notre part : le code qui le sert, l'exemple du SDK, le déploiement sur InferenceKey et les mesures.
Lisez le test complet, avec toutes les images, l'échelle de mémoire et les étapes de déploiement, dans notre article Research.