Nemotron 3.5 Bolt : un modèle agent de 74B sur un seul GPU, et ce que veulent dire les 24 GB
NVIDIA a fait tenir un modèle agent de 74B qui lit les images dans 22 GB de poids surtout en 2 bits. Sur une A40 : 136 tokens/s avec drafter, 70 sans.
Une seule carte graphique louée peut-elle faire tourner un modèle agent de 74B qui lit les images ? NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB, publié le 15 octobre, est un modèle de 74 milliards de paramètres qui lit du texte et des images et travaille comme un agent, en appelant des outils pour accomplir des tâches. Son fichier pèse 22,0 GB. Nous l'avons servi sur une seule NVIDIA A40 louée, une carte graphique (GPU) de data center de 48 GB, avec la lecture d'images et son drafter activés. Le drafter est un petit modèle auxiliaire qui accélère l'écriture.
Le "24GB" du nom est le budget de NVIDIA pour le texte seul : le modèle, la place pour environ 128 000 tokens de conversation (un token est un morceau de mot) pour un utilisateur, et le drafter. Le total fait 23,83 GB. Notre déploiement a utilisé environ 27 GB (25,2 GiB), mais la comparaison n'est pas à armes égales : ce chiffre inclut le lecteur d'images, que le budget de NVIDIA laisse de côté. Les configurations de NVIDIA pour llama.cpp, le programme gratuit que la plupart des gens utilisent pour faire tourner ce genre de modèle sur une seule machine, commencent aux cartes de 32 GB.
Ce que nous voulions savoir, c'est si un modèle agent de 74B tourne vraiment sur une seule carte qu'une petite équipe peut louer ou acheter, et à quelle vitesse. Sur une carte de data center de 48 GB, oui. Sur une carte grand public de 32 GB, la taille que cite la plus petite configuration de NVIDIA, ce n'est pas encore prouvé : les deux que nous avons louées étaient en panne.
| Quoi | Résultat |
|---|---|
| Modèle | Nemotron 3.5 Bolt 74B-A9B 24GB de NVIDIA, publié le 15 octobre : 74B paramètres (les valeurs qu'un modèle apprend à l'entraînement), dont 9B travaillent sur chaque mot, lit du texte, des images et de courtes vidéos, écrit du texte, appelle des outils |
| D'où il vient | une version allégée du Nemotron 3.5 Super VL de 120B de NVIDIA, puis fortement compressée pour que le fichier soit 85 % plus petit |
| Téléchargement | modèle de 22,0 GB, lecteur d'images de 1,73 GB, drafter de 1,0 GB |
| GPU utilisé | une NVIDIA A40 de 48 GB, louée sur RunPod (une carte de data center d'ancienne génération) |
| Mémoire utilisée en service | environ 27 GB sur les 48 GB de la carte, un peu plus de la moitié, avec la lecture d'images, le drafter et la place pour 98 304 tokens de conversation |
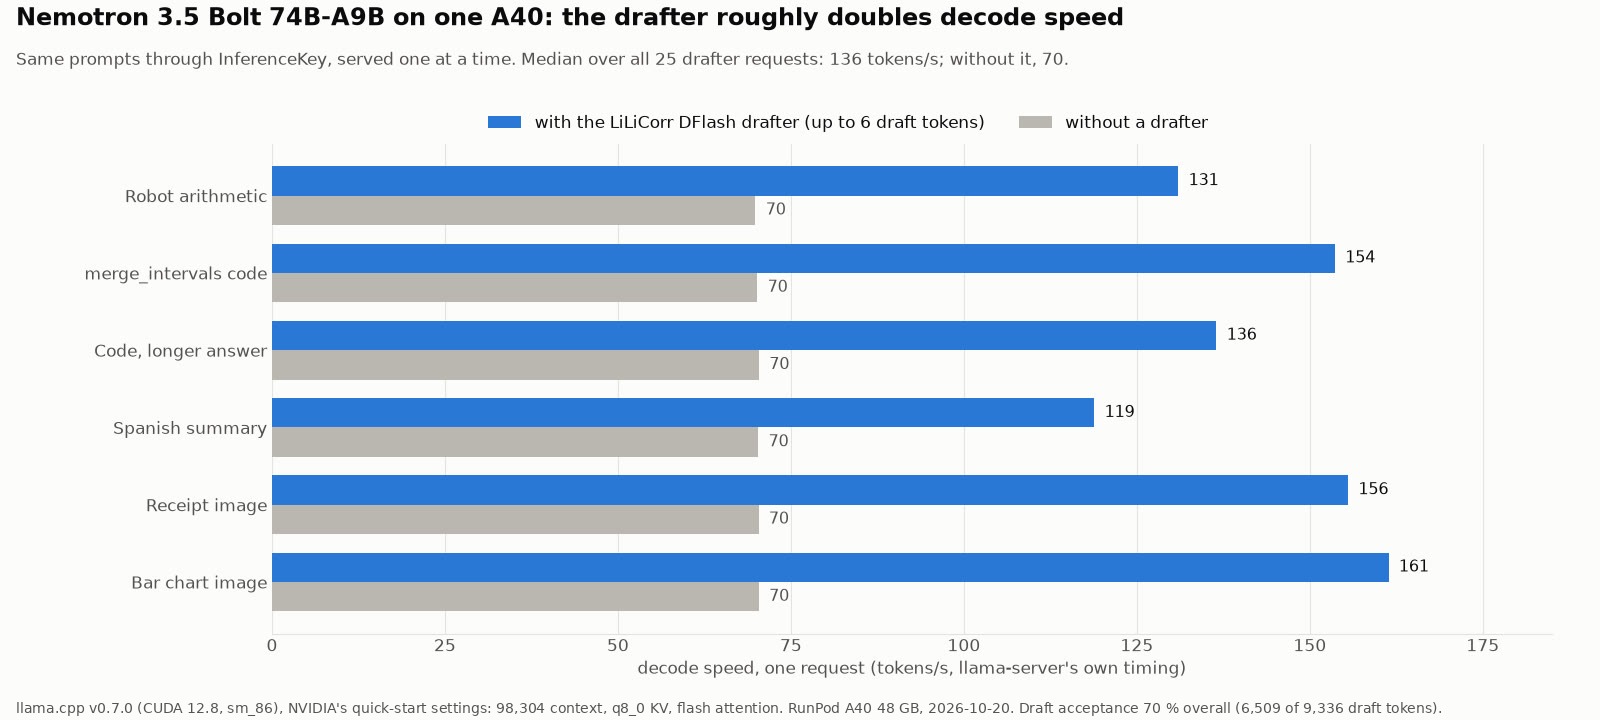
| Vitesse d'écriture pour un utilisateur | 136 tokens par seconde avec le drafter, 70 sans |
| Qualité, d'après les tests de NVIDIA | devant Qwen3.6-35B-A3B sur la plupart des tests d'agent que NVIDIA publie (Terminal-Bench 2.1 : 51,0 contre 44,4), juste derrière sur un, derrière sur les connaissances factuelles |
| Licence | OpenMDW-1.1, usage commercial autorisé |
| Le piège | il faut une version de llama.cpp (le programme gratuit qui le fait tourner) du 15 octobre ou plus récente, et celle que notre plateforme installe par défaut est plus ancienne |
Une équipe de spécialistes plus réduite
Bolt est le petit membre d'une famille. Son parent, Nemotron 3.5 Super VL, a 120 milliards de paramètres. Non compressé, il lui faut quatre des grands GPU de data center de NVIDIA (H100), ou deux des plus récents (GB200). Nous avons repéré la famille dans la vidéo d'actualité d'AI Search du 18 octobre, qui parle du parent et le qualifie de "still quite huge" (toujours assez énorme).
Les deux sont ce qu'on appelle un mélange d'experts (mixture of experts). Imaginez une grande équipe de spécialistes. Pour chaque mot, une poignée d'entre eux sont choisis pour faire le travail, et les autres attendent. C'est pour ça que le nom dit A9B : sur les 74 milliards de paramètres, environ 9 milliards travaillent sur un mot donné, ce qui le garde rapide.
NVIDIA a construit Bolt en réduisant l'équipe du parent. Une méthode d'entraînement a appris combien de spécialistes garder dans chaque partie du modèle et quelle taille donner à chacun, le parent vérifiant ses réponses au passage (le rapport technique donne les détails). Chaque partie est passée de 512 spécialistes à un nombre compris entre 240 et 496, et chaque mot en consulte désormais 9 au lieu de 22. L'objectif était de tenir sous les 24 GB. Cet entraînement a tourné sur 128 GPU de data center de NVIDIA pendant environ 64 heures.
La réduction a coûté environ 5 % du score : en moyenne sur neuf tests, le parent obtenait 57,58 et le modèle réduit 54,74, avant l'entraînement supplémentaire que NVIDIA a ensuite fait sur les images, les tâches d'agent et le code.
Compressé fort, exprès
Même réduit, Bolt non compressé occupe 148 GB. NVIDIA le livre fortement compressé, comme une photo enregistrée en qualité bien plus basse, et il arrive à 22,1 GB, 85 % plus petit. Les spécialistes, qui forment l'essentiel du modèle, sont les plus compressés. Les parties plus petites par lesquelles passe chaque mot gardent plus de détail.
Compresser un modèle aussi fort lui coûte d'habitude beaucoup de précision. NVIDIA a continué à entraîner Bolt après l'avoir compressé, la version non compressée corrigeant ses réponses. Une partie de la perte reste : sur Terminal-Bench 2.1, un test de travail d'agent dans un terminal, Bolt obtient 53,93 non compressé et 50,98 tel qu'on le télécharge.
24 GB sur le papier, pour le texte seul
D'après les calculs de NVIDIA, la version texte seul tient dans 24 GB, avec 23,83 GB utilisés. La marge qui reste dépend de l'unité : une carte grand public de 24 GB contient 24 GiB, donc si le chiffre de NVIDIA est en GB décimaux il reste environ 1,9 GB, et s'il est en GiB environ 0,2. NVIDIA compte 0,96 GB pour le drafter, et dans notre déploiement il a coûté environ 2,4 GB. Savoir si Bolt tient sur une vraie carte de 24 GB reste donc une question ouverte. Nous n'en avons pas essayé.
Le lecteur d'images ajoute 1,68 GB, ce qui laisse peu ou pas de place, même sur le papier. Les configurations llama.cpp de NVIDIA, qui chargent le lecteur d'images, commencent aux cartes de 32 GB.
La page du modèle chez NVIDIA propose deux configurations llama.cpp. La plus petite vise les cartes graphiques de 32 GB ou plus et garde 65 536 tokens de conversation. La plus grande vise les cartes de 48 GB ou plus et en garde 262 144. La commande de démarrage rapide de la même page se situe entre les deux, à 98 304 tokens, et c'est celle que nous avons lancée.
Un assistant rapide qui devine en avance
Un modèle écrit normalement un token à la fois. NVIDIA livre avec Bolt un second modèle, beaucoup plus petit, le drafter LiLiCorr, environ 1,1 milliard de paramètres dans un fichier de 1,0 GB. Le drafter devine les quelques tokens suivants, et Bolt les vérifie tous en une seule passe, les garde jusqu'au premier avec lequel il n'est pas d'accord et écrit celui-là lui-même. Quand les devinettes sont bonnes, plusieurs tokens sortent pour le prix d'une seule vérification.
Le drafter devine tout un bloc de mots d'un coup et vérifie que ses devinettes vont bien ensemble, si bien qu'on en garde davantage. Dans les tests de NVIDIA, chaque vérification faisait avancer la réponse d'environ 4 à 5 tokens, plus sur le code et moins sur la prose.
Ses scores, d'après les chiffres de NVIDIA
Tous les chiffres de cette section viennent de la page du modèle et du rapport de NVIDIA. Nous ne les avons pas refaits. Face à Qwen3.6-35B-A3B, un modèle ouvert plus petit auquel NVIDIA le compare :
| Test (ce qu'il mesure) | Bolt, tel que téléchargé | Qwen3.6-35B-A3B |
|---|---|---|
| Terminal-Bench 2.1 (travail d'agent dans un terminal) | 50,98 | 44,38 |
| BrowseComp (trouver des faits en naviguant) | 66,75 | 48,74 |
| GPQA Diamond (sciences de niveau doctorat) | 86,43 | 83,40 |
| PinchBench (un benchmark d'agent) | 87,82 | 88,07 |
| Précision AA-Omniscience (rappel de faits) | 16,90 | 19,47 |
| AA-Omniscience, réponses sans rien inventer | 61,27 | 65,85 |
Bolt gagne la plupart des tests d'agent et de raisonnement que NVIDIA publie et perd PinchBench d'un cheveu. Il perd aussi sur le rappel de faits, où il invente un peu plus souvent. Sur un test d'utilisation d'outils, l'équipe de Qwen annonce pour son propre modèle un score bien plus élevé (62,8) que celui mesuré par NVIDIA (51,2), ce qui rappelle que ces chiffres dépendent de qui les mesure. Gemma 4 26B-A4B de Google bat Bolt pour suivre des instructions détaillées (IFBench, 77,25 contre 66,17). La réduction et la compression ensemble ont coûté à Bolt environ 11 points sur Terminal-Bench 2.1 : le parent en taille réelle obtient 61,94, Bolt tel que téléchargé 50,98.
Le propre test de vitesse de NVIDIA montre que Bolt est l'option la plus lente : sur un ordinateur portable Surface avec 128 GB de mémoire, il écrivait environ 84 tokens par seconde sur du code, contre environ 97 pour Qwen3.6 et 101 pour Gemma 4. Vous échangez donc un peu de vitesse contre de meilleurs scores d'agent.
Ce qu'il faut pour le faire tourner
Il y a deux voies. La première est llama.cpp, le programme gratuit et open source qui fait tourner ce genre de modèle sur votre propre machine. Kartik Gulia, ingénieur chez NVIDIA, a écrit le code qui permet à llama.cpp de faire tourner Bolt et son lecteur d'images, et le mainteneur de llama.cpp, ggerganov, l'a accepté le 15 octobre (pull request #30520). Une version plus ancienne ne peut pas charger le fichier.
La seconde est vLLM, un logiciel serveur conçu pour les data centers. Pour l'instant, il faut une version de test précise de vLLM, nommée sur la page du modèle chez NVIDIA. La page se contredit sur les générations de GPU NVIDIA prises en charge : trois à un endroit, seulement la plus récente à un autre. Nous n'avons pas essayé cette voie.
La licence est OpenMDW-1.1. Elle autorise l'usage, la modification et la redistribution pour n'importe quel but, ne met aucune limite à ce que vous faites des sorties, et vous demande de garder la licence et les mentions quand vous transmettez le modèle. La page du modèle chez NVIDIA dit qu'il est prêt pour un usage commercial.
Le faire tourner sur InferenceKey
Le GPU et le logiciel
Nous l'avons fait tourner sur une NVIDIA A40 de 48 GB, louée sur RunPod. Nous voulions d'abord une carte de 32 GB, la taille que cite la plus petite configuration de NVIDIA, et nous avons obtenu deux machines RTX 5090. Les deux avaient un GPU en panne (plus de détails plus bas), donc l'A40 a servi de solution de repli. C'est une génération de GPU plus ancienne que celles qu'indique la page llama.cpp de NVIDIA, et elle a fonctionné quand même.
Nous avons utilisé la prise en charge de llama.cpp intégrée à InferenceKey, sans code spécifique dans la plateforme. Elle compile llama.cpp sur la machine GPU et lance une seule commande qui télécharge le modèle, le lecteur d'images et le drafter. Nous avons choisi llama.cpp parce que les fichiers et recettes officiels de NVIDIA sont faits pour lui. Notre commande reprend les réglages du démarrage rapide, mais récupère les fichiers directement depuis Hugging Face, le site où NVIDIA les publie, au lieu de les télécharger d'abord.
Ça n'a pas marché du premier coup, cela dit. Le worker, le petit programme qu'InferenceKey installe sur chaque machine GPU, installe une version de llama.cpp antérieure de 1 920 modifications à la prise en charge de Bolt, et la plateforme n'a aucun moyen de changer ça de l'extérieur. Nous nous sommes connectés à la machine et avons réglé plusieurs choses à la main sur le worker : la version plus récente de llama.cpp, une compilation plus rapide et un délai plus long avant d'abandonner, plus le chemin du compilateur CUDA, par précaution.
Les étapes
Notre script d'exemple (dans le SDK d'InferenceKey, la bibliothèque Python de la plateforme) demande à InferenceKey de faire tourner le modèle sur votre machine GPU, attend qu'il soit prêt, pose une question de raisonnement, lit un ticket de caisse à partir d'une image, lance un agent de remboursement à deux outils, enregistre les réponses et arrête le modèle. La commande qu'il lance sur le GPU :
llama-server -hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  --hf-file NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --spec-draft-hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  --spec-type draft-dflash --spec-draft-n-max 6 --spec-draft-ngl 999 -ngl 999 \
  --batch-size 2048 --ubatch-size 512 --ctx-size 98304 --parallel 1 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja
Avant de la lancer, il faut ajouter des réglages au worker sur la machine GPU elle-même. Le README de l'exemple liste les trois qui comptent : la version de llama.cpp (v0.7.0), le nombre de tâches de compilation à lancer en parallèle, et un délai plus long avant que la plateforme abandonne le premier démarrage, parce que compiler llama.cpp et télécharger 24,7 GB peut prendre plus longtemps que ce que permet le délai par défaut. Ensuite, vous parlez au modèle avec le même format de chat que le service d'OpenAI, outils compris. Nous avons tout lancé depuis une copie privée d'InferenceKey sur notre machine de développement, jamais sur le service en production.
Ce que nous avons mesuré
La réponse sur le ticket en 3,4 secondes au lieu de 7. Avec le drafter, la réponse sur le ticket de caisse est revenue en environ 3,4 secondes. Sans lui, 7. Sur 25 requêtes, une à la fois, le modèle a écrit environ deux fois plus vite avec le drafter : une médiane de 136 tokens par seconde contre 70, jamais en dessous de 110. La réponse sur le diagramme en barres, 930 tokens, a pris moins de 8 secondes. Une partie de ce qu'il écrit est une réflexion cachée que vous ne voyez jamais, donc la réponse visible est plus courte que le nombre de tokens. Les devinettes du drafter ont été gardées 70 % du temps, et le gain était le plus grand sur la lecture d'images et sur l'une des deux tâches de code.
Un peu plus de la moitié de la carte. Avec le lecteur d'images, le drafter et la place pour 98 304 tokens, le modèle a utilisé environ 27 GB sur les 48 de l'A40. Sans le drafter, il utilisait environ 2,4 GB de moins.
Les longs documents passent, avec un démarrage plus lent. Nous avons caché un code au milieu d'un document d'environ 25 000 tokens et d'un autre d'environ 71 000 tokens. Les deux fois, le modèle l'a trouvé exactement. Lire le document de 71 000 tokens a pris 58 secondes. Sur les longs documents, le drafter gêne. Avec la question à 25 000 tokens, le modèle a répondu en 17,5 secondes sans lui et en 21,5 secondes avec lui, parce que le drafter ralentit la lecture d'environ un quart.
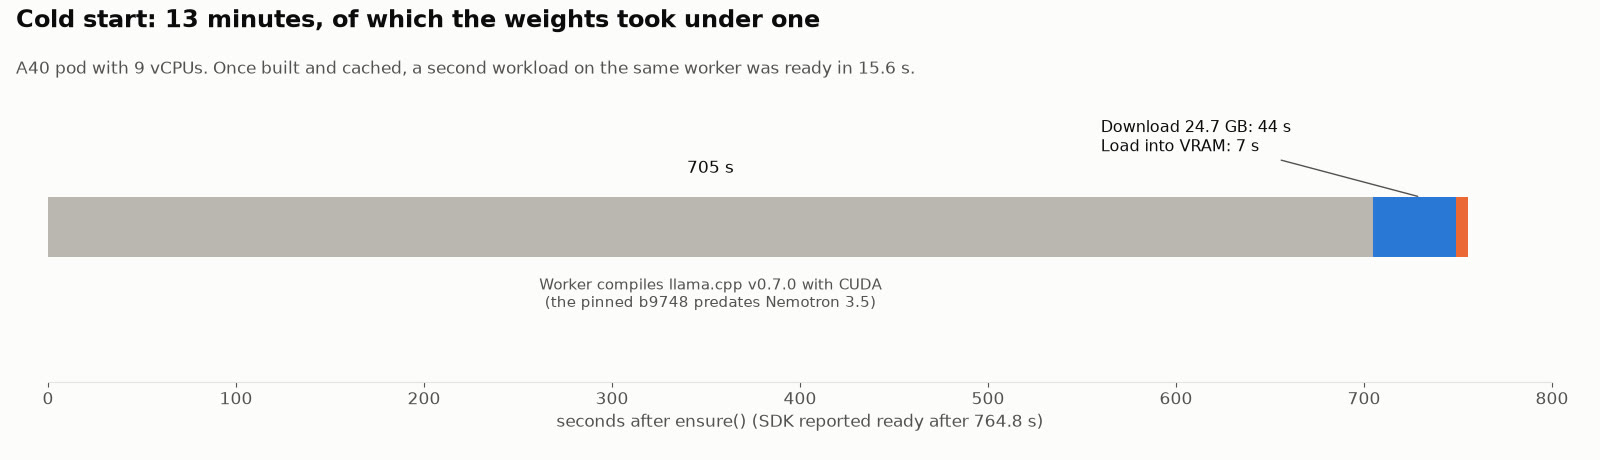
Prêt en moins de 13 minutes, presque toutes passées à compiler. De la demande du modèle à "prêt", il a fallu 764,8 secondes sur une machine neuve. Télécharger les 24,7 GB de fichiers a pris environ 44 secondes et les charger environ 7. Les 705 secondes restantes sont parties dans la compilation de llama.cpp pour le GPU sur les 9 cœurs de processeur de la machine. Démarrer une seconde copie du modèle sur la même machine, avec llama.cpp déjà compilé, a pris 15,6 secondes.
Ce qu'il a répondu
Ce sont nos propres questions, environ 50 requêtes en tout, la plupart posées une seule fois, avec des images que nous avons dessinées nous-mêmes. Elles montrent un comportement, pas une qualité de benchmark.
- Un robot d'entrepôt et sa batterie : 14 mètres et 28 % de batterie, juste sur les 4 essais.
- Une petite tâche de code (fusionner des intervalles qui se chevauchent) : code correct, avec trois tests qu'il a écrits lui-même.
- Un résumé de deux phrases en espagnol : correct et naturel.
- Un ticket de café en image : tous les prix et le total de 15,20 justes sur les 5 essais. Dans 3 d'entre eux, il a écrit l'article "Tostada tomate" sous la forme "Tostada tomato".
- Un diagramme en barres : les cinq valeurs bien lues et le total de 270 correct.
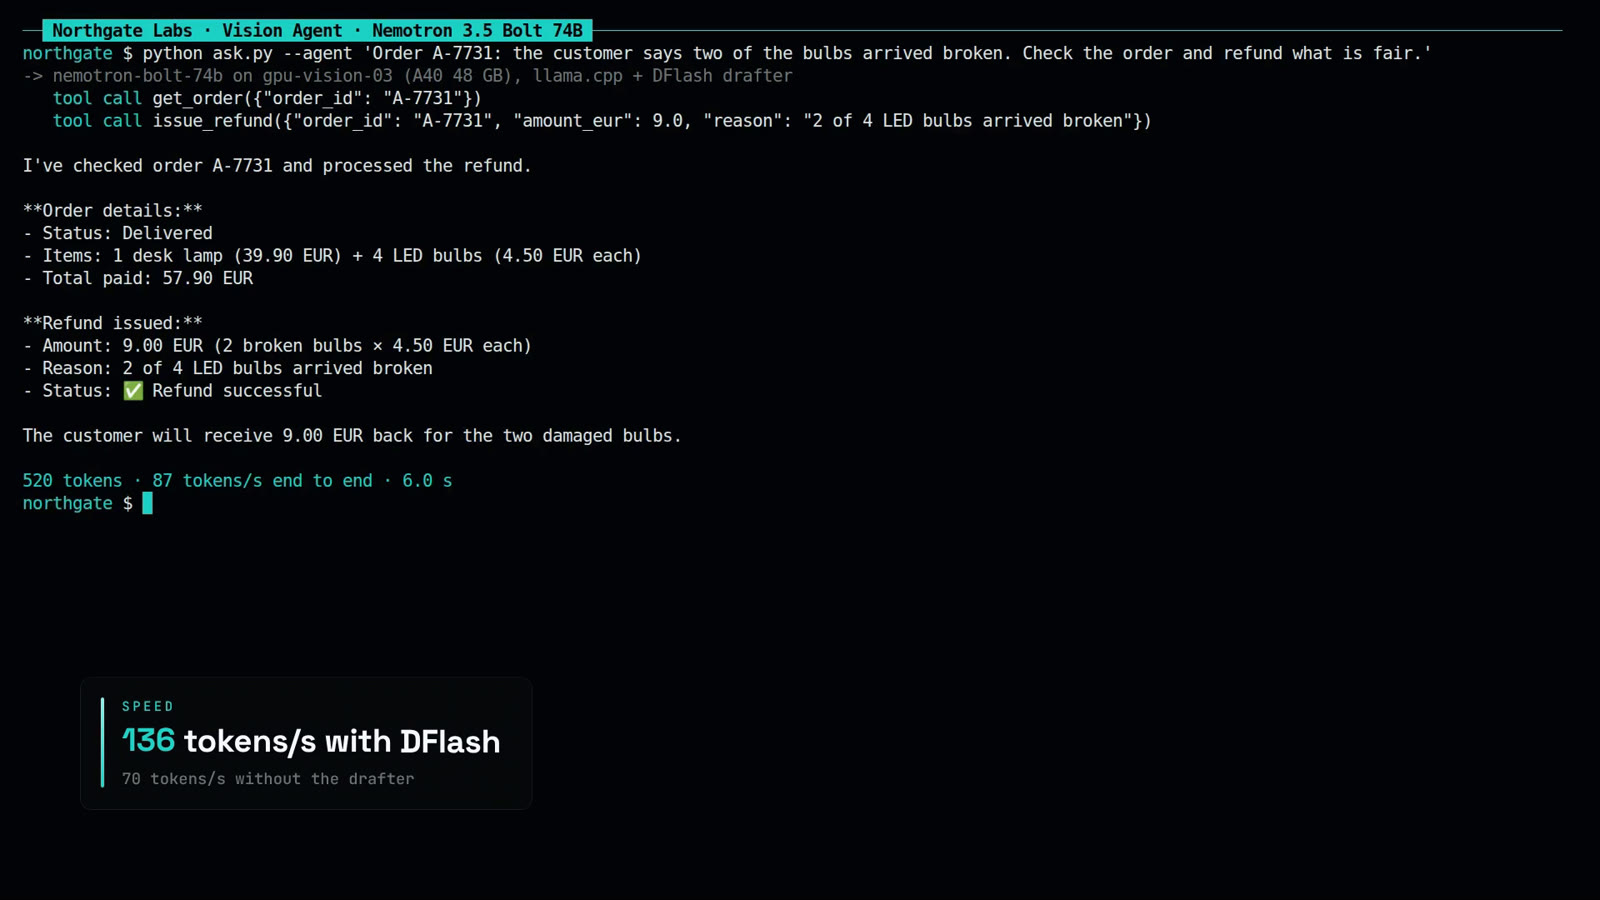
- L'agent de remboursement : deux des quatre ampoules d'une commande sont arrivées cassées, et le modèle avait un outil pour consulter la commande et un autre pour émettre un remboursement. Sur les 5 essais, il a appelé l'outil de commande, puis remboursé 9 euros pour les deux ampoules à 4,50 euros pièce, et n'a jamais remboursé la lampe à 39,90 euros de la même commande. Les appels d'outils sont sortis au format standard d'OpenAI à chaque fois.
- Le code caché à environ 25 000 et 71 000 tokens : trouvé les deux fois.
Aucune réponse n'a tourné en boucle, n'est revenue vide ni n'a été coupée.
L'enregistrement de la démo
Dans l'enregistrement de notre démo, le terminal affichait 87 tokens par seconde pour l'agent de remboursement (520 tokens en 6,0 s). Ce chiffre est de bout en bout : il compte la réflexion cachée du modèle et le passage par la plateforme, donc il est plus bas que la vitesse d'écriture ci-dessus.
Ce qui a mal tourné
La plupart des problèmes venaient des machines louées et de notre propre plateforme, pas du modèle. La seule bizarrerie du modèle qui mérite d'être notée, c'est tout ce qu'il réfléchit avant de répondre (dernier point ci-dessous).
- Deux GPU en panne déclarés en bonne santé. Les deux machines RTX 5090 sont tombées sur le même hôte. La carte apparaissait, mais aucun programme ne pouvait réellement s'en servir. InferenceKey a quand même marqué les deux workers en ligne et le modèle prêt, parce que rien dans la plateforme ne vérifie que le GPU marche vraiment. Nous les avons supprimées au bout de 5 et 1 minutes. C'est pour ça que nous n'avons aucun chiffre sur 32 GB.
- Le llama.cpp de notre worker est trop ancien pour ce modèle, et on ne peut pas le changer depuis la plateforme. La version ne se règle que sur le worker lui-même, et InferenceKey n'a aucun moyen de passer des réglages supplémentaires à un worker sur une machine louée. Nous nous sommes connectés à la machine, les avons ajoutés à la main et avons redémarré le worker.
- Presque tout le premier démarrage sert à compiler le logiciel. Par défaut, notre worker compile llama.cpp avec une seule tâche à la fois, et c'est à nous de le corriger. Même avec 12 tâches en parallèle, réglées à la main, la compilation a pris 705 secondes sur les 9 cœurs de la machine A40, 92 % de l'attente. La même compilation sur une machine à 31 cœurs a pris 2 minutes 41 secondes.
- Une réflexion cachée qui coûte du temps qu'on ne voit pas. Le modèle réfléchit avant de répondre. Quand la réponse revient d'un seul bloc, InferenceKey supprime ce texte de réflexion mais le compte quand même : la réponse d'une phrase sur le robot a pris 374 tokens de temps d'écriture. Le réglage indiqué sur la page du modèle chez NVIDIA pour couper la réflexion n'est pas transmis par InferenceKey, donc nous n'avons pas pu la couper.
- Aucun chiffre de vitesse dans la réponse. llama.cpp mesure ses propres temps, et InferenceKey ne les transmet pas. Nos chiffres de vitesse viennent du log du serveur sur la machine.
- Un seul réglage du drafter par modèle. Cette version de llama.cpp ne peut pas activer ou désactiver le drafter requête par requête, donc la comparaison a demandé une seconde copie du modèle. Rapide, avec 15,6 secondes de démarrage, mais maladroit.
- Petites choses : le tableau de bord affichait "No access" pour une clé qui marchait, et RunPod n'avait plus d'A40 dans son pool communautaire.
À chacun son mérite
NVIDIA a fait le plus dur : entraîner le parent, le compresser pour en faire Bolt, entraîner la version compressée, construire le drafter LiLiCorr, publier les fichiers llama.cpp avec des recettes prêtes à lancer, écrire un rapport technique détaillé, et publier le tout sous une licence ouverte qui autorise l'usage commercial. Kartik Gulia, de NVIDIA, a écrit la prise en charge de Bolt dans llama.cpp dans la #30520, et ggerganov l'a fusionnée dans llama.cpp le jour de la sortie, ce qui permet tout simplement à llama.cpp de le charger. AI Search a parlé du parent dans sa vidéo d'actualité, et la sortie est aussi apparue sur r/LocalLLaMA.
Notre part, c'est le script d'exemple, le déploiement de bout en bout via InferenceKey sur une A40, et la mesure de la vitesse, de la mémoire, du temps de démarrage et de son comportement sur nos propres questions.
Ce qu'il faut retenir
Un modèle agent de 74B qui lit les images a tourné sur une seule carte de data center de 48 GB, en en utilisant un peu plus de la moitié. Pour un utilisateur, il a écrit 136 tokens par seconde, dont une partie de réflexion cachée. Il a appelé les outils correctement sur notre unique tâche de remboursement. C'est le drafter qui le rend rapide : sans lui, la vitesse est divisée par deux. Nous avons mesuré ce gain avec une requête à la fois. Les drafters gagnent souvent moins quand plusieurs requêtes se partagent la carte, et nous ne l'avons pas testé.
En clair : une carte de 48 GB, remplie à un peu plus de la moitié, a fait tourner ce modèle agent environ deux fois plus vite qu'il n'y arrive sans le drafter. Avec nos réglages, il sert une personne à la fois, donc nous ne pouvons pas dire comment il tient pour toute une équipe.
Les limites sont claires. Les chiffres de qualité sont ceux de NVIDIA, et nos vérifications se résument à environ 50 requêtes à nous. Et dans le propre tableau de vitesse de NVIDIA, des modèles plus petits comme Qwen3.6-35B-A3B écrivent plus vite, donc on choisit Bolt pour ses scores d'agent, pas pour sa vitesse.
La réponse est donc oui sur une carte de 48 GB. Sur une carte de 32 GB, la taille que cite la plus petite configuration de NVIDIA, la question reste ouverte : nous ne l'avons pas fait tourner sur une telle carte. Les 27 GB que nous avons mesurés devraient y laisser environ 5 GB de marge. La prochaine mesure que nous devons, c'est sa vitesse sur une RTX 5090, une carte de 32 GB plus récente que l'A40.
Pour les ingénieurs
Modèle (fiche, GGUF, drafter, page de recherche, rapport technique). Publié le 2026-10-15. Données arrêtées en mai 2026. 74B au total, 9B actifs, LatentMoE hybride Mamba-2/Transformer, encodeur de vision C-RADIO v4-H. Entrée texte, images, vidéo (mp4 jusqu'à 2 min). Sortie texte. Contexte jusqu'à 256K. 40 couches Mamba, 40 MoE, 8 d'attention, hidden 4096 (repris du parent). Star Elastic : un router conditionné par le budget choisit le nombre d'experts routés et la largeur intermédiaire MoE par couche, entraîné conjointement avec une distillation KL depuis le parent gelé. Experts routés de 512 à 240-496 par couche, largeur intermédiaire de 2688 à 1536-2560, top-k de 22 à 9. Cible sous 24 GB en batch 1, contexte 128K. Entraînement de compression : 72B tokens à 8K plus 48B à 128K, 32 nœuds GB200 (128 GPU), environ 64 h. Moyenne sur neuf benchmarks de 57,58 à 54,74 (-2,85, -4,94 % en relatif) avant le post-training. Post-training : réentraînement de l'adaptateur de vision, SFT axé vision, fusions SLERP (80:20, 75:25), RL MCP-Atlas, RLHF, SWE-RL. Langues : anglais et code en priorité, aussi espagnol, français, allemand, italien, japonais. Appel d'outils. Réflexion activée ou désactivée avec chat_template_kwargs.enable_thinking. Échantillonnage temperature 1.0, top_p 0.95. Parent Super VL : BF16 sur 4x H100 (TP4) ou 2x GB200 (TP2), version NVFP4 publiée à part.
Quantification. Poids uniquement. Experts routés et partagés en IQ2_XXS (2,0625 bpw), projections d'entrée/sortie Mamba en NVFP4, attention, latent MoE, embedding et LM head en Q8_0. QAD : 26B tokens, LR 1e-5 avec warmup de 1,2B tokens, cosinus jusqu'à 1e-7 sur 25B. Seconde étape de QAD de 10M tokens avec un teacher plus récent. 148 GB en BF16 vers 22,1 GB (-85,1 %). Budget NVIDIA (Table 2, batch 1, contexte 131 072) : poids 22,01 GB (experts routés 17,05), runtime 0,87 (KV FP8 0,54, SSM Mamba 0,08, activations 0,25) = 22,87, plus drafter 0,96 = 23,83 GB. Encodeur de vision et projecteur, 1,68 GB en BF16, exclus (cible texte seul).
Fichiers. Repo GGUF sha e0fecb69 : NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf 22 018 326 528 B, mmproj 1 733 692 736 B. Repo du drafter sha 182d2987 : 998 242 560 B. 24,75 GB au total, non gated. Drafter : 1,13B paramètres hors embeddings et LM head partagés (tête LiLiCorr de 37M), cinq couches, bloc de 8 positions (7 emplacements de draft), fenêtre glissante de 1 024 tokens, attention sinks, arch GGUF dflash. llama.cpp le fait tourner via son mode spéculatif DFlash (--spec-type draft-dflash). LiLiCorr note conjointement les candidats top-K sur tout le draft en une passe, ce qui améliore la sélection indépendante des tokens de DFlash et la correction séquentielle de DSpark (arXiv 2608.20530). Acceptation selon NVIDIA (vLLM, longueur de draft 7, concurrence 64, SPEED-Bench 880 prompts) : longueur moyenne acceptée 4,681 (temp 0) / 4,248 (temp 1) avec le drafter NVFP4, 4,736 / 4,288 en BF16. Code 5,18-5,74, écriture 3,36-3,73. AL estimée AA AgentPerf Local : LiLiCorr 4,18, DSpark 3,68.
Recettes (fiche GGUF). "RTX Spark 64GB or RTX discrete GPU 32GB+" : recette 28GB, contexte 65 536, 1 séquence, jusqu'à 6 drafts, KV q8_0. "RTX Spark 128GB or RTX discrete GPU 48GB+" : recette 32GB, contexte 262 144, 1 séquence, jusqu'à 7 drafts, batch/ubatch 4096/2048, sans quantification du KV. Démarrage rapide : flags de réglage de la recette 28GB avec --ctx-size 98304, chargement de fichiers locaux avec --model, --mmproj et --spec-draft-model après hf download. Nous avons lancé les mêmes flags de réglage avec -hf, --hf-file et --spec-draft-hf à la place (-hf récupère le mmproj). Flags communs -ngl 999 --spec-type draft-dflash --spec-draft-ngl 999 --temp 1.0 --top-p 0.95 --flash-attn on --jinja. Compilation pour GPU discret : cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON puis cmake --build build --config Release -j. La fiche liste Ada Lovelace et Blackwell. Notre déploiement sur Ampere sm_86 a fonctionné. vLLM : vllm/vllm-openai:nightly-77154ca6116ae34cbfe314beef1016bde9b63989, TP 1, longueur max 262144, max seqs 1, 7 tokens spéculatifs, pip install b12x, vllm download-kernels, VLLM_USE_V2_MODEL_RUNNER=1, --enable-auto-tool-choice --tool-call-parser qwen3_coder. Matériel annoncé comme A100/H100/Blackwell dans le résumé et Blackwell SM120/SM121 dans Software Integration. Non testé par nous.
llama.cpp. PR #30520 "Add Nemotron Super 3.5 VL and Nemotron Bolt 74B A9B support", ouverte par frozenblade1224 (Kartik Gulia, NVIDIA), fusionnée par ggerganov le 2026-10-15T13:34:57Z (cd0a5b6a). Le tag v0.7.0 (620d2225) vient un commit plus tard. Le tag par défaut de notre worker, b9748, a 1 920 commits de retard sur la fusion. Le speculative.n_max par requête est désactivé à la compilation dans v0.7.0.
Benchmarks (Technical Report Table 7, déclarés par NVIDIA). Bolt IQ2 / Qwen3.6-35B-A3B BF16 / Gemma4 26B-A4B / Nemotron 3.5 Lightning 30B-A3B : Terminal-Bench 2.1 50,98 / 44,38 / 37,22 / 23,46, BrowseComp 66,75 / 48,74 / 26,30 / 36,81, GPQA Diamond 86,43 / 83,40 / 79,61 / 75,57, GDPVal-AA-V2 28,47 / 25,75 / 15,33 / 18,26, HLE (sans outils) 25,30 / 19,56 / 17,42 / 10,47, SciCode 41,02 / 35,33 / 40,28 / 31,38, AA-LCR 64,06 / 61,06 / 57,56 / 49,19, Tau3 Banking 17,01 / 10,52 / 14,02 / 9,48, WebArena (vision) 50,86 / 36,60 / 38,2 / -, MCP-Atlas 52,20 / 51,2 (Qwen annonce 62,8) / - / 46,4, PinchBench 87,82 / 88,07 / 74,70 / 83,43, précision AA-Omniscience 16,90 / 19,47 / 22,17 / 16,63, non-hallucination AA-Omniscience 61,27 / 65,85 / 14,22 / 68,81, IFBench 66,17 / 63,71 / 77,25 / 72,88. Parent Super VL BF16 : TB2.1 61,94, BrowseComp 71,50, GPQA 90,78. Bolt BF16 53,93 / 70,00 / 88,83. Vitesse selon NVIDIA (Table 8, llama.cpp, Windows 11 ARM, RTX Spark Surface Laptop Ultra 128 GB) : Bolt IQ2_XXS + LiLiCorr 83,99 TPS SPEED-Bench-Coding, 600,80 s AA AgentPerf Local, Qwen3.6 35B-A3B UD-Q4_K_M + MTP 96,63 / 453,97 s, Gemma 4 26B-A4B UD-Q4_K_M + MTP 100,56 / 480,68 s, Qwen3.8 27B UD-Q4_K_M + DFlash 28,26 / 1 043,28 s.
Notre configuration. RunPod A40 48 GB secure cloud, 46 068 MiB (48,3 GB), driver 595.91.07, compute 8.6, 9 vCPU, image runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404 (nvcc 12.8). Worker amorcé par un manager InferenceKey local via des tunnels HTTP et TCP. La production n'a jamais été touchée. Env du worker ajouté à la main : INFERENCEKEY_LLAMACPP_TAG=v0.7.0, CMAKE_BUILD_PARALLEL_LEVEL=12, INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000, CUDACXX=/usr/local/cuda/bin/nvcc, /usr/local/cuda/bin dans le PATH (sans vérifier si cmake trouve nvcc sans les deux derniers). Environ 6 minutes sont parties dans les deux pods communautaires RTX 5090 défectueux avant l'A40 (22,1 minutes). Commit de l'exemple du SDK 0c61916b sur la branche main d'inferencekey-sdk. L'essentiel :
spec = WorkloadSpec(
    name="Nemotron 3.5 Bolt 74B-A9B (llama.cpp, DFlash)",
    slug="nemotron-bolt-74b",
    model="nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF",
    backend=Backend.LLAMACPP,
    command=COMMAND,  # the llama-server line above
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=3600)
Temps jusqu'à prêt. De ensure() à prêt, 764,8 s : clone et compilation de v0.7.0 pour sm_86 avec 12 jobs, 704,7 s (92 %). Téléchargement environ 44 s (environ 560 MB/s). Chargement environ 7 s. Second workload (sans drafter, compilation en cache) 15,6 s. Même compilation sur le pod 5090 (31 vCPU, 32 jobs) : 2 min 41 s.
Mémoire et consommation. llama-server 25 816 MiB (27,1 GB, 25,2 GiB) avec drafter (pic de la carte 25 825 sur 46 068 MiB), 23 516 MiB (24,7 GB) sans. Les chiffres du texte sont en GB décimaux, comme les tailles de fichiers. Puissance maximale 303,4 W.
Par requête (/v1/chat/completions sans streaming, une à la fois, décodage d'après le print_timing de llama-server) :
| Cas | Tok sortie DFlash | tok/s DFlash | Acceptation | Aller-retour s | Tok sortie sans draft | tok/s sans draft | Aller-retour s |
|---|---|---|---|---|---|---|---|
| arithmétique du robot | 374 | 130,98 | 0,620 | 3,85 | 458 | 69,87 | 7,05 |
| merge_intervals | 642 | 153,62 | 0,754 | 4,94 | 602 | 70,14 | 9,36 |
| code (2e échantillon) | 1 095 | 136,49 | 0,647 | 8,62 | 891 | 70,38 | 13,34 |
| résumé en espagnol | 414 | 118,84 | 0,545 | 4,27 | 333 | 70,27 | 5,51 |
| image du ticket (796 tok de prompt) | 394 | 155,52 | 0,783 | 3,42 | 361 | 70,32 | 6,95 |
| image du diagramme en barres (1 078 tok de prompt) | 930 | 161,37 | 0,813 | 7,89 | 425 | 70,35 | 7,86 |
| boucle d'outils, 3 tours | 101 / 308 / 197 | 131,6 / 140,1 / 128,5 | 0,67 / 0,69 / 0,61 | 6,61 | 85 / 318 / 166 | 70,8 / 70,4 / 70,3 | 10,23 |
| aiguille, 24 944 tok de prompt | 101 | 131,16 | 0,667 | 21,48 | 102 | 63,39 | 17,52 |
| aiguille, 70 773 tok de prompt | 98 | 110,46 | 0,568 | 60,56 | non lancé |
Médiane de décodage 136,5 tok/s sur 25 requêtes avec drafter (de 110,5 à 161,9, sorties de plus de 200 tokens 146,5) contre 70,3 sur 9 sans (63,4 à 25K, 69,9 à 70,8 sinon) : environ 1,9x (de 1,7x à 2,3x selon le prompt). Le décodage compte les tokens de raisonnement. Acceptation 69,7 % (6 509 sur 9 336), longueur moyenne acceptée médiane 5,0 sur 6. Prefill à 24 944 tokens 1 265 tok/s avec drafter, 1 667 sans. À 70 773 tokens 1 216 tok/s (58,2 s). Exemple du SDK : réponse de raisonnement 3,9 s (265 tokens), ticket 4,4 s, boucle à deux outils 7,0 s. Démo : ticket 429 tokens en 3,8 s. Agent de remboursement 520 tokens en 6,0 s (87 tok/s de bout en bout, raisonnement compris). finish_reason: stop partout.
Problèmes de plateforme. (1) Deux pods communautaires RTX 5090 sur un même hôte : nvidia-smi fonctionnait, ggml_cuda_init: failed to initialize CUDA: unknown error, torch.cuda.is_available() False. Le manager a marqué le worker en ligne et le déploiement prêt. (2) Le llama.cpp b9748 figé ne peut pas charger le modèle. Le bootstrap RunPod écrit un manifeste d'env fixe sans champ pour de l'env supplémentaire. (3) cmake --build tourne sans -j, donc la compilation est séquentielle sauf si CMAKE_BUILD_PARALLEL_LEVEL est défini. (4) Les réponses sans streaming suppriment reasoning_content mais le comptent dans completion_tokens. chat_template_kwargs n'est pas transmis (robot 374 contre 328 tokens avec enable_thinking: false). Streaming non testé. (5) Les timings de llama-server ne sont pas transmis. (6) Contrôle du drafter par requête désactivé à la compilation, d'où un second workload. (7) A40 community en 409 rupture de stock, donc secure cloud. (8) Un relancement distant de bootstrap-worker.sh a été tué une fois par sa propre garde pkill -f. Relancé depuis son répertoire. (9) Le panneau affiche Access "No access" avec une clé wildcard qui fonctionne.
Nettoyage. Les deux workloads et les trois pods supprimés (manager 204, RunPod 404, liste de pods vide), stack locale, tunnels, NATS, base de données et bucket MinIO supprimés.
Limites. Un seul modèle de GPU (Ampere A40, 48 GB), aucune carte de 32 GB, une requête à la fois (--parallel 1, concurrence non testée), environ 50 requêtes avec nos propres prompts et des images synthétiques, la plupart avec un seul échantillon, temperature 1.0. Toutes les comparaisons de benchmarks et de vitesse avec d'autres modèles sont celles de NVIDIA. Voie vLLM non testée. La réflexion n'a pas pu être coupée via notre endpoint.
Sources : fiche du modèle, fiche GGUF, drafter LiLiCorr, page de recherche, rapport technique, Nemotron 3.5 Super VL, OpenMDW-1.1, llama.cpp #30520, exemple du SDK, vidéo d'AI Search, r/LocalLLaMA.