Nemotron 3.5 Bolt: ein 74B-Agentenmodell auf einer GPU, und was die 24 GB bedeuten
NVIDIA packt ein 74B-Agentenmodell mit Bildverständnis in 22 GB, meist 2-Bit-Gewichte. Auf einer A40: 136 Tokens/s mit Drafter, 70 ohne.
Kann eine einzige gemietete Grafikkarte ein 74B-Agentenmodell betreiben, das Bilder liest? NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB, veröffentlicht am 15. Oktober, ist ein Modell mit 74 Milliarden Parametern, das Text und Bilder liest und als Agent arbeitet: Es ruft Werkzeuge auf, um Aufgaben zu erledigen. Die Modelldatei hat 22.0 GB. Wir haben es auf einer gemieteten NVIDIA A40 betrieben, einer Grafikkarte (GPU) fürs Rechenzentrum mit 48 GB, mit eingeschaltetem Bildverständnis und eingeschaltetem Drafter, einem kleinen Hilfsmodell, das das Schreiben beschleunigt.
Die „24GB“ im Namen sind NVIDIAs Budget nur für Text: das Modell, Platz für etwa 128,000 Tokens Unterhaltung (ein Token ist ein Wortstück) für einen Nutzer, und der Drafter. Zusammen sind das 23.83 GB. Unser Lauf brauchte etwa 27 GB (25.2 GiB), aber das ist kein Vergleich auf Augenhöhe: Darin steckt der Bildleser, den NVIDIAs Budget weglässt. NVIDIAs eigene Setups für llama.cpp, das kostenlose Programm, mit dem die meisten solche Modelle auf einem einzelnen Rechner laufen lassen, beginnen bei Karten mit 32 GB.
Wir wollten wissen, ob ein 74B-Agentenmodell wirklich auf einer einzigen Karte läuft, die ein kleines Team mieten oder kaufen kann, und wie schnell. Auf einer Rechenzentrumskarte mit 48 GB tut es das. Auf einer Consumer-Karte mit 32 GB, der Größe, die NVIDIAs kleineres Setup nennt, ist es noch nicht bewiesen: Beide, die wir gemietet haben, waren defekt.
| Was | Ergebnis |
|---|---|
| Modell | Nemotron 3.5 Bolt 74B-A9B 24GB von NVIDIA, veröffentlicht am 15. Oktober: 74B Parameter (die Werte, die ein Modell im Training lernt), davon arbeiten 9B an jedem Wort, liest Text, Bilder und kurze Videos, schreibt Text, ruft Werkzeuge auf |
| Woher es kommt | eine abgespeckte Version von NVIDIAs Nemotron 3.5 Super VL mit 120B, danach stark komprimiert, sodass die Datei 85% kleiner ist |
| Download | 22.0 GB Modell, 1.73 GB Bildleser, 1.0 GB Drafter |
| Unsere GPU | eine NVIDIA A40 mit 48 GB, gemietet bei RunPod (eine ältere Rechenzentrumskarte) |
| Speicher im Betrieb | etwa 27 GB der 48-GB-Karte, etwas mehr als die Hälfte, mit Bildverständnis, Drafter und Platz für 98,304 Tokens Unterhaltung |
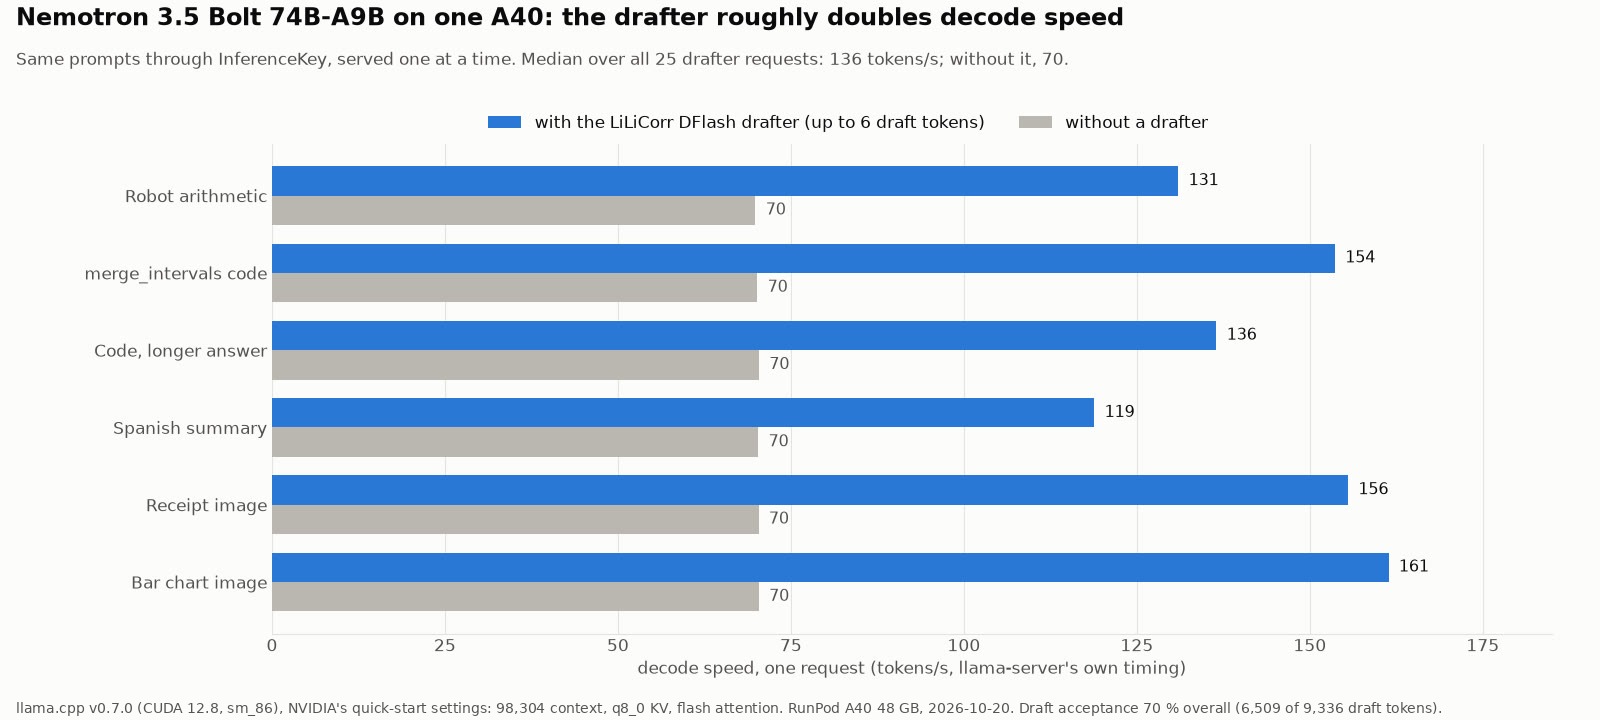
| Schreibtempo für einen Nutzer | 136 Tokens pro Sekunde mit Drafter, 70 ohne |
| Qualität, NVIDIAs eigene Tests | vor Qwen3.6-35B-A3B bei den meisten Agententests, die NVIDIA angibt (Terminal-Bench 2.1: 51.0 gegen 44.4), knapp dahinter bei einem, dahinter beim Faktenwissen |
| Lizenz | OpenMDW-1.1, kommerzielle Nutzung erlaubt |
| Der Haken | braucht eine Version von llama.cpp (dem kostenlosen Programm, das es ausführt) vom 15. Oktober oder neuer, und die Version, die unsere Plattform standardmäßig installiert, ist älter |
Ein kleineres Team von Spezialisten
Bolt ist das kleine Mitglied einer Familie. Sein Elternmodell, Nemotron 3.5 Super VL, hat 120 Milliarden Parameter. Unkomprimiert braucht es vier von NVIDIAs großen Rechenzentrums-GPUs (H100) oder zwei der neuesten (GB200). Entdeckt haben wir die Familie im News-Video von AI Search vom 18. Oktober, das das Elternmodell vorstellt und es „still quite huge“ nennt.
Beide sind eine sogenannte Mixture of Experts. Stell dir ein großes Team von Spezialisten vor. Für jedes Wort werden ein paar von ihnen ausgewählt, die die Arbeit machen, und der Rest wartet. Deshalb steht A9B im Namen: Von den 74 Milliarden Parametern arbeiten bei jedem Wort etwa 9 Milliarden, und das hält es schnell.
NVIDIA hat Bolt gebaut, indem es das Team des Elternmodells verkleinert hat. Ein Trainingsverfahren hat gelernt, wie viele Spezialisten in jedem Teil des Modells bleiben und wie groß jeder sein soll, während das Elternmodell unterwegs die Antworten prüfte (Details im technischen Bericht). Jeder Teil ging von 512 Spezialisten auf zwischen 240 und 496, und jedes Wort fragt jetzt 9 von ihnen statt 22. Das Ziel war, unter 24 GB zu kommen. Dieses Training lief etwa 64 Stunden auf 128 Rechenzentrums-GPUs von NVIDIA.
Das Verkleinern kostete etwa 5% der Punktzahl: Im Schnitt über neun Tests kam das Elternmodell auf 57.58 und das verkleinerte Modell auf 54.74, vor dem zusätzlichen Training, das NVIDIA danach mit Bildern, Agentenaufgaben und Code gemacht hat.
Stark komprimiert, mit Absicht
Selbst verkleinert braucht Bolt unkomprimiert 148 GB. NVIDIA liefert es stark komprimiert aus, wie ein Foto, das mit viel geringerer Qualität gespeichert wurde, und landet bei 22.1 GB, 85% kleiner. Die Spezialisten, die den Großteil des Modells ausmachen, sind am stärksten komprimiert. Die kleineren Teile, durch die jedes Wort läuft, behalten mehr Details.
Ein Modell so stark zu komprimieren, kostet normalerweise viel Genauigkeit. NVIDIA hat Bolt nach dem Komprimieren weiter trainiert, wobei die unkomprimierte Version seine Antworten korrigierte. Ein Teil des Verlusts bleibt: Bei Terminal-Bench 2.1, einem Test für Agentenarbeit im Terminal, kommt Bolt unkomprimiert auf 53.93 und in der heruntergeladenen Form auf 50.98.
24 GB auf dem Papier, nur für Text
Nach NVIDIAs eigener Rechnung passt die reine Textversion in 24 GB, mit 23.83 GB belegt. Wie viel Luft das lässt, hängt von der Einheit ab: Eine Consumer-Karte mit 24 GB hat 24 GiB. Ist NVIDIAs Zahl in dezimalen GB, bleiben also etwa 1.9 GB frei, ist sie in GiB, etwa 0.2. NVIDIA veranschlagt für den Drafter 0.96 GB, in unserem Lauf kostete er etwa 2.4 GB. Ob Bolt auf eine echte 24-GB-Karte passt, ist also noch offen. Wir haben keine ausprobiert.
Der Bildleser kommt mit 1.68 GB dazu, und dann bleibt selbst auf dem Papier wenig oder kein Platz. NVIDIAs llama.cpp-Setups, die den Bildleser laden, beginnen bei Karten mit 32 GB.
NVIDIAs Modellseite bietet zwei llama.cpp-Setups an. Das kleinere ist für Grafikkarten mit 32 GB oder mehr und fasst 65,536 Tokens Unterhaltung. Das größere ist für 48 GB oder mehr und fasst 262,144. Der Schnellstart-Befehl auf derselben Seite liegt dazwischen, bei 98,304 Tokens, und den haben wir laufen lassen.
Ein schneller Helfer, der vorausrät
Ein Modell schreibt normalerweise ein Token nach dem anderen. NVIDIA liefert mit Bolt ein zweites, viel kleineres Modell aus, den LiLiCorr-Drafter, etwa 1.1 Milliarden Parameter in einer Datei von 1.0 GB. Der Drafter rät die nächsten paar Tokens, und Bolt prüft sie alle in einem Durchgang, behält sie bis zum ersten, bei dem es anderer Meinung ist, und schreibt dieses selbst. Wenn die Tipps gut sind, kommen mehrere Tokens zum Preis einer Prüfung heraus.
Der Drafter rät einen ganzen Block von Wörtern auf einmal und prüft, ob die Tipps zusammenpassen, sodass mehr davon behalten werden. In NVIDIAs Tests brachte jede Prüfung die Antwort um etwa 4 bis 5 Tokens voran, mehr bei Code und weniger bei Fließtext.
Wie es abschneidet, nach NVIDIAs Zahlen
Alle Zahlen hier stammen von NVIDIAs Modellseite und aus dem Bericht. Wir haben sie nicht nachgemessen. Gegen Qwen3.6-35B-A3B, ein kleineres offenes Modell, mit dem NVIDIA es vergleicht:
| Test (was er misst) | Bolt, wie heruntergeladen | Qwen3.6-35B-A3B |
|---|---|---|
| Terminal-Bench 2.1 (Agentenarbeit im Terminal) | 50.98 | 44.38 |
| BrowseComp (Fakten durch Surfen finden) | 66.75 | 48.74 |
| GPQA Diamond (Naturwissenschaft auf Graduiertenniveau) | 86.43 | 83.40 |
| PinchBench (ein Agenten-Benchmark) | 87.82 | 88.07 |
| AA-Omniscience, Genauigkeit (Faktenwissen) | 16.90 | 19.47 |
| AA-Omniscience, Antworten ohne Erfundenes | 61.27 | 65.85 |
Bolt gewinnt die meisten Agenten- und Reasoning-Tests, die NVIDIA angibt, und verliert PinchBench um Haaresbreite. Es verliert auch beim Abrufen von Fakten, wo es etwas häufiger Dinge erfindet. Bei einem Test zur Werkzeugnutzung meldet das Qwen-Team selbst einen viel höheren Wert (62.8) als den, den NVIDIA dafür gemessen hat (51.2), eine Erinnerung daran, dass diese Zahlen davon abhängen, wer sie misst. Gemma 4 26B-A4B von Google schlägt Bolt beim Befolgen detaillierter Anweisungen (IFBench, 77.25 gegen 66.17). Verkleinern und Komprimieren zusammen kosteten Bolt etwa 11 Punkte bei Terminal-Bench 2.1: Das Elternmodell in voller Größe kommt auf 61.94, Bolt in der heruntergeladenen Form auf 50.98.
NVIDIAs eigener Geschwindigkeitstest zeigt, dass Bolt die langsamere Wahl ist: Auf einem Surface-Laptop mit 128 GB Speicher schrieb es bei Programmierarbeit etwa 84 Tokens pro Sekunde, gegen etwa 97 bei Qwen3.6 und 101 bei Gemma 4. Du tauschst also etwas Tempo gegen die stärkeren Agentenwerte.
Was du brauchst, um es zu betreiben
Es gibt zwei Wege. Der erste ist llama.cpp, das kostenlose Open-Source-Programm, das Modelle wie dieses auf deinem eigenen Rechner ausführt. Kartik Gulia, Engineer bei NVIDIA, hat den Code geschrieben, mit dem llama.cpp Bolt und seinen Bildleser ausführen kann, und der Maintainer von llama.cpp, ggerganov, hat ihn am 15. Oktober angenommen (Pull Request #30520). Ältere Versionen können die Datei nicht laden.
Der zweite ist vLLM, Serversoftware fürs Rechenzentrum. Vorerst braucht es eine bestimmte Testversion von vLLM, die auf NVIDIAs Modellseite genannt wird. Die Seite ist widersprüchlich, welche NVIDIA-GPU-Generationen unterstützt werden: an einer Stelle drei, an einer anderen nur die neueste. Diesen Weg haben wir nicht ausprobiert.
Die Lizenz ist OpenMDW-1.1. Sie erlaubt Nutzung, Änderungen und Weitergabe für jeden Zweck, setzt keine Grenzen dafür, was du mit den Ausgaben machst, und verlangt, dass du Lizenz und Hinweise beibehältst, wenn du das Modell weitergibst. NVIDIAs Modellseite sagt, es sei bereit für die kommerzielle Nutzung.
Betrieb auf InferenceKey
Die GPU und die Software
Wir haben es auf einer NVIDIA A40 mit 48 GB betrieben, gemietet bei RunPod. Eigentlich wollten wir zuerst eine 32-GB-Karte, die Größe, die NVIDIAs kleineres Setup nennt, und bekamen zwei RTX-5090-Maschinen. Beide hatten eine defekte GPU (mehr dazu unten), also war die A40 der Ausweichplan. Sie ist eine ältere GPU-Generation als die, die NVIDIAs llama.cpp-Seite auflistet, und lief trotzdem.
Wir haben die eingebaute llama.cpp-Unterstützung von InferenceKey genutzt, ohne eigenen Code in der Plattform. Sie baut llama.cpp auf der GPU-Maschine und führt einen Befehl aus, der das Modell, den Bildleser und den Drafter herunterlädt. Wir haben llama.cpp gewählt, weil NVIDIAs offizielle Dateien und Rezepte dafür gemacht sind. Unser Befehl nutzt die Einstellungen des Schnellstarts, holt die Dateien aber direkt von Hugging Face, der Seite, auf der NVIDIA sie veröffentlicht, statt sie vorher herunterzuladen.
Out of the box lief es allerdings nicht. Der Worker, das kleine Programm, das InferenceKey auf jede GPU-Maschine legt, installiert ein llama.cpp-Release, das 1,920 Änderungen älter ist als die Bolt-Unterstützung, und die Plattform kann das von außen nicht ändern. Wir haben uns auf der Maschine angemeldet und mehrere Dinge am Worker von Hand gesetzt: die neuere llama.cpp-Version, einen schnelleren Build und eine längere Wartezeit, bevor aufgegeben wird, dazu sicherheitshalber den Pfad zum CUDA-Compiler.
Die Schritte
Unser Beispielskript (im InferenceKey SDK, der Python-Bibliothek für die Plattform) bittet InferenceKey, das Modell auf deiner GPU-Maschine zu starten, wartet, bis es bereit ist, stellt eine Reasoning-Frage, liest einen Kassenbon aus einem Bild, lässt einen Erstattungsagenten mit zwei Werkzeugen laufen, speichert die Antworten und fährt das Modell herunter. Der Befehl, den es auf der GPU ausführt:
llama-server -hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  --hf-file NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --spec-draft-hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  --spec-type draft-dflash --spec-draft-n-max 6 --spec-draft-ngl 999 -ngl 999 \
  --batch-size 2048 --ubatch-size 512 --ctx-size 98304 --parallel 1 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja
Bevor er laufen kann, braucht der Worker zusätzliche Einstellungen auf der GPU-Maschine selbst. Das README des Beispiels nennt die drei, die zählen: die llama.cpp-Version (v0.7.0), die Zahl der parallel laufenden Build-Jobs und eine längere Wartezeit, bevor die Plattform den ersten Start aufgibt, weil das Bauen von llama.cpp und das Herunterladen von 24.7 GB länger dauern kann, als der Standard erlaubt. Danach sprichst du mit dem Modell im selben Chat-Format wie beim Dienst von OpenAI, Werkzeuge eingeschlossen. Alles lief von einer privaten Kopie von InferenceKey auf unserem Entwicklungsrechner, nie über den Live-Dienst.
Was wir gemessen haben
Die Antwort zum Kassenbon in 3.4 Sekunden statt 7. Mit Drafter kam die Antwort zum Kassenbon nach etwa 3.4 Sekunden zurück. Ohne ihn nach 7. Über 25 Anfragen, eine nach der anderen, schrieb das Modell mit Drafter etwa doppelt so schnell: im Median 136 Tokens pro Sekunde gegen 70, nie unter 110. Die Antwort zum Balkendiagramm, 930 Tokens, dauerte unter 8 Sekunden. Ein Teil dessen, was es schreibt, ist verborgenes Nachdenken, das du nie siehst, also ist die sichtbare Antwort kürzer, als die Token-Zahl vermuten lässt. Die Tipps des Drafters wurden in 70% der Fälle behalten, und der Gewinn war am größten beim Lesen von Bildern und bei einer der beiden Programmieraufgaben.
Etwas mehr als die halbe Karte. Mit Bildleser, Drafter und Platz für 98,304 Tokens belegte das Modell etwa 27 GB der 48 GB der A40. Ohne Drafter etwa 2.4 GB weniger.
Lange Dokumente gehen, mit langsamerem Start. Wir haben einen Code mitten in einem Dokument von etwa 25,000 Tokens versteckt und einen weiteren in einem von etwa 71,000 Tokens. Beide Male hat das Modell ihn exakt gefunden. Das Lesen des Dokuments mit 71,000 Tokens dauerte 58 Sekunden. Bei langen Dokumenten steht der Drafter im Weg. Bei der Frage mit 25,000 Tokens antwortete das Modell ohne ihn in 17.5 Sekunden und mit ihm in 21.5 Sekunden, weil der Drafter das Lesen um etwa ein Viertel verlangsamt.
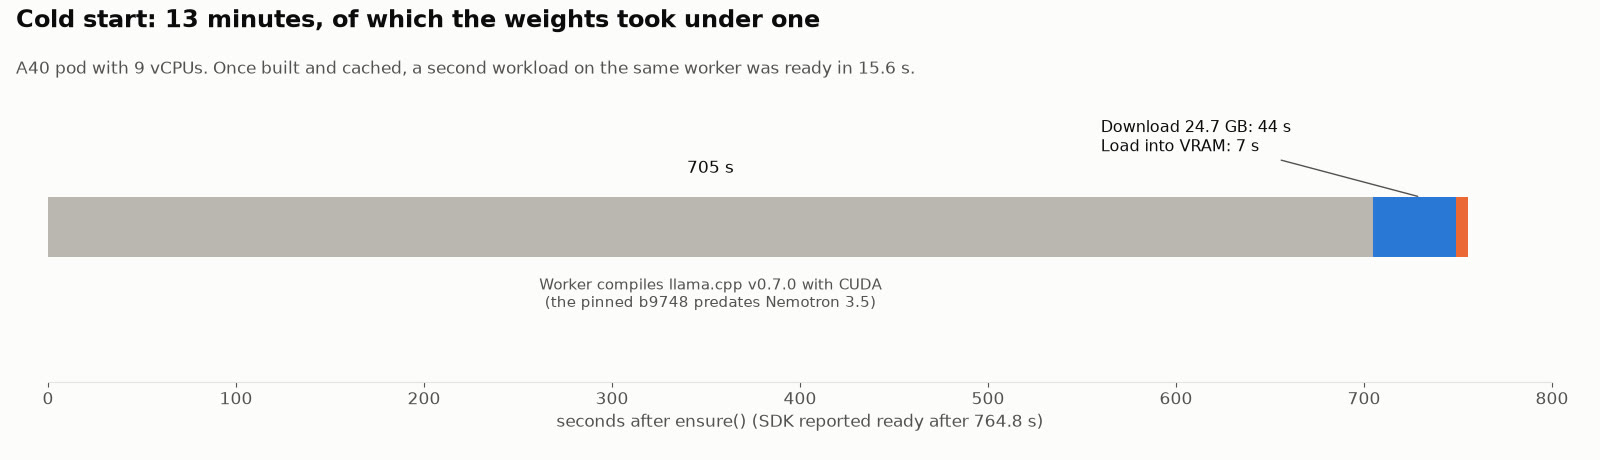
Bereit in unter 13 Minuten, fast alles davon Kompilieren. Von der Anforderung des Modells bis „bereit“ vergingen auf einer frischen Maschine 764.8 Sekunden. Das Herunterladen der 24.7 GB dauerte etwa 44 Sekunden und das Laden etwa 7. Die übrigen 705 Sekunden gingen ins Bauen von llama.cpp für die GPU auf den 9 Prozessorkernen der Maschine. Eine zweite Kopie des Modells auf derselben Maschine, mit bereits gebautem llama.cpp, war nach 15.6 Sekunden gestartet.
Was es geantwortet hat
Das sind unsere eigenen Fragen, insgesamt etwa 50 Anfragen, die meisten nur einmal gestellt, mit Bildern, die wir selbst gezeichnet haben. Sie zeigen Verhalten, keine Benchmark-Qualität.
- Ein Lagerroboter und sein Akku: 14 Meter und 28% Akku, richtig in allen 4 Läufen.
- Eine kleine Programmieraufgabe (überlappende Intervalle zusammenführen): korrekter Code, mit drei Tests, die es selbst geschrieben hat.
- Eine Zusammenfassung in zwei Sätzen auf Spanisch: korrekt und natürlich.
- Ein Café-Kassenbon in einem Bild: jeder Preis und die Summe von 15.20 richtig in allen 5 Läufen. In 3 davon schrieb es den Posten „Tostada tomate“ als „Tostada tomato“.
- Ein Balkendiagramm: alle fünf Werte richtig gelesen und die Summe von 270 korrekt.
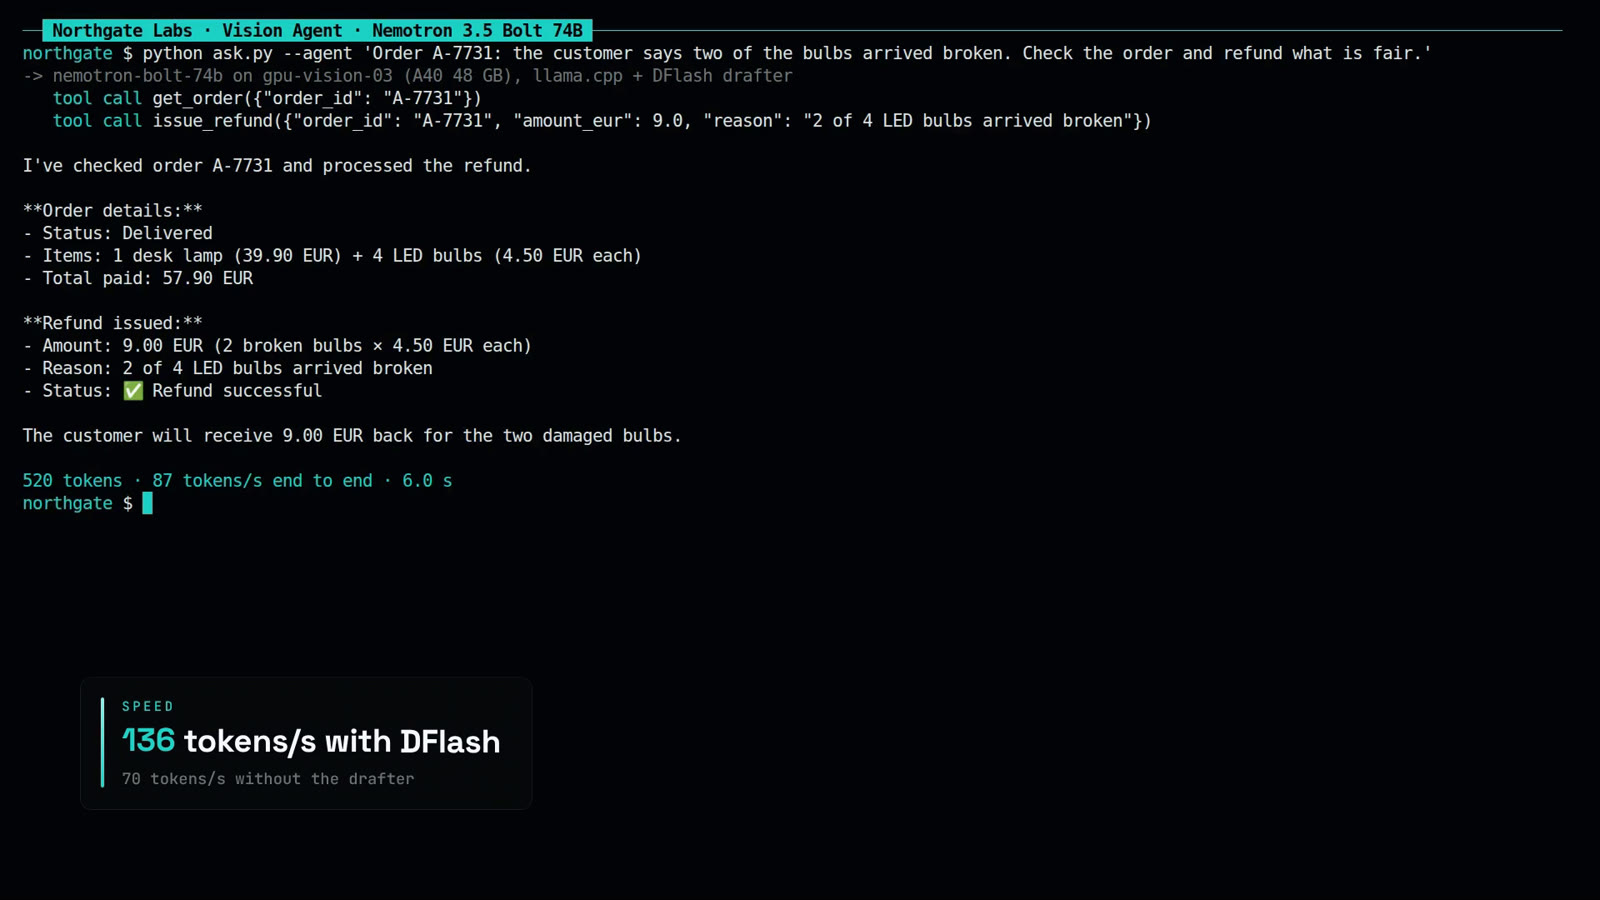
- Der Erstattungsagent: Zwei der vier Glühbirnen einer Bestellung kamen kaputt an, und das Modell hatte ein Werkzeug, um die Bestellung nachzuschlagen, und eines, um eine Erstattung auszulösen. In allen 5 Läufen rief es das Bestellwerkzeug auf, erstattete dann 9 Euro für die zwei Birnen zu je 4.50 und erstattete nie die Lampe zu 39.90 Euro aus derselben Bestellung. Die Werkzeugaufrufe kamen jedes Mal im Standardformat von OpenAI.
- Der versteckte Code bei etwa 25,000 und 71,000 Tokens: beide Male gefunden.
Keine Antwort lief in eine Schleife, kam leer zurück oder wurde abgeschnitten.
Der Demo-Lauf
In unserem aufgezeichneten Demo-Lauf zeigte das Terminal 87 Tokens pro Sekunde für den Erstattungsagenten (520 Tokens in 6.0 s). Diese Zahl ist Ende zu Ende gemessen: Sie zählt das verborgene Nachdenken des Modells und den Weg durch die Plattform mit, deshalb liegt sie unter dem Schreibtempo oben.
Was schiefging
Die meisten Probleme lagen bei den gemieteten Maschinen und in unserer eigenen Plattform, nicht beim Modell. Die eine Eigenheit des Modells, die erwähnenswert ist, ist, wie viel es nachdenkt, bevor es antwortet (letzter Punkt unten).
- Zwei defekte GPUs, als gesund gemeldet. Beide RTX-5090-Maschinen landeten auf demselben Host. Die Karte tauchte auf, aber kein Programm konnte sie tatsächlich nutzen. InferenceKey markierte trotzdem beide Worker als online und das Modell als bereit, weil nichts in der Plattform prüft, ob die GPU wirklich funktioniert. Wir haben sie nach 5 und 1 Minute gelöscht. Deshalb haben wir keine Zahlen für 32 GB.
- Das llama.cpp unseres Workers ist für dieses Modell zu alt, und du kannst es nicht über die Plattform ändern. Die Version lässt sich nur am Worker selbst setzen, und InferenceKey kann einem Worker auf einer gemieteten Maschine keine zusätzlichen Einstellungen mitgeben. Wir haben uns auf der Maschine angemeldet, sie von Hand hinzugefügt und den Worker neu gestartet.
- Fast der ganze erste Start ist das Bauen der Software. Standardmäßig baut unser Worker llama.cpp mit einem Job nach dem anderen, und das müssen wir beheben. Selbst mit 12 parallelen Jobs, die wir von Hand gesetzt haben, dauerte der Build auf den 9 Kernen der A40-Maschine 705 Sekunden, 92% der Wartezeit. Derselbe Build auf einer Maschine mit 31 Kernen dauerte 2 Minuten 41 Sekunden.
- Verborgenes Nachdenken, das Zeit kostet, die du nicht siehst. Das Modell denkt nach, bevor es antwortet. Kommt die Antwort in einem Stück zurück, wirft InferenceKey diesen Denktext weg, zählt ihn aber trotzdem: Die Ein-Satz-Antwort zum Roboter kostete 374 Tokens Schreibzeit. Den Schalter auf NVIDIAs Modellseite, mit dem man das Nachdenken abschaltet, reicht InferenceKey nicht durch, also konnten wir es nicht abschalten.
- Keine Tempoangaben in der Antwort. llama.cpp meldet seine eigenen Zeiten, und InferenceKey gibt sie nicht weiter. Unsere Tempozahlen stammen aus dem Serverlog auf der Maschine.
- Eine Drafter-Einstellung pro Modell. Diese llama.cpp-Version kann den Drafter nicht pro Anfrage ein- oder ausschalten, also brauchte der Vergleich eine zweite Kopie des Modells. Schnell, mit 15.6 Sekunden zum Starten, aber umständlich.
- Kleinigkeiten: Das Dashboard zeigte „No access“ für einen Key, der funktionierte, und RunPod hatte in seinem Community-Pool keine A40 mehr.
Wer was gemacht hat
NVIDIA hat den schweren Teil erledigt: Es hat das Elternmodell trainiert, es zu Bolt komprimiert, die komprimierte Version trainiert, den LiLiCorr-Drafter gebaut, die llama.cpp-Dateien mit fertigen Rezepten veröffentlicht, einen ausführlichen technischen Bericht geschrieben und alles unter einer offenen Lizenz freigegeben, die kommerzielle Nutzung erlaubt. Kartik Gulia von NVIDIA hat die Bolt-Unterstützung für llama.cpp in #30520 geschrieben, und ggerganov hat sie am Tag der Veröffentlichung in llama.cpp übernommen, und nur deshalb kann llama.cpp es überhaupt laden. AI Search hat das Elternmodell in seinem News-Video vorgestellt, und die Veröffentlichung tauchte auch auf r/LocalLLaMA auf.
Unser Teil war das Beispielskript, es Ende zu Ende über InferenceKey auf einer A40 laufen zu lassen und Tempo, Speicher, Startzeit und das Verhalten bei unseren eigenen Fragen zu messen.
Was bleibt
Ein 74B-Agentenmodell, das Bilder liest, lief auf einer einzigen Rechenzentrumskarte mit 48 GB und belegte etwas mehr als die Hälfte davon. Für einen Nutzer schrieb es 136 Tokens pro Sekunde, ein Teil davon verborgenes Nachdenken. Bei unserer einen Erstattungsaufgabe rief es die Werkzeuge korrekt auf. Der Drafter macht es schnell: Ohne ihn halbiert sich das Tempo. Diesen Gewinn haben wir mit einer Anfrage nach der anderen gemessen. Drafter bringen oft weniger, wenn sich mehrere Anfragen die Karte teilen, und das haben wir nicht getestet.
Ganz einfach gesagt: Eine 48-GB-Karte, etwas mehr als halb voll, hat dieses Agentenmodell etwa doppelt so schnell laufen lassen wie ohne den Drafter. Mit unseren Einstellungen bedient es eine Person nach der anderen, also können wir nicht sagen, wie es sich für ein ganzes Team schlägt.
Die Grenzen sind klar. Die Qualitätszahlen sind NVIDIAs eigene, und unsere Prüfungen waren etwa 50 Anfragen von uns selbst. Und in NVIDIAs eigener Tempotabelle schreiben kleinere Modelle wie Qwen3.6-35B-A3B schneller, du wählst Bolt also wegen seiner Agentenwerte, nicht wegen des Tempos.
Die Antwort ist also ja auf einer 48-GB-Karte. Auf einer 32-GB-Karte, der Größe, die NVIDIAs kleineres Setup nennt, ist sie noch offen: Wir haben es auf keiner laufen lassen. Mit den 27 GB, die wir gemessen haben, sollten dort etwa 5 GB frei bleiben. Die nächste Messung, die wir schulden, ist, wie schnell es auf einer RTX 5090 läuft, einer neueren 32-GB-Karte als die A40.
Für Engineers
Modell (Card, GGUF, Drafter, Forschungsseite, technischer Bericht). Veröffentlicht 2026-10-15. Datenstand Mai 2026. 74B gesamt, 9B aktiv, Mamba-2/Transformer-Hybrid LatentMoE, Vision-Encoder C-RADIO v4-H. Eingabe Text, Bilder, Video (mp4 bis 2 min). Ausgabe Text. Kontext bis 256K. 40 Mamba-, 40 MoE-, 8 Attention-Layer, Hidden 4096 (vom Elternmodell übernommen). Star Elastic: Ein budgetkonditionierter Router wählt pro Layer die Zahl der gerouteten Experten und die MoE-Intermediate-Breite, gemeinsam trainiert mit KL-Distillation vom eingefrorenen Elternmodell. Geroutete Experten 512 auf 240-496 pro Layer, Intermediate-Breite 2688 auf 1536-2560, Top-k 22 auf 9. Ziel unter 24 GB bei Batch 1, 128K Kontext. Kompressionstraining 72B Tokens bei 8K plus 48B bei 128K, 32 GB200-Nodes (128 GPUs), etwa 64 h. Mittel über neun Benchmarks 57.58 auf 54.74 (-2.85, -4.94% relativ) vor dem Post-Training. Post-Training: Neutraining des Vision-Adapters, bildlastiges SFT, SLERP-Merges (80:20, 75:25), MCP-Atlas RL, RLHF, SWE-RL. Sprachen: primär Englisch und Code, außerdem Spanisch, Französisch, Deutsch, Italienisch, Japanisch. Tool Calling. Thinking umschaltbar mit chat_template_kwargs.enable_thinking. Sampling Temperature 1.0, top_p 0.95. Elternmodell Super VL: BF16 auf 4x H100 (TP4) oder 2x GB200 (TP2), separates NVFP4-Release.
Quantisierung. Nur Gewichte. Geroutete und geteilte Experten IQ2_XXS (2.0625 bpw), Mamba-In/Out-Projektionen NVFP4, Attention, Latent MoE, Embedding und LM Head Q8_0. QAD: 26B Tokens, LR 1e-5 mit 1.2B Tokens Warmup, Cosinus auf 1e-7 über 25B. Zweite QAD-Stufe mit 10M Tokens und neuerem Teacher. 148 GB BF16 auf 22.1 GB (-85.1%). NVIDIA-Budget (Tabelle 2, Batch 1, 131,072 Kontext): Gewichte 22.01 GB (geroutete Experten 17.05), Laufzeit 0.87 (KV FP8 0.54, Mamba SSM 0.08, Aktivierungen 0.25) = 22.87, plus Drafter 0.96 = 23.83 GB. Vision-Encoder und Projektor 1.68 GB BF16 nicht eingerechnet (Ziel nur Text).
Dateien. GGUF-Repo sha e0fecb69: NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf 22,018,326,528 B, mmproj 1,733,692,736 B. Drafter-Repo sha 182d2987: 998,242,560 B. Insgesamt 24.75 GB, nicht gated. Drafter: 1.13B Parameter ohne geteilte Embeddings und LM Head (LiLiCorr-Head 37M), fünf Layer, Block von 8 Positionen (7 Draft-Slots), Sliding Window von 1,024 Tokens, Attention Sinks, GGUF-Arch dflash. llama.cpp führt ihn über seinen spekulativen DFlash-Modus aus (--spec-type draft-dflash). LiLiCorr bewertet die Top-K-Kandidaten über den ganzen Draft gemeinsam in einem Durchgang und verbessert damit DFlashs unabhängige Token-Auswahl und DSparks sequenzielle Korrektur (arXiv 2608.20530). NVIDIA-Akzeptanz (vLLM, Draft-Länge 7, Concurrency 64, SPEED-Bench 880 Prompts): mittlere Akzeptanzlänge 4.681 (temp 0) / 4.248 (temp 1) NVFP4-Drafter, 4.736 / 4.288 BF16. Coding 5.18-5.74, Writing 3.36-3.73. Geschätzte AL in AA AgentPerf Local: LiLiCorr 4.18, DSpark 3.68.
Rezepte (GGUF-Card). „RTX Spark 64GB or RTX discrete GPU 32GB+“: 28GB-Rezept, 65,536 Kontext, 1 Sequenz, bis zu 6 Drafts, q8_0 KV. „RTX Spark 128GB or RTX discrete GPU 48GB+“: 32GB-Rezept, 262,144 Kontext, 1 Sequenz, bis zu 7 Drafts, Batch/Ubatch 4096/2048, keine KV-Quantisierung. Schnellstart: Tuning-Flags des 28GB-Rezepts mit --ctx-size 98304, lädt lokale Dateien mit --model, --mmproj und --spec-draft-model nach hf download. Wir haben dieselben Tuning-Flags stattdessen mit -hf, --hf-file und --spec-draft-hf laufen lassen (-hf holt das mmproj). Gemeinsame Flags -ngl 999 --spec-type draft-dflash --spec-draft-ngl 999 --temp 1.0 --top-p 0.95 --flash-attn on --jinja. Build für diskrete GPU: cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON, dann cmake --build build --config Release -j. Die Card nennt Ada Lovelace und Blackwell. Unser Lauf auf Ampere sm_86 hat funktioniert. vLLM: vllm/vllm-openai:nightly-77154ca6116ae34cbfe314beef1016bde9b63989, TP 1, max len 262144, max seqs 1, 7 spekulative Tokens, pip install b12x, vllm download-kernels, VLLM_USE_V2_MODEL_RUNNER=1, --enable-auto-tool-choice --tool-call-parser qwen3_coder. Hardware in der Zusammenfassung als A100/H100/Blackwell angegeben, unter Software Integration als Blackwell SM120/SM121. Von uns nicht getestet.
llama.cpp. PR #30520 „Add Nemotron Super 3.5 VL and Nemotron Bolt 74B A9B support“, eröffnet von frozenblade1224 (Kartik Gulia, NVIDIA), gemergt von ggerganov 2026-10-15T13:34:57Z (cd0a5b6a). Tag v0.7.0 (620d2225) ist einen Commit später. Der Standard-Tag unseres Workers, b9748, liegt 1,920 Commits hinter dem Merge. speculative.n_max pro Anfrage ist in v0.7.0 herauskompiliert.
Benchmarks (Technical Report, Tabelle 7, selbst gemeldet). Bolt IQ2 / Qwen3.6-35B-A3B BF16 / Gemma4 26B-A4B / Nemotron 3.5 Lightning 30B-A3B: Terminal-Bench 2.1 50.98 / 44.38 / 37.22 / 23.46, BrowseComp 66.75 / 48.74 / 26.30 / 36.81, GPQA Diamond 86.43 / 83.40 / 79.61 / 75.57, GDPVal-AA-V2 28.47 / 25.75 / 15.33 / 18.26, HLE (ohne Werkzeuge) 25.30 / 19.56 / 17.42 / 10.47, SciCode 41.02 / 35.33 / 40.28 / 31.38, AA-LCR 64.06 / 61.06 / 57.56 / 49.19, Tau3 Banking 17.01 / 10.52 / 14.02 / 9.48, WebArena (Vision) 50.86 / 36.60 / 38.2 / -, MCP-Atlas 52.20 / 51.2 (Qwen meldet selbst 62.8) / - / 46.4, PinchBench 87.82 / 88.07 / 74.70 / 83.43, AA-Omniscience-Genauigkeit 16.90 / 19.47 / 22.17 / 16.63, AA-Omniscience Non-Hallucination 61.27 / 65.85 / 14.22 / 68.81, IFBench 66.17 / 63.71 / 77.25 / 72.88. Elternmodell Super VL BF16: TB2.1 61.94, BrowseComp 71.50, GPQA 90.78. Bolt BF16 53.93 / 70.00 / 88.83. NVIDIA-Tempo (Tabelle 8, llama.cpp, Windows 11 ARM, RTX Spark Surface Laptop Ultra 128 GB): Bolt IQ2_XXS + LiLiCorr 83.99 TPS SPEED-Bench-Coding, 600.80 s AA AgentPerf Local, Qwen3.6 35B-A3B UD-Q4_K_M + MTP 96.63 / 453.97 s, Gemma 4 26B-A4B UD-Q4_K_M + MTP 100.56 / 480.68 s, Qwen3.8 27B UD-Q4_K_M + DFlash 28.26 / 1043.28 s.
Unser Setup. RunPod A40 48 GB Secure Cloud, 46,068 MiB (48.3 GB), Treiber 595.91.07, Compute 8.6, 9 vCPUs, Image runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404 (nvcc 12.8). Worker von einem lokalen InferenceKey-Manager über HTTP- und TCP-Tunnel gebootstrappt. Produktion nie angefasst. Von Hand ergänzte Worker-Env: INFERENCEKEY_LLAMACPP_TAG=v0.7.0, CMAKE_BUILD_PARALLEL_LEVEL=12, INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000, CUDACXX=/usr/local/cuda/bin/nvcc, /usr/local/cuda/bin im PATH (nicht geprüft, ob cmake nvcc ohne die letzten beiden findet). Etwa 6 Minuten gingen an die zwei fehlerhaften RTX-5090-Community-Pods vor der A40 (22.1 Minuten). SDK-Beispiel Commit 0c61916b auf inferencekey-sdk main. Der Kern davon:
spec = WorkloadSpec(
    name="Nemotron 3.5 Bolt 74B-A9B (llama.cpp, DFlash)",
    slug="nemotron-bolt-74b",
    model="nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF",
    backend=Backend.LLAMACPP,
    command=COMMAND,  # the llama-server line above
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=3600)
Zeit bis bereit. ensure() bis bereit 764.8 s: Klonen und Bauen von v0.7.0 für sm_86 mit 12 Jobs, 704.7 s (92%). Download etwa 44 s (etwa 560 MB/s). Laden etwa 7 s. Zweiter Workload (ohne Drafter, gecachter Build) 15.6 s. Derselbe Build auf dem 5090-Pod (31 vCPUs, 32 Jobs): 2 min 41 s.
Speicher und Leistung. llama-server 25,816 MiB (27.1 GB, 25.2 GiB) mit Drafter (Spitze der Karte 25,825 von 46,068 MiB), 23,516 MiB (24.7 GB) ohne. Zahlen im Fließtext sind dezimale GB, wie die Dateigrößen. Spitzenleistung 303.4 W.
Pro Anfrage (nicht streamendes /v1/chat/completions, eine nach der anderen, Decode aus print_timing von llama-server):
| Fall | Out-Tok DFlash | tok/s DFlash | Akzeptanz | Round Trip s | Out-Tok ohne Draft | tok/s ohne Draft | Round Trip s |
|---|---|---|---|---|---|---|---|
| Roboter-Rechnung | 374 | 130.98 | 0.620 | 3.85 | 458 | 69.87 | 7.05 |
| merge_intervals | 642 | 153.62 | 0.754 | 4.94 | 602 | 70.14 | 9.36 |
| Code (2. Sample) | 1,095 | 136.49 | 0.647 | 8.62 | 891 | 70.38 | 13.34 |
| Spanische Zusammenfassung | 414 | 118.84 | 0.545 | 4.27 | 333 | 70.27 | 5.51 |
| Kassenbon-Bild (796 Prompt-Tok) | 394 | 155.52 | 0.783 | 3.42 | 361 | 70.32 | 6.95 |
| Balkendiagramm-Bild (1,078 Prompt-Tok) | 930 | 161.37 | 0.813 | 7.89 | 425 | 70.35 | 7.86 |
| Tool-Loop, 3 Turns | 101 / 308 / 197 | 131.6 / 140.1 / 128.5 | 0.67 / 0.69 / 0.61 | 6.61 | 85 / 318 / 166 | 70.8 / 70.4 / 70.3 | 10.23 |
| Needle, 24,944 Prompt-Tok | 101 | 131.16 | 0.667 | 21.48 | 102 | 63.39 | 17.52 |
| Needle, 70,773 Prompt-Tok | 98 | 110.46 | 0.568 | 60.56 | nicht gelaufen |
Decode-Median 136.5 tok/s über 25 Anfragen mit Drafter (110.5 bis 161.9, Ausgaben ab 200 Tokens 146.5) gegen 70.3 über 9 ohne (63.4 bei 25K, sonst 69.9 bis 70.8): etwa 1.9x (1.7x bis 2.3x pro Prompt). Decode zählt Reasoning-Tokens mit. Akzeptanz 69.7% (6,509 von 9,336), Median der mittleren akzeptierten Länge 5.0 von 6. Prefill bei 24,944 Tokens 1,265 tok/s mit Drafter, 1,667 ohne. Bei 70,773 Tokens 1,216 tok/s (58.2 s). SDK-Beispiel: Reasoning-Antwort 3.9 s (265 Tokens), Kassenbon 4.4 s, Loop mit zwei Werkzeugen 7.0 s. Demo: Kassenbon 429 Tokens in 3.8 s. Erstattungsagent 520 Tokens in 6.0 s (87 tok/s Ende zu Ende, Reasoning eingeschlossen). Überall finish_reason: stop.
Plattformprobleme. (1) Zwei RTX-5090-Community-Pods auf einem Host: nvidia-smi funktionierte, ggml_cuda_init: failed to initialize CUDA: unknown error, torch.cuda.is_available() False. Der Manager markierte den Worker als online und das Deployment als bereit. (2) Das gepinnte llama.cpp b9748 kann das Modell nicht laden. Der RunPod-Bootstrap schreibt ein festes Env-Manifest ohne Feld für zusätzliche Env. (3) cmake --build läuft ohne -j, der Build ist also seriell, solange CMAKE_BUILD_PARALLEL_LEVEL nicht gesetzt ist. (4) Nicht streamende Antworten verwerfen reasoning_content, zählen es aber in completion_tokens. chat_template_kwargs wird nicht weitergereicht (Roboter 374 gegen 328 Tokens mit enable_thinking: false). Streaming nicht getestet. (5) timings von llama-server werden nicht durchgereicht. (6) Steuerung des Drafters pro Anfrage herauskompiliert, daher ein zweiter Workload. (7) A40 in der Community Cloud 409 ausverkauft, daher Secure Cloud. (8) Ein entfernter Neustart von bootstrap-worker.sh wurde einmal von seinem eigenen pkill -f-Guard beendet. Aus seinem Verzeichnis neu gestartet. (9) Das Panel zeigt bei Access „No access“ mit einem funktionierenden Wildcard-Key.
Aufräumen. Beide Workloads und alle drei Pods gelöscht (Manager 204, RunPod 404, leere Pod-Liste), lokaler Stack, Tunnel, NATS, Datenbank und MinIO-Bucket entfernt.
Grenzen. Ein GPU-Modell (Ampere A40, 48 GB), keine 32-GB-Karte, eine Anfrage nach der anderen (--parallel 1, Concurrency nicht getestet), etwa 50 Anfragen mit eigenen Prompts und synthetischen Bildern, meist ein Sample pro Fall, Temperature 1.0. Alle Benchmark- und Tempovergleiche mit anderen Modellen sind von NVIDIA. vLLM-Weg nicht getestet. Thinking ließ sich über unseren Endpoint nicht abschalten.
Quellen: Model Card, GGUF-Card, LiLiCorr-Drafter, Forschungsseite, technischer Bericht, Nemotron 3.5 Super VL, OpenMDW-1.1, llama.cpp #30520, SDK-Beispiel, Video von AI Search, r/LocalLLaMA.