Nemotron 3.5 Bolt: un modelo agente de 74B en una sola GPU, y qué significan los 24 GB
NVIDIA ha metido un modelo agente de 74B con visión en 22 GB de pesos casi todos a 2 bits. En una A40 escribió 136 tokens/s con su borrador y 70 sin él.
¿Puede una sola tarjeta gráfica alquilada mover un modelo agente de 74B que lee imágenes? NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB, publicado el 15 de octubre, es un modelo de 74B parámetros que lee texto e imágenes y funciona como agente: llama a herramientas para sacar el trabajo adelante. Su fichero ocupa 22,0 GB. Lo servimos en una NVIDIA A40 alquilada, una tarjeta gráfica (GPU) de centro de datos con 48 GB, con la lectura de imágenes activada y también su modelo borrador (drafter), un modelo pequeño de apoyo que acelera la escritura.
El "24GB" del nombre es el presupuesto de NVIDIA solo para texto: el modelo, sitio para unos 128.000 tokens de conversación (un token es un trozo de palabra) para un usuario, y el borrador. Todo suma 23,83 GB. Nuestra prueba usó unos 27 GB (25,2 GiB), pero no es una comparación en igualdad de condiciones: incluye el lector de imágenes, que el presupuesto de NVIDIA deja fuera. Las configuraciones de la propia NVIDIA para llama.cpp, el programa gratuito que usa casi todo el mundo para ejecutar modelos así en una sola máquina, empiezan en tarjetas de 32 GB.
Lo que queríamos saber es si un modelo agente de 74B funciona de verdad en una sola tarjeta que un equipo pequeño pueda alquilar o comprar, y a qué velocidad. En una tarjeta de centro de datos de 48 GB, sí. En una tarjeta de consumo de 32 GB, el tamaño que indica la configuración pequeña de NVIDIA, todavía no está demostrado: las dos que alquilamos estaban rotas.
| Qué | Resultado |
|---|---|
| Modelo | Nemotron 3.5 Bolt 74B-A9B 24GB de NVIDIA, publicado el 15 de octubre: 74B parámetros (los valores que un modelo aprende al entrenarse), 9B de ellos trabajando en cada palabra; lee texto, imágenes y vídeos cortos, escribe texto y llama a herramientas |
| De dónde sale | una versión adelgazada del Nemotron 3.5 Super VL de 120B de NVIDIA, comprimida después a fondo para que el fichero sea un 85% más pequeño |
| Descarga | modelo de 22,0 GB, lector de imágenes de 1,73 GB, borrador de 1,0 GB |
| GPU que usamos | una NVIDIA A40 con 48 GB, alquilada en RunPod (una tarjeta de centro de datos de generación anterior) |
| Memoria usada al servir | unos 27 GB de los 48 de la tarjeta, algo más de la mitad, con lectura de imágenes, el borrador y sitio para 98.304 tokens de conversación |
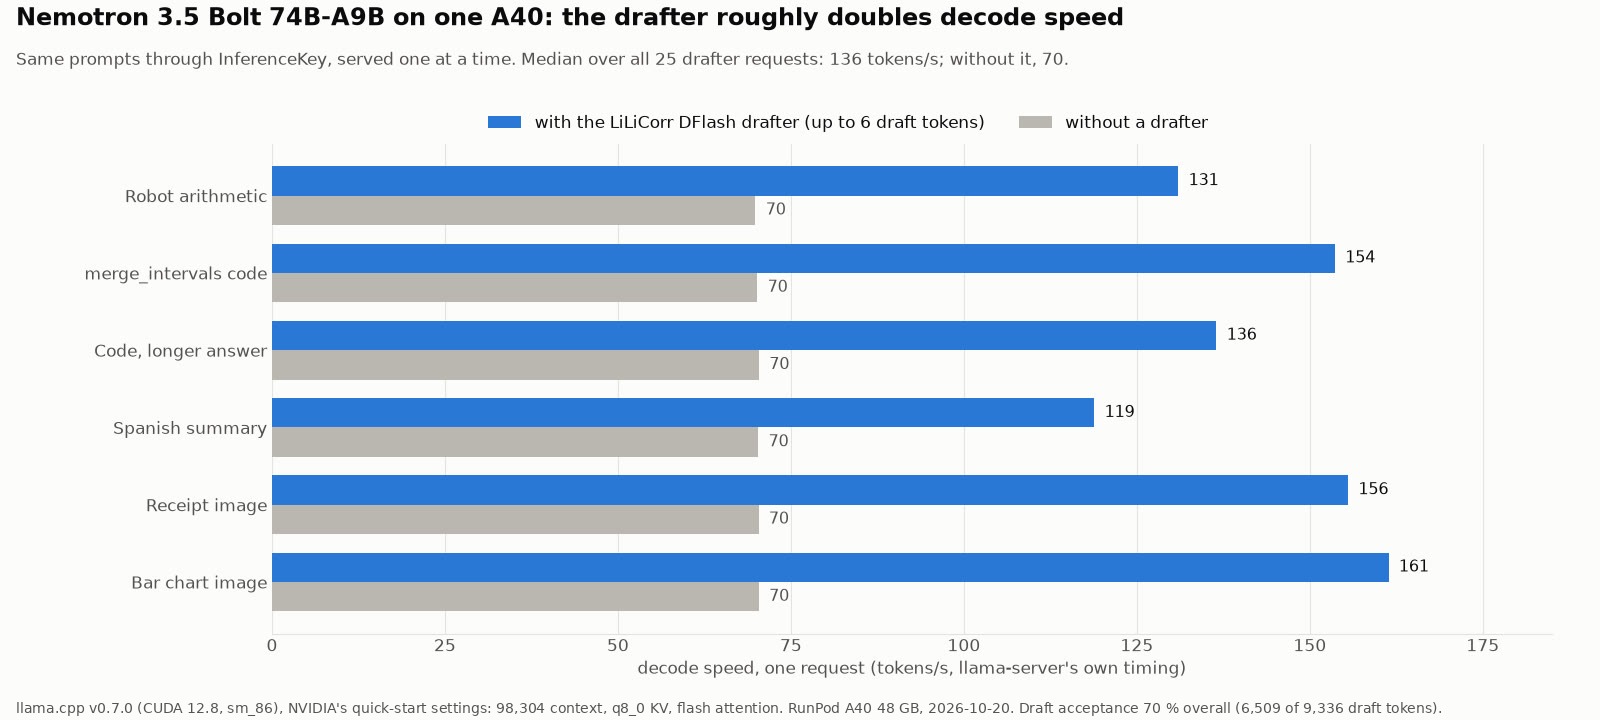
| Velocidad de escritura para un usuario | 136 tokens por segundo con el borrador, 70 sin él |
| Calidad, en las pruebas de la propia NVIDIA | por delante de Qwen3.6-35B-A3B en la mayoría de las pruebas de agentes que publica NVIDIA (Terminal-Bench 2.1: 51,0 frente a 44,4), por detrás por muy poco en una, y por detrás en conocimiento de datos |
| Licencia | OpenMDW-1.1, permite uso comercial |
| La pega | necesita una versión de llama.cpp (el programa gratuito que lo ejecuta) del 15 de octubre o posterior, y la que instala por defecto nuestra plataforma es más antigua |
Un equipo de especialistas más pequeño
Bolt es el pequeño de una familia. Su padre, Nemotron 3.5 Super VL, tiene 120B parámetros. Sin comprimir, necesita cuatro de las GPU grandes de centro de datos de NVIDIA (H100), o dos de las más nuevas (GB200). Vimos la familia en el vídeo de noticias de AI Search del 18 de octubre, que habla del padre y dice que sigue siendo "still quite huge".
Los dos son lo que se llama una mezcla de expertos (mixture of experts). Imagina un equipo grande de especialistas. Para cada palabra se elige a unos pocos para hacer el trabajo, y el resto espera. Por eso el nombre dice A9B: de los 74B parámetros, unos 9B trabajan en cada palabra, y eso lo mantiene rápido.
NVIDIA construyó Bolt reduciendo el equipo del padre. Un método de entrenamiento aprendió cuántos especialistas conservar en cada parte del modelo y qué tamaño debía tener cada uno, con el padre corrigiendo sus respuestas por el camino (el informe técnico tiene los detalles). Cada parte pasó de 512 especialistas a entre 240 y 496, y ahora cada palabra consulta a 9 en vez de a 22. El objetivo era quedarse por debajo de 24 GB. Ese entrenamiento corrió en 128 GPU de centro de datos de NVIDIA durante unas 64 horas.
Adelgazar costó en torno a un 5% de la puntuación: en la media de nueve pruebas, el padre sacó 57,58 y el modelo reducido 54,74, antes del entrenamiento extra que NVIDIA hizo después con imágenes, tareas de agente y programación.
Comprimido a fondo, a propósito
Incluso reducido, Bolt sin comprimir ocupa 148 GB. NVIDIA lo distribuye muy comprimido, como una foto guardada con mucha menos calidad, y se queda en 22,1 GB, un 85% menos. Los especialistas, que son la mayor parte del modelo, son lo que más se comprime. Las partes pequeñas por las que pasa cada palabra conservan más detalle.
Comprimir tanto un modelo suele costarle mucha precisión. NVIDIA siguió entrenando Bolt después de comprimirlo, con la versión sin comprimir corrigiendo sus respuestas. Parte de la pérdida se queda: en Terminal-Bench 2.1, una prueba de trabajo de agente en un terminal, Bolt saca 53,93 sin comprimir y 50,98 tal como se descarga.
24 GB sobre el papel, solo para texto
Según las cuentas de la propia NVIDIA, la versión solo texto entra en 24 GB, con 23,83 GB usados. Cuánto margen deja depende de la unidad: una tarjeta de consumo de 24 GB tiene 24 GiB, así que si la cifra de NVIDIA está en GB decimales sobran unos 1,9 GB, y si está en GiB, unos 0,2. NVIDIA calcula 0,96 GB para el borrador, y en nuestra prueba costó unos 2,4 GB. Así que si Bolt entra en una tarjeta real de 24 GB sigue siendo una pregunta abierta. No lo probamos en una.
El lector de imágenes añade 1,68 GB, lo que deja poco o ningún margen incluso sobre el papel. Las configuraciones de NVIDIA para llama.cpp, que cargan el lector de imágenes, empiezan en tarjetas de 32 GB.
La página del modelo de NVIDIA ofrece dos configuraciones de llama.cpp. La pequeña es para tarjetas gráficas de 32 GB o más y admite 65.536 tokens de conversación. La grande es para 48 GB o más y admite 262.144. El comando de inicio rápido de esa misma página se queda en medio, con 98.304 tokens, y es el que ejecutamos.
Un ayudante rápido que adivina por delante
Un modelo normalmente escribe un token detrás de otro. NVIDIA distribuye con Bolt un segundo modelo mucho más pequeño, el borrador LiLiCorr, de unos 1,1B parámetros en un fichero de 1,0 GB. El borrador adivina los siguientes tokens, y Bolt los comprueba todos de una pasada, se queda con ellos hasta el primero en el que no está de acuerdo y ese lo escribe él. Cuando las apuestas son buenas, salen varios tokens por el precio de una comprobación.
El borrador adivina un bloque entero de palabras de una vez y comprueba que encajan entre sí, así que se aprovechan más. En las pruebas de NVIDIA, cada comprobación hizo avanzar la respuesta unos 4 o 5 tokens, más en código y menos en prosa.
Qué puntuación saca, según las cifras de NVIDIA
Todas las cifras de este apartado salen de la página del modelo y del informe de NVIDIA. No las hemos repetido. Frente a Qwen3.6-35B-A3B, un modelo abierto más pequeño con el que lo compara NVIDIA:
| Prueba (qué mide) | Bolt, tal como se descarga | Qwen3.6-35B-A3B |
|---|---|---|
| Terminal-Bench 2.1 (trabajo de agente en un terminal) | 50,98 | 44,38 |
| BrowseComp (encontrar datos navegando) | 66,75 | 48,74 |
| GPQA Diamond (ciencia de nivel de posgrado) | 86,43 | 83,40 |
| PinchBench (una prueba de agentes) | 87,82 | 88,07 |
| AA-Omniscience, precisión (recordar datos) | 16,90 | 19,47 |
| AA-Omniscience, respuestas sin inventarse cosas | 61,27 | 65,85 |
Bolt gana la mayoría de las pruebas de agentes y de razonamiento que publica NVIDIA y pierde PinchBench por un pelo. También pierde en recordar datos, donde se inventa cosas algo más a menudo. En una prueba de uso de herramientas, el propio equipo de Qwen publica una puntuación mucho más alta (62,8) que la que NVIDIA midió para él (51,2), un recordatorio de que estas cifras dependen de quién ejecute la prueba. Gemma 4 26B-A4B de Google supera a Bolt siguiendo instrucciones detalladas (IFBench, 77,25 frente a 66,17). Reducir y comprimir, juntos, le costaron a Bolt unos 11 puntos en Terminal-Bench 2.1: el padre a tamaño completo saca 61,94, y Bolt tal como se descarga, 50,98.
La propia prueba de velocidad de NVIDIA muestra que Bolt es la opción más lenta: en un portátil Surface con 128 GB de memoria escribió unos 84 tokens por segundo en trabajo de programación, frente a unos 97 de Qwen3.6 y 101 de Gemma 4. Así que cambias algo de velocidad por mejores puntuaciones como agente.
Qué necesitas para ejecutarlo
Hay dos caminos. El primero es llama.cpp, el programa gratuito y de código abierto que ejecuta modelos como este en tu propia máquina. Kartik Gulia, ingeniero de NVIDIA, escribió el código que permite a llama.cpp ejecutar Bolt y su lector de imágenes, y el mantenedor de llama.cpp, ggerganov, lo aceptó el 15 de octubre (pull request #30520). Cualquier versión anterior no puede cargar el fichero.
El segundo es vLLM, software de servidor pensado para centros de datos. De momento necesita una versión de prueba concreta de vLLM, indicada en la página del modelo de NVIDIA. La página no es coherente sobre qué generaciones de GPU de NVIDIA soporta: tres en un sitio, solo la más nueva en otro. Este camino no lo probamos.
La licencia es OpenMDW-1.1. Permite usarlo, modificarlo y redistribuirlo con cualquier fin, no pone límites a lo que hagas con lo que genera y pide que conserves la licencia y los avisos cuando pases el modelo a otros. La página del modelo de NVIDIA dice que está listo para uso comercial.
Ejecutarlo en InferenceKey
La GPU y el software
Lo ejecutamos en una NVIDIA A40 con 48 GB, alquilada en RunPod. Primero queríamos una tarjeta de 32 GB, el tamaño que indica la configuración pequeña de NVIDIA, y nos tocaron dos máquinas con RTX 5090. Las dos resultaron tener la GPU rota (más abajo lo contamos), así que la A40 fue el plan B. Es de una generación de GPU anterior a las que lista la página de llama.cpp de NVIDIA, y funcionó igualmente.
Usamos el soporte de llama.cpp que trae InferenceKey, sin código a medida en la plataforma. Compila llama.cpp en la máquina con GPU y ejecuta un único comando que descarga el modelo, el lector de imágenes y el borrador. Elegimos llama.cpp porque los ficheros y las recetas oficiales de NVIDIA son para él. Nuestro comando usa los ajustes del inicio rápido, pero baja los ficheros directamente de Hugging Face, la web donde NVIDIA los publica, en vez de descargarlos antes.
Eso sí, no funcionó a la primera. El worker, el pequeño programa que InferenceKey pone en cada máquina con GPU, instala una versión de llama.cpp 1920 cambios más antigua que el soporte de Bolt, y la plataforma no tiene forma de cambiarlo desde fuera. Entramos en la máquina y configuramos a mano varias cosas en el worker: la versión más nueva de llama.cpp, una compilación más rápida y una espera más larga antes de rendirse, además de la ruta del compilador de CUDA, por si acaso.
Los pasos
Nuestro script de ejemplo (en el SDK de InferenceKey, la librería de Python de la plataforma) pide a InferenceKey que ejecute el modelo en tu máquina con GPU, espera a que esté listo, hace una pregunta de razonamiento, lee un tique a partir de una foto, ejecuta un agente de devoluciones con dos herramientas, guarda las respuestas y apaga el modelo. El comando que ejecuta en la GPU:
llama-server -hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  --hf-file NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --spec-draft-hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  --spec-type draft-dflash --spec-draft-n-max 6 --spec-draft-ngl 999 -ngl 999 \
  --batch-size 2048 --ubatch-size 512 --ctx-size 98304 --parallel 1 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja
Antes de ejecutarlo, el worker necesita unos ajustes añadidos en la propia máquina con GPU. El README del ejemplo lista los tres que importan: la versión de llama.cpp (v0.7.0), el número de tareas de compilación en paralelo y una espera más larga antes de que la plataforma dé por fallido el primer arranque, porque compilar llama.cpp y descargar 24,7 GB puede tardar más de lo que permite el valor por defecto. Después hablas con el modelo con el mismo formato de chat que el servicio de OpenAI, herramientas incluidas. Lo ejecutamos todo desde una copia privada de InferenceKey en nuestra máquina de desarrollo, nunca en el servicio en producción.
Lo que medimos
La respuesta del tique en 3,4 segundos en vez de 7. Con el borrador, la respuesta sobre el tique llegó en unos 3,4 segundos. Sin él, en 7. En 25 peticiones, una detrás de otra, el modelo escribió más o menos el doble de rápido con el borrador: una mediana de 136 tokens por segundo frente a 70, nunca por debajo de 110. La respuesta del gráfico de barras, 930 tokens, tardó menos de 8 segundos. Parte de lo que escribe es razonamiento oculto que nunca ves, así que la respuesta visible es más corta de lo que dice el recuento de tokens. Las apuestas del borrador se aceptaron el 70% de las veces, y la ganancia fue mayor al leer imágenes y en una de las dos tareas de programación.
Algo más de media tarjeta. Con el lector de imágenes, el borrador y sitio para 98.304 tokens, el modelo usó unos 27 GB de los 48 de la A40. Sin el borrador usó unos 2,4 GB menos.
Los documentos largos funcionan, con un arranque más lento. Escondimos un código en mitad de un documento de unos 25.000 tokens y de otro de unos 71.000 tokens. Las dos veces el modelo lo encontró exacto. Leer el documento de 71.000 tokens llevó 58 segundos. En documentos largos el borrador estorba. Con la pregunta de 25.000 tokens, el modelo respondió en 17,5 segundos sin él y en 21,5 con él, porque el borrador ralentiza la lectura en torno a una cuarta parte.
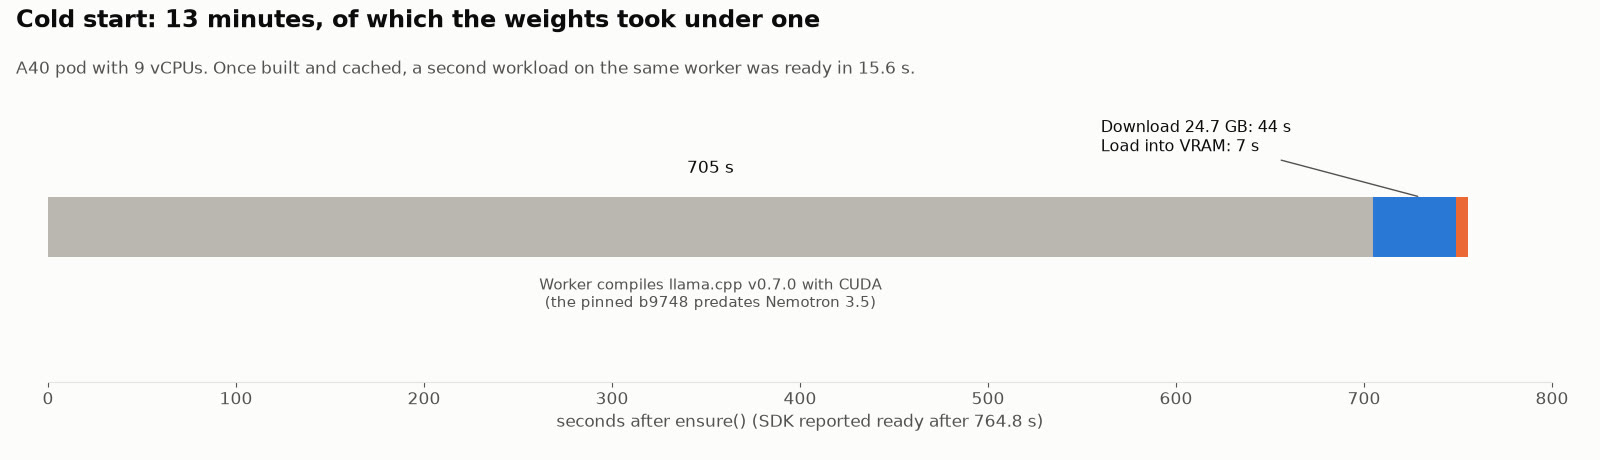
Listo en menos de 13 minutos, casi todo compilando. Desde pedir el modelo hasta "listo" pasaron 764,8 segundos en una máquina recién creada. Descargar los 24,7 GB de ficheros llevó unos 44 segundos y cargarlos unos 7. Los otros 705 segundos se fueron en compilar llama.cpp para la GPU en los 9 núcleos de procesador de la máquina. Arrancar una segunda copia del modelo en la misma máquina, con llama.cpp ya compilado, llevó 15,6 segundos.
Lo que respondió
Son preguntas nuestras, unas 50 peticiones en total, la mayoría hechas una sola vez, con imágenes que dibujamos nosotros. Muestran cómo se comporta, no su calidad en un benchmark.
- Un robot de almacén y su batería: 14 metros y 28% de batería, bien en las 4 ejecuciones.
- Una tarea de programación pequeña (fusionar intervalos que se solapan): código correcto, con tres tests escritos por él mismo.
- Un resumen de dos frases en español: correcto y natural.
- Un tique de cafetería en una foto: todos los precios y el total de 15,20 bien en las 5 ejecuciones. En 3 de ellas escribió el artículo "Tostada tomate" como "Tostada tomato".
- Un gráfico de barras: los cinco valores bien leídos y el total de 270 correcto.
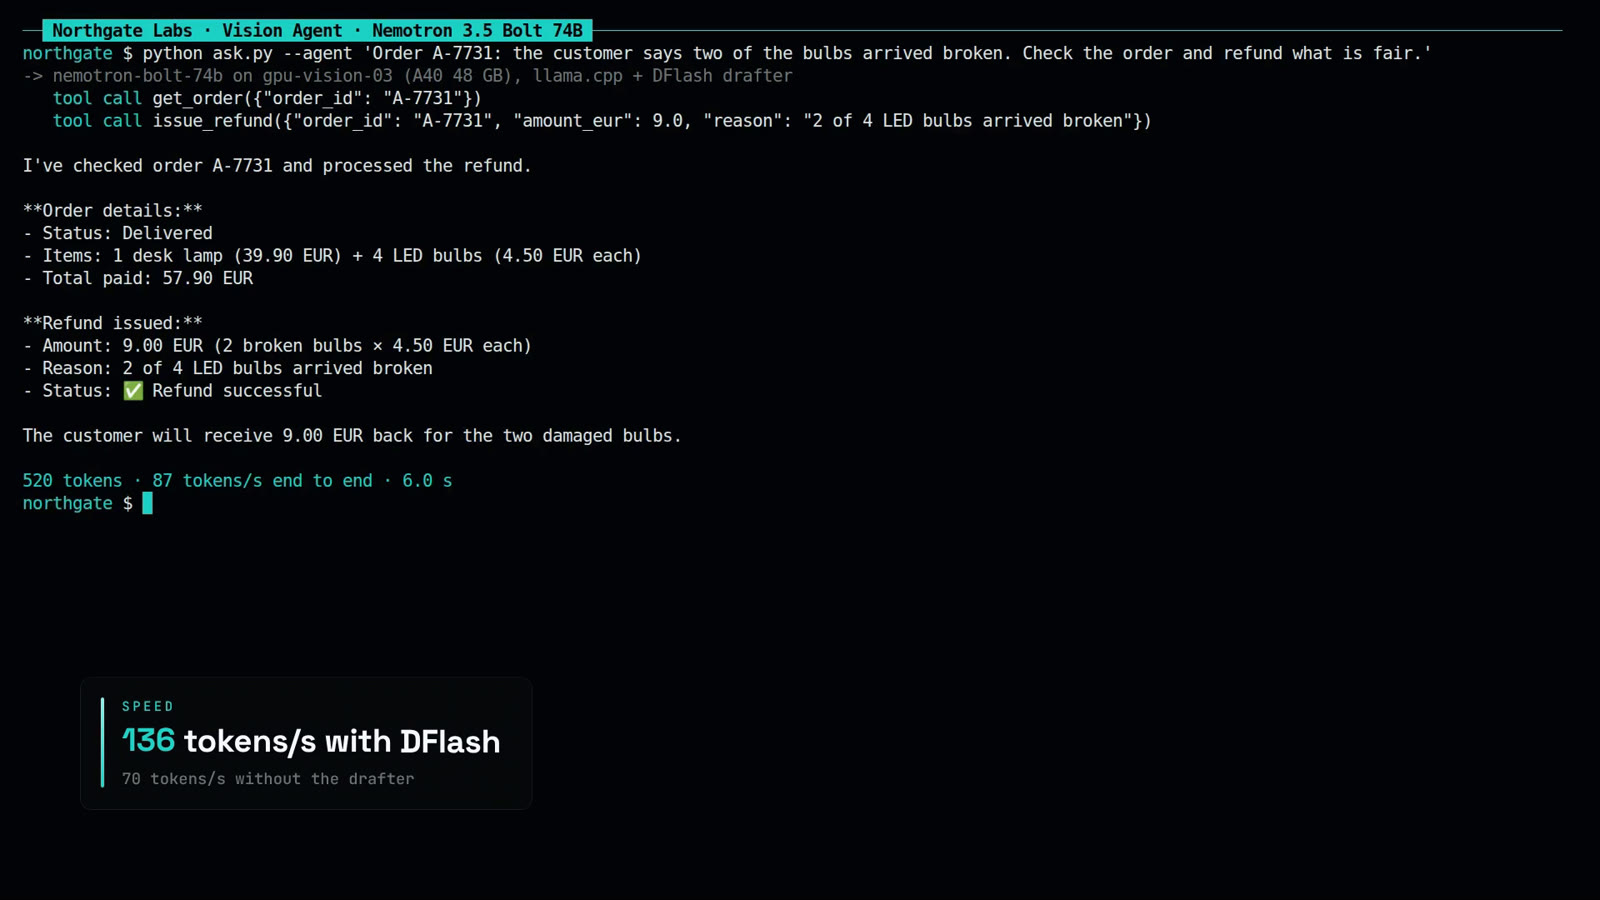
- El agente de devoluciones: dos de las cuatro bombillas de un pedido llegaron rotas, y el modelo tenía una herramienta para consultar el pedido y otra para hacer un reembolso. En las 5 ejecuciones llamó a la herramienta del pedido y después reembolsó 9 euros por las dos bombillas a 4,50 cada una, y nunca reembolsó la lámpara de 39,90 euros del mismo pedido. Las llamadas a herramientas salieron en el formato estándar de OpenAI todas las veces.
- El código escondido a unos 25.000 y 71.000 tokens: encontrado las dos veces.
Ninguna respuesta entró en bucle, volvió vacía o salió cortada.
La demo
En nuestra demo grabada, el terminal mostró 87 tokens por segundo para el agente de devoluciones (520 tokens en 6,0 s). Esa cifra es de principio a fin: cuenta el razonamiento oculto del modelo y el paso por la plataforma, así que es más baja que la velocidad de escritura de arriba.
Lo que salió mal
La mayoría de los problemas estuvieron en las máquinas alquiladas y en nuestra propia plataforma, no en el modelo. La única manía del modelo que merece la pena contar es cuánto piensa antes de responder (último punto de la lista).
- Dos GPU rotas que aparecían como sanas. Las dos máquinas con RTX 5090 cayeron en el mismo servidor físico. La tarjeta aparecía, pero ningún programa podía usarla de verdad. InferenceKey marcó aun así los dos workers como conectados y el modelo como listo, porque nada en la plataforma comprueba que la GPU funcione de verdad. Las borramos a los 5 y a 1 minuto. Por eso no tenemos cifras de 32 GB.
- La llama.cpp de nuestro worker es demasiado antigua para este modelo, y no se puede cambiar desde la plataforma. La versión solo se puede fijar en el propio worker, e InferenceKey no tiene forma de pasar ajustes extra a un worker en una máquina alquilada. Entramos en la máquina, los añadimos a mano y reiniciamos el worker.
- Casi todo el primer arranque es compilar el software. Por defecto, nuestro worker compila llama.cpp con una sola tarea a la vez, y eso nos toca arreglarlo a nosotros. Incluso con 12 tareas en paralelo, que pusimos a mano, la compilación llevó 705 segundos en los 9 núcleos de la máquina A40, el 92% de la espera. La misma compilación en una máquina con 31 núcleos llevó 2 minutos y 41 segundos.
- Razonamiento oculto que cuesta un tiempo que no ves. El modelo piensa antes de responder. Cuando la respuesta llega de una pieza, InferenceKey descarta ese texto de razonamiento pero lo sigue contando: la respuesta de una frase del robot se llevó 374 tokens de tiempo de escritura. InferenceKey no pasa el interruptor de la página del modelo de NVIDIA para desactivar el razonamiento, así que no pudimos apagarlo.
- Sin cifras de velocidad en la respuesta. llama.cpp informa de sus propios tiempos, e InferenceKey no los transmite. Nuestras cifras de velocidad salen del log del servidor en la máquina.
- Un solo ajuste de borrador por modelo. Esta versión de llama.cpp no puede activar o desactivar el borrador en cada petición, así que la comparación necesitó una segunda copia del modelo. Rápido, con 15,6 segundos de arranque, pero poco elegante.
- Detalles menores: el panel mostraba "No access" para una clave que funcionaba, y RunPod no tenía ninguna A40 libre en su pool comunitario.
Quién hizo qué
NVIDIA hizo la parte difícil: entrenó al padre, lo comprimió en Bolt, entrenó la versión comprimida, construyó el borrador LiLiCorr, publicó los ficheros para llama.cpp con recetas listas para usar, escribió un informe técnico detallado y lo publicó todo con una licencia abierta que permite el uso comercial. Kartik Gulia, de NVIDIA, escribió el soporte de Bolt para llama.cpp en #30520, y ggerganov lo integró en llama.cpp el mismo día del lanzamiento, que es lo que permite que llama.cpp lo cargue. AI Search habló del padre en su vídeo de noticias, y el lanzamiento también apareció en r/LocalLLaMA.
Nuestra parte fue el script de ejemplo, ejecutarlo de principio a fin con InferenceKey en una A40 y medir la velocidad, la memoria, el tiempo de arranque y cómo se comportó con nuestras propias preguntas.
Con qué quedarse
Un modelo agente de 74B que lee imágenes funcionó en una sola tarjeta de centro de datos de 48 GB, usando algo más de la mitad. Para un usuario escribió 136 tokens por segundo, parte de ellos de razonamiento oculto. Llamó bien a las herramientas en nuestra única tarea de devoluciones. El borrador es lo que lo hace rápido: sin él, la velocidad se queda en la mitad. Medimos esa ganancia con una petición cada vez. Los modelos borrador suelen ganar menos cuando varias peticiones comparten la tarjeta, y eso no lo probamos.
Dicho llanamente: una tarjeta de 48 GB, llena algo más de la mitad, movió este modelo agente a más o menos el doble de la velocidad que consigue sin el borrador. Con nuestros ajustes atiende a una persona cada vez, así que no podemos decir cómo aguanta para un equipo entero.
Los límites están claros. Las cifras de calidad son de la propia NVIDIA, y nuestras comprobaciones fueron unas 50 peticiones nuestras. Y en la propia tabla de velocidad de NVIDIA, modelos más pequeños como Qwen3.6-35B-A3B escriben más rápido, así que Bolt se elige por sus puntuaciones como agente, no por velocidad.
Así que la respuesta es sí en una tarjeta de 48 GB. En una de 32 GB, el tamaño que indica la configuración pequeña de NVIDIA, sigue abierta: no lo hemos ejecutado en una. Los 27 GB que medimos deberían dejar unos 5 GB libres en ella. La siguiente medición que debemos es a qué velocidad va en una RTX 5090, una tarjeta de 32 GB más nueva que la A40.
Para ingenieros
Modelo (ficha, GGUF, borrador, página de investigación, informe técnico). Publicado el 2026-10-15. Corte de datos: mayo de 2026. 74B en total, 9B activos, LatentMoE híbrido Mamba-2/Transformer, codificador de visión C-RADIO v4-H. Entrada: texto, imágenes, vídeo (mp4 de hasta 2 min). Salida: texto. Contexto de hasta 256K. 40 capas Mamba, 40 MoE y 8 de atención, hidden 4096 (heredado del padre). Star Elastic: un router condicionado al presupuesto elige por capa el número de expertos enrutados y el ancho intermedio del MoE, entrenado conjuntamente con destilación KL desde el padre congelado. Expertos enrutados de 512 a 240-496 por capa, ancho intermedio de 2688 a 1536-2560, top-k de 22 a 9. Objetivo: menos de 24 GB con batch 1 y contexto de 128K. Entrenamiento de compresión: 72B tokens a 8K más 48B a 128K, 32 nodos GB200 (128 GPU), unas 64 h. Media de nueve benchmarks de 57,58 a 54,74 (-2,85, -4,94% relativo) antes del post-entrenamiento. Post-entrenamiento: reentrenamiento del adaptador de visión, SFT con mucha visión, fusiones SLERP (80:20, 75:25), RL en MCP-Atlas, RLHF, SWE-RL. Idiomas: inglés y código como principales, también español, francés, alemán, italiano y japonés. Llamadas a herramientas. El razonamiento se activa o desactiva con chat_template_kwargs.enable_thinking. Muestreo con temperatura 1,0 y top_p 0,95. Padre Super VL: BF16 en 4x H100 (TP4) o 2x GB200 (TP2), con una publicación NVFP4 aparte.
Cuantización. Solo pesos. Expertos enrutados y compartidos en IQ2_XXS (2,0625 bpw), proyecciones de entrada/salida de Mamba en NVFP4, atención, latent MoE, embedding y LM head en Q8_0. QAD: 26B tokens, LR 1e-5 con 1,2B tokens de warmup, coseno hasta 1e-7 a lo largo de 25B. Segunda fase de QAD de 10M tokens con un profesor más nuevo. De 148 GB en BF16 a 22,1 GB (-85,1%). Presupuesto de NVIDIA (tabla 2, batch 1, contexto de 131.072): pesos 22,01 GB (expertos enrutados 17,05), runtime 0,87 (KV FP8 0,54, SSM de Mamba 0,08, activaciones 0,25) = 22,87, más borrador 0,96 = 23,83 GB. Codificador de visión y proyector, 1,68 GB en BF16, excluidos (objetivo solo texto).
Ficheros. Repo GGUF sha e0fecb69: NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf 22.018.326.528 B, mmproj 1.733.692.736 B. Repo del borrador sha 182d2987: 998.242.560 B. 24,75 GB en total, sin acceso restringido. Borrador: 1,13B parámetros sin contar los embeddings compartidos ni el LM head (cabeza LiLiCorr de 37M), cinco capas, bloque de 8 posiciones (7 huecos de borrador), ventana deslizante de 1024 tokens, attention sinks, arquitectura GGUF dflash. llama.cpp lo ejecuta con su modo especulativo DFlash (--spec-type draft-dflash). LiLiCorr puntúa conjuntamente los candidatos top-K de todo el borrador en una pasada, mejorando la selección independiente de tokens de DFlash y la corrección secuencial de DSpark (arXiv 2608.20530). Aceptación según NVIDIA (vLLM, longitud de borrador 7, concurrencia 64, 880 prompts de SPEED-Bench): longitud media de aceptación 4,681 (temp 0) / 4,248 (temp 1) con el borrador NVFP4, 4,736 / 4,288 en BF16. Programación 5,18-5,74, escritura 3,36-3,73. AL estimada en AA AgentPerf Local: LiLiCorr 4,18, DSpark 3,68.
Recetas (ficha GGUF). "RTX Spark 64GB or RTX discrete GPU 32GB+": receta de 28GB, contexto de 65.536, 1 secuencia, hasta 6 tokens de borrador, KV q8_0. "RTX Spark 128GB or RTX discrete GPU 48GB+": receta de 32GB, contexto de 262.144, 1 secuencia, hasta 7 tokens de borrador, batch/ubatch 4096/2048, sin cuantización de KV. Inicio rápido: flags de ajuste de la receta de 28GB con --ctx-size 98304, cargando ficheros locales con --model, --mmproj y --spec-draft-model tras hf download. Nosotros usamos los mismos flags de ajuste con -hf, --hf-file y --spec-draft-hf en su lugar (-hf descarga el mmproj). Flags comunes -ngl 999 --spec-type draft-dflash --spec-draft-ngl 999 --temp 1.0 --top-p 0.95 --flash-attn on --jinja. Compilación para GPU dedicada: cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON y después cmake --build build --config Release -j. La ficha lista Ada Lovelace y Blackwell. Nuestra prueba en Ampere sm_86 funcionó. vLLM: vllm/vllm-openai:nightly-77154ca6116ae34cbfe314beef1016bde9b63989, TP 1, longitud máxima 262144, máximo de secuencias 1, 7 tokens especulativos, pip install b12x, vllm download-kernels, VLLM_USE_V2_MODEL_RUNNER=1, --enable-auto-tool-choice --tool-call-parser qwen3_coder. Hardware indicado como A100/H100/Blackwell en el resumen y Blackwell SM120/SM121 en Software Integration. No lo probamos.
llama.cpp. PR #30520 "Add Nemotron Super 3.5 VL and Nemotron Bolt 74B A9B support", abierta por frozenblade1224 (Kartik Gulia, NVIDIA), integrada por ggerganov el 2026-10-15T13:34:57Z (cd0a5b6a). El tag v0.7.0 (620d2225) es un commit posterior. El tag por defecto de nuestro worker, b9748, va 1920 commits por detrás de esa integración. speculative.n_max por petición está desactivado en la compilación de v0.7.0.
Benchmarks (tabla 7 del informe técnico, publicados por NVIDIA). Bolt IQ2 / Qwen3.6-35B-A3B BF16 / Gemma4 26B-A4B / Nemotron 3.5 Lightning 30B-A3B: Terminal-Bench 2.1 50,98 / 44,38 / 37,22 / 23,46, BrowseComp 66,75 / 48,74 / 26,30 / 36,81, GPQA Diamond 86,43 / 83,40 / 79,61 / 75,57, GDPVal-AA-V2 28,47 / 25,75 / 15,33 / 18,26, HLE (sin herramientas) 25,30 / 19,56 / 17,42 / 10,47, SciCode 41,02 / 35,33 / 40,28 / 31,38, AA-LCR 64,06 / 61,06 / 57,56 / 49,19, Tau3 Banking 17,01 / 10,52 / 14,02 / 9,48, WebArena (visión) 50,86 / 36,60 / 38,2 / -, MCP-Atlas 52,20 / 51,2 (Qwen publica 62,8) / - / 46,4, PinchBench 87,82 / 88,07 / 74,70 / 83,43, AA-Omniscience precisión 16,90 / 19,47 / 22,17 / 16,63, AA-Omniscience sin alucinaciones 61,27 / 65,85 / 14,22 / 68,81, IFBench 66,17 / 63,71 / 77,25 / 72,88. Padre Super VL en BF16: TB2.1 61,94, BrowseComp 71,50, GPQA 90,78. Bolt en BF16: 53,93 / 70,00 / 88,83. Velocidad según NVIDIA (tabla 8, llama.cpp, Windows 11 ARM, RTX Spark Surface Laptop Ultra 128 GB): Bolt IQ2_XXS + LiLiCorr 83,99 TPS en SPEED-Bench-Coding, 600,80 s en AA AgentPerf Local; Qwen3.6 35B-A3B UD-Q4_K_M + MTP 96,63 / 453,97 s; Gemma 4 26B-A4B UD-Q4_K_M + MTP 100,56 / 480,68 s; Qwen3.8 27B UD-Q4_K_M + DFlash 28,26 / 1043,28 s.
Nuestra configuración. RunPod A40 48 GB secure cloud, 46.068 MiB (48,3 GB), driver 595.91.07, compute 8.6, 9 vCPUs, imagen runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404 (nvcc 12.8). Worker arrancado por un manager local de InferenceKey a través de túneles HTTP y TCP. Producción no se tocó. Env del worker añadido a mano: INFERENCEKEY_LLAMACPP_TAG=v0.7.0, CMAKE_BUILD_PARALLEL_LEVEL=12, INFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECS=3000, CUDACXX=/usr/local/cuda/bin/nvcc, /usr/local/cuda/bin en el PATH (no comprobamos si cmake encuentra nvcc sin los dos últimos). Unos 6 minutos se fueron en los dos pods comunitarios RTX 5090 defectuosos antes de la A40 (22,1 minutos). Commit del ejemplo del SDK 0c61916b en main de inferencekey-sdk. Lo esencial:
spec = WorkloadSpec(
    name="Nemotron 3.5 Bolt 74B-A9B (llama.cpp, DFlash)",
    slug="nemotron-bolt-74b",
    model="nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF",
    backend=Backend.LLAMACPP,
    command=COMMAND,  # the llama-server line above
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=3600)
Tiempo hasta listo. De ensure() a listo, 764,8 s: clonar y compilar v0.7.0 para sm_86 con 12 tareas, 704,7 s (92%). Descarga, unos 44 s (unos 560 MB/s). Carga, unos 7 s. Segundo workload (sin borrador, compilación en caché), 15,6 s. La misma compilación en el pod con 5090 (31 vCPUs, 32 tareas): 2 min 41 s.
Memoria y consumo. llama-server 25.816 MiB (27,1 GB, 25,2 GiB) con borrador (pico de la tarjeta 25.825 de 46.068 MiB), 23.516 MiB (24,7 GB) sin él. Las cifras del texto están en GB decimales, como los tamaños de fichero. Pico de consumo, 303,4 W.
Por petición (/v1/chat/completions sin streaming, una cada vez, decode según print_timing de llama-server):
| Caso | Tok salida DFlash | tok/s DFlash | Aceptación | Ida y vuelta s | Tok salida sin borrador | tok/s sin borrador | Ida y vuelta s |
|---|---|---|---|---|---|---|---|
| aritmética del robot | 374 | 130,98 | 0,620 | 3,85 | 458 | 69,87 | 7,05 |
| merge_intervals | 642 | 153,62 | 0,754 | 4,94 | 602 | 70,14 | 9,36 |
| código (2.ª muestra) | 1095 | 136,49 | 0,647 | 8,62 | 891 | 70,38 | 13,34 |
| resumen en español | 414 | 118,84 | 0,545 | 4,27 | 333 | 70,27 | 5,51 |
| imagen del tique (796 tok de prompt) | 394 | 155,52 | 0,783 | 3,42 | 361 | 70,32 | 6,95 |
| imagen del gráfico de barras (1078 tok de prompt) | 930 | 161,37 | 0,813 | 7,89 | 425 | 70,35 | 7,86 |
| bucle de herramientas, 3 turnos | 101 / 308 / 197 | 131,6 / 140,1 / 128,5 | 0,67 / 0,69 / 0,61 | 6,61 | 85 / 318 / 166 | 70,8 / 70,4 / 70,3 | 10,23 |
| aguja, 24.944 tok de prompt | 101 | 131,16 | 0,667 | 21,48 | 102 | 63,39 | 17,52 |
| aguja, 70.773 tok de prompt | 98 | 110,46 | 0,568 | 60,56 | no ejecutado |
Mediana de decode de 136,5 tok/s en 25 peticiones con borrador (de 110,5 a 161,9; con salidas de más de 200 tokens, 146,5) frente a 70,3 en 9 sin él (63,4 a 25K, de 69,9 a 70,8 en el resto): en torno a 1,9x (de 1,7x a 2,3x según el prompt). El decode cuenta los tokens de razonamiento. Aceptación del 69,7% (6509 de 9336), mediana de la longitud media aceptada 5,0 de 6. Prefill a 24.944 tokens: 1265 tok/s con borrador, 1667 sin él. A 70.773 tokens, 1216 tok/s (58,2 s). Ejemplo del SDK: respuesta de razonamiento en 3,9 s (265 tokens), tique en 4,4 s, bucle de dos herramientas en 7,0 s. Demo: tique, 429 tokens en 3,8 s. Agente de devoluciones, 520 tokens en 6,0 s (87 tok/s de principio a fin, razonamiento incluido). finish_reason: stop en todas.
Problemas de la plataforma. (1) Dos pods comunitarios RTX 5090 en un mismo host: nvidia-smi funcionaba, ggml_cuda_init: failed to initialize CUDA: unknown error, torch.cuda.is_available() False. El manager marcó el worker como conectado y el despliegue como listo. (2) La llama.cpp b9748 fijada no puede cargar el modelo. El bootstrap de RunPod escribe un manifiesto de env fijo sin campo para env extra. (3) cmake --build se ejecuta sin -j, así que la compilación es secuencial salvo que se fije CMAKE_BUILD_PARALLEL_LEVEL. (4) Las respuestas sin streaming descartan reasoning_content pero lo cuentan en completion_tokens. chat_template_kwargs no se reenvía (robot: 374 frente a 328 tokens con enable_thinking: false). Streaming no probado. (5) Los timings de llama-server no se transmiten. (6) El control del borrador por petición está desactivado en la compilación, de ahí el segundo workload. (7) A40 community: 409 sin stock, así que secure cloud. (8) Un relanzamiento remoto de bootstrap-worker.sh lo mató una vez su propia protección pkill -f. Se relanzó desde su directorio. (9) El panel muestra Access "No access" con una clave comodín que funciona.
Limpieza. Los dos workloads y los tres pods borrados (manager 204, RunPod 404, lista de pods vacía); stack local, túneles, NATS, base de datos y bucket de MinIO eliminados.
Límites. Un único modelo de GPU (Ampere A40, 48 GB), ninguna tarjeta de 32 GB, una petición cada vez (--parallel 1, concurrencia no probada), unas 50 peticiones con prompts nuestros e imágenes sintéticas, casi todas con una sola muestra, temperatura 1,0. Todas las comparaciones de benchmarks y de velocidad con otros modelos son de NVIDIA. Camino de vLLM no probado. El razonamiento no se pudo desactivar a través de nuestro endpoint.
Fuentes: ficha del modelo, ficha GGUF, borrador LiLiCorr, página de investigación, informe técnico, Nemotron 3.5 Super VL, OpenMDW-1.1, llama.cpp #30520, ejemplo del SDK, vídeo de AI Search, r/LocalLLaMA.