Ming-Image Design dessine des écrans chargés de texte en 7 secondes, sur une carte de 80 GB
Le modèle de design 6B d'inclusionAI a pris 64,4 GiB sur une A100 80GB, a dessiné un écran 1024 en 6 à 7 s et un seul PNG transparent en six essais.
Un simple retour à la ligne a décidé si notre sticker de renard revenait détouré proprement ou en carré blanc. C'est le côté le plus capricieux de Ming-Image-0.1-Design, le nouveau modèle ouvert d'inclusionAI pour les écrans d'application, les tableaux de bord, les slides et les affiches pleines de texte. Le chiffre qui compte, c'est la mémoire. Vendu comme un 6B, il fait penser à une carte de 12 GB. Sur une NVIDIA A100 de 80 GB dans notre cloud, il a culminé à 64,4 GiB. Si vous déployez des modèles d'image, cela change la carte que vous louez. Sur cette carte, il a dessiné un écran d'application en 1024 x 1024 en 6 à 7 secondes et une affiche en 2048 x 2048 en 36. Les mots que vous mettez entre guillemets sont pour la plupart sortis bien orthographiés. Il est sous licence MIT, donc vous pouvez livrer ce qu'il produit. Pour des maquettes avec du vrai texte sur votre propre matériel, prévoyez une carte de 80 GB et vérifiez chaque asset transparent dans le code.
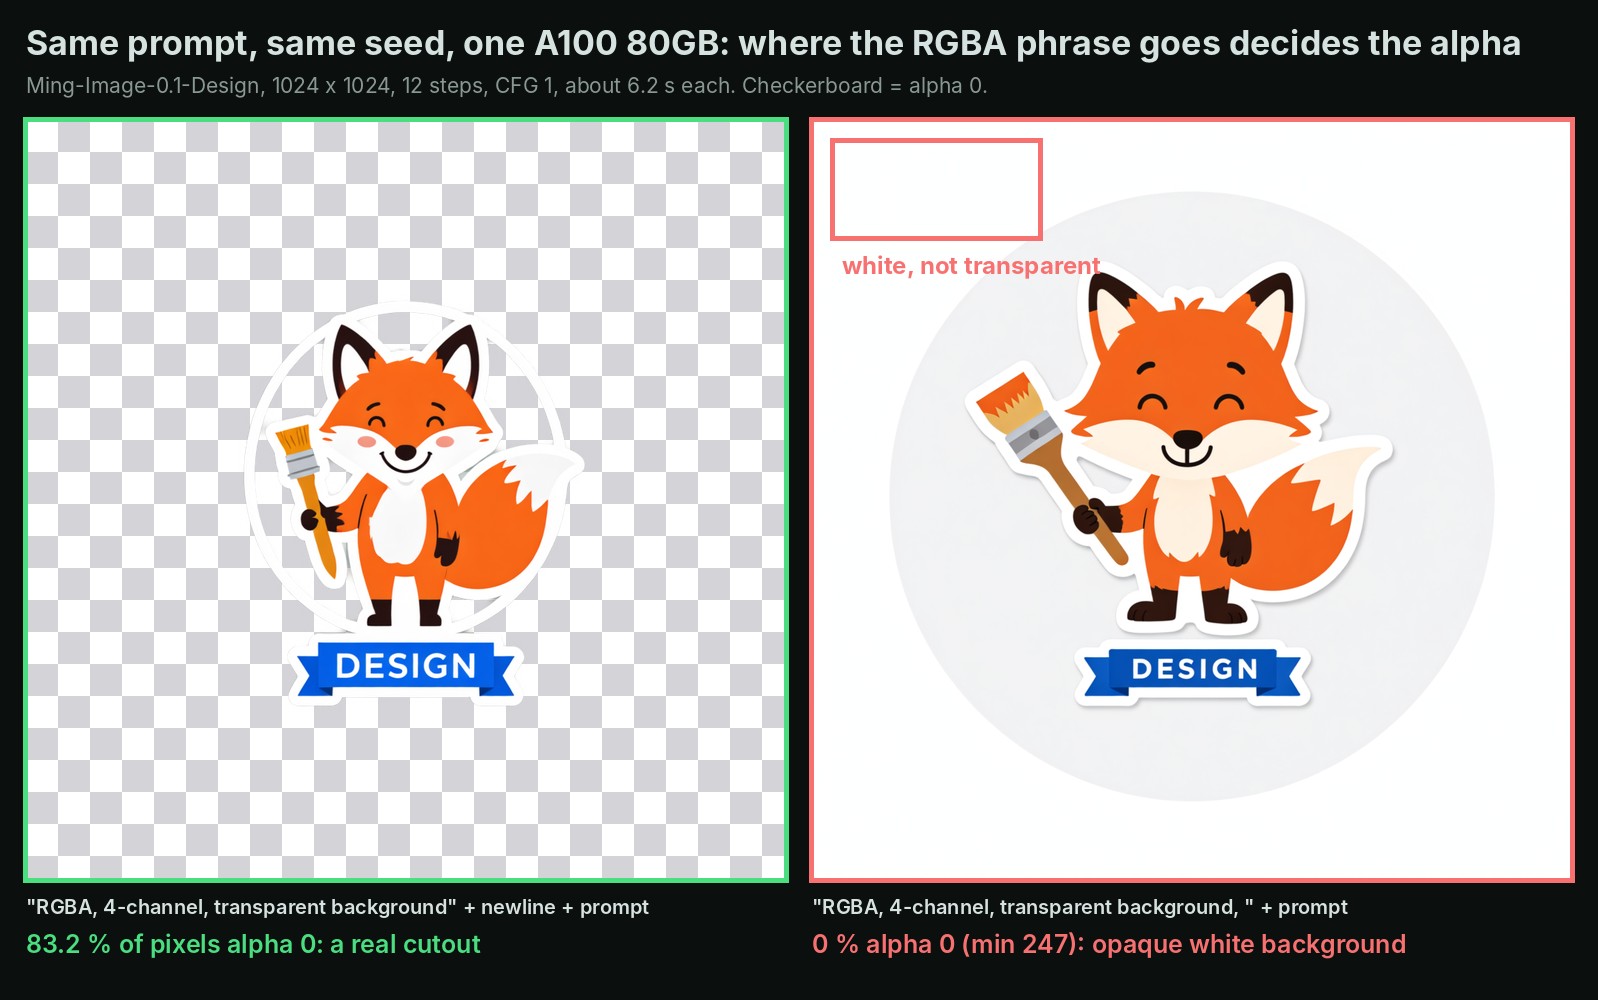
Même prompt, même départ aléatoire. Le retour à la ligne est la seule différence.
Le 6B n'est qu'un membre du groupe
Une affiche de concert met le nom du chanteur. Le camion transporte quand même la batterie, les amplis et le bassiste. Ming-Image Design marche pareil. La partie de 6 milliards de paramètres, celle qui dessine, pèse 12,3 GB sur disque. Derrière, il y a un modèle de langage de 34 GB qui lit votre prompt, un connecteur de 6,2 GB et un petit décodeur. Au total, le repo fait 52,9 GB.
Les auteurs le disent dans leur README : la configuration minimale validée est "one GPU with at least 80 GiB of memory." C'est le nombre de paramètres qui a circulé. Nous avons repéré le modèle dans une vidéo d'actualité d'AI Search, qui parlait de 12 gigaoctets, et notre propre catalogue avait recopié ce chiffre. Nous voulions le vrai, alors nous l'avons fait tourner.
Assez rapide pour itérer sur un design, pour une fraction de centime par écran
Nous avons gardé la configuration validée par les auteurs : modèle non compressé, 12 passes par image, une requête à la fois, leur propre code Python en dessous. Nous avons fait 15 images avec nos propres prompts, un seul essai chacune.
| Taille | Temps de carte par image | Pic de mémoire de la carte |
|---|---|---|
| 1024 x 1024 | 6,2 à 7,4 s | 50,45 GiB |
| 2048 x 2048 | 35,8 s | 64,4 GiB |
Quatre fois plus de pixels coûtent environ cinq fois plus de temps. Occupée sans arrêt, une carte ferait environ 400 à 500 écrans par heure en 1024. Une A100 de 80 GB se loue environ 1,4 à 1,8 dollar de l'heure, donc un écran en 1024 coûte entre un quart et un demi-centime, et une affiche en 2048 environ 2 centimes. C'est une estimation à partir d'images isolées, pas d'un test en continu.
Les mots entre guillemets sortent justes, le reste est du décor
Le texte court que vous écrivez entre guillemets est en général le texte que vous obtenez. Une affiche de concert a eu juste le nom du groupe et les dates dans trois villes. Une slide intitulée "Q3 GPU spend" a eu juste chaque étiquette de barre. Les trois cartes de statistiques d'un tableau de bord étaient parfaites. Le texte entre guillemets est sorti juste dans 5 mises en page sur 7.
Le texte que vous laissez au modèle, c'est une autre histoire. Les axes de graphique, les sous-titres et les cartes de fonctionnalités que nous n'avions pas écrits en toutes lettres sont revenus en pseudo-mots convaincants. Les longues listes ont dérapé aussi : un menu de café de 12 lignes est revenu avec deux prix faux et une ligne de café que nous n'avions jamais demandée.
La transparence a marché une fois sur six variantes de prompt
Chaque image revient en PNG avec un canal alpha, la couche qui dit à quel point chaque pixel est transparent. C'est le tour de force du modèle : un sticker ou un logo qui se pose sur une slide sans carré blanc autour.
En pratique, cela a marché dans une variante sur six. Les auteurs publient dix phrases déclencheuses. Avec "RGBA, 4-channel, transparent background" seule sur la première ligne, le renard est revenu avec 83,2 % de ses pixels entièrement transparents, deux fois. Avec une virgule à la place du retour à la ligne, blanc uni. Une icône d'application avec la phrase sur sa propre ligne est aussi revenue opaque, tout comme trois autres combinaisons de phrase et de sujet.
Qui devrait s'y intéresser
- Les équipes qui font des maquettes, des slides ou des affiches avec un texte qu'elles peuvent écrire en entier : mettez chaque mot dont vous avez besoin entre guillemets.
- Ceux qui ont besoin de menus, de listes de prix ou de tableaux : relisez chaque ligne avant de livrer.
- Ceux qui ont besoin d'assets transparents : mettez la phrase sur sa propre ligne et vérifiez la couche alpha dans le code. Notre backend renvoie la part de pixels transparents avec chaque image, donc cette vérification tient en une ligne.
- Les équipes avec des cartes de moins de 80 GB : prévoyez une carte de 80 GB pour l'instant. Nous avions prévu une émulation à 24 GB, et elle n'a jamais tourné.
Sur InferenceKey, Ming est livré sous forme de script Python, pas de serveur, donc nous l'avons enveloppé dans un custom backend : un petit programme qui charge le modèle une fois et répond aux requêtes. Un programme qui demande déjà des images à OpenAI peut appeler cette carte à la place. Un redémarrage après une mise à jour a pris 29 secondes. Les versions exactes des bibliothèques indiquées par les auteurs ne tournent pas telles quelles sur Python 3.11. Des versions un peu plus récentes règlent le problème, et l'exemple du SDK livre celles-là.
La limite honnête : c'est un test de comportement avec un essai par prompt sur un seul type de carte, pas un benchmark de qualité.
Merci à inclusionAI d'avoir construit et publié Ming-Image-0.1-Design sous MIT, avec le code d'inférence et les phrases de transparence, et à AI Search, où nous l'avons repéré. Notre part : le custom backend, le déploiement sur InferenceKey, les corrections de dépendances et les mesures.
Lisez le test complet, avec toutes les images, les chiffres de mémoire et les étapes de déploiement, dans notre article Research.