WeVisOne-VL-4B fait sept métiers de vision sur une seule carte de 16 GB, et son moteur rapide a mal compté un échiquier
WeVisOne-VL-4B de Tencent a encadré, compté, lu et détouré sur une vraie RTX 5080 de 16 GB, avec un détourage en une seconde sur une RTX 4090.
Dans un produit, une fonction de vision, ce sont souvent trois modèles à la suite : un qui dessine des cadres autour des objets que vous nommez, un qui transforme chaque cadre en contour, et un qui fait un détourage propre qui garde les cheveux. Le nouveau WeVisOne-VL-4B de Tencent fait tout cela dans un seul modèle ouvert de 4 milliards de paramètres, et nous l'avons fait tourner sur notre cloud pour voir si ça tient. Ça tient. Sur une vraie RTX 5080 de 16 GB, il a réussi nos 14 requêtes, réparties sur sept types de tâches, avec un pic de 12,8 GiB sur la carte. Sur une RTX 4090, le détourage d'un portrait en pleine résolution a pris environ une seconde. Pour une équipe qui déploie des modèles, cela fait un téléchargement, une carte et un endpoint là où il en fallait trois. Le revers : la façon rapide de le faire tourner a compté 15 pièces d'échecs là où il y en a 16, alors vérifiez ses comptages avant de vous y fier.
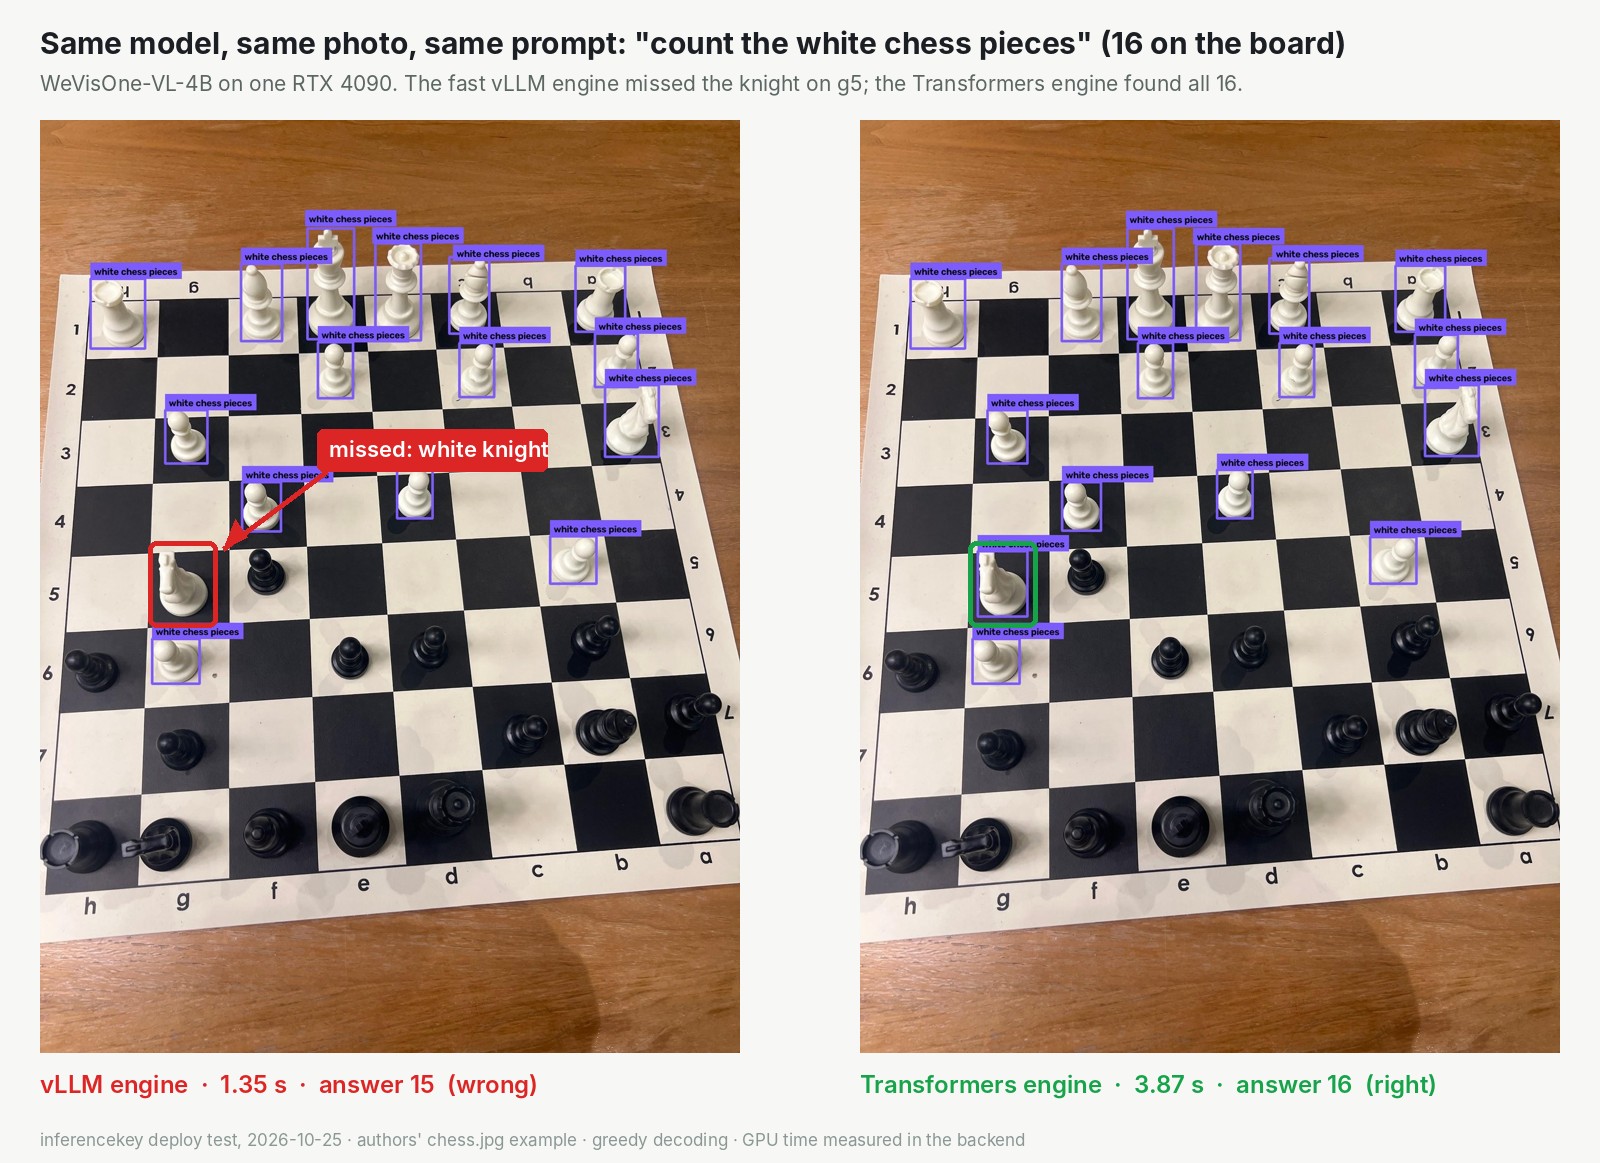
Même modèle, même photo et même consigne sur une RTX 4090. Le moteur rapide (à gauche) a répondu en 1,35 seconde et a raté le cavalier en g5. Le moteur de référence (à droite) a pris 3,87 secondes et a trouvé 16.
Ce qu'est ce modèle
WeVisOne-VL ("WeChat Vision All-in-One") vient de l'équipe WeChat Vision de Tencent, et il est construit sur un modèle ouvert d'Alibaba. D'après sa fiche de modèle, il trouve tout ce que vous pouvez nommer, ou une seule chose décrite comme "le chat de droite". Il sait aussi compter, pointer, lire du texte avec sa position, tracer des contours et faire des détourages.
L'astuce est simple à se représenter. Le modèle répond en texte, et une position sur l'image n'est que du texte en plus : un cadre, ce sont quatre mots spéciaux, un point, deux. Pour les contours et les détourages, un minuscule découpeur séparé de 9,6 millions de paramètres, environ 500 fois plus petit que le modèle, lit ce que le modèle a vu et peint les pixels. Aucun outil de contour séparé ne tourne à côté.
Les auteurs annoncent que le 4B est en tête sur plus de 30 benchmarks. Sur leur test de recherche d'objets nommés, il obtient 55,3 sur 100, contre 38,8 pour GroundingDINO, un modèle courant pour dessiner des cadres. Ce sont leurs tableaux, pas une comparaison que nous avons faite nous-mêmes. Les poids sont sous Apache 2.0, ce qui autorise l'usage commercial, et la fiche de modèle précise qu'il n'est pas conçu pour identifier des personnes. Cette ligne compte si votre produit traite des visages.
Ce que nous avons trouvé : tout tient sur 16 GB, et les deux moteurs ne sont pas d'accord
Le paquet de code des auteurs peut faire tourner le modèle de deux façons : un moteur rapide conçu pour le service, et le simple moteur de référence. Nous avons envoyé les mêmes 14 requêtes, une image à la fois, à chaque configuration. Elles couvraient la recherche de plusieurs objets nommés, le comptage, la recherche d'une seule chose décrite (et le refus d'une chose absente), le pointage, la lecture de texte, le contour et le détourage.
| Tâche | RTX 4090, rapide | RTX 5080 16 GB, référence |
|---|---|---|
| Détourer une personne, 1620 x 1080 | 1,0 s | 2,1 s |
| Trouver "le chat de droite" | 0,21 s | 0,68 s |
| Compter 12 personnes | 0,78 s | 2,8 s |
| Pic de mémoire sur la carte (GiB) | 23,0 | 12,8 |
Le moteur rapide est environ trois fois plus rapide sur la plupart des tâches sur les objets, mais il charge le modèle deux fois et demande une carte de 24 GB. Le moteur de référence a culminé à 12,3 GiB sur la même carte, donc la carte de 24 GB est un choix de vitesse, pas une obligation.
La vitesse est venue avec une mauvaise réponse. Les deux moteurs utilisaient un décodage glouton, donc le raté sur l'échiquier n'est pas du bruit d'échantillonnage. Les moteurs ont aussi divergé sur un panneau de rue (29 mots lus contre 21) et sur des casseroles et poêles suspendues (19 contre 20). Un raté sur 14 requêtes, ce n'est pas un taux. C'est une raison de faire la balance sur la sono sur laquelle vous allez vraiment jouer : testez vos propres images sur le moteur que vous allez mettre en production.
Un résultat qui nous a plu : quand on lui a demandé "le chien" dans une photo de chats, il a répondu qu'il n'y en avait pas, dans toutes les configurations que nous avons fait tourner. Un détecteur qui invente un chien, c'est exactement le bug qui fait qu'une équipe produit cesse de faire confiance à la fonction.
À qui ça s'adresse
Si vous livrez aujourd'hui de la détection, des contours ou des détourages, c'est un seul modèle sur une seule carte qui fait des tâches qui demandent d'habitude une chaîne. Si vous avez une carte de 16 GB, chaque tâche a tourné sur une vraie RTX 5080. S'il vous faut des comptages justes, utilisez le moteur de référence ou vérifiez d'abord le moteur rapide sur vos propres images. S'il vous faut de la vitesse, une carte de 24 GB avec le moteur rapide a donné des détourages en une seconde et des recherches en moins d'une seconde, après une requête de chauffe : la toute première détection après un démarrage a pris environ 15 secondes.
Sur notre plateforme, il tourne comme backend personnalisé, un petit programme Python que nous faisons tourner sur votre machine GPU à la place d'un serveur de modèles standard, parce que le découpeur vit en dehors de ce que renvoie un serveur standard. Une RTX 5080 neuve qui n'avait jamais vu le modèle répondait au bout de 87 secondes, téléchargement compris.
La limite honnête : nous avons envoyé une requête à la fois sur des images seules, et sous un plafond de mémoire strict émulé de 12 GB, tous les contours et tous les détourages ont échoué, donc en dessous de 16 GB, comptez uniquement sur les cadres et le texte.
Lisez le test complet de WeVisOne-VL-4B dans notre article Research, avec l'échelle de mémoire, chaque mesure de temps et l'exemple de déploiement.