Underdog Bark 3.0 Pro apunta cada "you know" y supera por poco a Qwen3-ASR con una cuarta parte de su tamaño
Bark 3.0 Pro falló el 6,28 % de las palabras en 40 clips en inglés y Qwen3-ASR-1.7B el 7,03 %. Además funcionó sin GPU, con cuatro hilos de CPU.
"Bark 3.0 escribe lo que se dijo, muletillas incluidas. No limpia el habla." Esa frase de sus autores explica casi todo lo que vimos. Underdog Bark 3.0 Pro es un nuevo modelo abierto de voz a texto que ocupa 1,25 GB en disco. En 40 clips en inglés falló el 6,28 % de las palabras. Qwen3-ASR-1.7B, un modelo de 4,7 GB, falló el 7,03 % con el mismo audio y en la misma RTX 3090. Muy igualados, con Bark ligeramente por delante. Para un equipo que despliega modelos, la noticia es el tamaño: Bark necesita unos 2 GB de memoria de GPU cuando el audio largo se corta en trozos, y cuatro hilos de procesador transcriben una grabación más rápido de lo que dura. Lo que puedes hacer con él: sacar transcripciones literales en inglés de reuniones y llamadas con el hardware que ya tienes, sin GPU si no queda otra.
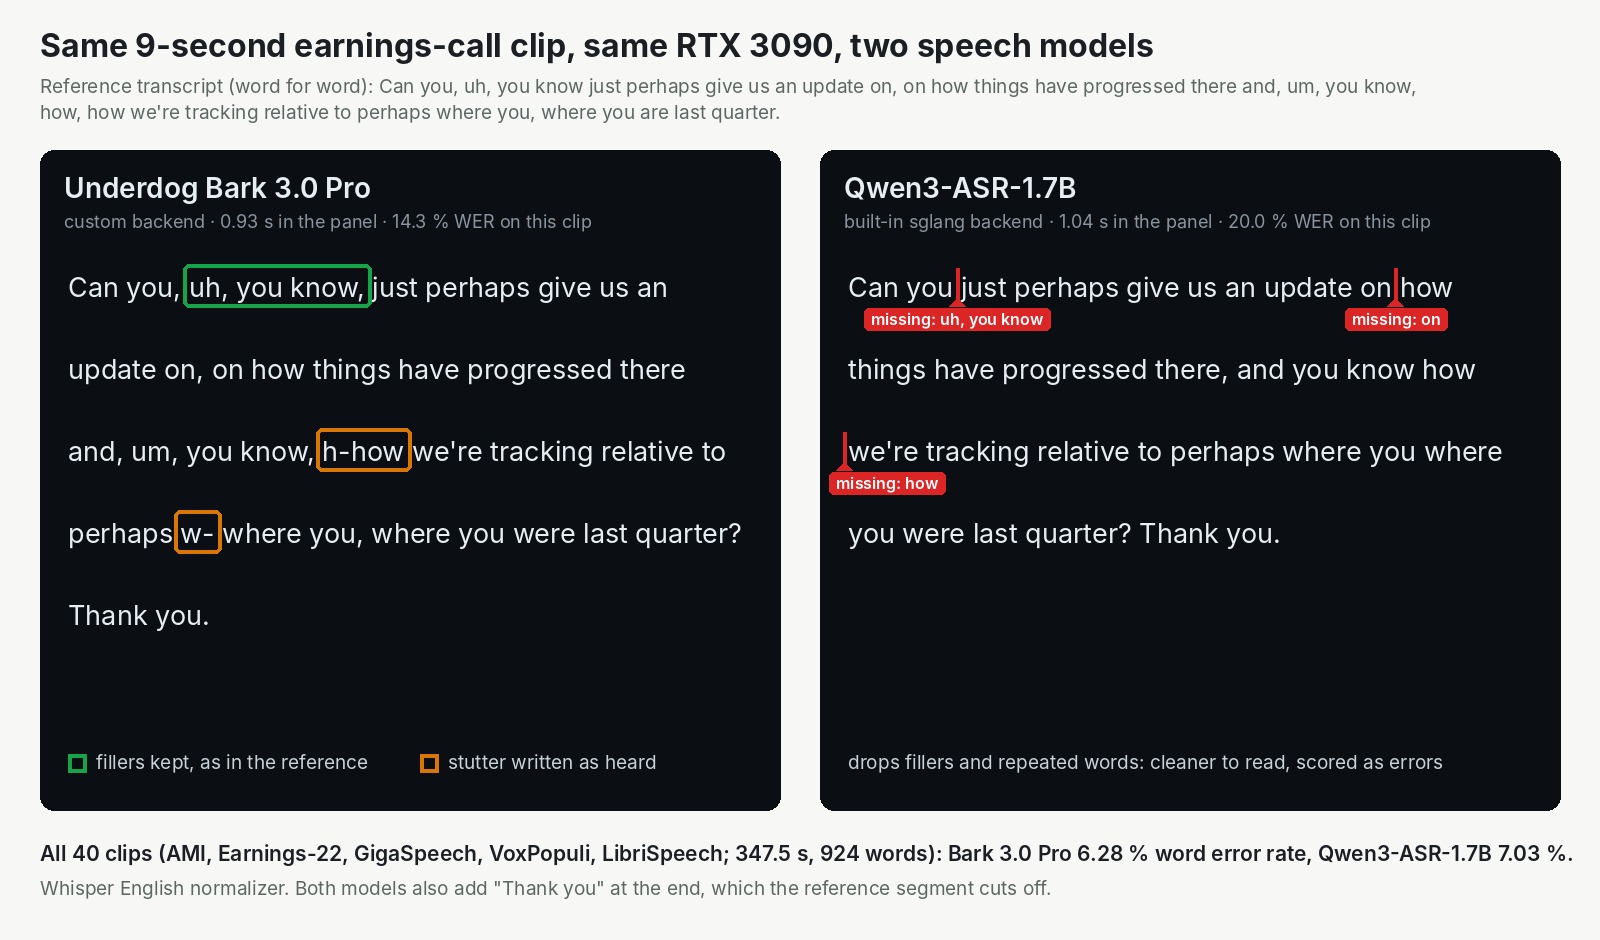
Un clip de una conferencia de resultados, una tarjeta. Bark conserva las muletillas y las repeticiones que conserva la referencia. El texto más pulido de Qwen pierde puntos por eso.
Un modelo pequeño hecho entre cuatro equipos
Bark tiene árbol genealógico. NVIDIA entrenó el modelo base, Parakeet TDT 0.6B v3. Moondream hizo una versión mejorada. Después, Conway Research lo reentrenó y lo encogió hasta convertirlo en Bark 3.0 Pro, y lo publicó en Hugging Face el 15 de octubre. El equipo de Underdog escribió el post del lanzamiento. Los tres modelos de la cadena usan CC-BY-4.0, que permite el uso comercial siempre que se cite a NVIDIA, Moondream y Conway Research.
Lo vimos en el vídeo de noticias de AI Search del 25 de octubre. La afirmación que nos hizo mirarlo está en la página del modelo: una tasa media de error por palabra del 4,29 % en el Open ASR Leaderboard, un ranking público de voz a texto, la más baja de cualquier modelo abierto según sus propias cuentas. La tasa de error por palabra es la proporción de palabras que un modelo falla, así que cuanto más baja, mejor. Esa cifra la dan ellos y no intentamos reproducirla. Nuestra parte fue más pequeña y más práctica: empaquetar Bark para desplegarlo, ponerlo junto a Qwen3-ASR en una misma tarjeta y contar los errores.
La diferencia es sobre todo "you know"
Sacamos ocho clips de cada uno de cinco conjuntos de prueba estándar: reuniones de oficina, conferencias de resultados, podcasts, discursos del Parlamento Europeo y audiolibros. En total, casi seis minutos y 924 palabras. Los dos modelos corrieron en nuestra nube, a través de una build local de pruebas de InferenceKey, y se puntuaron con las mismas reglas.
| En nuestros 40 clips | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|
| Palabras falladas | 6,28 % | 7,03 % |
| Palabras omitidas | 11 | 29 |
| Palabras mal oídas | 32 | 28 |
| Tamaño en disco | 1.254 MB | 4.699 MB |
Las filas del medio cuentan la historia. Las referencias humanas son literales: escriben lo que dijo la gente, arranques en falso incluidos. Imagina el pirata de un directo, toses incluidas, frente a la versión de estudio. Bark escribe el pirata. Qwen tira hacia la versión de estudio, y la mayoría de las 29 palabras que omitió eran muletillas y repeticiones como "you know", "on, on" y "how, how". En palabras realmente mal oídas, Qwen fue ligeramente mejor. Así que la ventaja de Bark viene de conservar lo que se dijo, no de tener mejor oído.
Por eso la ventaja de Bark fue mayor en reuniones y conferencias de resultados, donde las referencias conservan más muletillas y repeticiones. Qwen lo hizo mejor en los discursos del Parlamento y en los audiolibros, y no averiguamos por qué.
Tan rápido que lo lento es la red
Un clip típico volvía en medio segundo, contando el viaje por la red. Cinco minutos de audio de una conferencia de resultados costaron 2,8 segundos de trabajo de GPU en una sola petición, 4,5 segundos contando la subida y la respuesta, y Bark devolvió la transcripción entera. Qwen3-ASR devolvió 212 palabras del mismo fichero y se paró. No investigamos por qué.
Ahora la parte que importa si estás eligiendo hardware. Con solo Bark cargado, la 3090 nunca pasó de unos 2,8 GB de sus 24 GB. Limitamos la memoria que podía usar Bark para imitar tarjetas más pequeñas: por debajo de unos 2 GB, todo pasó cuando el audio largo se cortó en trozos de 60 segundos. Y sin tarjeta gráfica, cuatro hilos de un procesador de servidor hicieron el fichero de cinco minutos en 31 segundos, y dieciséis hilos en 14. Las transcripciones coincidieron palabra por palabra con las de la GPU en los 40 clips.
A quién le interesa
- Equipos que transcriben reuniones, llamadas o entrevistas en inglés y necesitan cada palabra tal como se dijo. Bark cometió menos errores literales que Qwen3-ASR-1.7B en nuestras reuniones y conferencias de resultados.
- Equipos sin una GPU libre. Unos pocos hilos de procesador transcriben una grabación más rápido de lo que dura, así que una máquina que ya tienes en marcha puede hacer el trabajo.
- Quien quiera meterlo en un producto. La licencia lo permite, citando a los autores.
Si quieres un texto que la gente lea sin editar, prevé un paso de limpieza: los autores publican aparte un Bark 3.0 Clean que quita las muletillas, y ese no lo probamos. Si tu audio no está en inglés, busca en otra parte. Bark solo funciona en inglés y, según sus autores, todavía no da tiempos por palabra ni nombres de hablantes.
El límite, sin rodeos y una sola vez: 924 palabras es una muestra pequeña en una sola GPU real, así que lee el resultado como "muy igualados, con Bark por delante", no como un ranking, y da por no probadas las tarjetas más pequeñas, porque ninguno de los siete tipos que intentamos alquilar tenía disponibilidad.
La prueba completa
El post de Research tiene la tabla por conjunto, las dos transcripciones del clip de la conferencia de resultados, la escalera de memoria, las pruebas en CPU y las dos asperezas que encontramos en la plataforma. Lee la prueba completa de Underdog Bark 3.0 Pro.