Underdog Bark 3.0 Pro note chaque "you know" et devance de peu Qwen3-ASR, pour un quart de la taille
Bark 3.0 Pro s'est trompé sur 6,28 % des mots de 40 extraits en anglais, Qwen3-ASR-1.7B sur 7,03 %. Il a aussi tourné sans GPU, sur quatre threads CPU.
"Bark 3.0 writes what was said, fillers included. It does not clean speech up." Cette phrase de ses auteurs explique l'essentiel de ce que nous avons vu. Underdog Bark 3.0 Pro est un nouveau modèle ouvert de reconnaissance vocale, 1,25 GB sur disque. Sur 40 extraits en anglais, il s'est trompé sur 6,28 % des mots. Qwen3-ASR-1.7B, un modèle de 4,7 GB, s'est trompé sur 7,03 % avec le même audio et la même RTX 3090. C'est serré, avec Bark légèrement devant. Pour une équipe qui déploie des modèles, c'est la taille qui fait l'actualité : Bark a besoin d'environ 2 GB de mémoire GPU une fois l'audio long découpé en morceaux, et quatre threads de processeur transcrivent un enregistrement plus vite qu'il ne se lit. Ce que vous pouvez en faire : obtenir des transcriptions mot à mot de réunions et d'appels en anglais sur le matériel que vous avez déjà, sans aucun GPU s'il le faut.
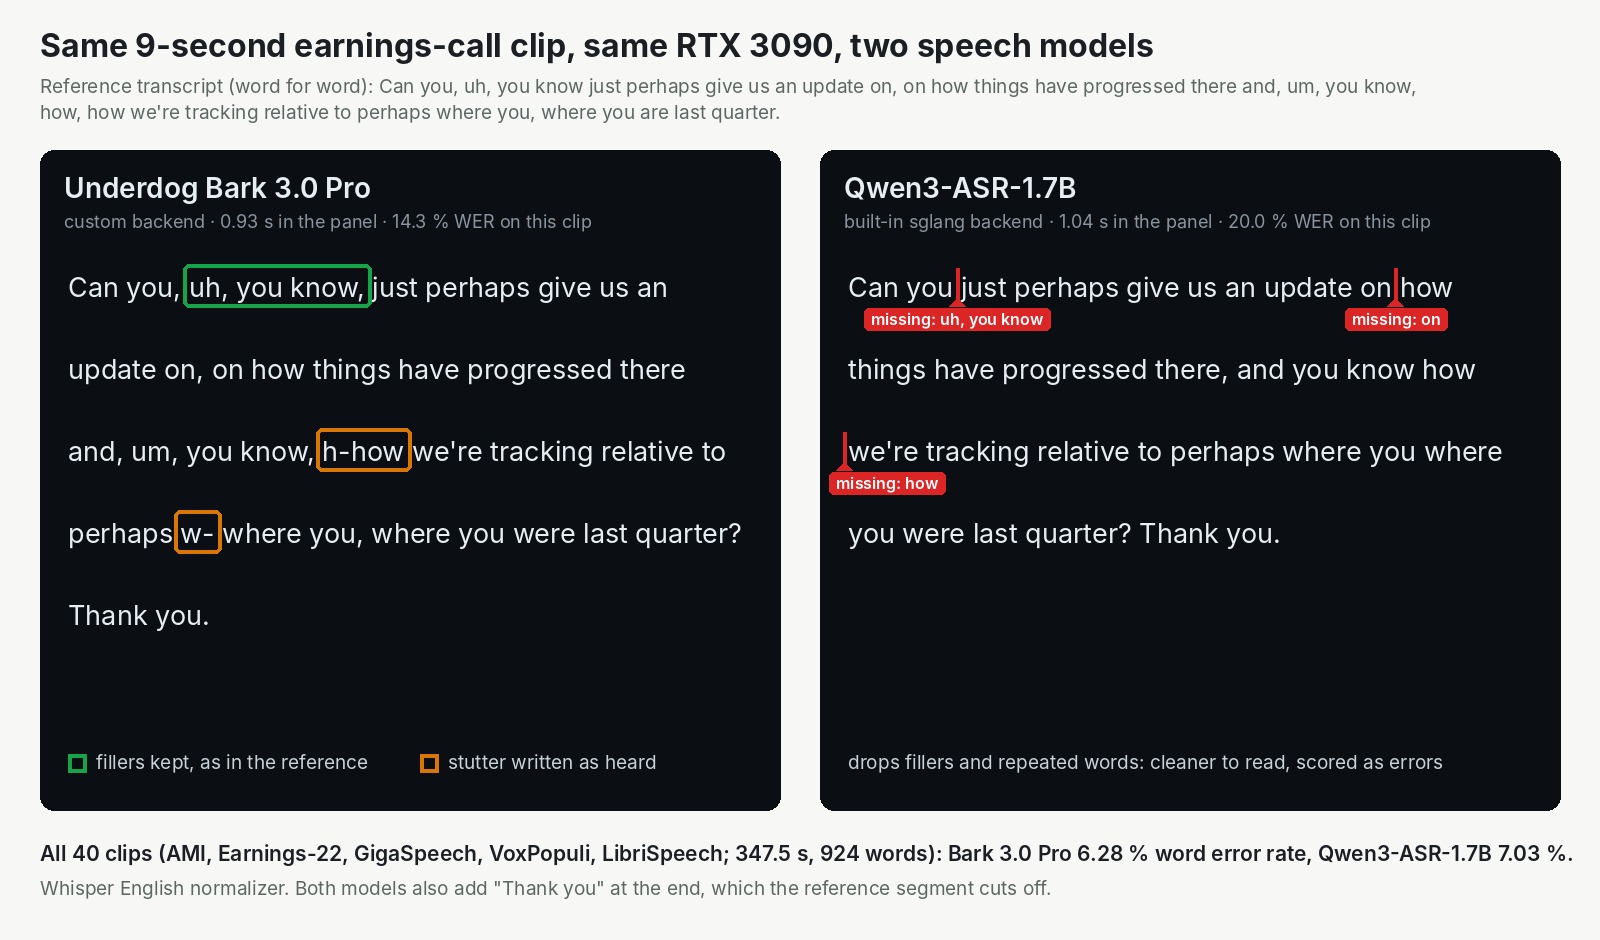
Un extrait de conférence de résultats, une carte. Bark garde les hésitations et les répétitions que garde la référence. Le texte plus propre de Qwen perd des points pour ça.
Un petit modèle construit par quatre équipes
Bark a un arbre généalogique. NVIDIA a entraîné le modèle de base, Parakeet TDT 0.6B v3. Moondream en a fait une version améliorée. Conway Research l'a ensuite réentraîné et réduit pour en faire Bark 3.0 Pro, publié sur Hugging Face le 15 octobre. L'équipe Underdog a écrit l'article de lancement. Les trois modèles de la chaîne sont sous CC-BY-4.0, qui autorise l'usage commercial à condition de citer NVIDIA, Moondream et Conway Research.
Nous l'avons repéré dans la vidéo d'actualité d'AI Search du 25 octobre. L'affirmation qui nous a fait regarder se trouve sur la page du modèle : un taux d'erreur moyen sur les mots de 4,29 % sur l'Open ASR Leaderboard, un classement public de reconnaissance vocale, le plus bas de tous les modèles ouverts selon son propre décompte. Le taux d'erreur sur les mots est la part des mots qu'un modèle transcrit mal, donc plus il est bas, mieux c'est. Ce score est déclaré par les auteurs, et nous n'avons pas essayé de le reproduire. Notre part était plus modeste et plus pratique : empaqueter Bark pour le déploiement, le mettre à côté de Qwen3-ASR sur une même carte et compter les erreurs.
L'écart, c'est surtout "you know"
Nous avons tiré huit extraits de chacun de cinq jeux de test standard : réunions de bureau, conférences de résultats, podcasts, discours au Parlement européen et livres audio. Cela fait presque six minutes et 924 mots. Les deux modèles ont tourné sur notre cloud, via une version de test locale d'InferenceKey, notés avec les mêmes règles.
| Sur nos 40 extraits | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|
| Mots erronés | 6,28 % | 7,03 % |
| Mots omis | 11 | 29 |
| Mots mal entendus | 32 | 28 |
| Taille sur disque | 1 254 MB | 4 699 MB |
Ce sont les lignes du milieu qui racontent l'histoire. Les corrigés humains sont verbatim : ils écrivent ce que les gens ont dit, faux départs compris. Imaginez le bootleg enregistré en concert, toux comprises, face à la version studio. Bark écrit le bootleg. Qwen penche vers la version studio, et la plupart des 29 mots qu'il a omis étaient des hésitations et des répétitions comme "you know", "on, on" et "how, how". Sur les mots réellement mal entendus, Qwen était légèrement devant. L'avance de Bark vient donc du fait qu'il garde ce qui a été dit, pas d'une meilleure oreille.
C'est pour cela que l'avance de Bark était la plus nette sur les réunions et les conférences de résultats, là où les corrigés gardent le plus d'hésitations et de répétitions. Qwen a fait mieux sur les discours parlementaires et les livres audio, et nous n'avons pas trouvé pourquoi.
Assez rapide pour que le réseau soit le maillon lent
Un extrait typique revenait en une demi-seconde, aller-retour réseau compris. Cinq minutes d'audio de conférence de résultats ont pris 2,8 secondes de travail GPU en une seule requête, 4,5 secondes en comptant l'envoi et la réponse, et Bark a renvoyé la transcription complète. Qwen3-ASR a renvoyé 212 mots sur le même fichier et s'est arrêté. Nous n'avons pas cherché pourquoi.
Vient ensuite la partie qui compte si vous choisissez du matériel. Avec Bark seul chargé, la 3090 n'a jamais dépassé environ 2,8 GB sur ses 24 GB. Nous avons plafonné la mémoire que Bark pouvait utiliser pour imiter des cartes plus petites : sous environ 2 GB, tout est passé une fois l'audio long découpé en morceaux de 60 secondes. Et sans aucune carte graphique, quatre threads d'un processeur de serveur ont traité le fichier de cinq minutes en 31 secondes, seize threads en 14. Les transcriptions étaient identiques mot pour mot à celles du GPU sur les 40 extraits.
À qui ça s'adresse
- Les équipes qui transcrivent des réunions, des appels ou des entretiens en anglais et ont besoin de chaque mot tel qu'il a été prononcé. Bark a fait moins d'erreurs verbatim que Qwen3-ASR-1.7B sur nos réunions et nos conférences de résultats.
- Les équipes sans GPU disponible. Quelques threads de processeur traitent un enregistrement plus vite qu'il ne se lit, donc une machine que vous faites déjà tourner peut faire le travail.
- Quiconque veut l'intégrer à un produit. La licence le permet, avec attribution.
Si vous voulez un texte que les gens lisent sans retouche, prévoyez une étape de nettoyage : les auteurs publient à part un Bark 3.0 Clean qui supprime les hésitations, que nous n'avons pas testé. Si votre audio n'est pas en anglais, cherchez ailleurs. Bark ne fait que l'anglais et, selon ses auteurs, n'a pas encore d'horodatage des mots ni de noms de locuteurs.
La limite honnête, une seule fois : 924 mots, c'est un petit échantillon sur un seul vrai GPU, donc lisez le résultat comme "serré, avec Bark devant", pas comme un classement, et considérez les cartes plus petites comme non testées, puisqu'aucun des sept types que nous avons essayé de louer n'était disponible.
Le test complet
L'article Research contient le tableau jeu par jeu, les deux transcriptions de l'extrait de conférence de résultats, l'échelle de mémoire, les essais sur CPU et les deux aspérités que nous avons rencontrées sur la plateforme. Lisez le test complet d'Underdog Bark 3.0 Pro.