Nanbeige4.3-33B auf einer Karte: 42 Token/s auf 24 GB, und auf 16 GB funktioniert nur die 3-Bit-Datei
Ein dichtes 33B-Agentenmodell mit 42 Token/s auf einer RTX 4090. Auf 16 GB läuft die 3-Bit-Datei mit 14 Token/s, die 4-Bit-Datei kriecht mit 1,6.
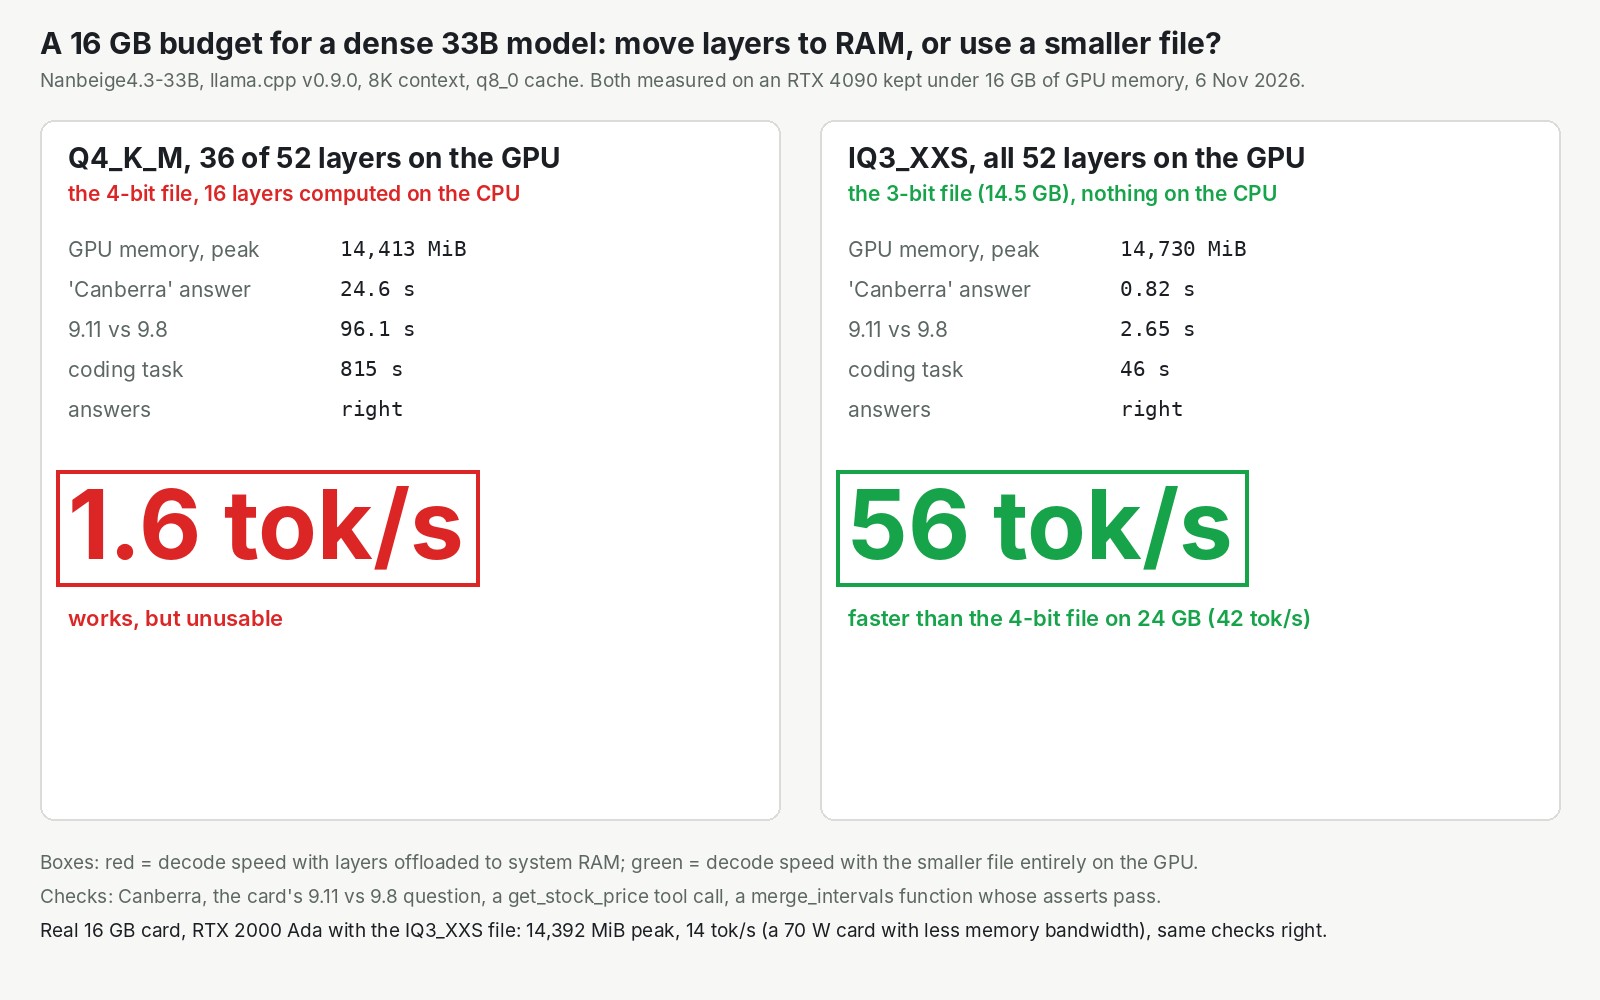
Bei einem dichten Modell schlägt die Datei, die auf die Karte passt, die bessere Datei, die nicht passt. Nanbeige4.3-33B, ein neues Agentenmodell fürs Programmieren unter Apache-2.0, schrieb auf einer einzigen RTX 4090 mit 24 GB in unserer Cloud etwa 42 Token pro Sekunde, mit jedes Mal gültigen Tool-Aufrufen. Unter einem 16-GB-Budget kroch seine 4-Bit-Datei, bei der ein Drittel des Modells von der Karte verdrängt war, mit 1,6 Token pro Sekunde. Die kleinere 3-Bit-Datei, komplett auf der Karte, bestand jede Prüfung, mit etwa 14 Token pro Sekunde auf einer echten 16-GB-Workstation-Karte. Für ein Team, das seine eigenen Modelle betreibt, heißt das: ein offenes Agentenmodell auf einer einzigen Karte, die Sie besitzen oder mieten, und eine klare Regel für die Wahl der Datei. Probieren Sie es auf 24 GB aus, oder auf 16 GB mit der 3-Bit-Datei. Zuerst ein Haken: Mit eingeschaltetem Denkmodus, der Voreinstellung, kam die finale Antwort des Agenten in 2 von 3 Läufen leer zurück.
Ein 33B, bei dem die ganze Band jeden Takt spielt
Die Agentenmodelle, die wir davor getestet haben, etwa Groot-19B und Clover-35B-A3B, nutzen für jedes Wort nur wenige ihrer Parameter: eine große Band, in der in jedem Takt nur ein paar Solisten spielen. Nanbeige4.3-33B ist dicht. Alle 33 Milliarden Parameter arbeiten an jedem Token.
Das hat einen messbaren Preis. Um jedes Wort zu schreiben, liest die Karte die ganze Modelldatei aus ihrem eigenen Speicher. Bei der 4-Bit-Datei sind das 20,8 GB pro Wort. Eine kleinere Datei bedeutet weniger zu lesen und mehr Wörter pro Sekunde. Alles, was außerhalb des Kartenspeichers liegt, wird weit langsamer gelesen, und die Geschwindigkeit bricht ein.
Das Modell erschien am 24. Oktober auf Hugging Face, vom Nanbeige-Team bei BOSS Zhipin. Seine Autoren beanspruchen "state-of-the-art agentic performance among open models in the ~30B parameter class". Unkomprimiert hat es 66 GB, und ihre eigenen Serving-Rezepte verteilen es auf vier GPUs. bartowski hat komprimierte Einzeldatei-Versionen für llama.cpp veröffentlicht, die freie Engine, die wir genutzt haben.
Die Autoren sehen es bei zwei von drei Agenten-Programmiertests vor Qwen3.8-27B, und sie drucken auch die Niederlage ab. Das sind ihre Zahlen, bei maximalem Denkaufwand. Wir haben sie nicht reproduziert.
| Test (Zahlen der Autoren) | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 |
| DeepSWE | 65.5 | 42.5 |
| SWE-Bench Pro | 60.3 | 61.7 |
Was uns eine einzige 24-GB-Karte geliefert hat
Mit der von bartowski empfohlenen 4-Bit-Datei lag das ganze Modell auf der RTX 4090. Es schrieb bei einer einzelnen Anfrage 42 bis 44 Token pro Sekunde, und bei kurzen Prompts kam das erste Token nach einer Viertel- bis einer halben Sekunde zurück.
Unsere Prüfungen waren klein: eine Antwort aus einem Wort, die Frage 9.11 oder 9.8 von der Modellseite, eine Programmieraufgabe mit eigenen Tests und zwei Tool-Aufrufe. Ein Tool-Aufruf bedeutet, dass das Modell Ihren Code bittet, eine Funktion auszuführen, hier eine Aktienkursabfrage und eine Wetterabfrage für zwei Städte gleichzeitig. Der Code bestand seine Tests in 24,6 Sekunden. Jeder Tool-Aufruf kam gültig zurück, im Standardformat von OpenAI.
Dieselbe Karte fasste einen Prompt mit 64K Token, grob 50.000 Wörter, und fand ein geheimes Wort, versteckt bei Token 61.428. Während sich der Prompt füllte, sank die Schreibgeschwindigkeit auf 16 Token pro Sekunde.
Die 16-GB-Regel: kleinere Datei, alles auf der Karte
Die kleinste Karte, die bestanden hat, ist eine echte: eine RTX 2000 Ada, eine Workstation-Karte mit 16 GB und 70 Watt, mit der 3-Bit-Datei von bartowski. Sie bestand dieselben Prüfungen bei etwa einem Drittel der Geschwindigkeit der 4090, eine Antwort mit 400 Token dauert also etwa 30 statt 10 Sekunden.
Die beiden 16-GB-Zeilen im Bild liefen auf der vollen 4090 und blieben in der Spitze unter dem Budget. Lesen Sie sie also als Speicherwerte, nicht als Geschwindigkeitsversprechen. Die Lehre gilt trotzdem: Ein Drittel eines dichten Modells außerhalb der Karte machte aus einem schnellen Modell eines, das für eine Programmieraufgabe 815 Sekunden brauchte. Weiter nach unten passte die 2-Bit-Datei unter 12 GB und beantwortete 9.8 richtig, erklärte aber die Nachkommastelle falsch, und das reicht, um sie von Code fernzuhalten.
Das Problem der leeren Antwort
Mit eingeschaltetem Denkmodus kommen manche Antworten mit leerem Antwortfeld an, und der ganze Text steckt im Denkfeld des Modells. Das traf jeden Aufsatz mit 400 Wörtern, um den wir gebeten haben, und die finale Antwort des Agenten nach den Wetterergebnissen in 2 von 3 Läufen, einmal auf jeder Karte. Die Tool-Aufrufe selbst waren nie betroffen.
Mit ausgeschaltetem Denkmodus in einer Anfrage, die direkt an llama.cpp ging, kam der Aufsatz in der normalen Antwort zurück. Über InferenceKey kommt dieser Schalter pro Anfrage noch nicht durch: Unser Endpoint verwirft ihn. Status: offen auf unserer Seite. Eine Server-Einstellung sollte den Denkmodus für jede Anfrage abschalten, aber wir haben sie nicht ausprobiert, und die Autoren empfehlen, den Denkmodus für Agenten eingeschaltet zu lassen.
Auf InferenceKey brauchte die Plattform keine Änderungen: eine Versionsnummer und ein Startbefehl. Das Deployment war auf der 4090 nach 303,7 Sekunden bereit, fast die ganze Zeit kompilierte der Worker (das kleine Programm auf Ihrer GPU-Maschine, das Aufträge von der Plattform annimmt) llama.cpp für diese GPU. Auf einem gedrosselten 16-GB-Host dauerte derselbe Build 19 Minuten 50 Sekunden.
Modell und Benchmarks sind die Arbeit des Nanbeige-Teams, die komprimierten Dateien die von bartowski, die Engine die der llama.cpp-Maintainer. Unser Teil: das Deployment, die Tests und das SDK-Beispiel.
Für wen das wichtig ist
- Teams mit einer 24-GB-Karte, die ein offenes Agentenmodell fürs Programmieren wollen. Einen Versuch wert. Prüfen Sie die Werte der Autoren an Ihren eigenen Aufgaben.
- Teams mit einer 16-GB-Karte. Nutzen Sie die 3-Bit-Datei komplett auf der Karte, nie die 4-Bit-Datei mit einem Drittel außerhalb.
- Teams, die es heute schon als Agent betreiben. Rechnen Sie mit leeren finalen Antworten bei eingeschaltetem Denkmodus, bis dieser Schalter durchkommt.
Die ehrliche Grenze: Wir haben jeweils eine Anfrage auf unseren eigenen kleinen Prompts laufen lassen, mit einzelnen Tool-Aufrufen und einem Agenten-Zug, nicht einen Agenten, der sich durch eine echte Codebasis arbeitet.
Den vollständigen Test lesen
Der Research-Beitrag enthält die Speicherstufen, jede Zeitmessung und das SDK-Beispiel. Lesen Sie den vollständigen Test von Nanbeige4.3-33B im Research-Beitrag.