Clover-35B-A3B schreibt 208 Token/s auf einer 24-GB-Karte, vorerst als gewöhnliches Modell
Das Diffusions-LLM von DiffuSpace im normalen llama.cpp auf einer RTX 4090: 208 Token/s und 128K Kontext nach einem 17-s-Patch, ohne Parallelmodus.
Zweihundertacht Token pro Sekunde, auf einer einzigen RTX 4090 in unserer Cloud. So viel lieferte uns Clover-35B-A3B-Preview, das offene Diffusions-Sprachmodell von DiffuSpace, im unveränderten llama.cpp v0.9.0, dem Release der freien Engine, das es diese Woche aufgenommen hat. Es las außerdem Prompts bis zu seinem vollen 128K-Fenster (ein kurzer Roman) in 21,4 der 24 GB der Karte. Für ein Team, das seine eigenen Modelle betreibt, heißt das: ein neues offenes Agentenmodell auf einer einzigen Karte, die Sie besitzen oder mieten, und zwar heute. Der Haken steht in den Release Notes: Unterstützt wird nur der "AR mode", Clover schreibt also ein Token nach dem anderen, wie jedes andere Modell. Der Parallel-Trick hinter den 515 Token pro Sekunde von DiffuSpace steckt nicht in diesem Code. Und die offizielle Datei braucht einen 17-Sekunden-Patch, bevor sie irgendetwas Vernünftiges antwortet. Probieren Sie es auf einer 24-GB-Karte für Agentenarbeit aus. Kaufen Sie noch keine Hardware wegen der Diffusionsgeschwindigkeit.
Gebaut, um Blöcke auszufüllen, betrieben wie eine Schreibkraft
Ein gewöhnliches Sprachmodell arbeitet wie eine Schreibkraft: ein Token, dann das nächste, jedes wartet auf das vorherige. Clover wurde darauf trainiert, eher wie jemand zu arbeiten, der ein Kreuzworträtsel löst. Es legt einen Block aus 32 leeren Feldern an, füllt in einem Durchgang jedes Feld, bei dem es sich zu mindestens 95 % sicher ist, und kommt für den Rest zurück. Weniger Durchgänge bedeuten mehr Text pro Sekunde, sofern die Software das Kreuzworträtsel auch löst.
Clover ist das erste Release von DiffuSpace, abgeleitet von Qwen3.6-35B-A3B, einem offenen Modell des Qwen-Teams von Alibaba. Von seinen 35 Milliarden Parametern arbeiten etwa 3 Milliarden an jedem Token: 256 Spezialisten, und jedes Wort fragt 8 davon plus einen Generalisten. Die Lizenz ist Apache-2.0, kommerzielle Nutzung ist also erlaubt.
Der Blog von DiffuSpace meldet 515 Token pro Sekunde auf einer einzelnen H200-Rechenzentrumskarte, gegenüber 365 für ein beschleunigtes Qwen-Modell ähnlicher Größe, und 680 auf einer GB300. Beide Werte stammen vom vollen, unkomprimierten Modell, Software und Modus werden nicht genannt.
Hier liegt die Lücke. Die Unterstützung in llama.cpp, Pull Request #31306 von Maphist0, wurde am 2. November gemergt und am 4. November in v0.9.0 ausgeliefert, im AR mode: die Schreibkraft. Die schnelleren Modi liegen anderswo. Der eigene Python-Code von DiffuSpace braucht allein für die Gewichte etwa 69 GB, also eine 80-GB-Karte. Ein SGLang-Pull-Request von Zirui Wu (#46927) ergänzt einen Modus aus Raten und Prüfen und meldet 453,59 Token pro Sekunde auf einer einzelnen H200, ist aber noch offen und wartet auf ein Review. Wir haben gemessen, was eine einzige Karte heute liefert.
Die offizielle Datei braucht zuerst einen 17-Sekunden-Patch
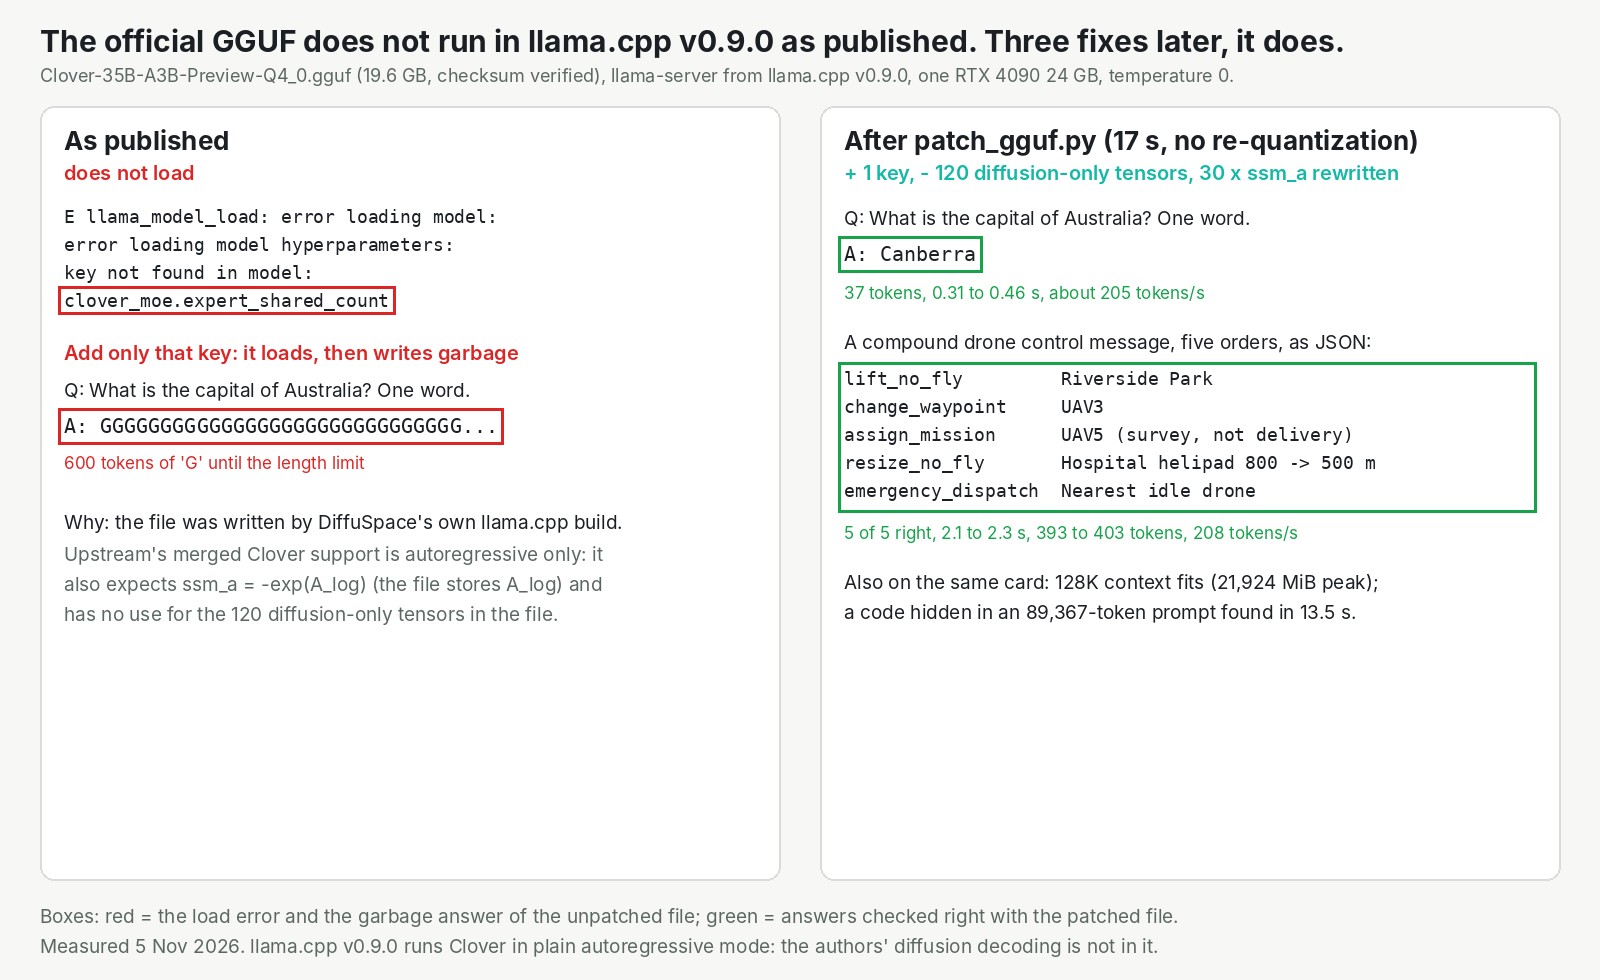
So wie veröffentlicht, verweigert llama.cpp v0.9.0 das Laden der Datei: key not found in model: clover_moe.expert_shared_count. Wir haben nur dieses Label ergänzt. Das Modell lud, und auf die Frage nach der Hauptstadt Australiens antwortete es mit 600 Kopien des Buchstabens G, ein einziger gehaltener Ton wie Gitarren-Feedback.
DiffuSpace hat die Datei mit einem eigenen llama.cpp-Build geschrieben, der sich an drei kleinen Stellen von Upstream unterscheidet. Unser Skript, patch_gguf.py, behebt alle drei und kopiert jedes andere Byte unverändert, es wird also nichts neu komprimiert. Bei der 19,6-GB-Datei dauerte das 17 Sekunden. Danach lautete die Antwort Canberra. Status: in unserem SDK-Beispiel behoben, in den Dateien von DiffuSpace und in llama.cpp noch offen.
Etwa 208 Token pro Sekunde, und das ganze 128K-Fenster passt
Mit der gepatchten Datei schrieb Clover bei einer einzelnen Anfrage 202 bis 211 Token pro Sekunde, und das erste Token kam nach 0,13 bis 0,31 Sekunden zurück.
| Was wir gefragt haben | Was zurückkam | Zeit |
|---|---|---|
| Eine zusammengesetzte Drohnen-Einsatznachricht, fünf Aufträge | 5 von 5 richtig, als sauberes JSON, in jedem Lauf | 2,1 bis 2,3 s |
| "Ist es in Lissabon oder in Oslo wärmer?" mit einem Wetter-Tool | Zwei Tool-Aufrufe gleichzeitig, beide gültig | 1,29 s |
| Ein ganzer Desktop in einer HTML-Datei | Eine funktionierende Seite mit einem Taschenrechner, der 7 x 6 = 42 sagt | 20,3 s |
| Ein Code, versteckt in einem Prompt mit 89.367 Token | Gefunden | 13,45 s |
Die eigene Drohnen-Demo von DiffuSpace brauchte 0,97 Sekunden, auf größerer Hardware in einem nicht genannten Modus: kein Vergleich unter gleichen Bedingungen.
Kleinere Karten funktionierten auch, langsamer. llama.cpp kann einen Teil der Spezialisten im Hauptspeicher des Rechners statt auf der Karte halten. Mit 10 ausgelagerten Schichten davon passte das Modell in 15.456 MiB, ein 16-GB-Budget, und schrieb immer noch etwa 102 Token pro Sekunde. Dieses Budget haben wir auf der 4090 emuliert: ein Speicherwert, kein Geschwindigkeitsversprechen.
Eine raue Stelle: Clover denkt immer nach, bevor es antwortet, und unser Endpoint reicht den Schalter zum Abschalten noch nicht durch (offen auf unserer Seite).
Auf InferenceKey hat sich kein Plattformcode geändert. Wir haben den Worker (das kleine Programm auf Ihrer GPU-Maschine, das Aufträge von der Plattform annimmt) auf llama.cpp v0.9.0 festgelegt. Er hat dieses Release beim ersten Mal in 4 min 50 s gebaut, danach war ein Endpoint in 11,7 Sekunden bereit. Ab dort ist es dieselbe API im OpenAI-Stil wie bei jedem anderen Modell.
Modell und Benchmarks sind die Arbeit von DiffuSpace, die Unterstützung in llama.cpp die von Maphist0, der SGLang-Branch der von Zirui Wu. Unser Teil: der Patch, das Deployment und die Messungen.
Für wen das wichtig ist
- Teams, die ein offenes Agentenmodell auf einer einzigen 24-GB-Karte wollen. Einen Versuch wert. Patchen Sie zuerst die Datei, und vergleichen Sie es auf Ihren eigenen Aufgaben mit seiner Qwen-Basis.
- Teams mit einer 16-GB-Karte. Wahrscheinlich ja, mit Spezialisten im RAM, bei etwa halber Geschwindigkeit.
- Teams, die die Diffusionsgeschwindigkeit aus dem Blog wollen. Heute nicht mit llama.cpp. Beobachten Sie den SGLang-Pull-Request, oder nutzen Sie den Python-Code von DiffuSpace auf einer 80-GB-Karte.
- Teams, die Modelle nach Benchmarks auswählen. Diese Werte stammen vom Hersteller und gelten im Ein-Token-Modus womöglich nicht.
Die ehrliche Grenze: Wir haben die Basis Qwen3.6-35B-A3B nicht auf dieser Karte laufen lassen und keine echte 16-GB-Karte getestet, können also nicht sagen, ob Clover in diesem Modus seine Basis schlägt.
Den vollständigen Test lesen
Der Research-Beitrag enthält die Speicherstufen, jede Zeitmessung und das SDK-Beispiel. Lesen Sie den vollständigen Test von Clover-35B-A3B im Research-Beitrag.