Clover-35B-A3B écrit 208 tokens/s sur une seule carte de 24 GB, comme un modèle ordinaire pour l'instant
Le LLM à diffusion de DiffuSpace dans llama.cpp standard sur une RTX 4090 : 208 tokens/s et 128K de contexte après un patch de 17 s, sans le mode parallèle.
Deux cent huit tokens par seconde, sur une seule RTX 4090 de notre cloud. C'est ce que nous a donné Clover-35B-A3B-Preview, le modèle de langage à diffusion ouvert de DiffuSpace, dans llama.cpp v0.9.0 standard, la version du moteur gratuit qui l'a ajouté cette semaine. Il a aussi lu des prompts jusqu'à sa fenêtre complète de 128K (un court roman) dans 21,4 des 24 GB de la carte. Pour une équipe qui déploie ses propres modèles, cela donne dès aujourd'hui un nouveau modèle ouvert pour agents sur une seule carte que l'on possède ou que l'on loue. Le piège se trouve dans les notes de version : le support est en "AR mode" uniquement, donc Clover écrit un token à la fois, comme n'importe quel autre modèle. L'astuce parallèle derrière les 515 tokens par seconde de DiffuSpace n'est pas dans ce code. Et le fichier officiel a besoin d'un patch de 17 secondes avant de répondre quoi que ce soit de sensé. Essayez-le sur une carte de 24 GB pour du travail d'agent. N'achetez pas encore de matériel pour la vitesse de la diffusion.
Conçu pour remplir des blocs, exécuté comme une dactylo
Un modèle de langage ordinaire travaille comme une dactylo : un token, puis le suivant, chacun attendant celui d'avant. Clover a été entraîné pour travailler plutôt comme quelqu'un qui remplit des mots croisés. Il pose un bloc de 32 cases vides, remplit d'un seul passage toutes celles dont il est sûr à au moins 95 %, et revient pour le reste. Moins de passages, c'est plus de texte par seconde, à condition que le logiciel fasse les mots croisés.
Clover est la première sortie de DiffuSpace, dérivée de Qwen3.6-35B-A3B, un modèle ouvert de l'équipe Qwen d'Alibaba. Sur ses 35 milliards de paramètres, environ 3 milliards travaillent sur chaque token : 256 spécialistes, et chaque mot en consulte 8 plus un généraliste. La licence est Apache-2.0, donc l'usage commercial est permis.
Le blog de DiffuSpace annonce 515 tokens par seconde sur une seule carte de data center H200, contre 365 pour un modèle Qwen accéléré de taille similaire, et 680 sur une GB300. Les deux chiffres viennent du modèle complet non compressé, sans que le logiciel ni le mode soient nommés.
Voici l'écart. Le support dans llama.cpp, la pull request #31306 de Maphist0, a été mergé le 2 novembre et livré dans v0.9.0 le 4 novembre, en AR mode : la dactylo. Les modes plus rapides vivent ailleurs. Le propre code Python de DiffuSpace demande environ 69 GB pour les seuls poids, donc une carte de 80 GB. Une pull request SGLang de Zirui Wu (#46927) ajoute un mode qui devine puis vérifie et annonce 453,59 tokens par seconde sur une seule H200, mais elle est encore ouverte, en attente de revue. Nous avons mesuré ce qu'une seule carte vous donne aujourd'hui.
Le fichier officiel a d'abord besoin d'un patch de 17 secondes
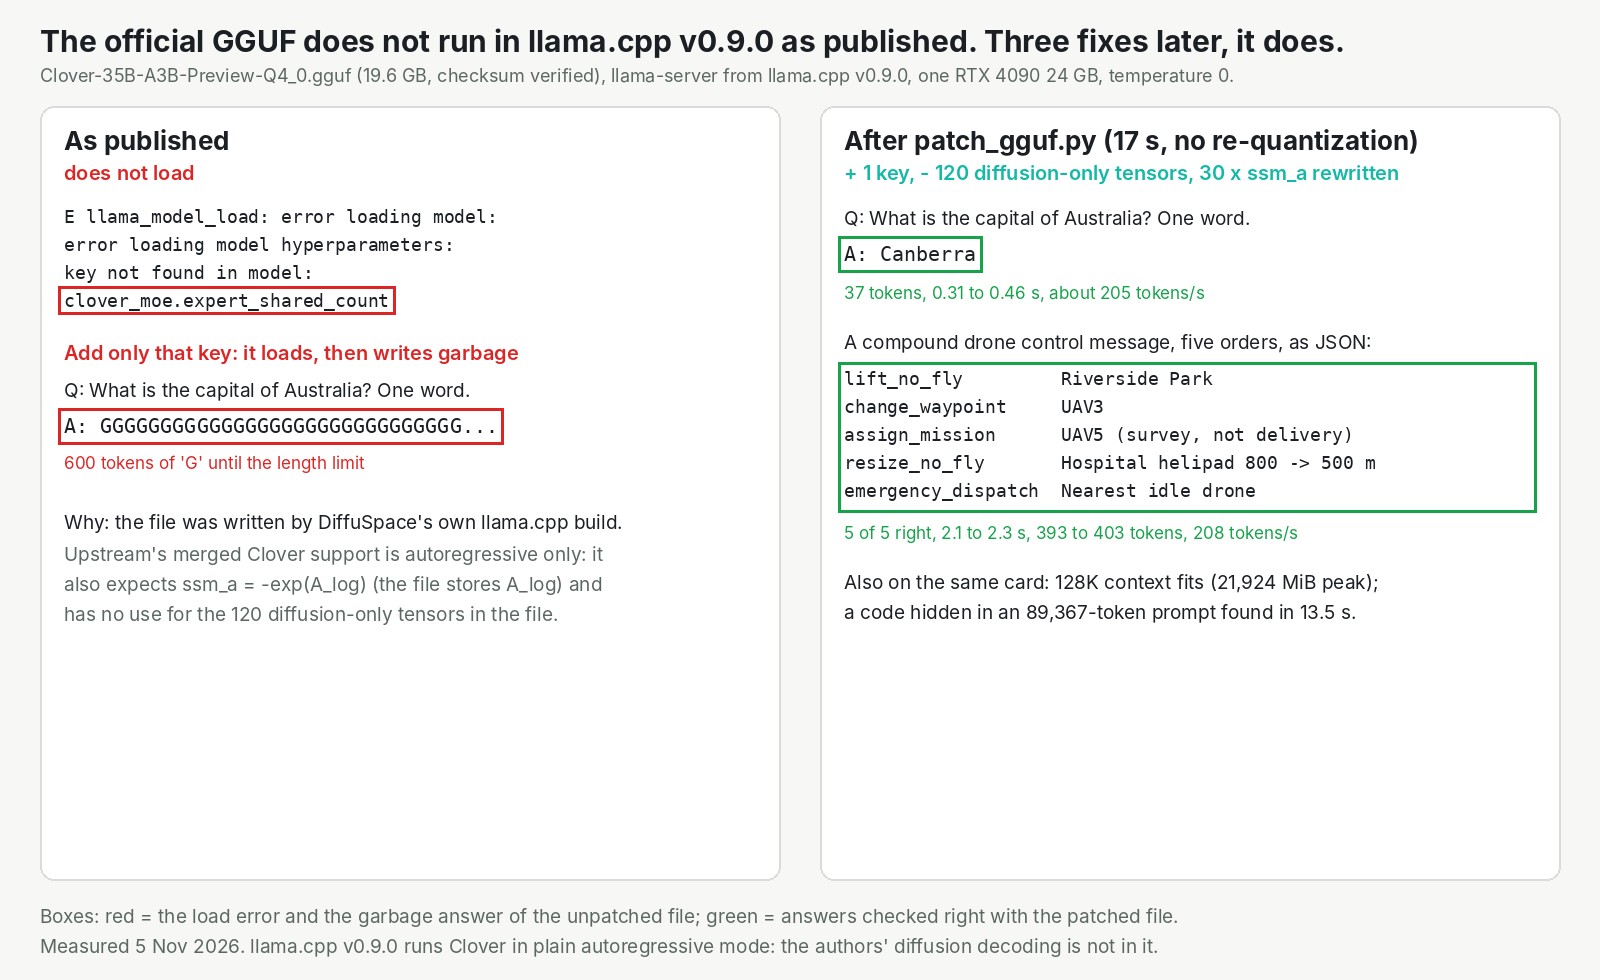
Tel que publié, llama.cpp v0.9.0 refuse de charger le fichier : key not found in model: clover_moe.expert_shared_count. Nous avons ajouté juste cette étiquette. Le modèle s'est chargé et, quand on lui a demandé la capitale de l'Australie, il a répondu par 600 fois la lettre G, une seule note tenue comme un larsen de guitare.
DiffuSpace a écrit le fichier avec son propre build de llama.cpp, qui diffère de l'officiel sur trois petits points. Notre script, patch_gguf.py, corrige les trois et copie tel quel chaque autre octet, donc rien n'est recompressé. Il a pris 17 secondes sur le fichier de 19,6 GB. Ensuite, la réponse était Canberra. Statut : corrigé dans notre exemple du SDK, toujours ouvert dans les fichiers de DiffuSpace et dans llama.cpp.
Environ 208 tokens par seconde, et toute la fenêtre de 128K tient
Avec le fichier patché, Clover a écrit de 202 à 211 tokens par seconde pour une requête, et le premier token est revenu en 0,13 à 0,31 seconde.
| Ce que nous avons demandé | Ce qui est revenu | Temps |
|---|---|---|
| Un message composé de dispatch de drones, cinq commandes | 5 sur 5 justes, en JSON propre, à chaque exécution | 2,1 à 2,3 s |
| "Fait-il plus chaud à Lisbonne ou à Oslo ?" avec un outil météo | Deux appels d'outil en même temps, tous deux valides | 1,29 s |
| Un bureau entier dans un seul fichier HTML | Une page qui fonctionne, avec une calculatrice qui dit 7 x 6 = 42 | 20,3 s |
| Un code caché dans un prompt de 89 367 tokens | Trouvé | 13,45 s |
La démo de drones de DiffuSpace a pris 0,97 seconde, sur du matériel plus gros et dans un mode non nommé : pas une course à armes égales.
Des cartes plus petites ont aussi fonctionné, plus lentement. llama.cpp peut garder une partie des spécialistes dans la mémoire principale de l'ordinateur au lieu de la carte. Avec 10 couches de spécialistes déplacées, le modèle a tenu dans 15 456 MiB, un budget de 16 GB, et a encore écrit environ 102 tokens par seconde. Nous avons émulé ce budget sur la 4090 : un chiffre de mémoire, pas une promesse de vitesse.
Un point rugueux : Clover réfléchit toujours avant de répondre, et notre endpoint ne transmet pas encore l'interrupteur qui désactive cela (ouvert de notre côté).
Sur InferenceKey, aucun code de la plateforme n'a changé. Nous avons fixé le worker (le petit programme sur votre machine GPU qui reçoit les ordres de la plateforme) sur llama.cpp v0.9.0. Il a compilé cette version en 4 min 50 s la première fois, et ensuite un endpoint prêt a pris 11,7 secondes. À partir de là, c'est la même API de style OpenAI que pour tous les autres modèles.
Le modèle et les benchmarks sont le travail de DiffuSpace, le support dans llama.cpp celui de Maphist0, la branche SGLang celle de Zirui Wu. Notre part : le patch, le déploiement et les mesures.
À qui ça s'adresse
- Les équipes qui veulent un modèle ouvert pour agents sur une seule carte de 24 GB. Ça vaut l'essai. Patchez d'abord le fichier, et comparez-le avec sa base Qwen sur vos propres tâches.
- Les équipes avec une carte de 16 GB. Probablement, avec les spécialistes en RAM, à environ la moitié de la vitesse.
- Les équipes qui veulent la vitesse de diffusion du blog. Pas sur llama.cpp aujourd'hui. Surveillez la pull request SGLang, ou utilisez le code Python de DiffuSpace sur une carte de 80 GB.
- Les équipes qui choisissent leurs modèles sur benchmark. Ces scores sont ceux de l'éditeur, et ils peuvent ne pas tenir en mode un token à la fois.
La limite honnête : nous n'avons pas fait tourner la base Qwen3.6-35B-A3B sur cette carte ni testé une vraie carte de 16 GB, donc nous ne pouvons pas dire si Clover dans ce mode bat sa base.
Lisez le test complet
L'article Research contient l'échelle de mémoire, chaque mesure de temps et l'exemple avec le SDK. Lisez le test complet de Clover-35B-A3B dans l'article Research.