Hy-SimulMT suit le rythme de l'orateur sur une seule carte de 48 GB, mais de l'anglais vers le chinois il perd des phrases
L'interprète simultané ouvert de Tencent sur une RTX 6000 Ada de 48 GB : premiers mots après 2,3 à 5,5 s, solide vers l'anglais, inégal vers le chinois.
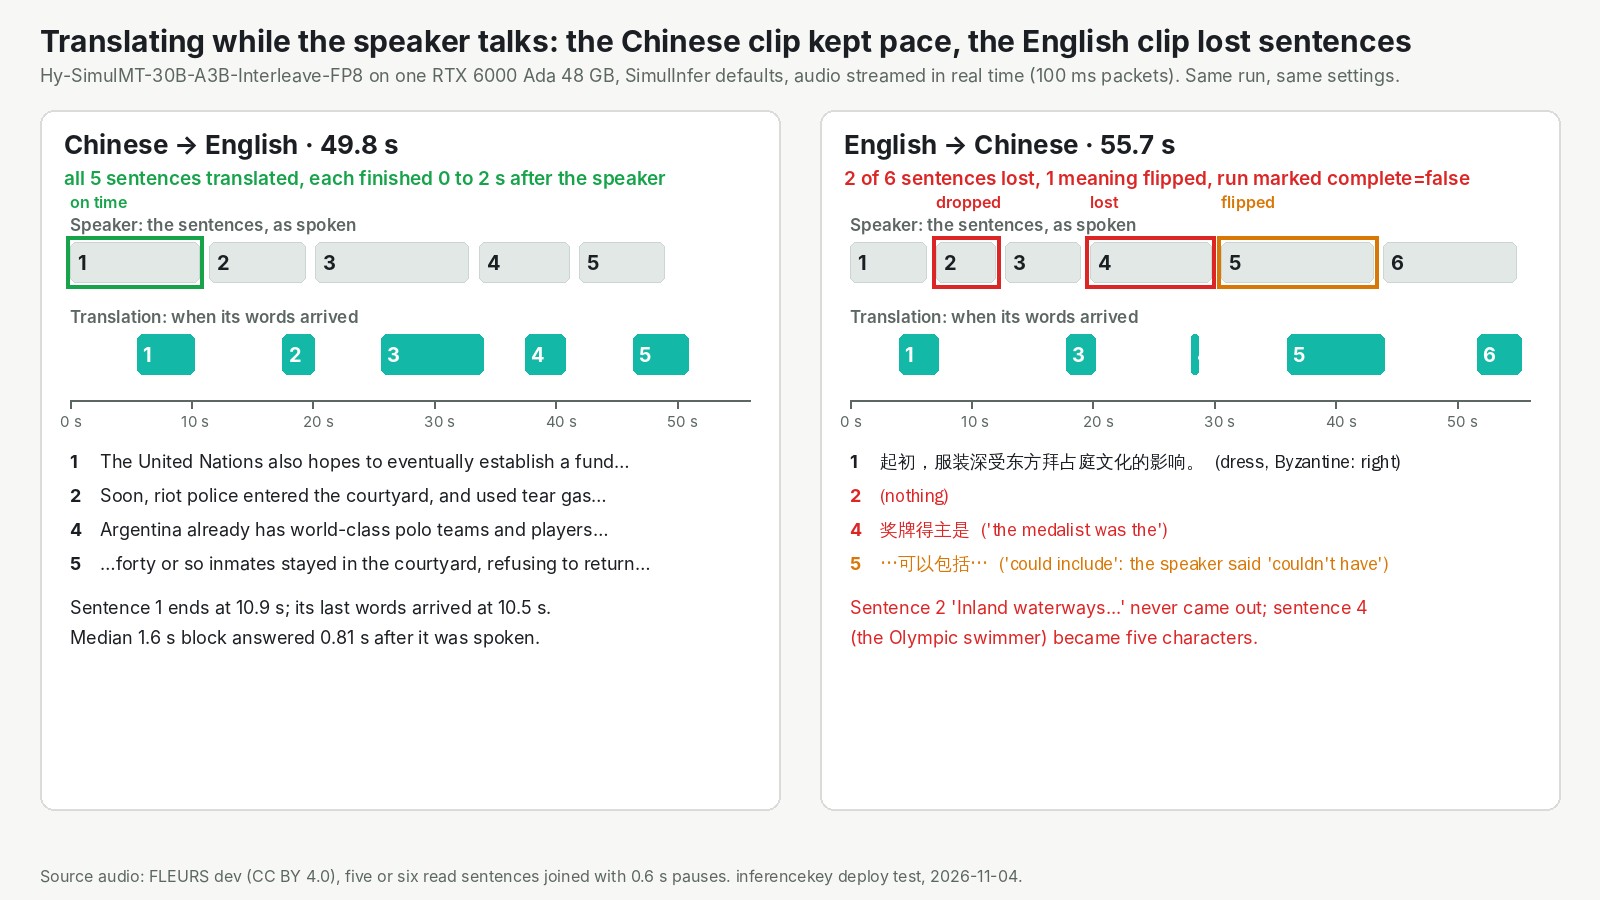
Du chinois en entrée, de l'anglais en sortie : dans notre premier extrait, chaque phrase a été traduite dans les 2 secondes environ après la fin de la phrase de l'orateur. De l'anglais en entrée, du chinois en sortie : un extrait a perdu deux de ses six phrases. Les deux résultats viennent du même montage, Hy-SimulMT, le modèle ouvert de Tencent Hunyuan pour l'interprétation simultanée entre le chinois et l'anglais, sur une seule RTX 6000 Ada de 48 GB de notre cloud. Sur quatre extraits de test, les premiers mots traduits sont arrivés après 2,3 à 5,5 secondes, alors que l'orateur parlait encore. Pour une équipe qui déploie ses propres modèles, cela donne un interprète simultané sur une seule carte que l'on possède ou que l'on loue. L'audio de la réunion et sa traduction n'en sortent jamais. Le modèle a tourné dans 38 GB de la carte, et un clone de la voix de l'orateur a rempli le reste. Utilisez-le dès maintenant du chinois vers l'anglais. Testez l'anglais vers le chinois sur votre propre audio avant que quiconque ne s'y fie.
Un interprète en cabine, pas un relais
La plupart des traductions de la parole fonctionnent en relais : un programme transcrit ce qui a été dit, un second traduit le texte terminé, et le retard grandit à chaque phrase longue.
Hy-SimulMT écoute et traduit dans le même modèle, comme la personne en cabine dans une conférence. Il entend un morceau de parole et décide s'il en a assez pour dire quelque chose. Un petit service des mêmes auteurs, SimulInfer, lui envoie l'audio par tranches de 1,6 seconde et recoud les morceaux.
Tencent Hunyuan l'a publié le 26 octobre sous Apache-2.0, qui autorise l'usage commercial. C'est un modèle de 30B dont seuls 3B paramètres environ travaillent sur chaque mot : une grande équipe de spécialistes, dont une poignée est consultée à chaque mot. Cela le garde rapide, mais la carte doit quand même contenir toute l'équipe. Nous avons testé une version compressée de 32 GB.
Deux limites d'emblée. Il ne fait que du chinois vers l'anglais et de l'anglais vers le chinois, même si sa page de téléchargement liste 40 langues. Et il ne parle pas tout seul : une sortie parlée demande un second modèle, Qwen3-TTS, qui tourne à côté.
Les auteurs indiquent qu'il suivait l'orateur avec environ 3 secondes de retard sur de longs exposés enregistrés, le plus faible de leur comparaison. Nous l'avons repéré dans la vidéo d'actualités d'AI Search du 1er novembre, et nous n'avons pas refait les tests des auteurs.
Il a suivi le rythme dans les deux sens
Nous avons monté quatre extraits de 50 à 56 secondes à partir de FLEURS, un jeu public de phrases lues, et nous avons envoyé chacun en flux par morceaux d'un dixième de seconde, à une vitesse d'élocution normale, comme le ferait un micro. Une tranche d'audio typique recevait sa réponse 0,4 à 0,8 seconde après sa fin, dans les quatre extraits. Dans le premier extrait chinois, la phrase d'ouverture se terminait à 10,9 secondes et sa traduction était déjà complète à 10,5.
| Extrait | Premiers mots | Score de qualité (0 à 100) | Terminé ? |
|---|---|---|---|
| Chinois 1 vers l'anglais | 5,5 s | 60,6 | oui |
| Chinois 2 vers l'anglais | 2,3 s | 51,7 | oui |
| Anglais 1 vers le chinois | 4,4 s | 42,2 | oui |
| Anglais 2 vers le chinois | 4,0 s | 23,4 | non |
Le score mesure à quel point la formulation colle à des traductions humaines. Pour situer, une version plus petite qui a bien traduit chaque phrase du premier extrait chinois a obtenu 66.
La vitesse était régulière, la précision non. L'extrait à 23,4 a perdu entièrement une phrase sur les voies navigables intérieures, et l'a de nouveau abandonnée quand nous avons relancé l'extrait une seconde fois. Un autre a inversé son sens : l'orateur a dit « couldn't have included » et la traduction dit « could include ». Un « could » erroné sonne parfaitement fluide. Envoyé comme un fichier entier, le même extrait est lui aussi revenu incomplet, donc le montage en direct n'est pas la seule cause.
La voix remplit la carte, et une vraie carte de 48 GB est la taille éprouvée
Le clone de voix copie la voix de l'orateur à partir des premières secondes de sa propre parole et lit la traduction avec. Il tourne sous la forme de Qwen3-TTS-0.6B, de l'équipe Qwen d'Alibaba, sur la même carte. Sur le premier extrait chinois, la première parole en anglais est sortie après 8,7 secondes, et le texte a gardé son rythme. La mémoire utilisée de la carte est passée de 38 GB à 48 GB. De l'anglais vers le chinois avec la voix activée, il n'a jamais répondu. Statut : ouvert, pas étudié.
Les cartes moins chères ne sont pas éprouvées. Sous une limite simulée de 32 GB, il a traduit les deux extraits de test au même rythme en direct, mais le démarrage prend brièvement toute la carte à chaque passage, donc une vraie carte de 32 GB peut échouer au démarrage. La version 4 bits des auteurs a tourné dans environ 21 GB, pour des fichiers terminés uniquement.
Sur InferenceKey, ce modèle demande plus qu'un simple serveur de modèles, donc nous avons écrit du code Python qui l'installe avec SimulInfer et lance les deux. Un premier déploiement sur une machine neuve était prêt en 6 minutes environ, un redémarrage en 73 secondes. SimulInfer ne reconnaissait pas la version compressée, donc notre code écrit le petit fichier qu'il cherche. Statut : corrigé dans notre exemple. Une limite vient de nous : notre API accepte un fichier envoyé d'une minute environ au maximum et le lit à vitesse d'élocution, donc un micro en direct ne peut pas encore passer par elle. Statut : ouvert.
Le modèle, SimulInfer et les benchmarks sont le travail de Tencent Hunyuan. Notre part : le déploiement, le banc de streaming et les mesures.
À qui ça sert
- Les équipes qui ont besoin d'un chinois vers anglais en direct sur leur propre matériel. C'est une option ouverte solide sur une seule carte de 48 GB.
- Les équipes qui ont besoin de l'anglais vers le chinois. Testez-le d'abord sur votre propre audio, et surveillez les négations inversées.
- Les équipes qui veulent aussi la voix de l'orateur. Prévoyez la carte de 48 GB entière et, pour l'instant, le sens chinois vers anglais uniquement.
- Les équipes qui ont besoin de toute autre langue. Ce n'est pas votre modèle.
La limite honnête : quatre extraits lus, une session à la fois, donc les longs exposés, la parole spontanée, les accents et les salles bruyantes restent à tester.
Lisez le test complet
L'article Research contient les chronologies, l'échelle de mémoire, chaque point faible et l'exemple avec le SDK pour votre propre GPU. Lisez le test complet de Hy-SimulMT dans l'article Research.