Hy-SimulMT sigue el ritmo del orador en una sola tarjeta de 48 GB, pero del inglés al chino se deja frases
El intérprete simultáneo abierto de Tencent en una RTX 6000 Ada de 48 GB: primeras palabras entre 2,3 y 5,5 s, sólido al inglés, irregular al chino.
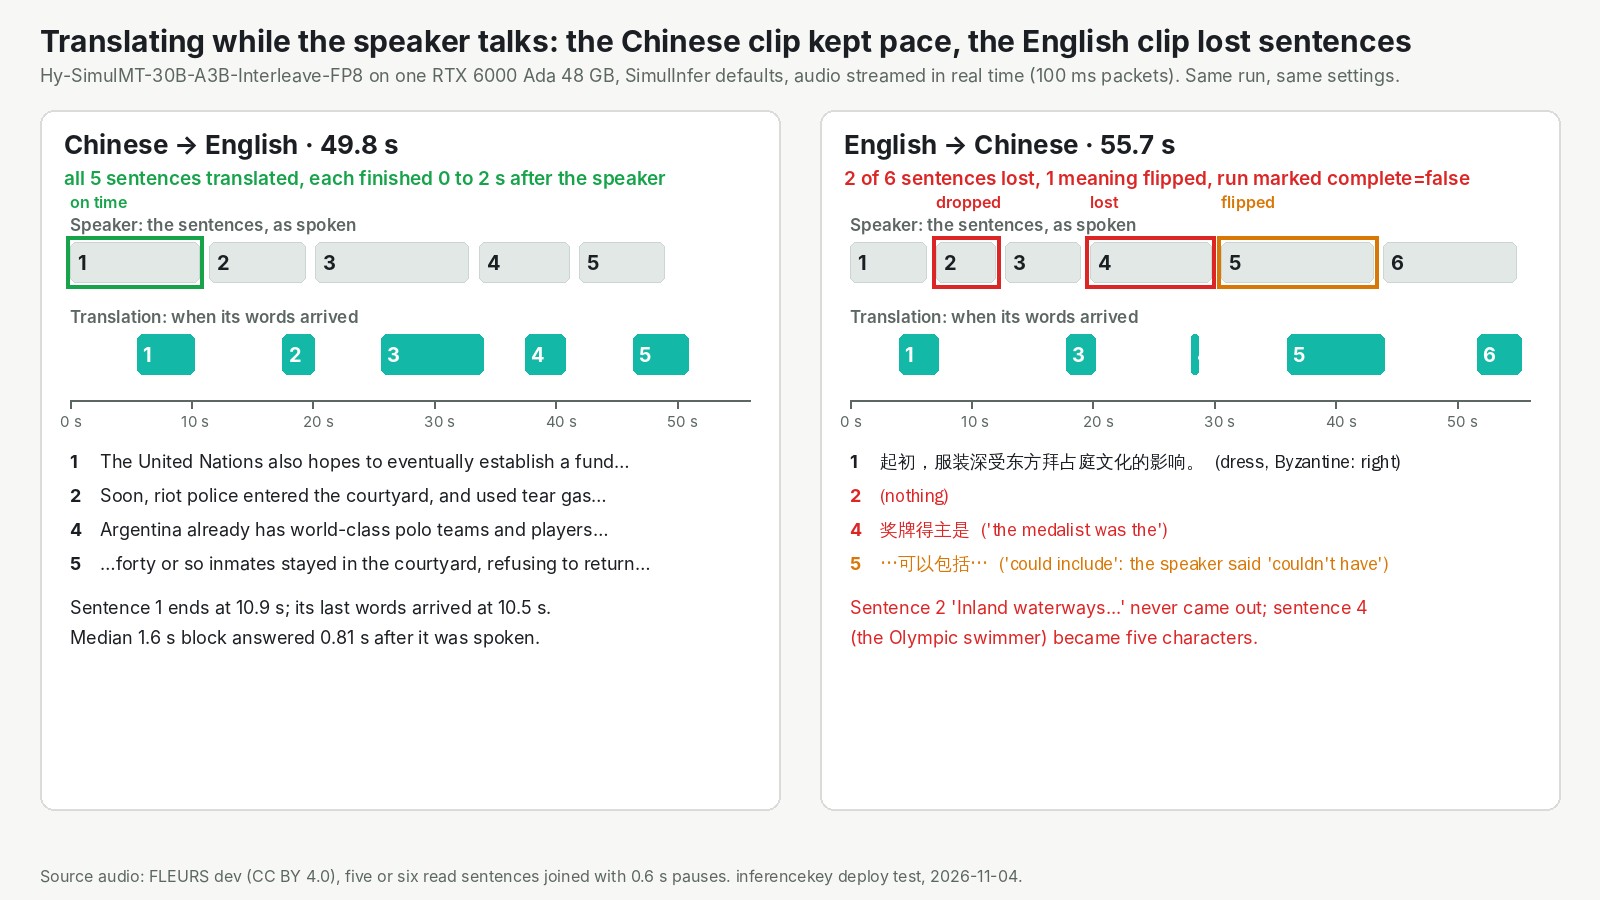
Chino de entrada, inglés de salida: en nuestro primer clip, cada frase quedó traducida unos 2 segundos después de que el orador la terminara, como mucho. Inglés de entrada, chino de salida: un clip perdió dos de sus seis frases. Los dos resultados salen del mismo montaje, Hy-SimulMT, el modelo abierto de Tencent Hunyuan para interpretación simultánea entre chino e inglés, en una sola RTX 6000 Ada de 48 GB de nuestra nube. En los cuatro clips de prueba, las primeras palabras traducidas llegaron entre los 2,3 y los 5,5 segundos, con el orador todavía hablando. Para un equipo que despliega sus propios modelos, eso es un intérprete simultáneo en una sola tarjeta que puedes tener en propiedad o alquilar. El audio de la reunión y su traducción no salen de ella. Funcionó con 38 GB de la tarjeta, y un clon de la voz del orador ocupó el resto. Úsalo ya del chino al inglés. Del inglés al chino, pruébalo con tu propio audio antes de que nadie dependa de él.
Un intérprete en la cabina, no un relevo
La mayoría de la traducción de voz funciona como un relevo: un programa escribe lo que se ha dicho, un segundo traduce el texto terminado, y el retraso crece con cada frase larga.
Hy-SimulMT escucha y traduce en el mismo modelo, como la persona de la cabina en un congreso. Oye un trozo de habla y decide si tiene bastante para decir algo. Un pequeño servicio de los mismos autores, SimulInfer, le pasa el audio en trozos de 1,6 segundos y une las piezas.
Tencent Hunyuan lo publicó el 26 de octubre con licencia Apache-2.0, que permite el uso comercial. Es un modelo de 30B en el que solo unos 3B parámetros trabajan en cada palabra: un equipo grande de especialistas, de los que se consulta a un puñado por palabra. Eso lo hace rápido, pero la tarjeta sigue teniendo que guardar el equipo entero. Probamos una versión comprimida de 32 GB.
Dos límites por delante. Solo hace chino a inglés e inglés a chino, aunque su página de descarga enumera 40 idiomas. Y no habla por sí solo: para la salida hablada hace falta un segundo modelo, Qwen3-TTS, funcionando a su lado.
Los autores dicen que en charlas largas grabadas iba unos 3 segundos por detrás del orador, el retraso más bajo de su comparativa. Lo vimos en el vídeo de noticias de AI Search del 1 de noviembre, y no repetimos las pruebas de los autores.
Siguió el ritmo en los dos sentidos
Montamos cuatro clips de 50 a 56 segundos a partir de FLEURS, un conjunto público de frases leídas, y enviamos cada uno en trozos de una décima de segundo a velocidad normal de habla, como lo haría un micrófono. Un trozo de audio típico tenía respuesta entre 0,4 y 0,8 segundos después de terminar, en los cuatro clips. En el primer clip en chino, la frase inicial terminó a los 10,9 segundos y su traducción ya estaba completa a los 10,5.
| Clip | Primeras palabras | Puntuación de calidad (0 a 100) | ¿Terminó? |
|---|---|---|---|
| Chino 1 al inglés | 5,5 s | 60,6 | sí |
| Chino 2 al inglés | 2,3 s | 51,7 | sí |
| Inglés 1 al chino | 4,4 s | 42,2 | sí |
| Inglés 2 al chino | 4,0 s | 23,4 | no |
La puntuación mide cuánto se parece la redacción a traducciones humanas. Como referencia, una versión más pequeña que acertó todas las frases del primer clip en chino sacó un 66.
La velocidad fue constante, la precisión no. El clip del 23,4 perdió entera una frase sobre vías navegables interiores, y volvió a saltársela cuando repetimos el clip. Otro invirtió el sentido: el orador dijo "couldn't have included" y la traducción dice "could include". Un "could" equivocado suena perfectamente fluido. Subido como fichero completo, el mismo clip también volvió incompleto, así que el montaje en directo no es la única causa.
La voz llena la tarjeta, y una tarjeta real de 48 GB es el tamaño probado
El clon de voz copia la voz del orador a partir de sus primeros segundos de habla y lee la traducción con ella. Funciona como Qwen3-TTS-0.6B, del equipo Qwen de Alibaba, en la misma tarjeta. En el primer clip en chino, la primera frase hablada en inglés salió a los 8,7 segundos, y el texto mantuvo su ritmo. La memoria ocupada de la tarjeta pasó de 38 GB a 48 GB. Del inglés al chino con la voz activada, no llegó a responder nunca. Estado: abierto, sin investigar.
Las tarjetas más baratas están sin probar. Con un límite emulado de 32 GB tradujo los dos clips de prueba al mismo ritmo en directo, pero el arranque ocupa un momento la tarjeta entera en cada ejecución, así que una tarjeta real de 32 GB puede fallar al arrancar. La versión de 4 bits de los autores funcionó con unos 21 GB, solo para ficheros completos.
En InferenceKey, este modelo necesita algo más que un servidor de modelos normal, así que escribimos código Python que lo instala con SimulInfer y arranca los dos. Un primer despliegue en una máquina recién arrancada estuvo listo en unos 6 minutos, y un reinicio en 73 segundos. SimulInfer no reconocía la versión comprimida, así que nuestro código escribe el pequeño fichero que busca. Estado: resuelto en nuestro ejemplo. Un límite es nuestro: nuestra API acepta un fichero subido de hasta un minuto, más o menos, y lo reproduce a velocidad de habla, así que un micrófono en directo todavía no puede pasar por ella. Estado: abierto.
El modelo, SimulInfer y los benchmarks son obra de Tencent Hunyuan. Lo nuestro fue el despliegue, el sistema de envío en streaming y las mediciones.
A quién le interesa
- Equipos que necesitan chino a inglés en directo en hardware propio. Es una opción abierta sólida en una sola tarjeta de 48 GB.
- Equipos que necesitan inglés a chino. Pruébalo antes con tu propio audio, y vigila las negaciones invertidas.
- Equipos que también quieren la voz del orador. Cuenta con la tarjeta de 48 GB entera y, por ahora, solo con el sentido chino a inglés.
- Equipos que necesitan cualquier otro idioma. Este no es tu modelo.
El límite honesto: cuatro clips leídos, una sesión cada vez, así que las charlas largas, el habla espontánea, los acentos y las salas con ruido siguen sin probar.
La prueba completa
El post de Research tiene las líneas de tiempo, la escalera de memoria, cada punto flojo y el ejemplo del SDK para tu propia GPU. Lee la prueba completa de Hy-SimulMT en el post de Research.