Groot-19B-A3B aguanta un prompt de 205K tokens en una sola RTX 5090, con menos de 600 MiB de margen
Groot-19B-A3B FP8 en una RTX 5090 de 32 GB: la ventana entera de 262.144 tokens, de 262 a 304 tokens/s, y no arranca con un tope de 24 GB.
Doscientos cinco mil tokens de prompt, una sola RTX 5090 y menos de 600 MiB de memoria libres. Eso es Groot-19B-A3B, un nuevo modelo abierto para agentes de GrootTeam, funcionando con su ventana completa de 262.144 tokens (los "256K") en una sola tarjeta de 32 GB de nuestra nube. Usamos la versión comprimida de 20,9 GB de los autores (FP8) sobre vLLM sin modificar. Encontró una frase que escondimos al 60 % de ese prompt. Escribió de 262 a 304 tokens por segundo con una sola petición, y sus llamadas a herramientas volvieron como JSON limpio. Para un equipo que despliega sus propios modelos, eso es un agente con una ventana de un cuarto de millón de tokens en una sola tarjeta de gama gaming que puedes tener en propiedad. La pega es el tamaño de la tarjeta. Cuando limitamos la misma GPU a 24 GB, vLLM se negó a arrancar, con sitio para unos 9.600 tokens. Cuenta con 32 GB.
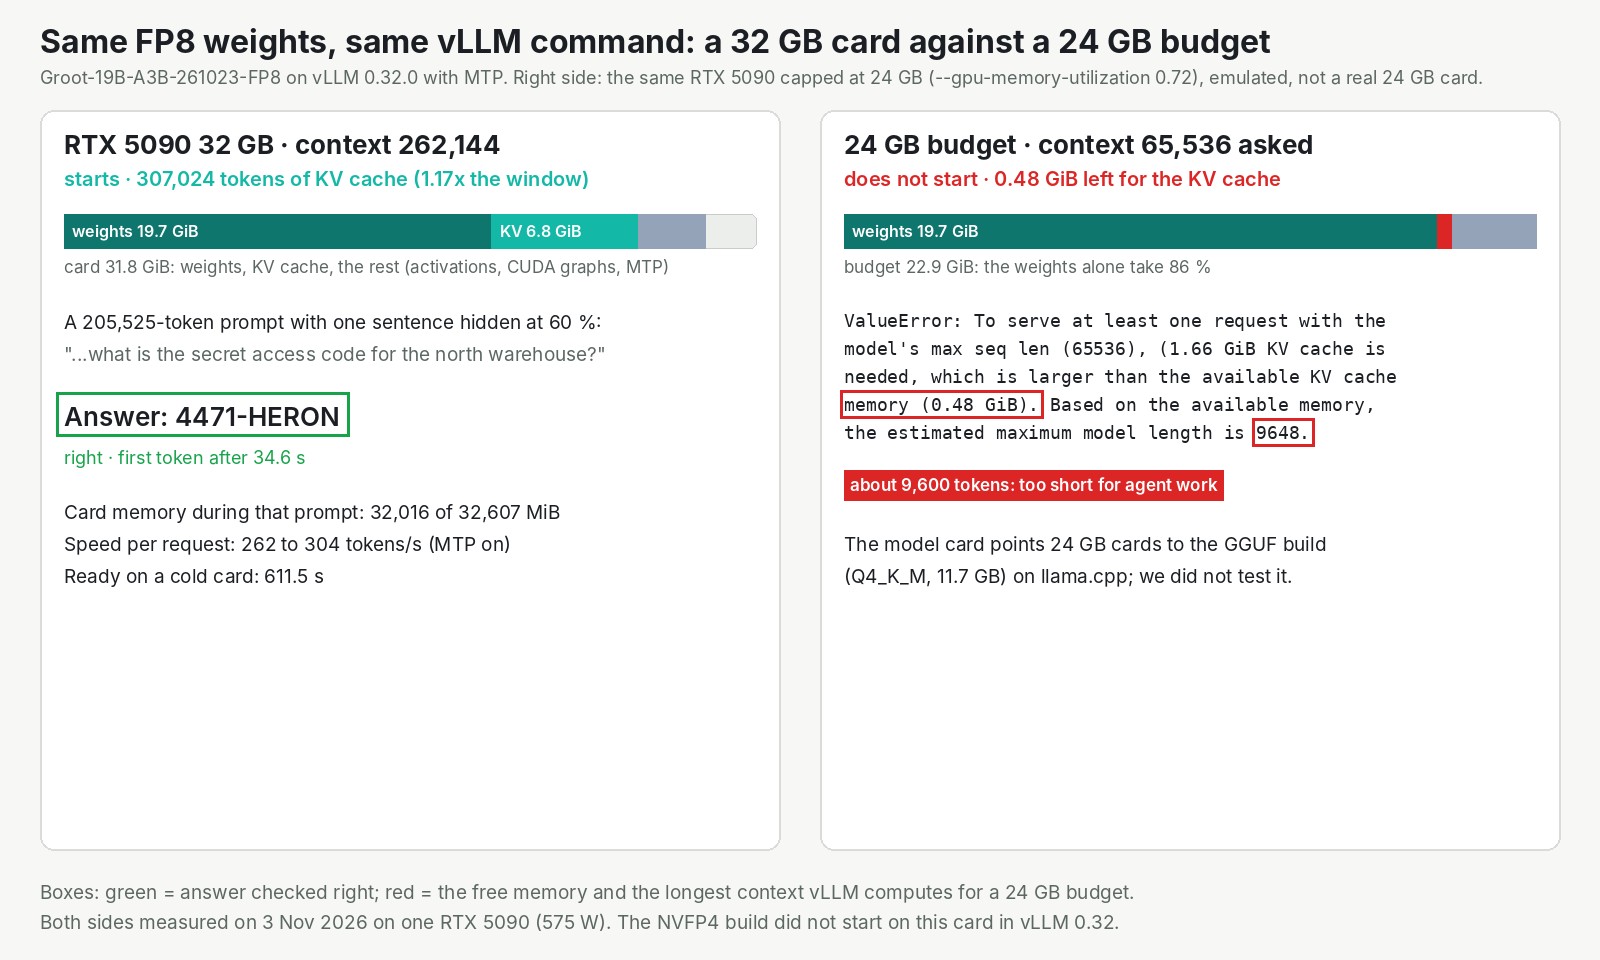
Mismos pesos, mismo comando, misma tarjeta. Con los 32 GB enteros respondió bien a un prompt de 205.525 tokens. Limitada a 24 GB, no arrancó.
Un modelo para agentes de 19B recortado de un padre de 35B
GrootTeam partió de Qwen3.6-35B-A3B, el modelo abierto de 35B del equipo de Qwen, y lo recortó a 19B. La página de los autores no dice cómo. Lo reentrenaron para agentes con una pequeña cantidad de datos abiertos, menos de 100 millones de tokens. Publicaron cuatro versiones el 23 de octubre, y lo vimos en el vídeo de noticias de AI Search del 1 de noviembre.
Funciona como un equipo grande en el que solo unos pocos especialistas se ocupan de cada palabra. Unos 3B de sus 19B parámetros trabajan en cada una. Así que escribe rápido, pero la GPU tiene que guardar los 19B enteros.
Los autores lo ponen por delante de su propio padre. En su tabla supera a Qwen3.6-35B-A3B y a Gemma-4-26B-A4B en 12 de 16 benchmarks. En Terminal-Bench 2.1, donde un agente trabaja en una línea de comandos, dan 52,1 frente a 43,8 y 26,5. Son sus cifras, y solo frente a modelos abiertos de su tamaño; no las reprodujimos. La etiqueta de licencia dice Apache-2.0, que permite el uso comercial, aunque falta el fichero LICENSE enlazado.
El modelo es obra de GrootTeam. Lo nuestro fue el despliegue, las pruebas y las mediciones.
La ventana completa entra en 32 GB, y 24 GB no bastan
Los autores calculan, a partir de los tamaños de memoria, que esta versión funciona con el contexto completo de 256K en una sola RTX 5090. Así que fuimos directos a esa tarjeta.
La memoria de una GPU paga dos cosas. Una son los pesos del modelo, un coste fijo. La otra es un bloc de notas que guarda la conversación, y crece con cada token de contexto. Groot mantiene la estructura de Qwen3.6, así que su bloc de notas sigue siendo tan pequeño como el de su padre. Lo que libera sitio son los pesos, 19B en vez de 35B.
En la tarjeta de 32 GB, a vLLM le quedaron 6,8 GiB para el bloc de notas después de cargar los pesos. Eso da para 307.024 tokens: la ventana completa y unos 45.000 de sobra. Después, la prueba de la frase escondida. Enterramos el código de acceso de un almacén al 60 % de un prompt de 205.525 tokens. El modelo devolvió 4471-HERON. La primera palabra llegó a los 34,6 segundos y la respuesta completa a los 40,3. En el pico, la tarjeta ocupaba 32.016 de sus 32.607 MiB. Imagina una furgoneta de gira con el amplificador encajado contra la puerta: rueda, pero no entra nada más.
| Presupuesto de memoria en la misma RTX 5090 | Qué pasó |
|---|---|
| 32 GB, la tarjeta real, 262.144 tokens | arrancó; el prompt de 205.525 tokens, respondido bien |
| 24 GB, emulados, 65.536 tokens pedidos | no arrancó; 9.648 tokens como máximo |
| 16 GB, emulados, la versión de 13,5 GB | no arrancó; un fallo de software al arrancar |
Con el tope de 24 GB, solo los pesos se llevaron el 86 % del presupuesto. Eso dejó 0,48 GiB para el bloc de notas. Unos 9.600 tokens se quedan cortos para un agente que lee ficheros y resultados de herramientas, y los propios autores recomiendan mantener al menos 128K. La ejecución de 16 GB falló por un motivo de software, no por falta de memoria, así que no dice nada, ni a favor ni en contra, de lo que afirman los autores para esa versión. Los dos topes se emularon en la misma 5090, no en tarjetas reales más pequeñas.
Llamadas a herramientas rápidas y limpias, y un largo razonamiento antes de cada respuesta
Una petición a través de nuestra API fue a entre 262 y 304 tokens por segundo. Una respuesta de 4.457 tokens tardó unos 17 segundos, y empezó a llegar en menos de un segundo. Parte de esa velocidad viene de una pequeña capa extra que incluyen los autores. Con esa capa desactivada, vLLM escribió de 170 a 211 tokens por segundo.
Las llamadas a herramientas funcionaron a la primera. Al preguntarle si hacía más calor en Lisboa o en Oslo, llamó a nuestra herramienta del tiempo para las dos ciudades en un solo turno y luego respondió: "Lisbon is warmer right now with 19°C compared to Oslo's 4°C". Todo el intercambio tardó 1,81 segundos, con la forma que espera un framework de agentes.
Cuenta con el razonamiento. Groot razona antes de cada respuesta, y ese razonamiento cuenta como salida. "La capital de Australia, en una palabra" le llevó de 111 a 131 tokens antes de "Canberra". Los autores desactivan el razonamiento con un ajuste por petición, y nuestra API todavía no deja pasar ese ajuste. Estado: abierto por nuestra parte. La solución provisional es arrancar el servidor con el razonamiento desactivado por defecto, un flag de una línea que aparece en el README de nuestro ejemplo.
En InferenceKey no hizo falta un motor a medida: el backend estándar de vLLM y los ajustes de los autores. Estuvo listo 611,5 segundos después de la llamada de despliegue en una máquina recién arrancada.
A quién le interesa
- Equipos que quieren un contexto largo en hardware propio. Una sola RTX 5090 de 32 GB funcionó con la ventana completa a esta velocidad. Un agente tiene la ventana completa; varios agentes a la vez tienen que conformarse cada uno con una más corta.
- Equipos con tarjetas de 24 GB. Olvídate de la versión de 20,9 GB. Los autores proponen la de 11,7 GB, que no probamos.
- Equipos que necesitan respuestas de chat rápidas. Cuenta con el razonamiento que llega antes de cada respuesta y pon un límite de tokens generoso.
El límite honesto: una GPU, una petición cada vez, nuestros propios prompts y unas pocas ejecuciones de cada cosa, así que esto comprueba que entra y lo rápido que va, no lo bien que se desenvuelve en una sesión de agente de varios pasos.
La prueba completa
El post de Research tiene las cifras de memoria, las pruebas de velocidad, los benchmarks de los autores, cada punto flojo con su estado y el ejemplo del SDK para tu propia GPU. Lee la prueba completa de Groot-19B-A3B en el post de Research.