Unlimited OCR 2 procesa un PDF entero en una sola llamada, y un ajuste decide si te puedes fiar del resultado
Unlimited OCR 2 leyó una guía de 59 páginas en 3 min 44 s, a un 4,2 % de su texto, sin recortes de página. Con recortes: 38,1 %.
Mismo modelo, misma tarjeta, las mismas 59 páginas. Con el ajuste de imagen que traen los autores por defecto, la ejecución tardó 6 min 45 s y el resultado se alejó un 38,1 % del propio texto del PDF. Cambiando un solo flag, crop_mode=false, tardó 3 min 44 s y se alejó un 4,2 %. El modelo es Unlimited OCR 2, un parser de documentos que Baidu publicó con licencia MIT. Recibe un PDF entero en una sola petición en vez de página a página, así que el texto que cruza un salto de página puede seguir unido. Si conviertes PDFs en datos para un buscador o un asistente, eso es justo lo que las herramientas de página a página hacen mal. Lo que puedes hacer con él: procesar informes y manuales largos en una sola tarjeta de 16 GB, siempre que desactives los recortes de página.
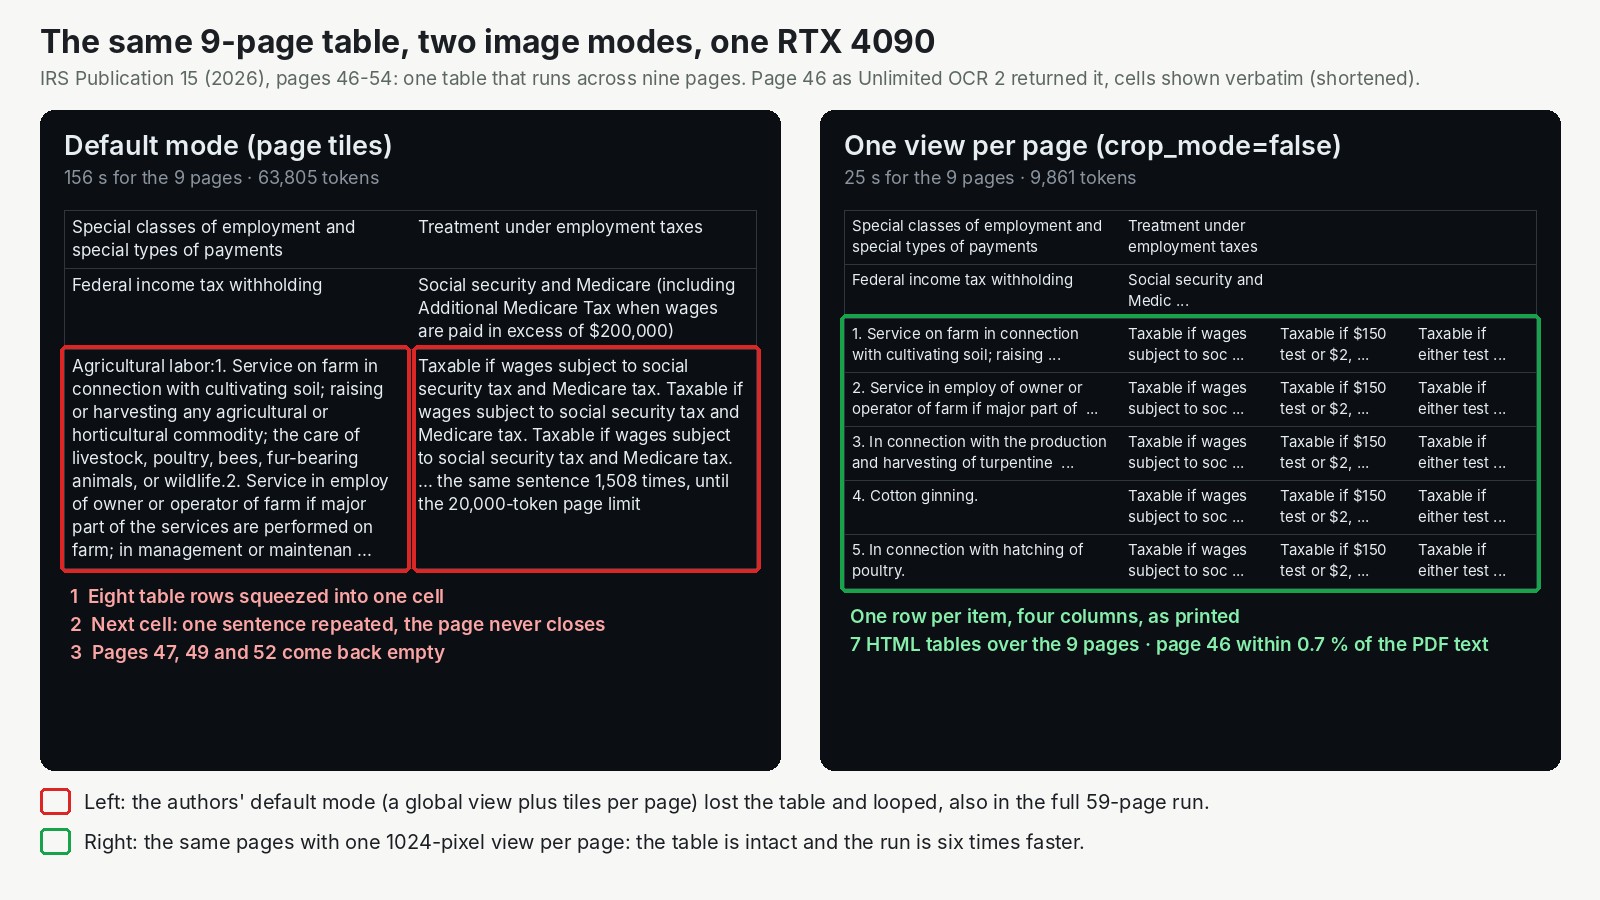
Solo las páginas 46 a 54, una tarjeta. A la izquierda, los recortes por defecto. A la derecha, una vista por página: seis veces más rápido y sin frase repetida.
Un parser que lee un documento, no un montón de páginas
La mayoría de las cadenas de procesado de PDF parten el fichero en páginas, leen cada una por separado y vuelven a pegar el texto. Todo lo que cruza un salto de página se corta. Una tabla que ocupa dos páginas se convierte en dos tablas, y la segunda no tiene cabecera.
Unlimited OCR 2 lee varias páginas juntas. Enseñarle a un modelo muchas páginas a la vez suele salir caro, porque cada página es una imagen. El truco de Baidu, según la ficha del modelo, es mantener a la vista solo un número fijo de trozos de imagen, sea cual sea la longitud del documento. Según los autores, cada palabra nueva cuesta más o menos lo mismo en la página 3 que en la 300.
El modelo es pequeño: 6,7 GB en disco. La licencia permite el uso comercial. El mérito es del equipo de Baidu, liderado por los colaboradores principales Shu Wei, Jingjing Wu y Qunyi Xie, que partieron de su primer Unlimited OCR y de DeepSeek-OCR. También publicaron una versión parcheada de SGLang, el framework abierto de servicio de modelos, con una receta completa. Lo nuestro fue empaquetar ese servidor detrás de una API y probarlo con un documento real.
Lo que encontró nuestra prueba
La Publicación 15 del IRS, la guía fiscal para empleadores de Estados Unidos, tiene 59 páginas, es de dominio público, tiene párrafos que cruzan el salto de página en casi todas las páginas y una tabla que va de la página 46 a la 52. Enviamos el PDF entero en una sola petición a una RTX 4090, una tarjeta gaming de 24 GB de nuestra nube, y comparamos la salida con la capa de texto del propio PDF: el porcentaje de caracteres que habría que cambiar, donde 0 % significa idéntico.
El ajuste que importa es cómo se le enseña cada página al modelo. El modo por defecto corta cada página en recortes ampliados, además de una imagen general. crop_mode=false enseña solo la imagen general.
| PDF de 59 páginas, una petición | Recortes de página (por defecto) | Una vista por página |
|---|---|---|
| RTX 4090, documento entero | 6 min 45 s | 3 min 44 s, 15,8 páginas/min |
| Distancia al texto del PDF | 38,1 % | 4,2 % |
| RTX 2000 Ada 16 GB, tarjeta real | no se ejecutó con las 59 páginas | unos 10 minutos y medio, 4,23 % |
En el texto corrido los dos modos lo hicieron bien: quitando las páginas de la tabla, ambos se quedaron en torno a un 2,4 % de distancia, dos o tres caracteres de cada cien. La diferencia está en la tabla. En el modo de recortes, la página 46 metió ocho filas en una sola celda y luego escribió una frase, "Taxable if wages subject to social security tax and Medicare tax", 1.508 veces. Como un pedal de loop que nadie apagó. Las páginas 47, 50 y 52 volvieron vacías. Al enviar solas las páginas 46 a 54 entró en el mismo bucle, así que es un comportamiento del modelo, no un accidente de memoria.
Con una vista por página, la tabla volvió como HTML en siete trozos, uno por página. La diferencia con un parser de página a página son las etiquetas: cinco de las seis uniones llevan una etiqueta que marca el trozo como continuación. Esas etiquetas son lo que necesita un programa para volver a coserla en una sola.
Una tarjeta pequeña aguanta. Una RTX 2000 Ada real, una tarjeta de estación de trabajo de 16 GB que consume 70 vatios, leyó la guía entera con una vista por página a 5,6 páginas por minuto, con un pico de 13,8 GB. Su calidad igualó la de la 4090.
A quién le interesa
- Equipos que procesan informes, manuales o contratos largos en los que tablas y párrafos cruzan páginas. Una petición por documento devuelve texto, posiciones y etiquetas entre páginas, con una licencia que permite el uso comercial.
- Cualquiera con tablas largas. Pon
crop_mode=falsey después revisa las cifras de las páginas de la tabla: cinco de ellas seguían entre un 20 % y un 46 % de distancia. - Quien mantenga los recortes activados. Deja las ventanas de 10 páginas que vienen por defecto y cuenta las páginas que vuelven. En el modo de recortes, una sola ventana para todo el documento se quedó sin espacio y se paró a mitad de la página 27 sin dar ningún error.
- Equipos con tarjetas pequeñas. Con 16 GB bastó para un documento como el nuestro.
En InferenceKey no hay soporte listo para este modelo, porque necesita el servidor parcheado de Baidu. Escribimos un backend propio, un fichero corto de Python que lo instala y lo ejecuta en tu máquina con GPU, y tu aplicación lo llama igual que llama a la API de chat de OpenAI. Estuvo listo en entre 61 y 143 segundos con los ficheros ya en caché.
El límite honesto, una sola vez: esto fue un documento en inglés de 59 páginas digitales limpias, leído una vez con cada ajuste, así que los escaneados están sin probar, y los cientos de páginas a los que apuntan los autores son su afirmación, no nuestra medición.
La prueba completa
El post de Research tiene las puntuaciones por página, la escalera de VRAM, los puntos flojos de la plataforma y el ejemplo del SDK. Lee la prueba completa de Unlimited OCR 2.