Unlimited OCR 2 liest ein ganzes PDF in einer Anfrage, und eine Einstellung entscheidet, ob Sie ihm trauen können
Unlimited OCR 2 las einen 59-seitigen Leitfaden in 3 min 44 s, 4,2 % vom Text entfernt, mit Seitenkacheln aus. Mit Kacheln: 38,1 %.
Dasselbe Modell, dieselbe Karte, dieselben 59 Seiten. Mit der Standard-Bildeinstellung der Autoren dauerte der Lauf 6 min 45 s und lag am Ende 38,1 % vom eigenen Text des PDFs entfernt. Mit einem geänderten Flag, crop_mode=false, dauerte er 3 min 44 s und lag 4,2 % daneben. Das Modell heißt Unlimited OCR 2, ein Dokumentparser, den Baidu unter MIT veröffentlicht hat. Es nimmt ein ganzes PDF in einer Anfrage statt Seite für Seite, sodass Text, der über einen Seitenumbruch läuft, zusammenhängend bleiben kann. Wer PDFs in Daten für eine Suche oder einen Assistenten verwandelt, weiß: Genau das machen seitenweise Werkzeuge falsch. Was Sie damit tun können: lange Berichte und Handbücher auf einer einzigen 16-GB-Karte parsen, solange Sie die Seitenkacheln ausschalten.
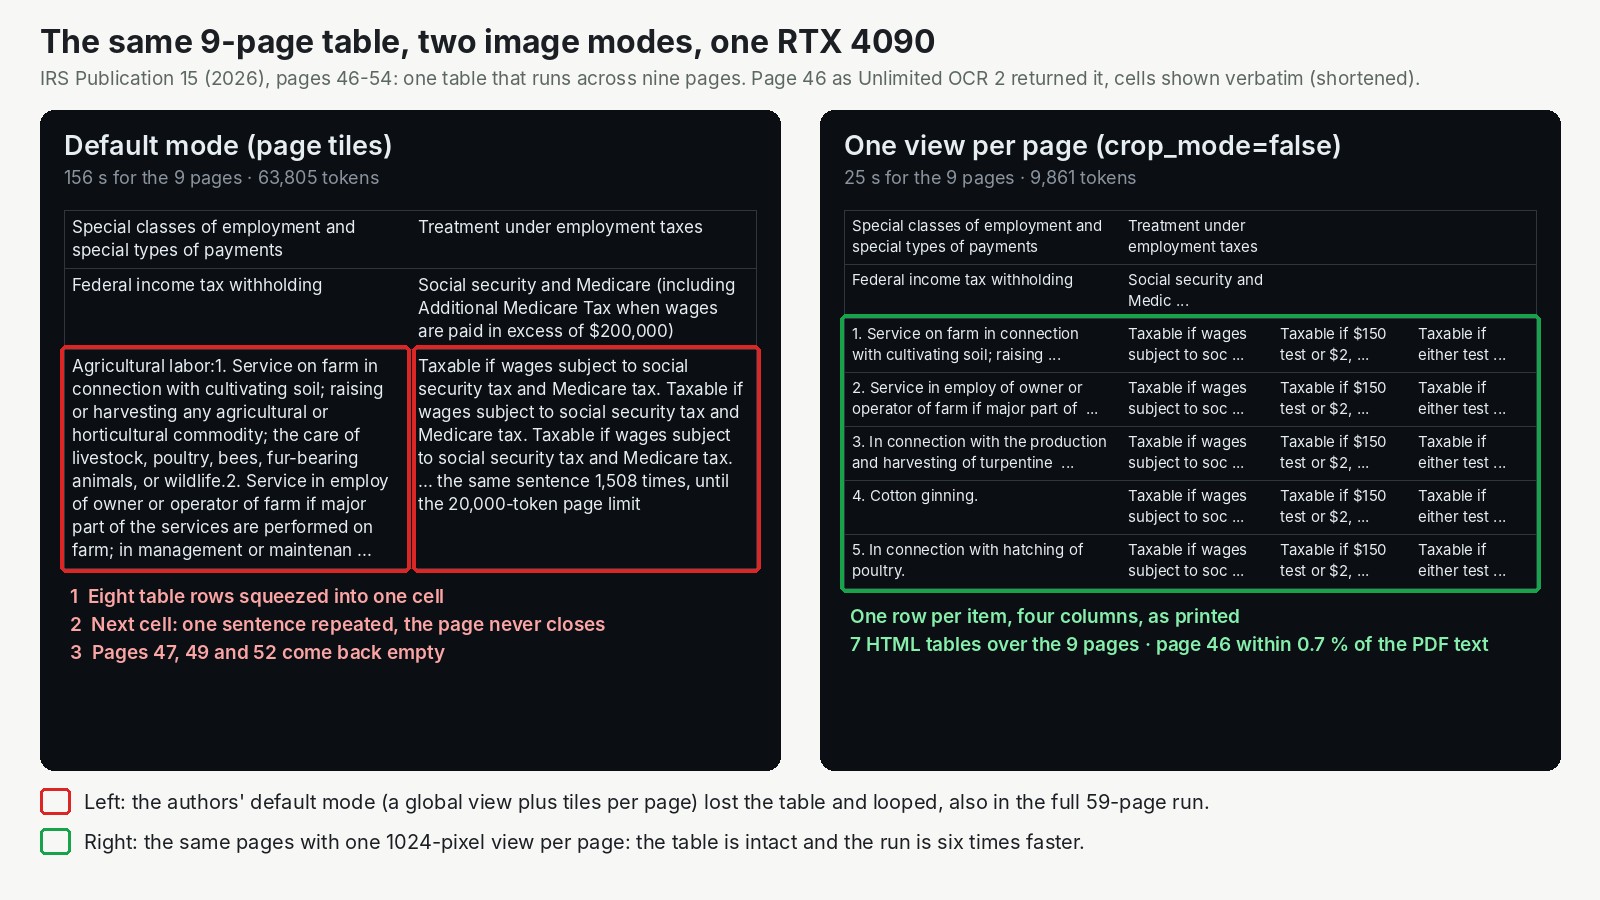
Nur die Seiten 46 bis 54, eine Karte. Links die Standardkacheln. Rechts eine Ansicht pro Seite: sechsmal schneller, kein wiederholter Satz.
Ein Parser, der ein Dokument liest, keinen Stapel Seiten
Die meisten PDF-Pipelines zerlegen die Datei in Seiten, lesen jede für sich und kleben den Text wieder zusammen. Alles, was über einen Seitenumbruch geht, wird zerschnitten. Eine Tabelle über zwei Seiten wird zu zwei Tabellen, und die zweite hat keinen Kopf.
Unlimited OCR 2 liest mehrere Seiten zusammen. Einem Modell viele Seiten auf einmal zu zeigen, ist normalerweise teuer, denn jede Seite ist ein Bild. Baidus Trick ist laut Modellseite, nur eine feste Zahl von Bildstücken im Blick zu behalten, egal wie lang das Dokument ist. Nach Angaben der Autoren kostet jedes neue Wort auf Seite 3 etwa so viel wie auf Seite 300.
Das Modell ist klein, 6,7 GB auf der Platte. Die Lizenz erlaubt kommerzielle Nutzung. Der Dank geht an Baidus Team, angeführt von den Hauptbeitragenden Shu Wei, Jingjing Wu und Qunyi Xie, die auf ihrem ersten Unlimited OCR und auf DeepSeek-OCR aufgebaut haben. Sie haben außerdem eine gepatchte Version von SGLang, dem offenen Serving-Framework, mit einem vollständigen Rezept mitgeliefert. Unser Teil war, diesen Server hinter eine API zu packen und ihn an einem echten Dokument zu testen.
Was unser Test ergeben hat
IRS Publication 15, der US-Steuerleitfaden für Arbeitgeber, hat 59 Seiten, ist gemeinfrei, hat auf den meisten Seiten Absätze über den Seitenumbruch hinweg und eine Tabelle, die von Seite 46 bis Seite 52 läuft. Wir haben das ganze PDF in einer Anfrage auf einer RTX 4090 geschickt, einer 24-GB-Gaming-Karte in unserer Cloud, und die Ausgabe gegen die eigene Textebene des PDFs bewertet: der Anteil der Zeichen, die Sie ändern müssten, wobei 0 % identisch heißt.
Entscheidend ist, wie jede Seite dem Modell gezeigt wird. Der Standard schneidet jede Seite in vergrößerte Kacheln, zusätzlich zu einem Übersichtsbild. crop_mode=false zeigt nur die Übersicht.
| 59-seitiges PDF, eine Anfrage | Seitenkacheln (Standard) | Eine Ansicht pro Seite |
|---|---|---|
| RTX 4090, ganzes Dokument | 6 min 45 s | 3 min 44 s, 15,8 Seiten/min |
| Abstand zum Text des PDFs | 38,1 % | 4,2 % |
| RTX 2000 Ada 16 GB, echte Karte | nicht auf allen 59 Seiten gelaufen | etwa zehneinhalb Minuten, 4,23 % |
Bei Fließtext waren beide Modi gut: Ohne die Tabellenseiten lagen beide bei etwa 2,4 % daneben, zwei oder drei Zeichen von hundert. Der Unterschied ist die Tabelle. Im Kachelmodus quetschte Seite 46 acht Zeilen in eine Zelle und schrieb dann einen Satz, "Taxable if wages subject to social security tax and Medicare tax", 1.508-mal. Ein Looper-Pedal, das niemand ausgeschaltet hat. Die Seiten 47, 50 und 52 kamen leer zurück. Die Seiten 46 bis 54 allein geschickt liefen in dieselbe Schleife, es ist also Verhalten des Modells, kein Speicherunfall.
Mit einer Ansicht pro Seite kam die Tabelle als HTML in sieben Teilen zurück, einem pro Seite. Der Unterschied zu einem seitenweisen Parser sind die Tags: Fünf der sechs Übergänge tragen ein Tag, das das Stück als Fortsetzung markiert. Genau diese Tags braucht ein Programm, um sie wieder zu einer Tabelle zusammenzusetzen.
Eine kleine Karte hält mit. Eine echte RTX 2000 Ada, eine 16-GB-Workstation-Karte mit 70 Watt Verbrauch, las den ganzen Leitfaden mit einer Ansicht pro Seite in 5,6 Seiten pro Minute, mit einer Spitze von 13,8 GB. Ihre Qualität entsprach der der 4090.
Für wen das relevant ist
- Teams, die lange Berichte, Handbücher oder Verträge parsen, in denen Tabellen und Absätze über Seiten gehen. Eine Anfrage pro Dokument liefert Text, Positionen und seitenübergreifende Tags, unter einer Lizenz, die kommerzielle Nutzung erlaubt.
- Alle mit langen Tabellen. Setzen Sie
crop_mode=falseund prüfen Sie dann die Zahlen auf den Tabellenseiten: Fünf davon lagen immer noch 20 % bis 46 % daneben. - Alle, die die Kacheln anlassen. Behalten Sie die Standardfenster von 10 Seiten und zählen Sie die Seiten, die zurückkommen. Im Kachelmodus ging einem einzigen Fenster für das ganze Dokument der Platz aus, und es hörte mitten auf Seite 27 auf, ohne Fehlermeldung.
- Teams mit kleinen Karten. 16 GB reichten für ein Dokument wie unseres.
Auf InferenceKey gibt es keine fertige Unterstützung für dieses Modell, weil es Baidus gepatchten Server braucht. Wir haben ein Custom Backend geschrieben, eine kurze Python-Datei, die ihn auf Ihrer GPU-Maschine installiert und startet, und Ihre App ruft es so auf wie die Chat-API von OpenAI. Mit zwischengespeicherten Dateien war es in 61 bis 143 Sekunden bereit.
Die ehrliche Grenze, einmal gesagt: Das war ein englisches Dokument mit 59 sauberen digitalen Seiten, einmal pro Einstellung gelesen. Scans sind also nicht getestet, und die Hunderte von Seiten, auf die die Autoren zielen, sind ihre Angabe, nicht unsere Messung.
Der vollständige Test
Der Research-Beitrag enthält die Bewertungen pro Seite, die VRAM-Leiter, die rauen Stellen der Plattform und das SDK-Beispiel. Lesen Sie den vollständigen Test von Unlimited OCR 2.