Nemotron 3.5 Transcribe: ein Deployment, für jedes Team ein anderes Transkript, in unter fünf Sekunden
Eine Kopie von Nemotron 3.5 Transcribe lieferte 3 Minuten Audio wörtlich, bereinigt und nach Sprechern getrennt in höchstens 4,4 s auf einer 32-GB-Karte.
Ein Compliance-Team will jedes "äh". Eine medizinische Dokumentation will sauberen Text. Ein Meeting-Tool will wissen, wer wann was gesagt hat. Normalerweise heißt das: getrennte Schritte, die Sie selbst anschrauben. Das neue offene Sprachmodell von NVIDIA, Nemotron 3.5 Transcribe, erledigt alle drei aus einer einzigen geladenen Kopie: Der Satz, den Sie mit dem Audio schicken, bestimmt das Transkript. Wir haben es auf einer Blackwell-Karte mit 32 GB in unserer Cloud laufen lassen, mit der offenen Software, die NVIDIA mitliefert. Drei Minuten eines Arztgesprächs kamen nach Arzt und Patient getrennt zurück, mit Start- und Endzeit für jedes der 561 Wörter, in 4,4 Sekunden GPU-Zeit. Wer eigene GPUs betreibt, bezahlt einen neuen Transkriptstil jetzt mit einem Satz, nicht mit einem weiteren Deployment. Was Sie damit tun können: wörtlichen, bereinigten, nach Sprechern markierten und übersetzten Text von einer Blackwell-Karte ausliefern, pro Anfrage gewählt.
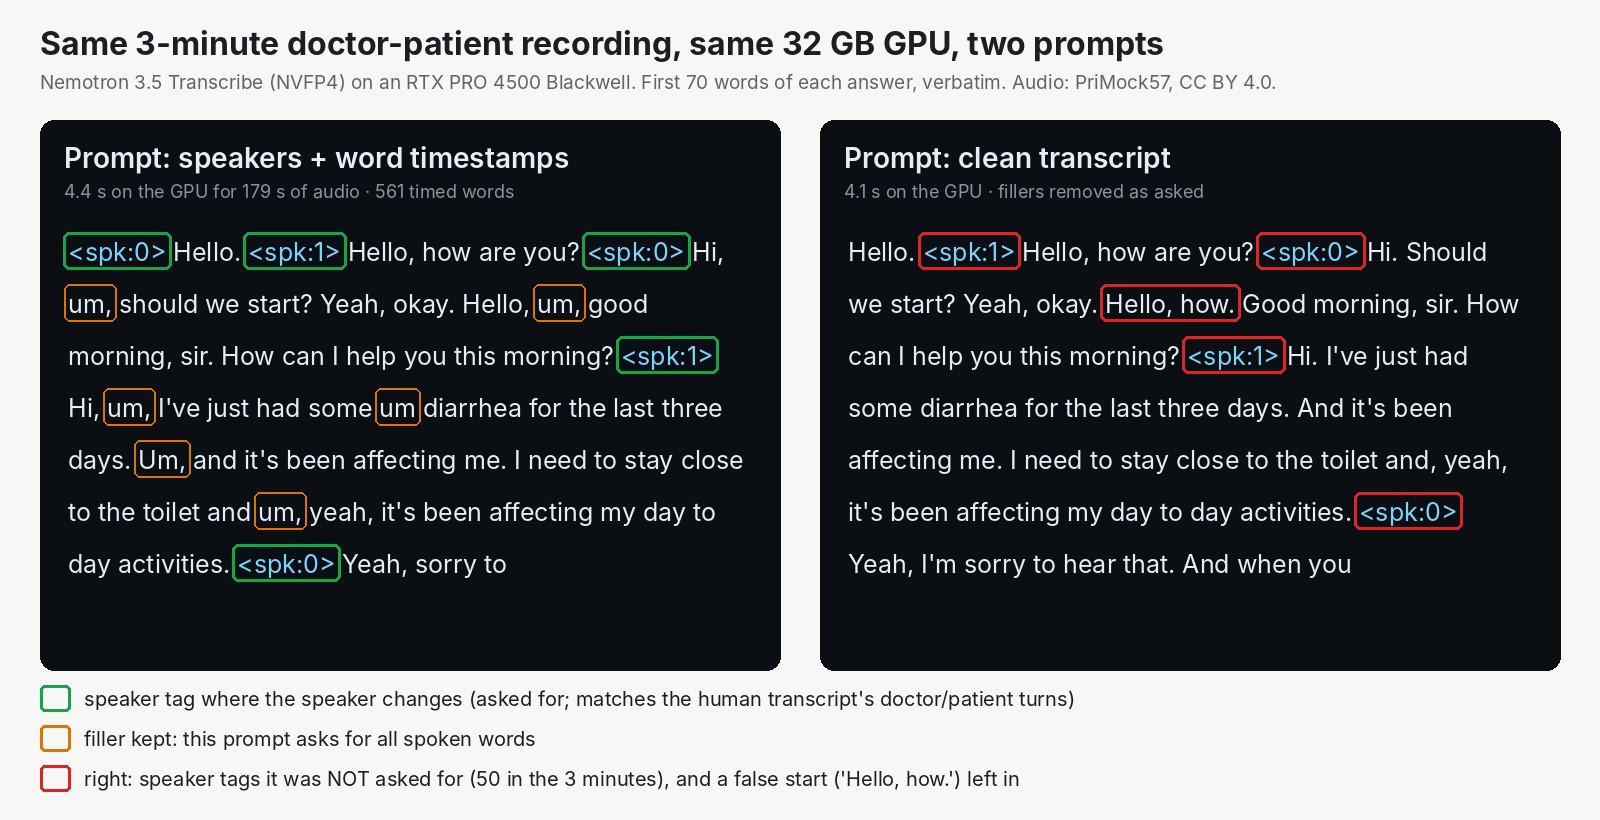
Eine Aufnahme, eine Karte, zwei Prompts. Die bereinigte Fassung rechts fügt Sprechermarkierungen hinzu, nach denen niemand gefragt hat.
Ein Sprachmodell, mit dem Sie reden wie mit einem Chatmodell
Nemotron 3.5 Transcribe hört zu und befolgt dann eine Anweisung. Die Modellseite von NVIDIA führt auf, was diese Anweisung verlangen kann: Wort für Wort mit jedem Füllwort, zum Lesen bereinigt, nach Sprechern markiert mit einer Zeit für jedes Wort, oder übersetzt. Es deckt 40 Sprachen und Aufnahmen bis zu einer Stunde ab.
Für ein Sprachmodell ist es groß: insgesamt 34 Milliarden Parameter, aber nur etwa 4,3 Milliarden arbeiten an jedem Stück Audio. Stellen Sie sich ein großes Team von Spezialisten vor, bei dem jedes Wort eine Handvoll befragt, während der Rest wartet. Deshalb läuft es für seine Größe schnell.
NVIDIA hat es am 28. Oktober in drei Dateigrößen veröffentlicht. Wir haben die kleinste genommen, 21,6 GB, die nur auf Blackwell läuft, NVIDIAs neuester Kartengeneration. Laut NVIDIA macht sie 3,6 % mehr Fehler als die größte Version. Die Lizenz, OpenMDW-1.1, erlaubt es, das Modell zu nutzen, zu verändern und weiterzugeben, und NVIDIAs Seite sagt klar, dass kommerzielle Nutzung erlaubt ist. NVIDIA hat das Modell und sein Serving-Rezept gebaut, das vLLM-Projekt die Engine, auf der es läuft, und entdeckt haben wir es im News-Video von AI Search vom 1. November. Unser Teil war, es zu verpacken, auf Karten laufen zu lassen, die ein Team mieten kann, und die Fehler zu zählen.
Was eine 32-GB-Karte geschafft hat
Unsere Karte war eine RTX PRO 4500 Blackwell, eine Workstation-Karte mit 32 GB. Jeder Prompt auf dem dreiminütigen Arztgespräch war in unter fünf Sekunden GPU-Zeit fertig, etwa vierzigmal schneller, als die Aufnahme abspielt.
| Prompt | GPU-Zeit für 3 Minuten | Was zurückkam |
|---|---|---|
| verbatim | 4,1 s | 33 der 34 "um" und "uh" erhalten |
| clean | 4,1 s | jedes Füllwort entfernt, dazu Markierungen, nach denen niemand gefragt hat |
| speakers + word timestamps | 4,4 s | Redebeiträge von Arzt und Patient, 561 Wörter mit Zeitstempel |
Eine spanische Übersetzung kam nach 4,9 Sekunden zurück; bewertet haben wir sie nicht. Fünf Minuten Audio aus einer Telefonkonferenz zu Quartalszahlen dauerten 4,8 Sekunden, in einer einzigen Anfrage.
Die Genauigkeitszahl, die sich über Modelle hinweg vergleichen lässt, stammt aus 40 kurzen englischen Clips, denselben, die wir letzte Woche für Underdog Bark und Qwen3-ASR verwendet haben. Nemotron lag bei 6,82 % falschen Wörtern. Bark 3.0 Pro kam auf 6,28 % und Qwen3-ASR-1.7B auf 7,03 %, gleich bewertet. Es liegt also dazwischen, näher an Qwen. Sein Gewinn ist die Wahl der Ausgabe, nicht die reine Genauigkeit. Bei Hörbuch-Sprache war es mit 0,94 % das beste der drei, bei aufgezeichneten Büro-Meetings mit 14,62 % das schwächste, hinter Bark und vor Qwen.
Die kleinste Hardware, die funktioniert hat, war ein echter 24-GB-Ausschnitt einer größeren Blackwell-Karte. Dieselben 6,82 % auf den Clips, aber vier- bis achtmal langsamer: Der dreiminütige Lauf mit Sprechern dauerte 35,3 Sekunden statt 4,4. Wie eine Band auf einer kleineren Bühne: dieselbe Setlist, langsamere Umbauten.
Für wen das relevant ist
- Teams, die für verschiedene Leser verschiedene Transkripte brauchen. Ein Deployment beantwortet alle vier Stile unter derselben Adresse. Auf InferenceKey nutzt es die Standard-Sprachroute von OpenAI, die unser Qwen3-ASR-Deployment schon beantwortet, die Anfrage behält also ihre Form. Neu ist das Prompt-Feld.
- Alle mit einer Blackwell-Karte mit 32 GB. Es läuft schnell. Ein 24-GB-Ausschnitt einer Blackwell-Karte läuft auch, langsamer.
- Teams mit RTX 4090 oder älteren Karten. Die kleine Datei läuft dort nicht; sie braucht Blackwell.
- Alle, die Live-Untertitel brauchen. Nicht dieses Modell. NVIDIAs Seite sagt, es arbeitet nur offline: Sie geben ihm eine fertige Aufnahme.
Bei der Geschwindigkeit sollten Sie NVIDIAs Schlagzeilenzahl vorsichtig lesen. Die Seite nennt etwa 37 Minuten Audio pro Sekunde auf einer 96-GB-Karte, aber mit NVIDIAs eigener paketierter Engine, die noch nicht offen ist. Die offene Version "is expected to be roughly two times slower". Dieser offene Weg ist der, den wir genutzt haben.
Die ehrliche Grenze, einmal gesagt: Den Clean-Prompt sollten Sie prüfen, bevor Sie ihm vertrauen, denn er hat in drei Minuten 50 Sprechermarkierungen hinzugefügt und einen Fehlstart stehen lassen, und unsere gesamte Stichprobe ist klein: 924 Wörter aus Clips plus eine Datei mit drei und eine mit fünf Minuten, eine Anfrage nach der anderen.
Der vollständige Test
Der Research-Beitrag enthält die vollständigen Messungen, die 24-GB-Leiter, NVIDIAs eigene Benchmarks, die Plattformgrenzen, auf die wir gestoßen sind, und das SDK-Beispiel. Lesen Sie den vollständigen Test von Nemotron 3.5 Transcribe.