Nemotron 3.5 Transcribe : un seul déploiement, une transcription différente pour chaque équipe, en moins de cinq secondes
Une seule copie de Nemotron 3.5 Transcribe a rendu 3 minutes d'audio en verbatim, propre et par locuteur, en 4,4 s max sur une carte de 32 GB.
Une équipe conformité veut chaque "euh". Un scribe médical veut une prose propre. Un outil de réunion veut qui a dit quoi, et quand. D'habitude, cela veut dire des étapes séparées que vous greffez vous-même. Le nouveau modèle vocal ouvert de NVIDIA, Nemotron 3.5 Transcribe, fait les trois à partir d'une seule copie chargée : la phrase que vous envoyez avec l'audio choisit la transcription. Nous l'avons fait tourner sur une seule carte Blackwell de 32 GB de notre cloud, avec le logiciel ouvert que livre NVIDIA. Trois minutes d'une consultation médicale sont revenues séparées entre médecin et patient, avec un début et une fin sur chacun de ses 561 mots, en 4,4 secondes de temps GPU. Pour qui fait tourner ses propres GPU, un nouveau style de transcription coûte désormais une phrase, pas un déploiement de plus. Ce que vous pouvez en faire : servir du texte verbatim, propre, étiqueté par locuteur et traduit depuis une seule carte Blackwell, au choix à chaque requête.
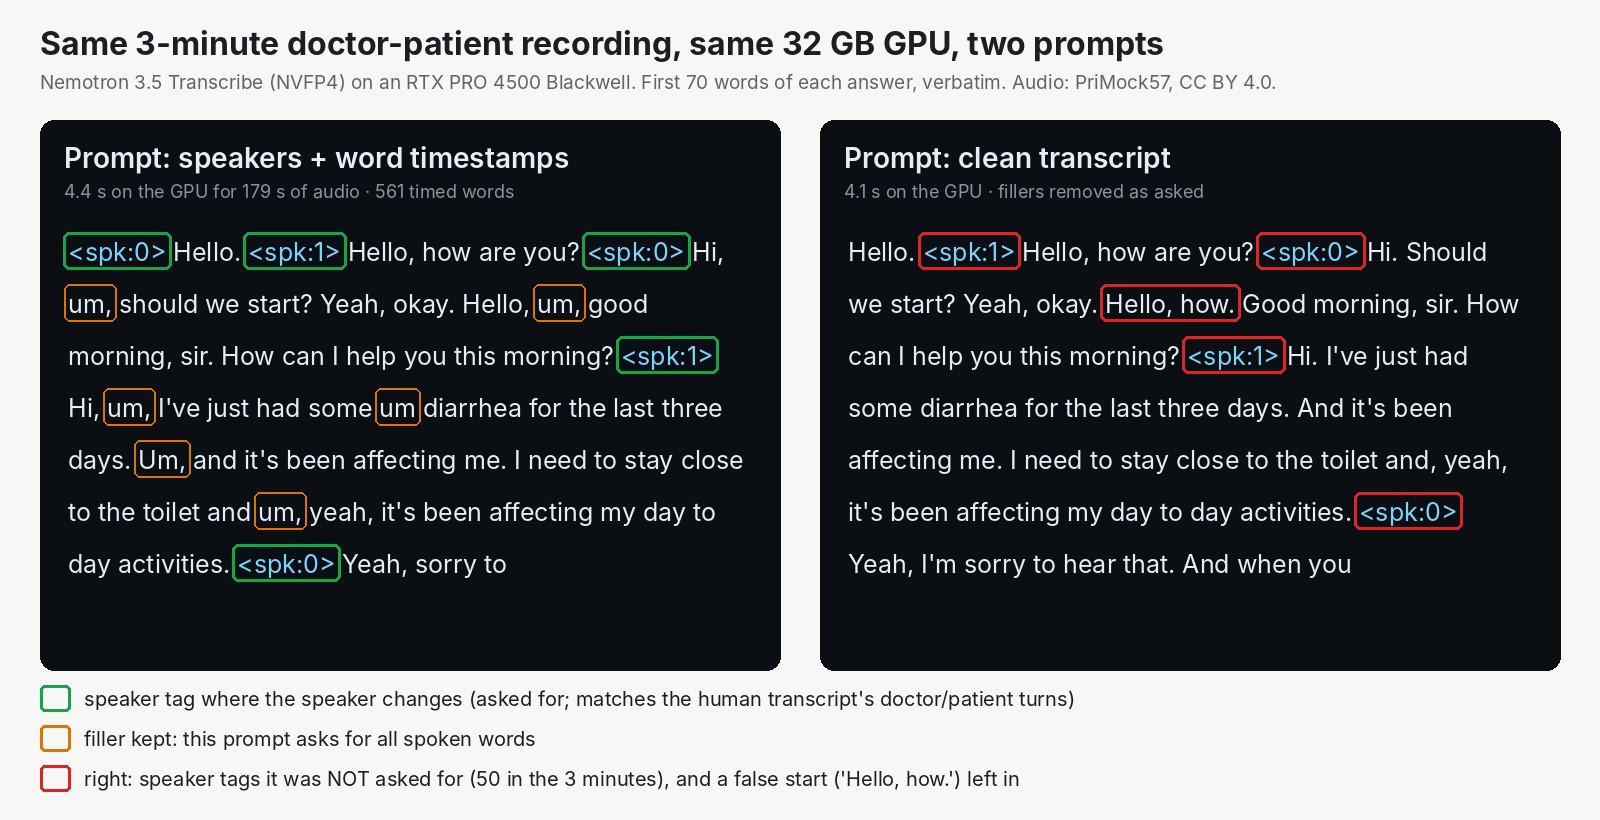
Un enregistrement, une carte, deux prompts. La version propre, à droite, ajoute des étiquettes de locuteur que personne n'a demandées.
Un modèle vocal à qui l'on parle comme à un modèle de chat
Nemotron 3.5 Transcribe écoute, puis suit une instruction. La page du modèle chez NVIDIA liste ce que cette instruction peut demander : mot pour mot avec chaque hésitation, nettoyé pour la lecture, étiqueté par locuteur avec un horodatage pour chaque mot, ou traduit. Il couvre 40 langues et des enregistrements jusqu'à une heure.
Il est gros pour un modèle vocal : 34 milliards de paramètres au total, mais seulement environ 4,3 milliards travaillent sur chaque morceau d'audio. Imaginez une grande équipe de spécialistes où chaque mot en consulte une poignée pendant que les autres attendent. C'est pour ça qu'il va vite pour sa taille.
NVIDIA l'a sorti le 28 octobre en trois tailles de fichier. Nous avons pris la plus petite, 21,6 GB, qui ne tourne que sur Blackwell, la génération de cartes la plus récente de NVIDIA. Selon NVIDIA, elle fait 3,6 % d'erreurs de plus que la plus grande version. La licence, OpenMDW-1.1, permet d'utiliser, de modifier et de partager le modèle, et la page de NVIDIA dit clairement que l'usage commercial est autorisé. NVIDIA a construit le modèle et sa recette de service, le projet vLLM a construit le moteur sur lequel il tourne, et nous l'avons repéré dans la vidéo d'actualité d'AI Search du 1er novembre. Notre part : l'empaqueter, le faire tourner sur des cartes qu'une équipe peut louer et compter les erreurs.
Ce qu'a fait une carte de 32 GB
Notre carte était une RTX PRO 4500 Blackwell, une carte de station de travail de 32 GB. Chaque prompt sur la consultation de trois minutes a fini en moins de cinq secondes de temps GPU, environ quarante fois plus vite que la durée de l'enregistrement.
| Prompt | Temps GPU pour 3 minutes | Ce qui est revenu |
|---|---|---|
| verbatim | 4,1 s | 33 des 34 "um" et "uh" gardés |
| clean | 4,1 s | toutes les hésitations retirées, plus des étiquettes que personne n'a demandées |
| speakers + word timestamps | 4,4 s | tours de parole du médecin et du patient, 561 mots horodatés |
Une traduction en espagnol est revenue au bout de 4,9 secondes ; nous ne l'avons pas notée. Cinq minutes d'audio d'une conférence de résultats financiers ont pris 4,8 secondes, en une seule requête.
Le chiffre de précision qui se compare d'un modèle à l'autre vient de 40 courts extraits en anglais, les mêmes que nous avons utilisés la semaine dernière pour Underdog Bark et Qwen3-ASR. Nemotron s'est trompé sur 6,82 % des mots. Bark 3.0 Pro a fait 6,28 % et Qwen3-ASR-1.7B 7,03 %, notés de la même façon. Il se place donc entre les deux, plus près de Qwen. Son atout, c'est le choix de la sortie, pas la précision brute. Il a été le meilleur des trois sur la lecture de livres audio, à 0,94 %, et le plus faible sur des réunions de bureau enregistrées, à 14,62 %, derrière Bark et devant Qwen.
Le plus petit matériel qui a fonctionné était une vraie tranche de 24 GB d'une carte Blackwell plus grosse. Même 6,82 % sur les extraits, mais quatre à huit fois plus lent : le passage avec locuteurs sur trois minutes a pris 35,3 secondes au lieu de 4,4. Comme un groupe sur une scène plus petite : même setlist, changements plus lents entre les morceaux.
Qui devrait s'y intéresser
- Les équipes qui ont besoin de transcriptions différentes pour des lecteurs différents. Un seul déploiement répond aux quatre styles à la même adresse. Sur InferenceKey, il utilise la route vocale OpenAI standard à laquelle notre déploiement Qwen3-ASR répond déjà, donc la requête garde sa forme. La nouveauté, c'est le champ prompt.
- Quiconque a une carte Blackwell de 32 GB. Il va vite. Une tranche Blackwell de 24 GB fonctionne aussi, plus lentement.
- Les équipes sur RTX 4090 ou sur des cartes plus anciennes. Le petit fichier n'y tournera pas ; il lui faut Blackwell.
- Quiconque a besoin de sous-titres en direct. Pas ce modèle. La page de NVIDIA dit qu'il fonctionne hors ligne uniquement : vous lui donnez un enregistrement terminé.
Sur la vitesse, lisez le chiffre phare de NVIDIA avec prudence. Sa page annonce environ 37 minutes d'audio par seconde sur une carte de 96 GB, mais avec le moteur empaqueté de NVIDIA lui-même, qui n'est pas encore ouvert. La version ouverte "is expected to be roughly two times slower" (devrait être environ deux fois plus lente). C'est cette voie ouverte que nous avons utilisée.
La limite honnête, une fois : le prompt clean est celui à vérifier avant de lui faire confiance, puisqu'il a ajouté 50 étiquettes de locuteur en trois minutes et gardé un faux départ, et tout notre échantillon est petit, 924 mots d'extraits plus un fichier de trois minutes et un de cinq minutes, une requête à la fois.
Le test complet
L'article Research contient toutes les mesures, l'échelle à 24 GB, les benchmarks de NVIDIA eux-mêmes, les limites de la plateforme que nous avons rencontrées et l'exemple avec le SDK. Lisez le test complet de Nemotron 3.5 Transcribe.