Nemotron 3.5 Transcribe: un solo despliegue, una transcripción distinta para cada equipo, en menos de cinco segundos
Una sola copia de Nemotron 3.5 Transcribe sacó texto literal, limpio y por hablante de 3 minutos de audio en 4,4 s o menos en una tarjeta de 32 GB.
Un equipo de cumplimiento normativo quiere cada "um". Un asistente de documentación médica quiere prosa limpia. Una herramienta de reuniones quiere saber quién dijo qué, y cuándo. Normalmente eso son pasos separados que te toca montar a ti. El nuevo modelo abierto de voz de NVIDIA, Nemotron 3.5 Transcribe, hace las tres cosas con una sola copia cargada: la frase que envías junto al audio decide la transcripción. Lo probamos en una tarjeta Blackwell de 32 GB de nuestra nube, con el software abierto que publica NVIDIA. Tres minutos de una consulta médica volvieron separados en médico y paciente, con hora de inicio y de fin en cada una de sus 561 palabras, en 4,4 segundos de tiempo de GPU. Si gestionas tus propias GPUs, un estilo de transcripción nuevo ahora cuesta una frase, no otro despliegue. Lo que puedes hacer con él: servir texto literal, limpio, etiquetado por hablante y traducido desde una sola tarjeta Blackwell, elegido en cada petición.
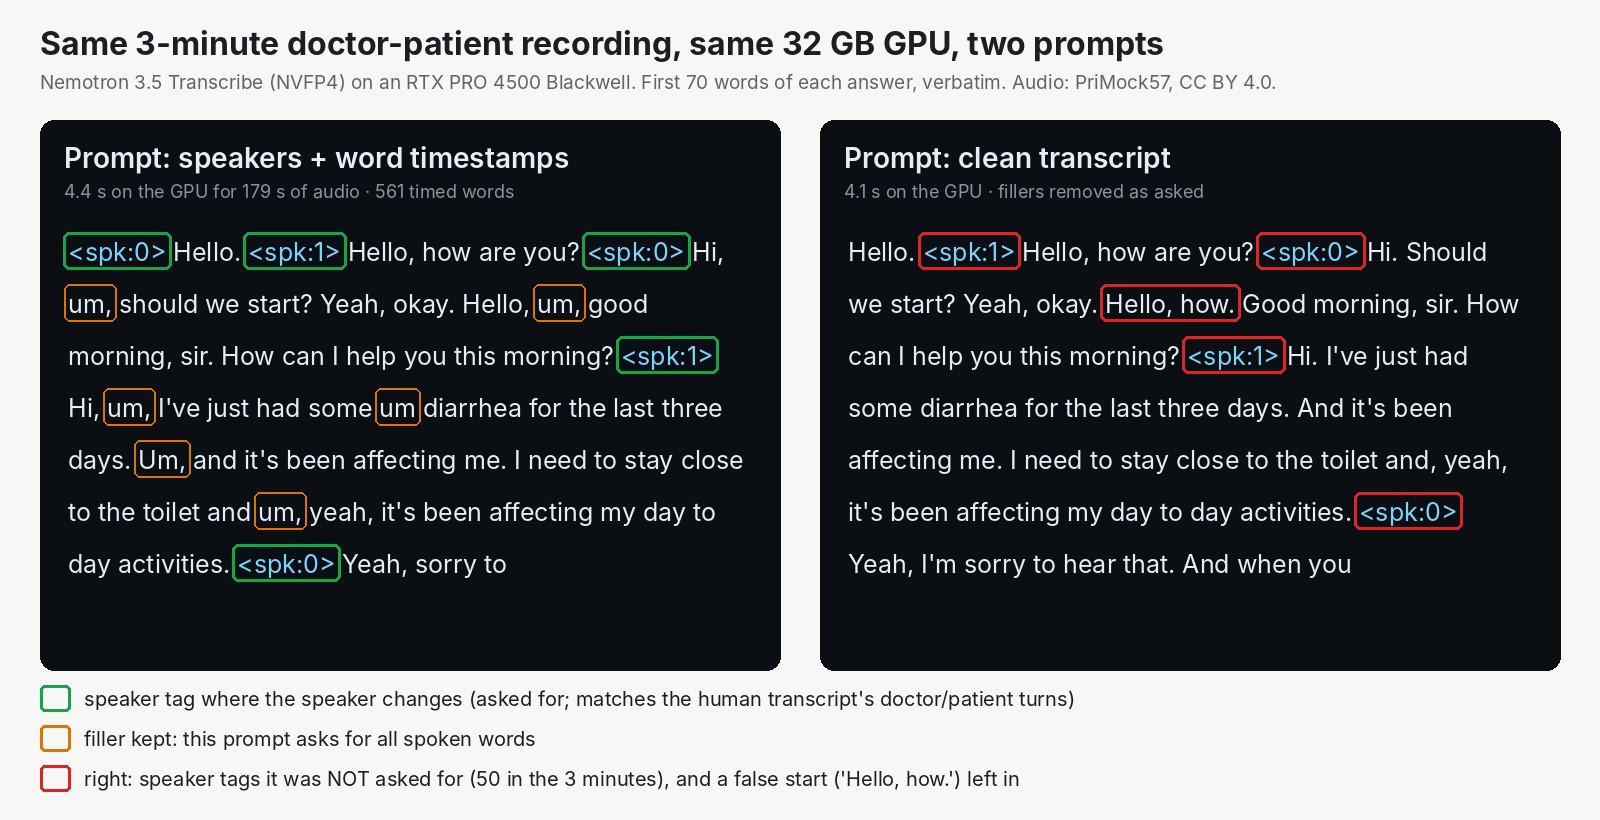
Una grabación, una tarjeta, dos prompts. La versión limpia de la derecha añade etiquetas de hablante que nadie pidió.
Un modelo de voz al que hablas como a un modelo de chat
Nemotron 3.5 Transcribe escucha y después sigue una instrucción. La página del modelo de NVIDIA enumera lo que esa instrucción puede pedir: palabra por palabra con todas las muletillas, limpio para leer, etiquetado por hablante con un tiempo para cada palabra, o traducido. Cubre 40 idiomas y grabaciones de hasta una hora.
Es grande para ser de voz: 34B parámetros en total, pero solo unos 4,3B trabajan en cada trozo de audio. Imagina un equipo grande de especialistas en el que cada palabra consulta a un puñado mientras el resto espera. Por eso va rápido para su tamaño.
NVIDIA lo publicó el 28 de octubre en tres tamaños de fichero. Usamos el más pequeño, de 21,6 GB, que solo funciona en Blackwell, la generación de tarjetas más nueva de NVIDIA. NVIDIA dice que comete un 3,6 % más de errores que la versión más grande. La licencia, OpenMDW-1.1, permite usar, modificar y compartir el modelo, y la página de NVIDIA dice claramente que el uso comercial está permitido. NVIDIA construyó el modelo y su receta de servicio, el proyecto vLLM construyó el motor sobre el que corre, y nosotros lo vimos en el vídeo de noticias de AI Search del 1 de noviembre. Lo nuestro fue empaquetarlo, ponerlo a funcionar en tarjetas que un equipo puede alquilar y contar los errores.
Lo que hizo una tarjeta de 32 GB
Nuestra tarjeta era una RTX PRO 4500 Blackwell, una tarjeta de estación de trabajo con 32 GB. Cada prompt sobre la consulta de tres minutos terminó en menos de cinco segundos de tiempo de GPU, unas cuarenta veces más rápido de lo que dura la grabación.
| Prompt | Tiempo de GPU para 3 minutos | Lo que volvió |
|---|---|---|
| verbatim | 4,1 s | 33 de los 34 "um" y "uh" conservados |
| clean | 4,1 s | todas las muletillas quitadas, más etiquetas que nadie pidió |
| speakers + word timestamps | 4,4 s | turnos de médico y paciente, 561 palabras con tiempos |
Una traducción al español volvió a los 4,9 segundos; no la puntuamos. Cinco minutos de audio de una presentación de resultados tardaron 4,8 segundos, en una sola petición.
La cifra de precisión que sirve para comparar entre modelos sale de 40 clips cortos en inglés, los mismos que usamos la semana pasada con Underdog Bark y Qwen3-ASR. Nemotron se equivocó en el 6,82 % de las palabras. Bark 3.0 Pro sacó un 6,28 % y Qwen3-ASR-1.7B un 7,03 %, puntuados de la misma forma. Así que queda entre los dos, más cerca de Qwen. Lo que gana es poder elegir la salida, no la precisión pura. Fue el mejor de los tres con voz de audiolibro, con un 0,94 %, y el más flojo con reuniones de oficina grabadas, con un 14,62 %, por detrás de Bark y por delante de Qwen.
El hardware más pequeño que funcionó fue una porción real de 24 GB de una tarjeta Blackwell más grande. El mismo 6,82 % en los clips, pero entre cuatro y ocho veces más lento: la ejecución de tres minutos con hablantes tardó 35,3 segundos en vez de 4,4. Como un grupo en un escenario más pequeño: el mismo repertorio, cambios más lentos entre canciones.
A quién le interesa
- Equipos que necesitan transcripciones distintas para lectores distintos. Un solo despliegue responde a los cuatro estilos en la misma dirección. En InferenceKey usa la ruta estándar de voz de OpenAI a la que ya responde nuestro despliegue de Qwen3-ASR, así que la petición mantiene su forma. Lo nuevo es el campo del prompt.
- Cualquiera con una tarjeta Blackwell de 32 GB. Va rápido. Una porción Blackwell de 24 GB también funciona, más lenta.
- Equipos con RTX 4090 o tarjetas más antiguas. El fichero pequeño no funciona ahí; necesita Blackwell.
- Quien necesite subtítulos en directo. Este modelo no. La página de NVIDIA dice que es solo offline: le pasas una grabación terminada.
Sobre la velocidad, lee con cuidado la cifra estrella de NVIDIA. Su página habla de unos 37 minutos de audio por segundo en una tarjeta de 96 GB, pero con el motor empaquetado propio de NVIDIA, que todavía no es abierto. De la versión abierta dice que "se espera que sea aproximadamente dos veces más lenta". Esa vía abierta es la que usamos nosotros.
El límite, con honestidad y una sola vez: el prompt de limpieza es el que hay que revisar antes de fiarse, porque añadió 50 etiquetas de hablante en tres minutos y mantuvo un arranque en falso, y toda nuestra muestra es pequeña, 924 palabras de clips más un fichero de tres minutos y otro de cinco, una petición cada vez.
La prueba completa
El post de Research tiene todas las mediciones, la escalera de 24 GB, los benchmarks propios de NVIDIA, los límites de la plataforma con los que nos topamos y el ejemplo del SDK. Lee la prueba completa de Nemotron 3.5 Transcribe.