Hy-Nomas mantiene estable un mundo de vídeo en una tarjeta de 24 GB, pero ignora los cambios de tiempo
Hy-Nomas en una RTX 4090: de 88 a 94 s por turno de 5 s, una escena que aguanta 3 turnos y 1 de 4 cambios de escena cumplido.
Cinco segundos de vídeo, unos noventa segundos de trabajo de GPU y un zorro que sigue siendo el mismo zorro tres llamadas después. Eso es Hy-Nomas, el nuevo modelo abierto de mundo en vídeo de Tencent Hunyuan, funcionando en una sola RTX 4090 de 24 GB de nuestra nube con la receta de una tarjeta de los propios autores. El arranque por defecto pide ocho GPUs. La versión de una tarjeta funcionó, llegó a un pico de 18,5 GiB y mantuvo la escena estable durante tres turnos. Además es Apache-2.0, de uso comercial gratuito. Si despliegas modelos, eso significa un mundo que diriges con texto, llamada a llamada, en una tarjeta que puedes alquilar por horas. Lo que todavía no hace bien es obedecer: solo uno de cada cuatro cambios de escena salió. Úsalo para prototipar escenas que tengan que mantenerse coherentes de un turno a otro, y prueba tus propios prompts antes de contar con que cambie el tiempo.
Un modelo de vídeo que recuerda lo que ha dibujado
La mayoría de los modelos abiertos de vídeo reciben un encargo, generan un clip y se olvidan de él. Hy-Nomas trabaja por turnos. Cada turno añade cinco segundos a la misma escena, con una instrucción de texto nueva. Antes de dibujar el siguiente trozo, lee sus notas sobre todo lo que ya ha dibujado. Esa memoria es la clave: el personaje, el camino y la luz pasan de una llamada a la siguiente.
El paper salió el 27 de octubre, con 39 autores. El modelo lee las instrucciones con un modelo abierto prestado, Qwen2.5-VL-7B. Los pesos y el código están en Hugging Face y GitHub.
La descarga es más pequeña de lo que parece. El repositorio completo ocupa 196 GB, pero la receta de una tarjeta solo lee tres partes, unos 35 GB.
La receta de una tarjeta funciona, unas 18 veces más lenta que el tiempo real
Junto al arranque de ocho GPUs, los autores publican una segunda receta pensada para una sola RTX 4090. Comprime las partes grandes y las aparca en la memoria principal del ordenador, y pasa cada una a la GPU solo para su propia fase. El paper no da ninguna velocidad para ella. Esa era nuestra pregunta.
| Mundo del zorro, una RTX 4090 | Tiempo de GPU | Pico de memoria de GPU |
|---|---|---|
| Turno 1: el zorro recorre el camino | 88,4 s | 17,4 GiB |
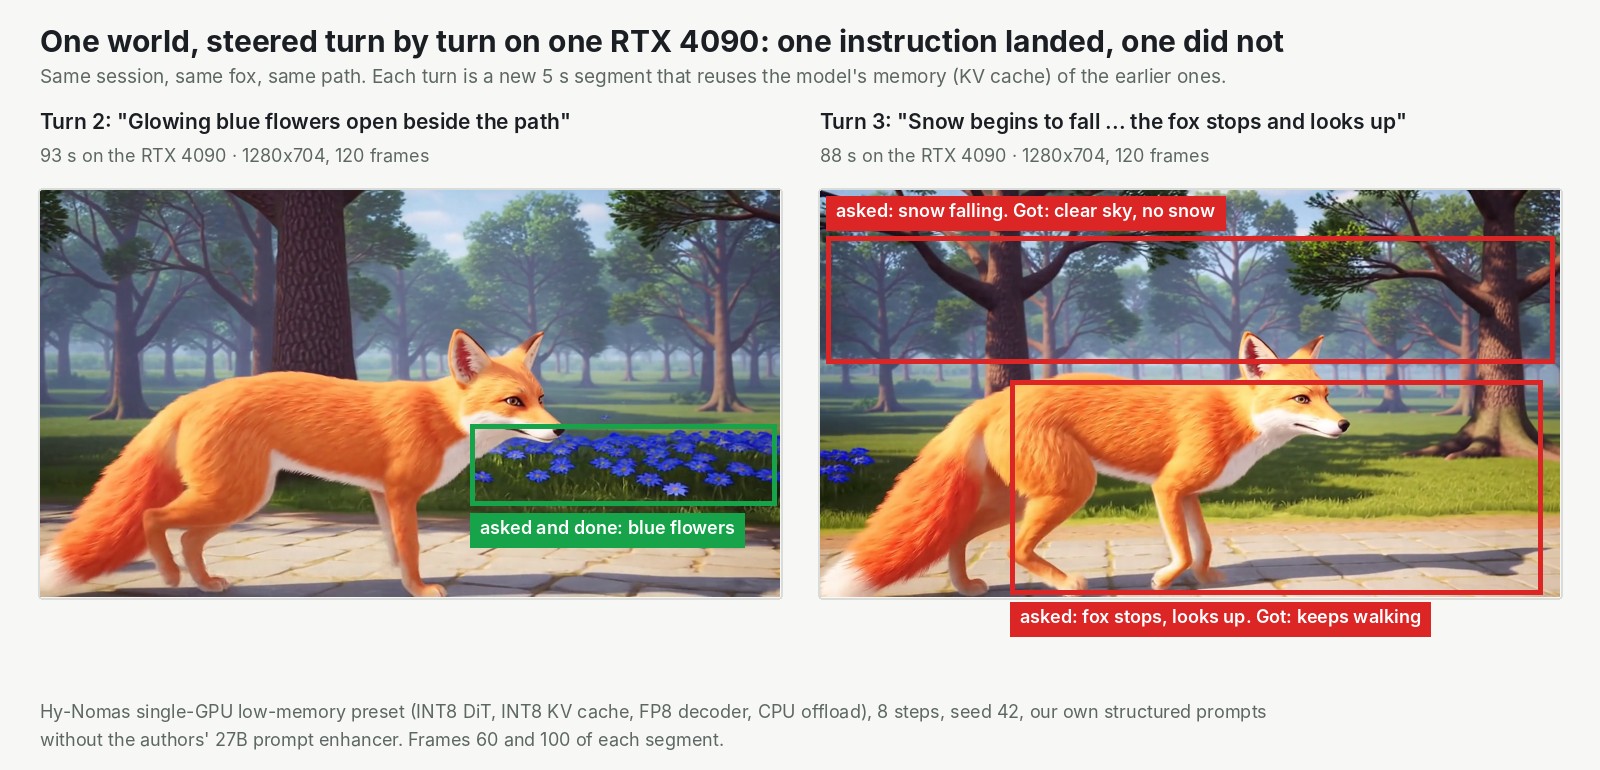
| Turno 2: se abren flores azules | 93,1 s | 17,6 GiB |
| Turno 3: nieve, el zorro se para | 88,2 s | 17,9 GiB |
Ya en caliente, cada segmento de 5 segundos tardó entre 88 y 94 segundos. Si ese ritmo se mantiene, un mundo de un minuto son doce turnos y unos 18 minutos de trabajo de GPU. La primera llamada tras un arranque en frío tardó hasta 138 segundos.
La escena aguantó. El zorro conservó el pelaje, el tamaño y la forma de andar. Los árboles y la luz no se movieron. En un segundo mundo, un farero conservó el chubasquero y el farol entre llamadas. Cada llamada era una petición separada, con un minuto y medio entre una y otra, y el resultado seguía pareciendo una sola toma.
También es repetible. Los mismos turnos con la misma semilla dieron ficheros de vídeo idénticos byte a byte en cuatro ejecuciones, en una misma máquina. Para un equipo, eso significa que un informe de bug puede llevar las entradas exactas y reproducir exactamente el mismo clip.
Dirigirlo es la parte floja: flores sí, nieve y tormentas no
Hy-Nomas añadió el objeto que le pedimos. En el turno dos, aparecieron flores azules junto al camino mientras pasaba el zorro. Los cambios de toda la escena nunca llegaron. No nevó, ni siquiera con una redacción más contundente, y la tormenta del mundo del farero nunca apareció. Eso es un cambio de escena de cuatro. El zorro, además, siguió andando cuando le pedimos que se parara y mirara arriba, y el farero nunca levantó el farol.
Sonó como un grupo que mantiene el ritmo tres canciones seguidas y se pierde el cambio de tono que ha pedido el cantante. Un sospechoso: escribimos los prompts a mano, sin Nomas-PE, el reescritor mucho más grande que la demo de los autores pasa a cada instrucción. No hemos probado si arregla lo del tiempo, así que tómalo como una suposición.
A quién le interesa, y con qué tarjeta
Si prototipas escenas, ideas de juegos o secuencias cortas que tengan que mantenerse coherentes, pruébalo. Si necesitas tiempo real, busca en otra parte. Si necesitas que el modelo obedezca cambios de toda la escena, prueba antes tus propios prompts.
La tarjeta importa más de lo habitual. Una RTX 4090 real de 24 GB funcionó, y la misma tarjeta limitada a 20 GiB pasó dos turnos. Limitada a 16 GiB, se quedó sin memoria antes de dibujar nada. Una parte de la receta solo funciona en la generación Ada de NVIDIA, la familia de la RTX 4090, así que una RTX 5090, más nueva, o una A40, más antigua, deberían fallar, aunque no las hemos probado. La memoria principal también crece, unos 5,9 GiB por cada 5 segundos de mundo.
En nuestra plataforma, un pequeño programa propio (nuestro envoltorio sobre el servicio de generación de los propios autores) mantuvo un mundo en memoria entre llamadas. Cada llamada envía un turno y recibe un MP4 de 5 segundos. Eso significa que una tarjeta sirve un mundo, y a un usuario, cada vez.
El límite, con honestidad: probamos dos mundos cortos, el más largo de tres turnos o 15 segundos de vídeo, una semilla por mundo, sin trayectorias de cámara, y el software de nuestra plataforma corrió en nuestro propio servidor, así que el servicio alojado en sí no está probado aquí.
Lee la prueba completa, con todos los tiempos, la escalera de memoria y los arreglos que necesitamos, en el post de Research sobre Hy-Nomas.