Sage-A1.5 mueve un agente de investigación en una tarjeta de 24 GB; deja su modo de verificación apagado para consultas sencillas
Sage-A1.5 en una RTX 4090: 136 tokens/s, una pregunta de investigación acertada en 3 de 3 ejecuciones y un modo de verificación que tarda 2,2 veces más.
¿Puede un agente de investigación abierto, uno que divide una pregunta, manda ayudantes a buscar y redacta la respuesta, vivir en una sola tarjeta gaming? Con Sage-A1.5, sí. Servimos el nuevo modelo de 35B del Shanghai AI Laboratory en una RTX 4090 de nuestra nube, con el fichero comprimido de los propios autores y llama.cpp de serie. Escribió unos 136 tokens por segundo y acertó nuestra pregunta de investigación en tres partes en las tres ejecuciones de prueba. Todas las llamadas a herramientas salieron exactamente en el formato que necesitaba nuestro código. Si despliegas modelos, eso significa un agente con licencia comercial gratuita, en una tarjeta de 24 GB que controlas tú, con las herramientas corriendo en tu propio código. Hay un interruptor que pide cuidado: su nuevo Verification Mode dio las mismas respuestas correctas en preguntas fáciles, pero tardó 2,2 veces más y gastó el doble de tokens. Déjalo apagado para consultas sencillas y pruébalo con tus casos difíciles.
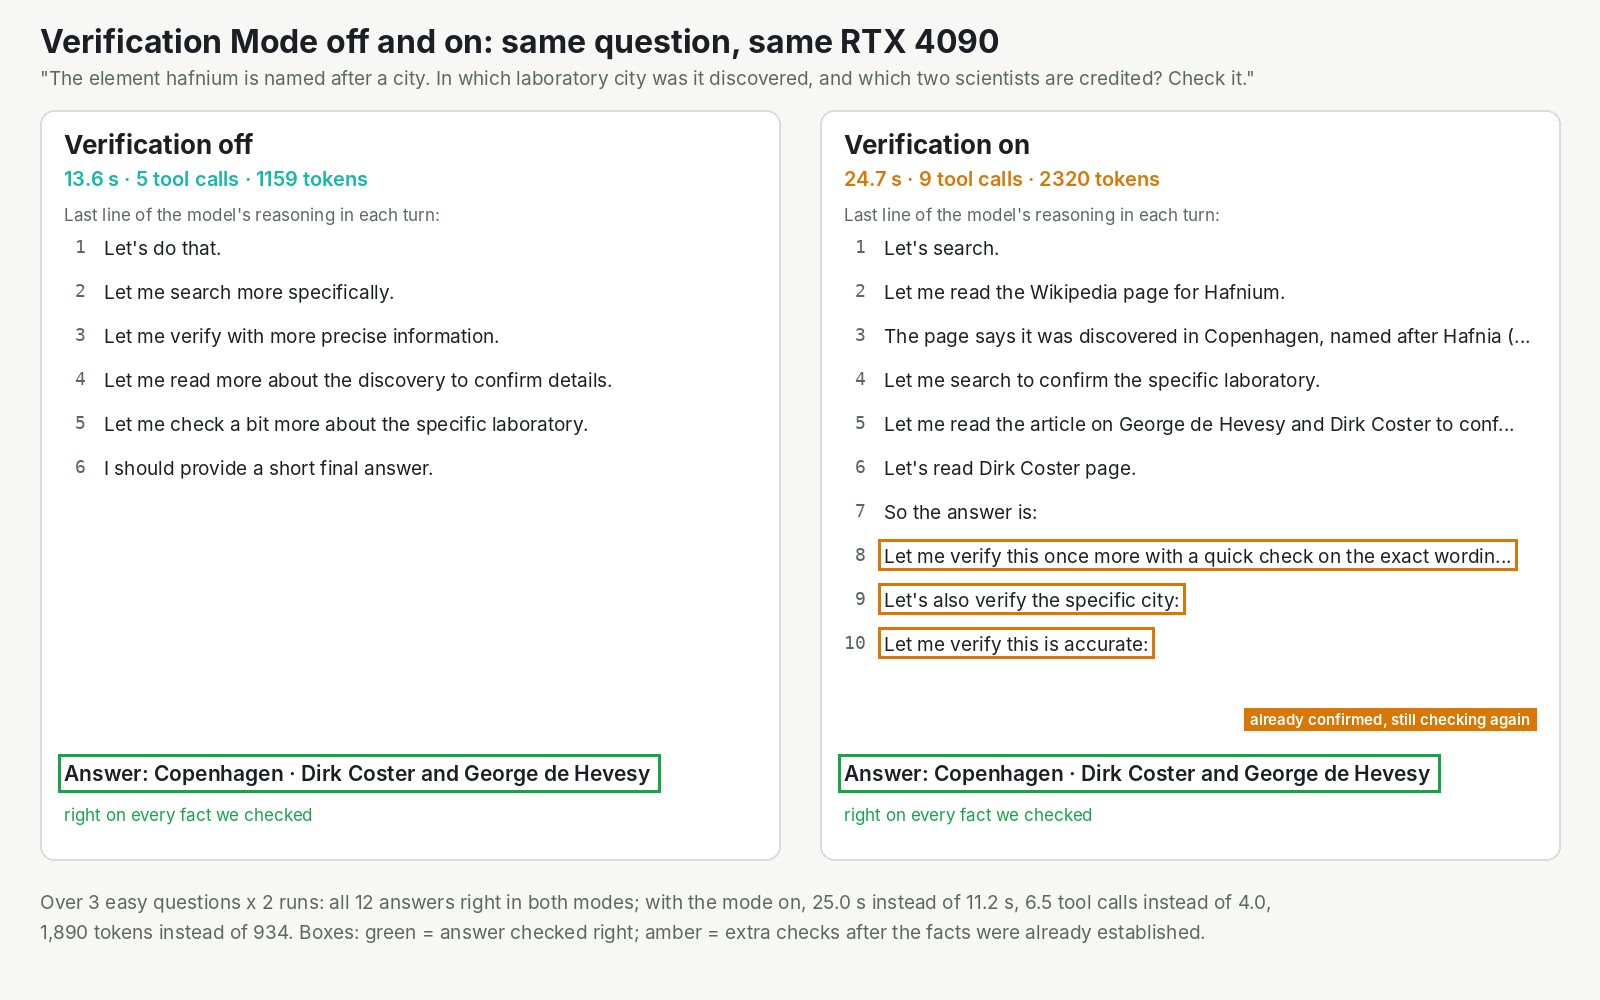
Una pregunta, hecha dos veces en la misma tarjeta. Las dos respuestas fueron correctas. Con el modo encendido, el modelo siguió comprobando datos que ya había leído.
Un modelo grande que trabaja como uno pequeño
Sage-A1.5 es un modelo mixture-of-experts: imagina 256 especialistas y un generalista que siempre está en la sala. Para cada palabra que escribe, consulta a 8 especialistas mientras el resto espera. Así que, de 35B parámetros, solo unos 3B trabajan en cada paso, según la página del proyecto. La velocidad va con los 3B y la factura de memoria con los 35B. Por eso entra en una sola tarjeta de 24 GB.
Lo construyó el Shanghai AI Laboratory a partir de dos modelos anteriores: el modelo abierto de 35B del equipo de Qwen y Agents-A1, el agente propio del laboratorio publicado en junio. El paper, de Wenjie Lou y 98 coautores, salió el 20 de octubre. El modelo completo y el fichero comprimido, de unos 22 GB, son Apache-2.0, de uso comercial gratuito y sin formulario que rellenar. El mérito del modelo es suyo. Nuestra parte fue el despliegue, las preguntas y las herramientas, y las mediciones.
Dos modos, que activas tú, lo convierten en un agente. Agentic Orchestration le da una herramienta para repartir tareas, así que puede mandar a tres ayudantes a la biblioteca a la vez. Verification Mode es una línea en sus instrucciones que le pide revisar su propio trabajo antes de responder.
Lo que encontró nuestra prueba
La pregunta de investigación era nuestra: cuántos años pasaron entre los descubrimientos del hafnio, el renio y el tecnecio. En cada ejecución, el modelo repartió tres tareas a la vez, una por elemento. Tres subagentes buscaron en páginas de Wikipedia en directo con dos herramientas que escribimos nosotros e informaron de vuelta. Después, el modelo principal redactó la respuesta: 1923, 1925 y 1937, 14 años del primero al último. Correcta en 3 de 3 ejecuciones de prueba.
Una ejecución tardó 72 segundos con el valor por defecto de nuestra plataforma, una petición cada vez, porque los subagentes esperaban en cola. Con dos a la vez, tardó 50 y 56 segundos. Ese valor por defecto sigue siendo uno.
La sorpresa vino con Verification Mode. En tres preguntas fáciles, hechas dos veces cada una, las 12 respuestas fueron correctas tanto con el modo apagado como encendido:
| Apagado | Encendido | |
|---|---|---|
| Respuestas correctas | 6 de 6 | 6 de 6 |
| Tiempo medio | 11,2 s | 25,0 s |
| Tokens escritos de media | 934 | 1.890 |
El trabajo extra era sobre todo repetición: turnos de "Let me verify" cuando los datos ya estaban confirmados. Eso no contradice a los autores. Ellos cuentan que el modo sube su puntuación en BrowseComp, una prueba de datos difíciles de encontrar en la web, del 72,5 % al 82,9 %. Las preguntas difíciles son donde una segunda mirada sale a cuenta.
A quién le interesa
- Equipos que quieren un agente que busque, lea e informe en su propio hardware. Funcionó en una RTX 4090 a velocidad completa, usando 21,3 de los 23,5 GiB de la tarjeta con nuestra configuración.
- Quien se preocupe por la precisión en preguntas difíciles. Prueba Verification Mode con tus propios casos difíciles, no con consultas sencillas.
- Equipos que necesitan respuestas de chat rápidas. Busca otra cosa. Una definición de dos frases tardó 14,4 segundos, porque antes razonó durante 1.905 tokens.
- Equipos con tarjetas de 16 GB o menos. Cuenta con una fracción de la velocidad. Cuando simulamos una tarjeta de 16 GB en la misma 4090, fue unas 5,6 veces más lento, y necesita bastante memoria principal.
En InferenceKey estaba sirviendo 104 segundos después de la llamada de despliegue, con el llama.cpp que nuestra plataforma ya incluye. Hay un tropiezo en la model card: su comando usa un ajuste de razonamiento, deepthink, que llama.cpp no tiene, y el servidor se cierra al arrancar. Escribe deepseek en su lugar. Estado: corregido en nuestro ejemplo, sigue en la card de los autores.
El límite honesto: hicimos un puñado de preguntas fáciles, respaldadas por Wikipedia, con un agente cada vez, así que esto comprueba la maquinaria, no la amplitud de su investigación.
Lee la prueba completa
El post de Research tiene las pruebas de prompt largo y de visión, la escalera de memoria de GPU, los benchmarks de los autores, cada aspereza con su estado y el ejemplo del SDK que lanza la misma pregunta en tu propia tarjeta. Lee la prueba completa de Sage-A1.5 en el post de Research.