Unlimited OCR 2 analyse un PDF entier en un seul appel, et un seul réglage décide si vous pouvez vous y fier
Unlimited OCR 2 a lu un guide de 59 pages en 3 min 44 s, à 4,2 % de son texte, tuiles de page désactivées. Avec les tuiles : 38,1 %.
Même modèle, même carte, mêmes 59 pages. Avec le réglage d'image par défaut des auteurs, le passage a pris 6 min 45 s et a rendu un texte à 38,1 % du texte propre du PDF. En changeant un seul flag, crop_mode=false, il a pris 3 min 44 s et s'est retrouvé à 4,2 %. Le modèle s'appelle Unlimited OCR 2, un analyseur de documents que Baidu a publié sous licence MIT. Il prend un PDF entier en une seule requête au lieu d'une page à la fois, donc le texte qui passe d'une page à l'autre peut rester d'un seul tenant. Pour qui transforme des PDF en données pour un moteur de recherche ou un assistant, c'est précisément là que les outils page par page se trompent. Ce que vous pouvez en faire : analyser de longs rapports et manuels sur une seule carte de 16 GB, à condition de désactiver les tuiles de page.
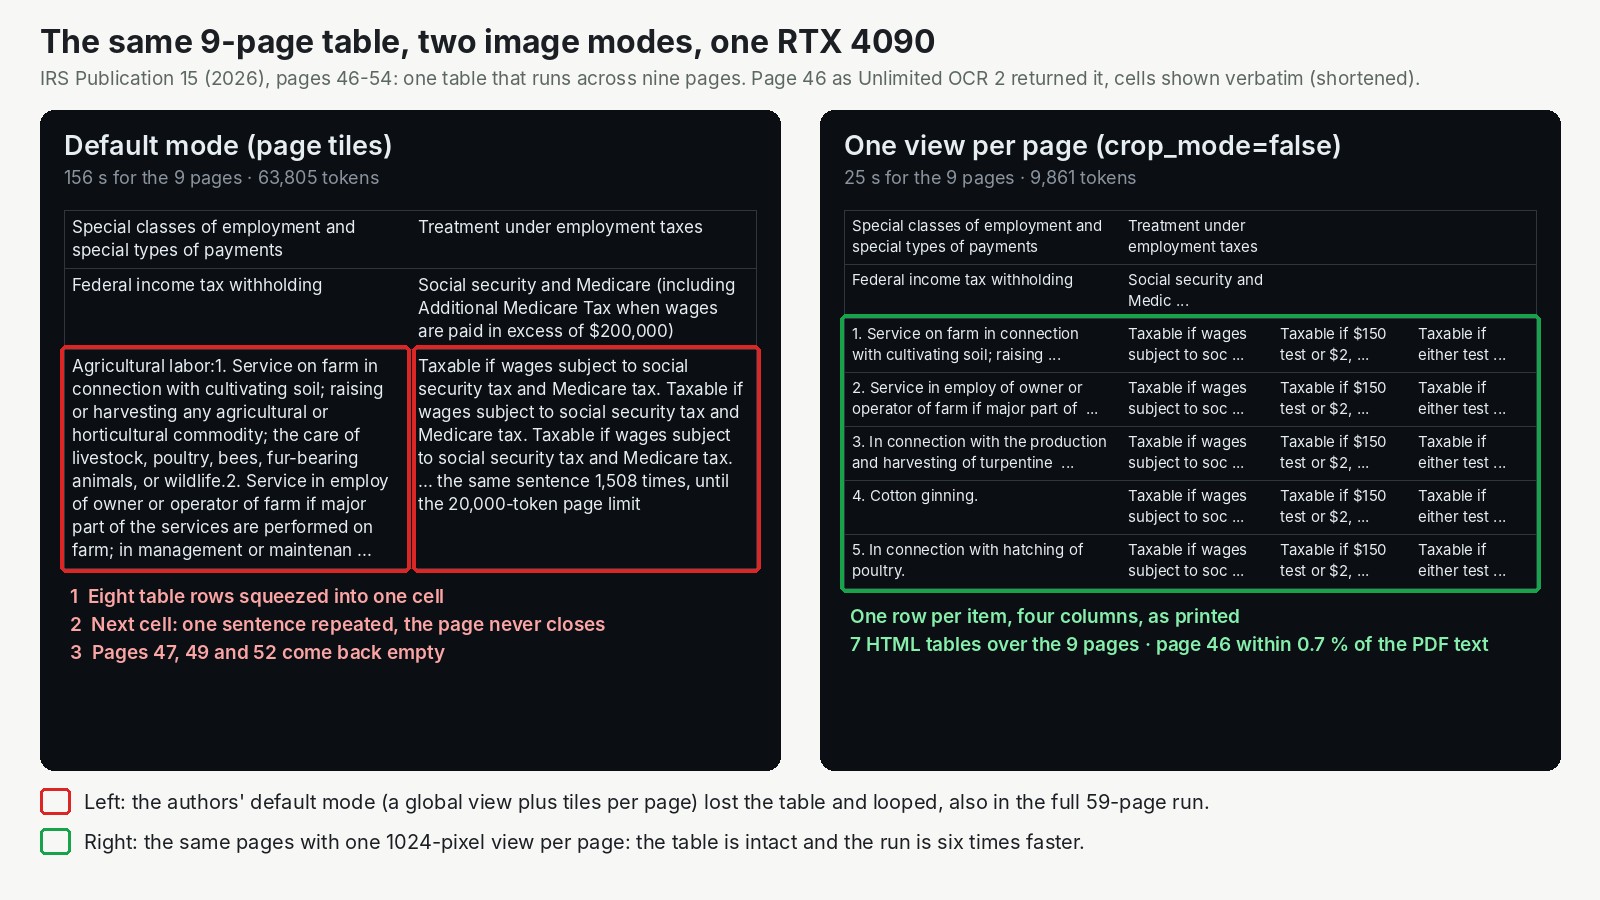
Les pages 46 à 54 seules, une carte. À gauche, les tuiles par défaut. À droite, une vue par page : six fois plus rapide, sans phrase répétée.
Un analyseur qui lit un document, pas une pile de pages
La plupart des chaînes de traitement de PDF découpent le fichier en pages, lisent chacune à part et recollent le texte ensuite. Tout ce qui chevauche un saut de page est coupé. Un tableau sur deux pages devient deux tableaux, et le second n'a pas d'en-tête.
Unlimited OCR 2 lit plusieurs pages ensemble. Montrer beaucoup de pages d'un coup à un modèle coûte d'habitude cher, puisque chaque page est une image. L'astuce de Baidu, selon la page du modèle, consiste à ne garder en vue qu'un nombre fixe de morceaux d'image, quelle que soit la longueur du document. D'après les auteurs, chaque nouveau mot coûte à peu près autant à la page 3 qu'à la page 300.
Le modèle est petit : 6,7 GB sur disque. La licence autorise l'usage commercial. Le mérite revient à l'équipe de Baidu, menée par les principaux contributeurs Shu Wei, Jingjing Wu et Qunyi Xie, qui sont partis de leur premier Unlimited OCR et de DeepSeek-OCR. Ils ont aussi livré une version modifiée de SGLang, le framework de service ouvert, avec une recette complète. Notre part : empaqueter ce serveur derrière une API et le tester sur un vrai document.
Ce qu'a trouvé notre test
L'IRS Publication 15, le guide fiscal des employeurs américains, fait 59 pages, est dans le domaine public, a des paragraphes qui chevauchent un saut de page sur la plupart des pages et un tableau qui court de la page 46 à la page 52. Nous avons envoyé le PDF entier en une seule requête sur une seule RTX 4090, une carte gaming de 24 GB de notre cloud, et noté la sortie par rapport à la couche texte du PDF lui-même : la part de caractères qu'il faudrait changer, 0 % voulant dire identique.
Le réglage qui compte, c'est la façon dont chaque page est montrée au modèle. Par défaut, chaque page est découpée en tuiles zoomées, en plus d'une image d'ensemble. crop_mode=false ne montre que l'image d'ensemble.
| PDF de 59 pages, une requête | Tuiles de page (par défaut) | Une vue par page |
|---|---|---|
| RTX 4090, document entier | 6 min 45 s | 3 min 44 s, 15,8 pages/min |
| Écart avec le texte du PDF | 38,1 % | 4,2 % |
| RTX 2000 Ada 16 GB, vraie carte | pas lancé sur les 59 pages | environ 10 minutes et demie, 4,23 % |
Sur le texte courant, les deux modes étaient bons : en laissant de côté les pages du tableau, les deux tournaient autour de 2,4 % d'écart, deux ou trois caractères sur cent. L'écart vient du tableau. En mode tuiles, la page 46 a tassé huit lignes dans une seule cellule, puis a écrit une phrase, "Taxable if wages subject to social security tax and Medicare tax", 1 508 fois. Une pédale de boucle que personne n'a coupée. Les pages 47, 50 et 52 sont revenues vides. Les pages 46 à 54 envoyées seules ont bouclé de la même façon, donc c'est le comportement du modèle, pas un accident de mémoire.
Avec une vue par page, le tableau est revenu en HTML en sept morceaux, un par page. La différence avec un analyseur page par page, ce sont les balises : cinq des six raccords portent une balise qui marque le morceau comme une suite. Ce sont ces balises dont un programme a besoin pour le recoudre en un seul tableau.
Une petite carte tient le coup. Une vraie RTX 2000 Ada, une carte de station de travail de 16 GB qui consomme 70 watts, a lu le guide entier avec une vue par page à 5,6 pages par minute, avec un pic à 13,8 GB. Sa qualité était la même que celle de la 4090.
Qui devrait s'y intéresser
- Les équipes qui analysent de longs rapports, manuels ou contrats où tableaux et paragraphes chevauchent les pages. Une requête par document renvoie le texte, les positions et les balises entre pages, sous une licence qui autorise l'usage commercial.
- Quiconque a de longs tableaux. Mettez
crop_mode=false, puis vérifiez les chiffres sur les pages du tableau : cinq d'entre elles restaient à 20 % à 46 % d'écart. - Quiconque garde les tuiles. Gardez les fenêtres par défaut de 10 pages et comptez les pages qui reviennent. En mode tuiles, une seule fenêtre pour tout le document a manqué de place et s'est arrêtée au milieu de la page 27, sans erreur.
- Les équipes sur petites cartes. 16 GB ont suffi pour un document comme le nôtre.
Sur InferenceKey, ce modèle n'a pas de support prêt à l'emploi, parce qu'il lui faut le serveur modifié de Baidu. Nous avons écrit un backend personnalisé, un court fichier Python qui l'installe et le lance sur votre machine GPU, et votre application l'appelle comme elle appelle l'API de chat d'OpenAI. Il était prêt en 61 à 143 secondes, fichiers en cache.
La limite honnête, une fois : c'était un seul document en anglais, 59 pages numériques propres, lu une fois par réglage, donc les scans ne sont pas testés et les centaines de pages que visent les auteurs restent leur affirmation, pas notre mesure.
Le test complet
L'article Research contient les scores page par page, l'échelle de VRAM, les limites de la plateforme et l'exemple avec le SDK. Lisez le test complet d'Unlimited OCR 2.