Groot-19B-A3B tient un prompt de 205K tokens sur une seule RTX 5090, avec moins de 600 MiB de marge
Groot-19B-A3B FP8 sur une RTX 5090 de 32 GB : la fenêtre complète de 262 144 tokens, 262 à 304 tokens/s, et aucun démarrage sous 24 GB.
Deux cent cinq mille tokens de prompt, une seule RTX 5090, et moins de 600 MiB de mémoire restante. C'est Groot-19B-A3B, un nouveau modèle ouvert pour agents signé GrootTeam, qui tourne avec sa fenêtre complète de 262 144 tokens (les « 256K ») sur une seule carte de 32 GB de notre cloud. Nous avons utilisé la version compressée des auteurs (FP8), de 20,9 GB, sur vLLM standard. Il a retrouvé une phrase que nous avions cachée à 60 % de ce prompt. Il a écrit 262 à 304 tokens par seconde pour une requête, et ses appels d'outils sont revenus en JSON propre. Pour une équipe qui déploie ses propres modèles, cela donne un agent avec une fenêtre d'un quart de million de tokens sur une seule carte de classe gaming que l'on peut posséder. Le hic, c'est la taille de la carte. Quand nous avons plafonné le même GPU à 24 GB, vLLM a refusé de démarrer, avec de la place pour environ 9 600 tokens. Prévoyez 32 GB.
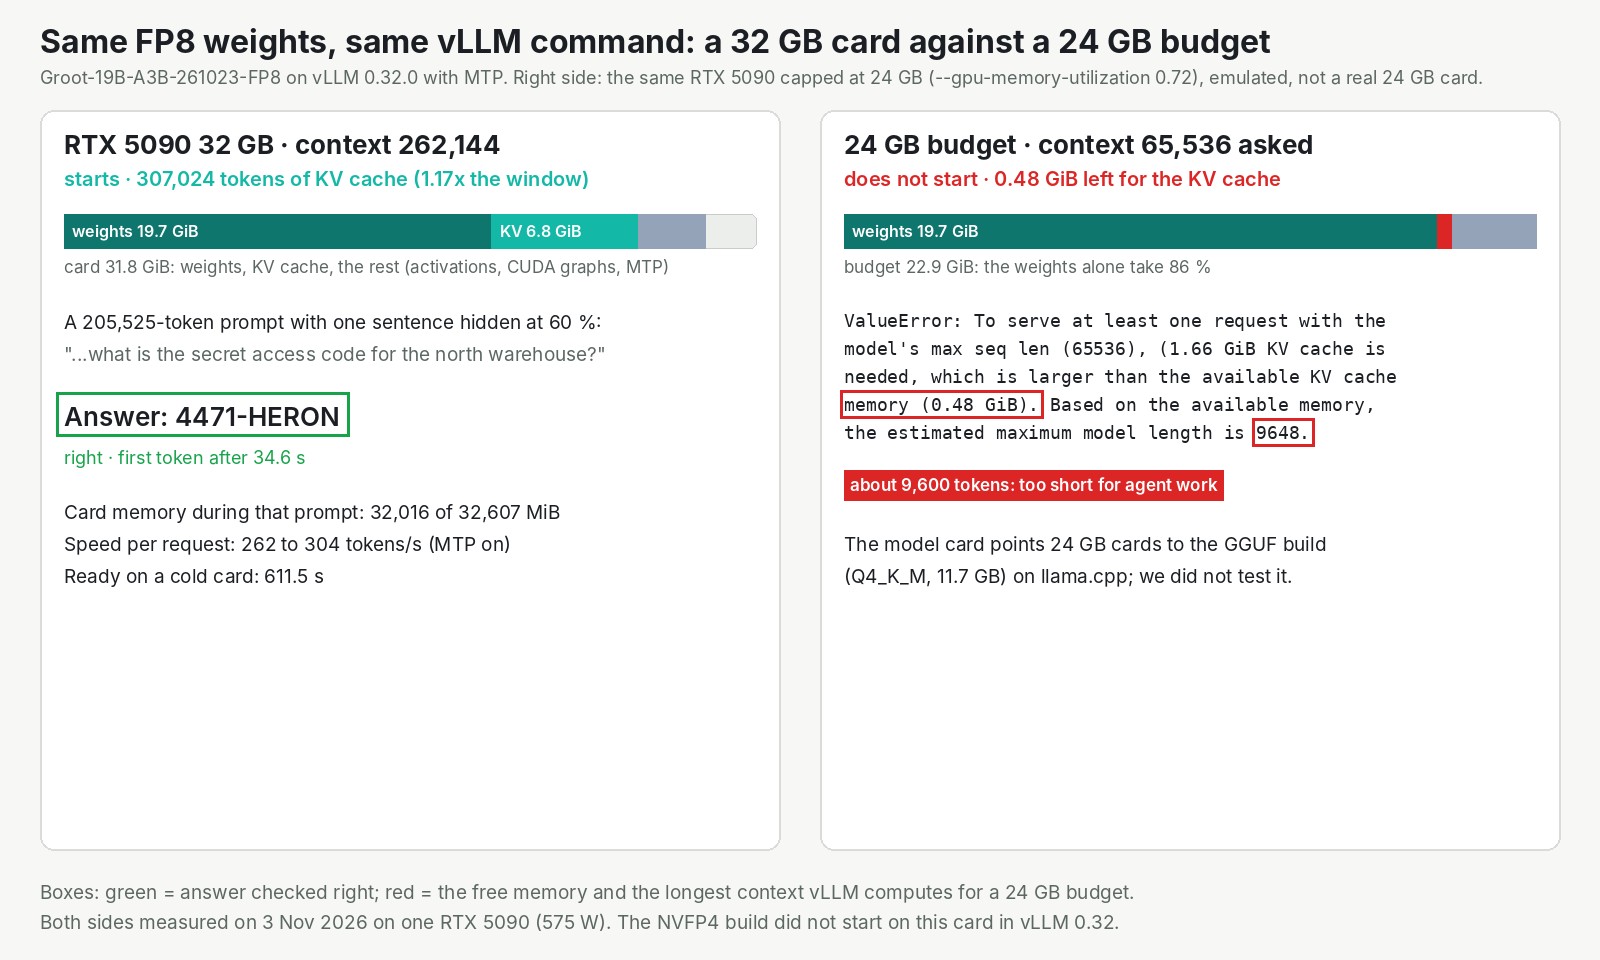
Mêmes poids, même commande, même carte. Avec ses 32 GB, il a bien répondu à un prompt de 205 525 tokens. Plafonné à 24 GB, il n'a pas démarré.
Un modèle pour agents de 19B taillé dans un parent de 35B
GrootTeam est parti de Qwen3.6-35B-A3B, le modèle ouvert de 35B de l'équipe Qwen, et l'a réduit à 19B. La page des auteurs ne dit pas comment. Ils l'ont réentraîné pour les agents sur une petite quantité de données ouvertes, moins de 0,1 milliard de tokens. Ils ont publié quatre versions le 23 octobre, et nous l'avons repéré dans la vidéo d'actualités d'AI Search du 1er novembre.
Il fonctionne comme une grande équipe où seuls quelques spécialistes traitent chaque mot. Environ 3 milliards de ses 19 milliards de paramètres travaillent sur chacun. Il écrit donc vite, mais le GPU doit contenir les 19 milliards.
Les auteurs le placent devant son propre parent. Dans leur tableau, il bat Qwen3.6-35B-A3B et Gemma-4-26B-A4B sur 12 benchmarks sur 16. Sur Terminal-Bench 2.1, où un agent travaille en ligne de commande, ils annoncent 52,1 contre 43,8 et 26,5. Ce sont leurs chiffres, face à des modèles ouverts de sa taille uniquement ; nous ne les avons pas reproduits. L'étiquette de licence indique Apache-2.0, qui autorise l'usage commercial, mais le fichier LICENSE lié est absent.
Le modèle est le travail de GrootTeam. Notre part : le déploiement, les tests et les mesures.
La fenêtre complète tient dans 32 GB, et 24 GB ne suffisent pas
Les auteurs estiment, à partir des tailles mémoire, que cette version fait tourner le contexte complet de 256K sur une seule RTX 5090. Nous sommes donc allés droit sur cette carte.
La mémoire d'un GPU paie deux choses. D'abord les poids du modèle, un coût fixe. Ensuite un bloc-notes qui garde la conversation, et qui grossit à chaque token de contexte. Groot garde l'architecture de Qwen3.6, donc son bloc-notes reste aussi petit que celui de son parent. Ce qui libère de la place, ce sont les poids : 19B au lieu de 35B.
Sur la carte de 32 GB, vLLM avait 6,8 GiB pour le bloc-notes une fois les poids chargés. De quoi tenir 307 024 tokens : la fenêtre complète plus environ 45 000 de marge. Puis le test de la phrase cachée. Nous avons enfoui le code d'accès d'un entrepôt à 60 % d'un prompt de 205 525 tokens. Le modèle a rendu 4471-HERON. Le premier mot est arrivé après 34,6 secondes, la réponse complète après 40,3. Au pic, la carte occupait 32 016 de ses 32 607 MiB. Imaginez un van de tournée avec l'ampli calé contre la porte : il roule, mais plus rien ne rentre.
| Budget mémoire sur la même RTX 5090 | Ce qui s'est passé |
|---|---|
| 32 GB, la vraie carte, 262 144 tokens | a démarré ; le prompt de 205 525 tokens a reçu la bonne réponse |
| 24 GB, émulés, 65 536 tokens demandés | n'a pas démarré ; 9 648 tokens au maximum |
| 16 GB, émulés, la version de 13,5 GB | n'a pas démarré ; une erreur logicielle au démarrage |
Sous le plafond de 24 GB, les poids seuls prenaient 86 % du budget. Il restait 0,48 GiB pour le bloc-notes. Environ 9 600 tokens, c'est trop court pour un agent qui lit des fichiers et des résultats d'outils, et les auteurs eux-mêmes recommandent de garder au moins 128K. Le passage à 16 GB a planté pour une raison logicielle, pas par manque de mémoire, donc il ne dit rien, ni dans un sens ni dans l'autre, sur ce qu'annoncent les auteurs pour cette version. Les deux plafonds ont été émulés sur la même 5090, pas sur de vraies cartes plus petites.
Des appels d'outils rapides et propres, et une longue réflexion avant chaque réponse
Une requête via notre API a tourné à 262 à 304 tokens par seconde. Une réponse de 4 457 tokens a pris environ 17 secondes, et la réponse a commencé en moins d'une seconde. Une partie de cette vitesse vient d'une petite couche supplémentaire que livrent les auteurs. Sans cette couche, vLLM écrivait 170 à 211 tokens par seconde.
L'appel d'outils a marché du premier coup. À la question de savoir s'il faisait plus chaud à Lisbonne ou à Oslo, il a appelé notre outil météo pour les deux villes en un seul tour, puis a répondu : « Lisbon is warmer right now with 19°C compared to Oslo's 4°C ». L'échange complet a pris 1,81 seconde, dans la forme qu'attend un framework d'agents.
Prévoyez le budget de la réflexion. Groot raisonne avant chaque réponse, et ce raisonnement compte comme sortie. « The capital of Australia, in one word » (la capitale de l'Australie, en un mot) a pris 111 à 131 tokens avant « Canberra ». Les auteurs désactivent la réflexion avec un réglage par requête, et notre API ne transmet pas encore ce réglage. Statut : ouvert de notre côté. Le contournement consiste à démarrer le serveur avec la réflexion désactivée par défaut, un flag d'une ligne montré dans le README de notre exemple.
Sur InferenceKey, il n'a eu besoin d'aucun moteur sur mesure : le backend vLLM standard et les réglages des auteurs. Il était prêt 611,5 secondes après l'appel de déploiement, sur une machine neuve.
À qui ça sert
- Les équipes qui veulent un long contexte sur du matériel à elles. Une seule RTX 5090 de 32 GB a fait tourner la fenêtre complète à cette vitesse. Un agent seul a droit à la fenêtre complète ; plusieurs agents en même temps doivent chacun se contenter d'une fenêtre plus courte.
- Les équipes sur des cartes de 24 GB. Passez votre chemin sur la version de 20,9 GB. Les auteurs suggèrent leur version de 11,7 GB, que nous n'avons pas testée.
- Les équipes qui ont besoin de réponses de chat rapides. Prévoyez la réflexion qui précède chaque réponse, et fixez une limite de tokens généreuse.
La limite honnête : un GPU, une requête à la fois, nos propres prompts et quelques passages chacun. Cela vérifie donc que ça tient et à quelle vitesse, pas son savoir-faire sur une session d'agent en plusieurs étapes.
Lisez le test complet
L'article Research contient les chiffres de mémoire, les mesures de vitesse, les benchmarks des auteurs, chaque point faible avec son statut et l'exemple avec le SDK pour votre propre GPU. Lisez le test complet de Groot-19B-A3B dans l'article Research.