Groot-19B-A3B hält einen Prompt mit 205K Tokens auf einer RTX 5090, mit weniger als 600 MiB Reserve
Groot-19B-A3B in FP8 auf einer 32-GB-RTX 5090: das volle Fenster von 262.144 Tokens, 262 bis 304 Tokens/s, und unter einer 24-GB-Grenze kein Start.
Zweihundertfünftausend Tokens Prompt, eine RTX 5090 und weniger als 600 MiB Speicher übrig. Das ist Groot-19B-A3B, ein neues offenes Agentenmodell von GrootTeam, das sein volles Fenster von 262.144 Tokens (die "256K") auf einer einzigen 32-GB-Karte in unserer Cloud fährt. Wir haben den komprimierten 20,9-GB-Build der Autoren (FP8) auf unverändertem vLLM genutzt. Es fand einen Satz, den wir bei 60 % dieses Prompts versteckt hatten. Es schrieb 262 bis 304 Tokens pro Sekunde für eine Anfrage, und seine Tool-Calls kamen als sauberes JSON zurück. Für ein Team, das seine eigenen Modelle betreibt, heißt das: ein Agent mit einem Fenster von einer Viertelmillion Tokens auf einer einzigen Karte der Gaming-Klasse, die Sie besitzen können. Der Haken ist die Größe der Karte. Als wir dieselbe GPU auf 24 GB begrenzt haben, verweigerte vLLM den Start, mit Platz für etwa 9.600 Tokens. Planen Sie mit 32 GB.
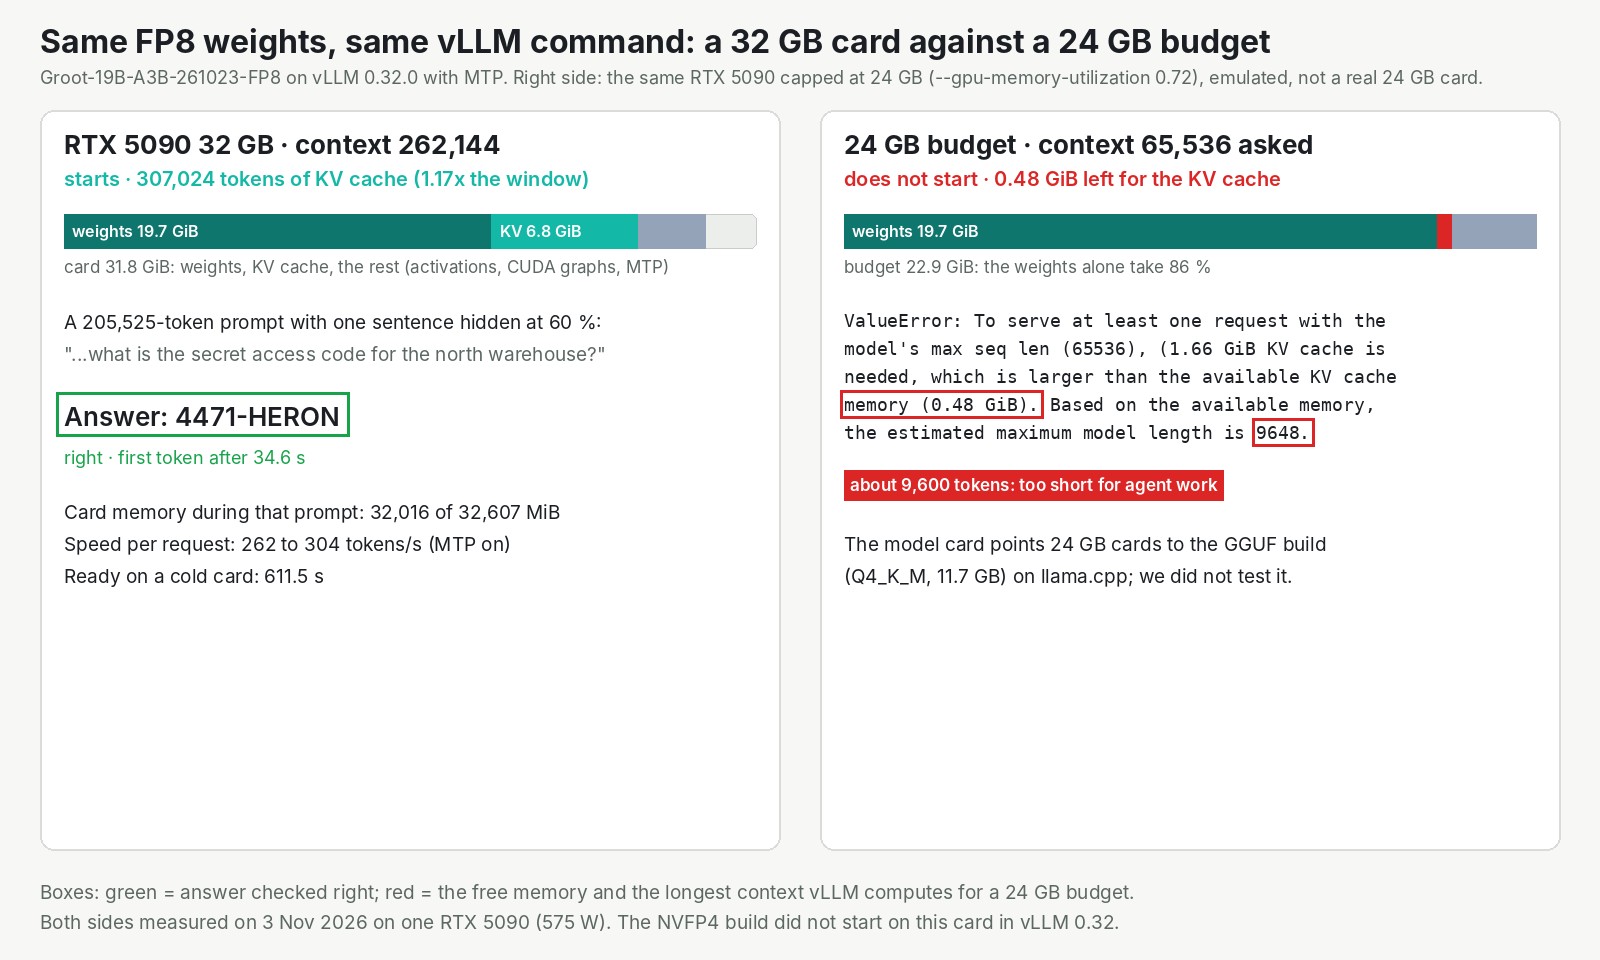
Dieselben Gewichte, derselbe Befehl, dieselbe Karte. Mit allen 32 GB beantwortete es einen Prompt mit 205.525 Tokens richtig. Auf 24 GB begrenzt, startete es nicht.
Ein 19B-Agentenmodell, aus einem 35B-Vorgänger geschnitten
GrootTeam ging von Qwen3.6-35B-A3B aus, dem offenen 35B-Modell des Qwen-Teams, und schnitt es auf 19B zurück. Wie, sagt die Seite der Autoren nicht. Sie haben es mit einer kleinen Menge offener Daten für Agenten nachtrainiert, weniger als 0,1 Milliarden Tokens. Sie veröffentlichten am 23. Oktober vier Builds, und wir sind im News-Video von AI Search vom 1. November darauf gestoßen.
Es arbeitet wie ein großes Team, in dem nur wenige Spezialisten jedes Wort bearbeiten. Etwa 3 Milliarden seiner 19 Milliarden Parameter arbeiten an jedem einzelnen. Es schreibt also schnell, aber die GPU muss alle 19 Milliarden halten.
Die Autoren sehen es vor seinem eigenen Vorgänger. In ihrer Tabelle schlägt es Qwen3.6-35B-A3B und Gemma-4-26B-A4B in 12 von 16 Benchmarks. Bei Terminal-Bench 2.1, wo ein Agent auf der Kommandozeile arbeitet, melden sie 52,1 gegenüber 43,8 und 26,5. Das sind ihre Zahlen, nur gegen offene Modelle seiner Größe; wir haben sie nicht nachgemessen. Das Lizenz-Tag nennt Apache-2.0, was kommerzielle Nutzung erlaubt, allerdings fehlt die verlinkte LICENSE-Datei.
Das Modell ist die Arbeit von GrootTeam. Unser Teil waren das Deployment, die Tests und die Messungen.
Das volle Fenster passt in 32 GB, und 24 GB reichen nicht
Die Autoren schätzen anhand der Speichergrößen, dass dieser Build den vollen 256K-Kontext auf einer RTX 5090 fährt. Also sind wir direkt zu dieser Karte gegangen.
Der Speicher einer GPU bezahlt zwei Dinge. Das eine sind die Gewichte des Modells, ein fester Posten. Das andere ist ein Notizblock, der das Gespräch festhält, und er wächst mit jedem Token Kontext. Groot behält den Aufbau von Qwen3.6, sein Notizblock bleibt also so klein wie der seines Vorgängers. Was den Platz freimacht, sind die Gewichte, 19B statt 35B.
Auf der 32-GB-Karte blieben vLLM nach dem Laden der Gewichte 6,8 GiB für den Notizblock. Das reicht für 307.024 Tokens: das volle Fenster plus etwa 45.000 Reserve. Dann der Test mit dem versteckten Satz. Wir haben den Zugangscode für ein Lager bei 60 % eines Prompts mit 205.525 Tokens vergraben. Das Modell gab 4471-HERON zurück. Das erste Wort kam nach 34,6 Sekunden, die vollständige Antwort nach 40,3. An der Spitze belegte die Karte 32.016 ihrer 32.607 MiB. Stellen Sie sich einen Tourbus vor, in dem der Verstärker gegen die Tür klemmt: Er fährt, aber sonst passt nichts mehr hinein.
| Speicherbudget auf derselben RTX 5090 | Was passiert ist |
|---|---|
| 32 GB, die echte Karte, 262.144 Tokens | gestartet; der Prompt mit 205.525 Tokens richtig beantwortet |
| 24 GB, emuliert, 65.536 Tokens verlangt | nicht gestartet; höchstens 9.648 Tokens |
| 16 GB, emuliert, der 13,5-GB-Build | nicht gestartet; ein Softwarefehler beim Start |
Unter der 24-GB-Grenze nahmen allein die Gewichte 86 % des Budgets ein. Für den Notizblock blieben 0,48 GiB. Rund 9.600 Tokens sind zu kurz für einen Agenten, der Dateien und Tool-Ergebnisse liest, und die Autoren selbst empfehlen, mindestens 128K zu behalten. Der 16-GB-Lauf stürzte aus einem Softwaregrund ab, nicht aus Speichermangel, er sagt also weder für noch gegen die Angabe der Autoren zu diesem Build etwas aus. Beide Grenzen wurden auf derselben 5090 emuliert, es waren keine echten kleineren Karten.
Schnelle, saubere Tool-Calls und langes Nachdenken vor jeder Antwort
Eine Anfrage über unsere API lief mit 262 bis 304 Tokens pro Sekunde. Eine Antwort mit 4.457 Tokens dauerte etwa 17 Sekunden, und sie begann nach weniger als einer Sekunde. Ein Teil dieses Tempos kommt von einer kleinen Zusatzschicht, die die Autoren mitliefern. Mit dieser Schicht aus schrieb vLLM 170 bis 211 Tokens pro Sekunde.
Tool-Calling funktionierte beim ersten Versuch. Auf die Frage, ob es in Lissabon oder in Oslo wärmer sei, rief es unser Wetter-Tool in einem Zug für beide Städte auf und antwortete dann: "Lisbon is warmer right now with 19°C compared to Oslo's 4°C". Der ganze Austausch dauerte 1,81 Sekunden, in der Form, die ein Agenten-Framework erwartet.
Rechnen Sie das Nachdenken ein. Groot denkt vor jeder Antwort nach, und dieses Nachdenken zählt als Ausgabe. Die Frage "The capital of Australia, in one word" kostete 111 bis 131 Tokens vor "Canberra". Die Autoren schalten das Nachdenken mit einer Einstellung pro Anfrage ab, und unsere API reicht diese Einstellung noch nicht durch. Status: bei uns offen. Der Workaround ist, den Server so zu starten, dass das Nachdenken standardmäßig aus ist, ein einzeiliges Flag, das im README unseres Beispiels steht.
Auf InferenceKey brauchte es keine eigene Engine: das unveränderte vLLM-Backend und die Einstellungen der Autoren. Auf einer frischen Maschine war es 611,5 Sekunden nach dem Deploy-Aufruf bereit.
Für wen das relevant ist
- Teams, die einen langen Kontext auf eigener Hardware wollen. Eine einzige 32-GB-RTX 5090 fuhr das volle Fenster mit diesem Tempo. Ein Agent bekommt das volle Fenster; mehrere Agenten gleichzeitig müssen sich jeweils mit einem kürzeren begnügen.
- Teams mit 24-GB-Karten. Lassen Sie den 20,9-GB-Build aus. Die Autoren schlagen ihren 11,7-GB-Build vor, den wir nicht getestet haben.
- Teams, die schnelle Chat-Antworten brauchen. Rechnen Sie das Nachdenken vor jeder Antwort ein und setzen Sie ein großzügiges Token-Limit.
Die ehrliche Grenze: eine GPU, eine Anfrage nach der anderen, unsere eigenen Prompts und jeweils wenige Läufe. Das prüft also, ob es passt und wie schnell es ist, nicht, wie gut es sich über eine mehrstufige Agenten-Sitzung schlägt.
Der vollständige Test
Der Research-Beitrag enthält die Speicherzahlen, die Tempo-Läufe, die Benchmarks der Autoren, jede raue Stelle mit ihrem Status und das SDK-Beispiel für Ihre eigene GPU. Lesen Sie den vollständigen Test von Groot-19B-A3B im Research-Beitrag.