Hy-SimulMT hält mit dem Sprecher Schritt, auf einer 48-GB-Karte, aber von Englisch nach Chinesisch fallen Sätze weg
Tencents offener Live-Dolmetscher auf einer 48-GB-RTX 6000 Ada: erste Wörter nach 2,3 bis 5,5 s, solide ins Englische, holprig ins Chinesische.
Chinesisch rein, Englisch raus: In unserem ersten Clip war jeder Satz etwa 2 Sekunden, nachdem der Sprecher ihn beendet hatte, übersetzt. Englisch rein, Chinesisch raus: Ein Clip verlor zwei seiner sechs Sätze. Beide Ergebnisse stammen aus demselben Setup, Hy-SimulMT, dem offenen Modell von Tencent Hunyuan für Live-Dolmetschen zwischen Chinesisch und Englisch, auf einer einzigen 48-GB-RTX 6000 Ada in unserer Cloud. Über vier Test-Clips kamen die ersten übersetzten Wörter nach 2,3 bis 5,5 Sekunden, während der Sprecher noch redete. Für ein Team, das seine eigenen Modelle betreibt, heißt das: ein Live-Dolmetscher auf einer einzigen Karte, die Sie besitzen oder mieten. Der Ton des Meetings und seine Übersetzung verlassen sie nie. Das Modell lief in 38 GB der Karte, und ein Klon der Stimme des Sprechers füllte den Rest. Nutzen Sie es jetzt für Chinesisch nach Englisch. Testen Sie Englisch nach Chinesisch mit Ihrem eigenen Audio, bevor sich jemand darauf verlässt.
Ein Dolmetscher in der Kabine, keine Staffel
Die meiste Sprachübersetzung ist eine Staffel: Ein Programm schreibt mit, was gesagt wurde, ein zweites übersetzt den fertigen Text, und die Verzögerung wächst mit jedem langen Satz.
Hy-SimulMT hört zu und übersetzt im selben Modell, wie die Person in der Dolmetscherkabine auf einer Konferenz. Es hört ein Stück Sprache und entscheidet, ob es genug hat, um etwas zu sagen. Ein kleiner Dienst derselben Autoren, SimulInfer, füttert es mit Audio in Stücken von 1,6 Sekunden und setzt die Teile zusammen.
Tencent Hunyuan hat es am 26. Oktober unter Apache-2.0 veröffentlicht, was kommerzielle Nutzung erlaubt. Es ist ein 30B-Modell, in dem nur etwa 3 Milliarden Parameter an jedem Wort arbeiten: ein großes Team von Spezialisten, von denen pro Wort eine Handvoll gefragt wird. Das hält es schnell, aber die Karte muss trotzdem das ganze Team halten. Wir haben einen komprimierten 32-GB-Build getestet.
Zwei Grenzen vorweg. Es kann nur Chinesisch nach Englisch und Englisch nach Chinesisch, auch wenn seine Download-Seite 40 Sprachen aufführt. Und es spricht nicht selbst: Für gesprochene Ausgabe braucht es ein zweites Modell, Qwen3-TTS, das daneben läuft.
Die Autoren sagen, es lag bei langen aufgezeichneten Vorträgen etwa 3 Sekunden hinter dem Sprecher, der niedrigste Wert in ihrem Vergleich. Wir sind im News-Video von AI Search vom 1. November darauf gestoßen und haben die Tests der Autoren nicht nachgefahren.
Es hielt in beide Richtungen Schritt
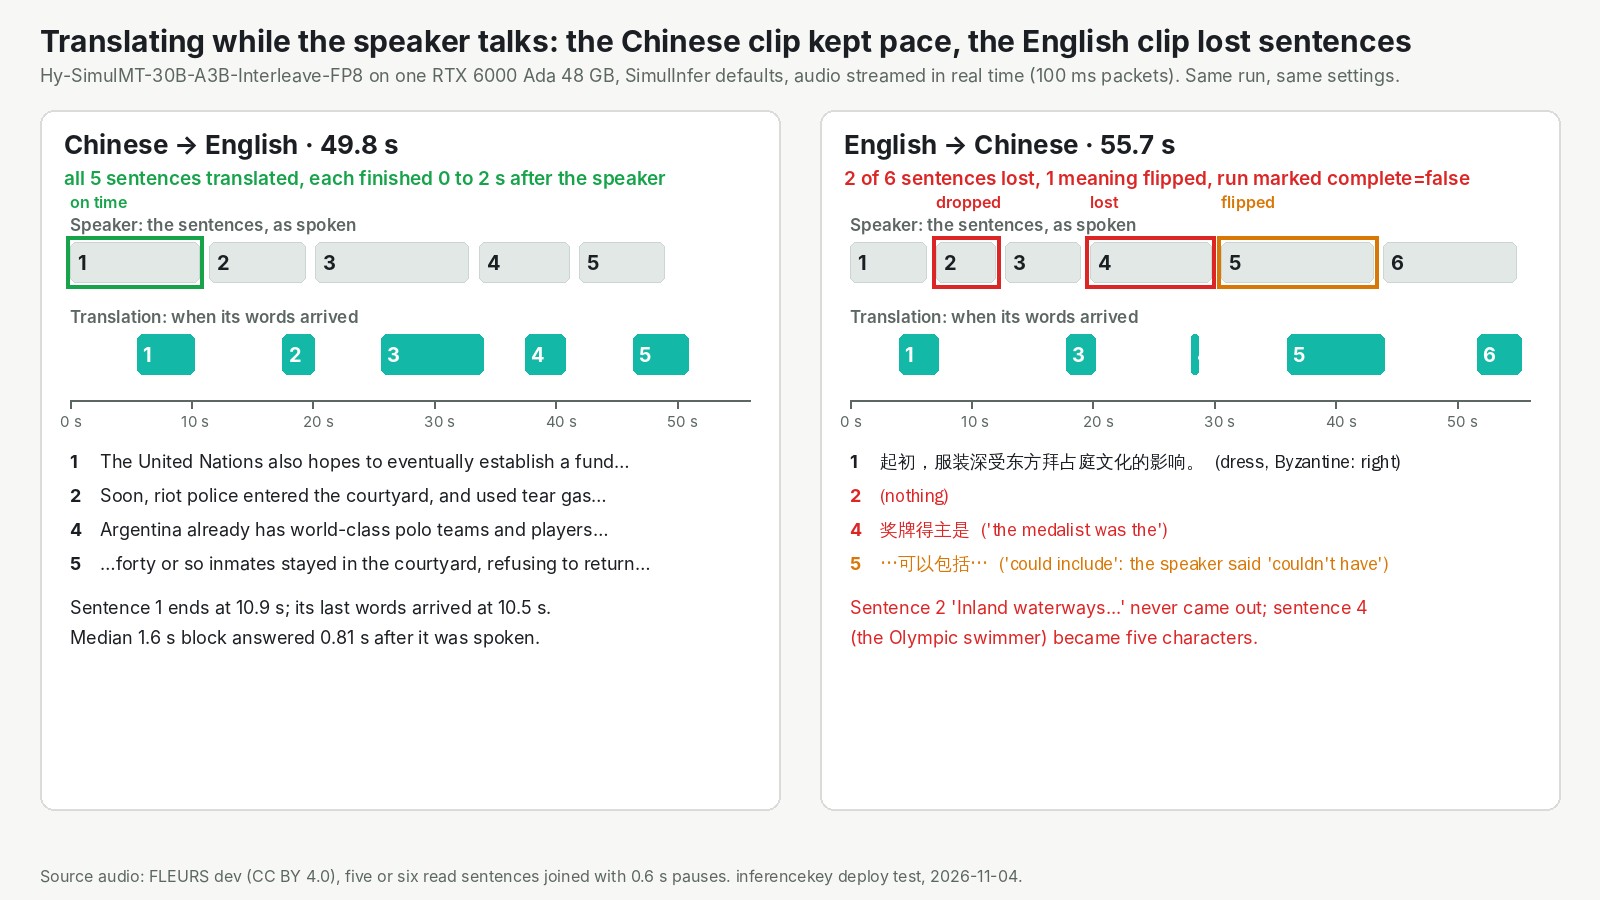
Wir haben aus FLEURS, einem öffentlichen Satz vorgelesener Sätze, vier Clips von 50 bis 56 Sekunden gebaut und jeden in Zehntelsekunden-Stücken in normalem Sprechtempo gestreamt, so wie es ein Mikrofon tun würde. Ein typisches Audio-Stück wurde in allen vier Clips 0,4 bis 0,8 Sekunden nach seinem Ende beantwortet. Im ersten chinesischen Clip endete der erste Satz bei 10,9 Sekunden, und seine Übersetzung war schon bei 10,5 fertig.
| Clip | Erste Wörter | Qualitätswert (0 bis 100) | Fertig? |
|---|---|---|---|
| Chinesisch 1 nach Englisch | 5,5 s | 60,6 | ja |
| Chinesisch 2 nach Englisch | 2,3 s | 51,7 | ja |
| Englisch 1 nach Chinesisch | 4,4 s | 42,2 | ja |
| Englisch 2 nach Chinesisch | 4,0 s | 23,4 | nein |
Der Wert misst, wie nah die Formulierung an menschlichen Übersetzungen liegt. Als Anhaltspunkt: Ein kleinerer Build, der jeden Satz des ersten chinesischen Clips richtig hatte, kam auf 66.
Das Tempo war gleichmäßig, die Genauigkeit nicht. Der Clip mit 23,4 verlor einen Satz über Binnenwasserstraßen komplett, und ließ ihn auch beim zweiten Durchlauf wieder weg. Ein anderer drehte seine Bedeutung um: Der Sprecher sagte "couldn't have included", und die Übersetzung sagt "could include". Ein falsches "could" klingt völlig flüssig. Als ganze Datei hochgeladen, kam derselbe Clip ebenfalls unvollständig zurück, das Live-Setup ist also nicht die einzige Ursache.
Die Stimme füllt die Karte, und eine echte 48-GB-Karte ist die belegte Größe
Der Stimmklon kopiert die Stimme des Sprechers aus den ersten paar Sekunden seiner eigenen Rede und liest die Übersetzung damit vor. Er läuft als Qwen3-TTS-0.6B, vom Qwen-Team von Alibaba, auf derselben Karte. Im ersten chinesischen Clip kam die erste englische Sprache nach 8,7 Sekunden heraus, und der Text hielt sein Tempo. Die belegte Karte ging von 38 GB auf 48 GB. Englisch nach Chinesisch mit eingeschalteter Stimme hat nie geantwortet. Status: offen, nicht untersucht.
Günstigere Karten sind nicht belegt. Unter einer simulierten 32-GB-Grenze übersetzte es beide Test-Clips im selben Live-Tempo, aber der Start belegt in jedem Lauf kurz die ganze Karte, eine echte 32-GB-Karte kann also beim Start scheitern. Der 4-Bit-Build der Autoren lief in etwa 21 GB, nur für fertige Dateien.
Auf InferenceKey braucht dieses Modell mehr als einen einfachen Modellserver, also haben wir Python-Code geschrieben, der es mit SimulInfer installiert und beides startet. Ein erstes Deployment auf einer frischen Maschine war in etwa 6 Minuten oben, ein Neustart in 73 Sekunden. SimulInfer hat den komprimierten Build nicht erkannt, also schreibt unser Code die kleine Datei, nach der es sucht. Status: in unserem Beispiel behoben. Eine Grenze liegt bei uns: Unsere API nimmt eine hochgeladene Datei von bis zu etwa einer Minute und spielt sie in Sprechtempo ab, ein Live-Mikrofon geht also noch nicht durch. Status: offen.
Das Modell, SimulInfer und die Benchmarks sind die Arbeit von Tencent Hunyuan. Unser Teil waren das Deployment, der Streaming-Testaufbau und die Messungen.
Für wen das wichtig ist
- Teams, die live Chinesisch nach Englisch auf eigener Hardware brauchen. Das ist eine starke offene Option auf einer 48-GB-Karte.
- Teams, die Englisch nach Chinesisch brauchen. Testen Sie es zuerst mit Ihrem eigenen Audio, und achten Sie auf umgedrehte Verneinungen.
- Teams, die auch die Stimme des Sprechers wollen. Planen Sie vorerst mit der vollen 48-GB-Karte und nur der Richtung Chinesisch nach Englisch.
- Teams, die irgendeine andere Sprache brauchen. Das ist nicht Ihr Modell.
Die ehrliche Grenze: vier vorgelesene Clips, jeweils eine Sitzung, also sind lange Vorträge, spontane Rede, Akzente und laute Räume noch ungetestet.
Den vollständigen Test lesen
Der Research-Beitrag enthält die Zeitachsen, die Speicherstufen, jede raue Stelle und das SDK-Beispiel für Ihre eigene GPU. Lesen Sie den vollständigen Test von Hy-SimulMT im Research-Beitrag.