Clover-35B-A3B escribe 208 tokens/s en una sola tarjeta de 24 GB, de momento como un modelo normal
El LLM de difusión de DiffuSpace en llama.cpp de serie y una RTX 4090: 208 tokens/s y 128K de contexto tras un parche de 17 s, sin el modo paralelo.
Doscientos ocho tokens por segundo, en una sola RTX 4090 de nuestra nube. Eso nos dio Clover-35B-A3B-Preview, el modelo de lenguaje de difusión abierto de DiffuSpace, en llama.cpp v0.9.0 de serie, la versión del motor gratuito que lo incorporó esta semana. También leyó prompts de hasta su ventana completa de 128K (una novela corta) con 21,4 de los 24 GB de la tarjeta. Para un equipo que despliega sus propios modelos, eso es un nuevo modelo abierto para agentes en una sola tarjeta que puedes tener en propiedad o alquilar, hoy mismo. La pega está en las notas de la versión: el soporte es solo "AR mode", así que Clover escribe un token cada vez, como cualquier otro modelo. El truco en paralelo que hay detrás de los 515 tokens por segundo de DiffuSpace no está en ese código. Y el fichero oficial necesita un parche de 17 segundos antes de responder nada con sentido. Pruébalo en una tarjeta de 24 GB para trabajo con agentes. No compres hardware por la velocidad de la difusión todavía.
Hecho para rellenar bloques, ejecutado como un mecanógrafo
Un modelo de lenguaje normal funciona como un mecanógrafo: un token, luego el siguiente, y cada uno espera al anterior. Clover se entrenó para trabajar más bien como alguien que rellena un crucigrama. Prepara un bloque de 32 casillas vacías, rellena en una pasada todas las casillas de las que está seguro al menos al 95% y vuelve a por el resto. Menos pasadas significan más texto por segundo, si el software hace el crucigrama.
Clover es el primer lanzamiento de DiffuSpace, derivado de Qwen3.6-35B-A3B, un modelo abierto del equipo Qwen de Alibaba. De sus 35B parámetros, unos 3B trabajan en cada token: 256 especialistas, y cada palabra consulta a 8 más un generalista. La licencia es Apache-2.0, así que el uso comercial está permitido.
El blog de DiffuSpace habla de 515 tokens por segundo en una sola tarjeta de centro de datos H200, frente a 365 de un modelo Qwen acelerado de tamaño parecido, y de 680 en una GB300. Las dos cifras usaron el modelo completo sin comprimir, sin decir qué software ni qué modo.
Aquí está la diferencia. El soporte de llama.cpp, la pull request #31306 de Maphist0, se fusionó el 2 de noviembre y salió en la v0.9.0 el 4 de noviembre, en AR mode: el mecanógrafo. Los modos rápidos están en otra parte. El código Python de la propia DiffuSpace necesita unos 69 GB solo para los pesos, así que una tarjeta de 80 GB. Una pull request de SGLang de Zirui Wu (#46927) añade un modo de adivinar y luego comprobar y da 453,59 tokens por segundo en una sola H200, pero sigue abierta, pendiente de revisión. Nosotros medimos lo que da hoy una sola tarjeta.
El fichero oficial necesita antes un parche de 17 segundos
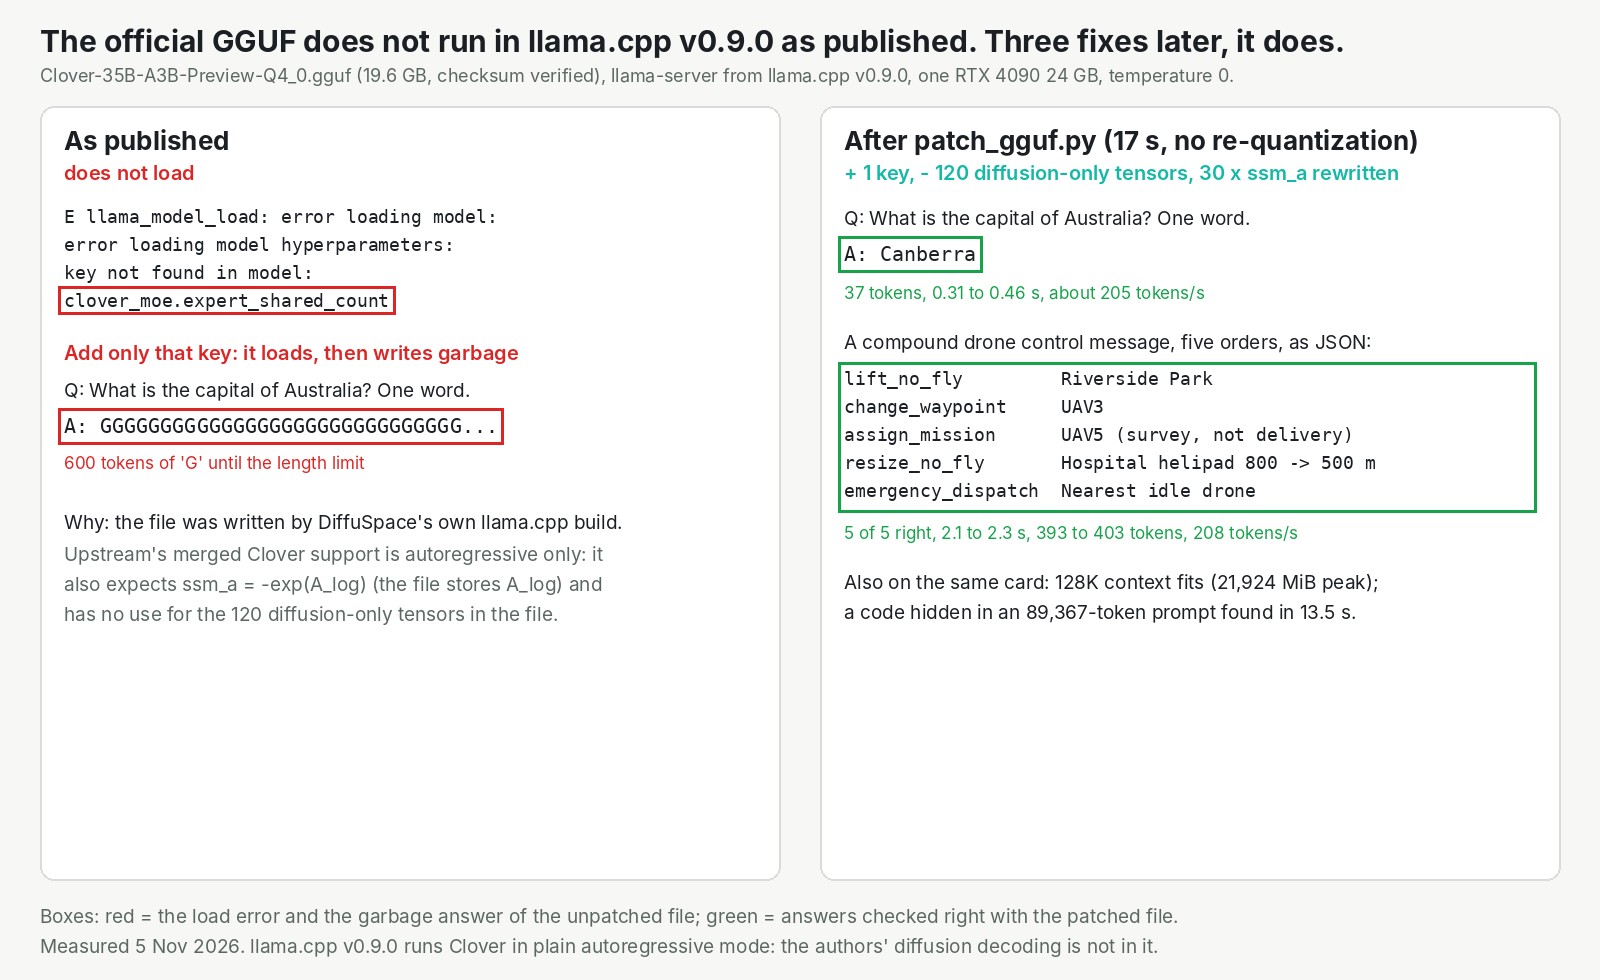
Tal como se publicó, llama.cpp v0.9.0 se niega a cargar el fichero: key not found in model: clover_moe.expert_shared_count. Añadimos solo esa etiqueta. El modelo cargó y, cuando le preguntamos por la capital de Australia, respondió con 600 copias de la letra G, una nota sostenida como el acople de una guitarra.
DiffuSpace escribió el fichero con su propia compilación de llama.cpp, que se diferencia de la oficial en tres detalles pequeños. Nuestro script, patch_gguf.py, corrige los tres y copia tal cual todos los demás bytes, así que no se vuelve a comprimir nada. Tardó 17 segundos con el fichero de 19,6 GB. Después, la respuesta fue Canberra. Estado: resuelto en nuestro ejemplo del SDK, todavía abierto en los ficheros de DiffuSpace y en llama.cpp.
Unos 208 tokens por segundo, y entra la ventana entera de 128K
Con el fichero parcheado, Clover escribió entre 202 y 211 tokens por segundo con una sola petición, y el primer token llegó en 0,13 a 0,31 segundos.
| Lo que pedimos | Lo que devolvió | Tiempo |
|---|---|---|
| Un mensaje compuesto de despacho de drones, cinco pedidos | 5 de 5 correctos, en JSON limpio, en cada ejecución | 2,1 a 2,3 s |
| "Is it warmer in Lisbon or in Oslo?" con una herramienta del tiempo | Dos llamadas a herramientas a la vez, las dos válidas | 1,29 s |
| Un escritorio completo en un solo fichero HTML | Una página que funciona, con una calculadora que dice 7 x 6 = 42 | 20,3 s |
| Un código escondido en un prompt de 89.367 tokens | Encontrado | 13,45 s |
La demo de drones de la propia DiffuSpace tardó 0,97 segundos, en hardware más grande y en un modo sin especificar: no es una carrera en igualdad de condiciones.
Las tarjetas más pequeñas también funcionaron, más despacio. llama.cpp puede dejar parte de los especialistas en la memoria principal del ordenador en lugar de en la tarjeta. Sacando 10 capas de ellos, el modelo entró en 15.456 MiB, un presupuesto de 16 GB, y aun así escribió unos 102 tokens por segundo. Emulamos ese presupuesto en la 4090: es una cifra de memoria, no una promesa de velocidad.
Un punto flojo: Clover siempre piensa antes de responder, y nuestro endpoint todavía no deja pasar el interruptor para desactivarlo (abierto por nuestra parte).
En InferenceKey no cambió nada de código de la plataforma. Fijamos el worker (el pequeño programa de tu máquina con GPU que recibe órdenes de la plataforma) a llama.cpp v0.9.0. Compiló esa versión en 4 min 50 s la primera vez y, a partir de ahí, un endpoint estuvo listo en 11,7 segundos. Desde ese punto es la misma API al estilo de OpenAI que con cualquier otro modelo.
El modelo y los benchmarks son obra de DiffuSpace, el soporte de llama.cpp es de Maphist0 y la rama de SGLang es de Zirui Wu. Lo nuestro: el parche, el despliegue y las mediciones.
A quién le interesa
- Equipos que quieren un modelo abierto para agentes en una sola tarjeta de 24 GB. Merece la pena probarlo. Parchea antes el fichero y compáralo con su base Qwen en tus propias tareas.
- Equipos con una tarjeta de 16 GB. Probablemente sí, con especialistas en la RAM, a más o menos la mitad de velocidad.
- Equipos que quieren la velocidad de difusión del blog. Hoy no en llama.cpp. Sigue la pull request de SGLang o usa el código Python de DiffuSpace en una tarjeta de 80 GB.
- Equipos que eligen modelos por benchmarks. Esas puntuaciones son del fabricante y puede que no se mantengan en el modo de un token cada vez.
El límite honesto: no ejecutamos la base Qwen3.6-35B-A3B en esta tarjeta ni probamos una tarjeta real de 16 GB, así que no podemos decir si Clover en este modo supera a su base.
La prueba completa
El post de Research tiene la escalera de memoria, cada tiempo medido y el ejemplo del SDK. Lee la prueba completa de Clover-35B-A3B en el post de Research.