Nanbeige4.3-33B en una sola tarjeta: 42 tokens/s con 24 GB, y con 16 GB solo funciona el fichero de 3 bits
Un modelo denso de 33B para agentes a 42 tokens/s en una RTX 4090. Con 16 GB, el fichero de 3 bits va a 14 tokens/s; el de 4 bits se arrastra a 1,6.
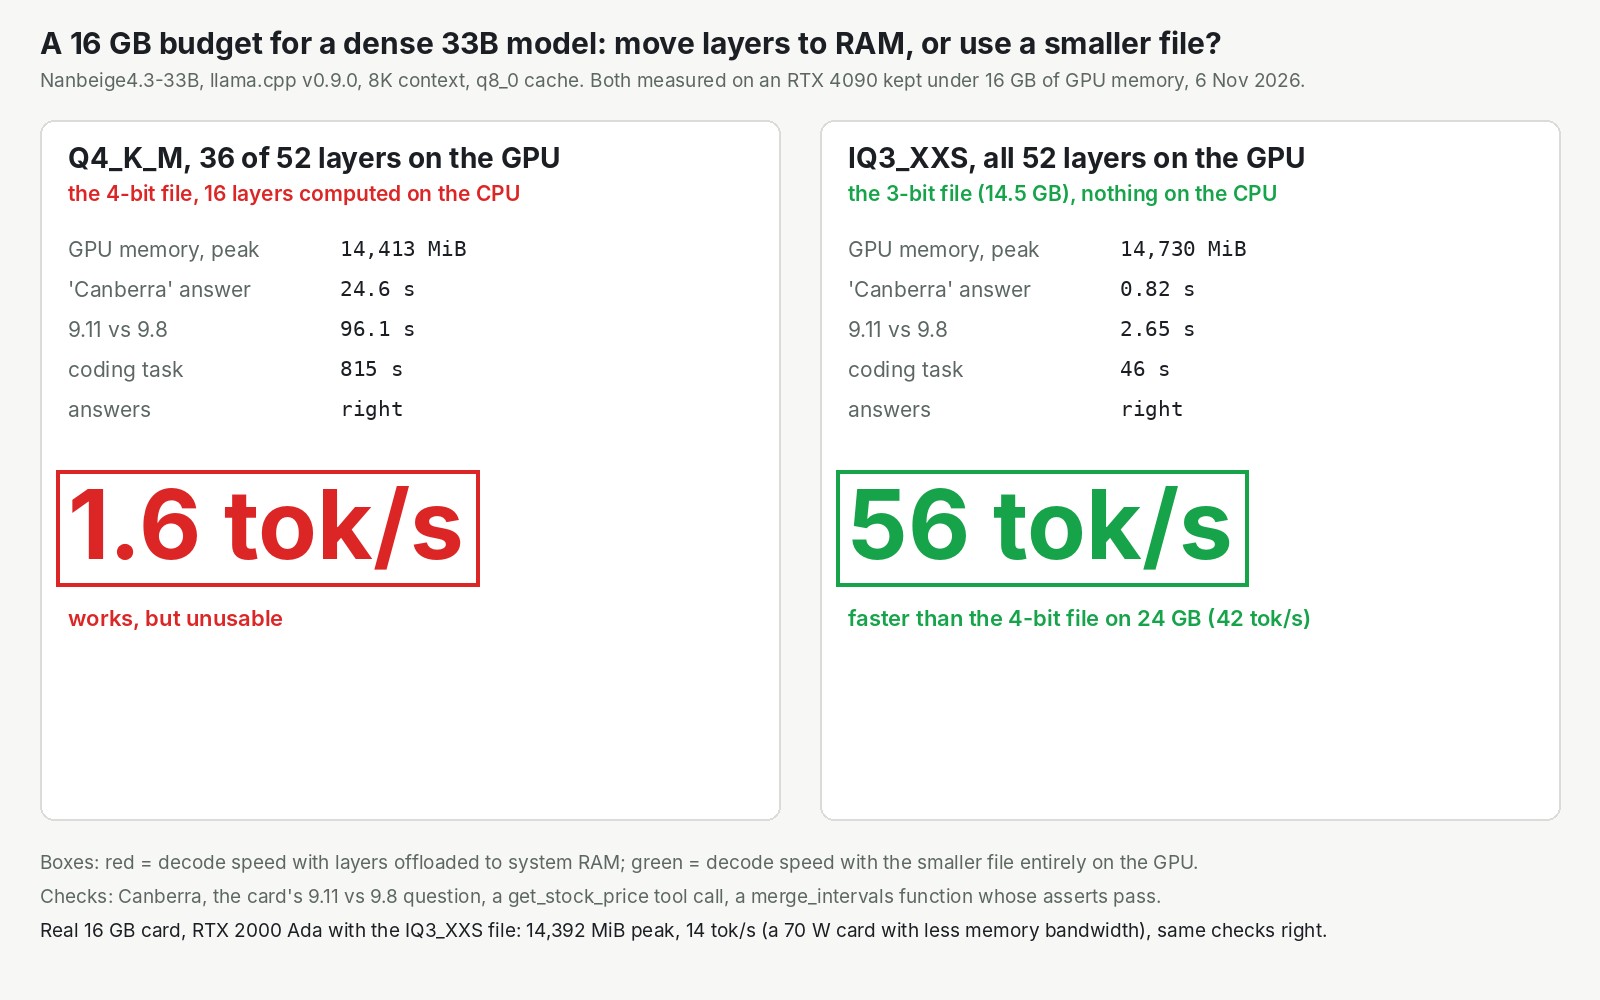
Con un modelo denso, el fichero que cabe en la tarjeta gana al fichero mejor que no cabe. Nanbeige4.3-33B, un nuevo modelo para agentes de programación con licencia Apache-2.0, escribió unos 42 tokens por segundo en una sola RTX 4090 de 24 GB de nuestra nube, con llamadas a herramientas válidas todas las veces. Con un presupuesto de 16 GB, su fichero de 4 bits, con un tercio del modelo fuera de la tarjeta, se arrastró a 1,6 tokens por segundo. El fichero de 3 bits, más pequeño y entero en la tarjeta, pasó todas las comprobaciones, a unos 14 tokens por segundo en una tarjeta de estación de trabajo real de 16 GB. Para un equipo que despliega sus propios modelos: un modelo abierto para agentes en una sola tarjeta que puedes tener en propiedad o alquilar, y una regla clara para elegir el fichero. Pruébalo con 24 GB, o con 16 GB y el fichero de 3 bits. Antes, una pega: con el modo de pensamiento activado, que es lo que viene por defecto, la respuesta final del agente llegó vacía en 2 de 3 ejecuciones.
Un 33B en el que toca la banda entera en cada compás
Los modelos para agentes que probamos antes, como Groot-19B y Clover-35B-A3B, usan solo unos pocos de sus parámetros para cada palabra: una big band en la que solo tocan unos pocos solistas en cada compás. Nanbeige4.3-33B es denso. Sus 33B parámetros trabajan en cada token.
Eso tiene un precio que se puede medir. Para escribir cada palabra, la tarjeta lee el fichero entero del modelo de su propia memoria. Con el fichero de 4 bits, son 20,8 GB por palabra. Un fichero más pequeño significa menos que leer y más palabras por segundo. Lo que se queda fuera de la memoria de la tarjeta se lee mucho más despacio, y la velocidad se hunde.
El modelo se subió a Hugging Face el 24 de octubre, obra del equipo Nanbeige de BOSS Zhipin. Sus autores dicen tener "state-of-the-art agentic performance among open models in the ~30B parameter class". Sin comprimir ocupa 66 GB, y sus propias recetas para servirlo lo reparten entre cuatro GPU. bartowski publicó versiones comprimidas en un solo fichero para llama.cpp, el motor gratuito que usamos.
Los autores lo ponen por delante de Qwen3.8-27B en dos de tres pruebas de programación con agentes, y también publican en la que pierde. Son sus cifras, con el pensamiento al máximo. No las hemos reproducido.
| Prueba (cifras de los autores) | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 |
| DeepSWE | 65,5 | 42,5 |
| SWE-Bench Pro | 60,3 | 61,7 |
Lo que nos dio una sola tarjeta de 24 GB
Con el fichero de 4 bits que recomienda bartowski, el modelo entero entró en la RTX 4090. Escribió entre 42 y 44 tokens por segundo con una sola petición, y el primer token llegó en un cuarto de segundo a medio segundo con prompts cortos.
Nuestras comprobaciones fueron pequeñas: una respuesta de una palabra, la pregunta de si es mayor 9.11 o 9.8 que aparece en la página del modelo, una tarea de programación con sus propios tests y dos llamadas a herramientas. Una llamada a herramienta es el modelo pidiendo a tu código que ejecute una función, aquí una consulta del precio de una acción y otra del tiempo en dos ciudades a la vez. El código pasó sus tests en 24,6 segundos. Todas las llamadas a herramientas llegaron válidas, en el formato estándar de OpenAI.
La misma tarjeta aguantó un prompt de 64K tokens, unas 50.000 palabras, y encontró una palabra secreta escondida en el token 61.428. La escritura bajó a 16 tokens por segundo a medida que se llenaba el prompt.
La regla de los 16 GB: fichero más pequeño, todo en la tarjeta
La tarjeta más pequeña que pasó es una real: una RTX 2000 Ada, una tarjeta de estación de trabajo de 16 GB y 70 vatios, con el fichero de 3 bits de bartowski. Pasó las mismas comprobaciones a más o menos un tercio de la velocidad de la 4090, así que una respuesta de 400 tokens tarda unos 30 segundos en lugar de 10.
Las dos filas de 16 GB de la imagen se ejecutaron en la 4090 completa y su pico quedó por debajo del presupuesto, así que hay que leerlas como cifras de memoria, no como promesas de velocidad. La lección sigue en pie: un tercio de un modelo denso fuera de la tarjeta convirtió un modelo rápido en uno que tardó 815 segundos en una tarea de programación. Bajando más, el fichero de 2 bits entró en menos de 12 GB y acertó con 9.8, pero explicó mal su posición decimal, y eso basta para no acercarlo al código.
El problema de las respuestas vacías
Con el pensamiento activado, algunas respuestas llegan con la respuesta vacía y todo el texto metido en el campo de pensamiento del modelo. Pasó en todas las redacciones de 400 palabras que le pedimos, y en la respuesta final del agente tras los resultados del tiempo en 2 de 3 ejecuciones, una vez en cada tarjeta. Las llamadas a herramientas en sí nunca se vieron afectadas.
Con el pensamiento desactivado en una petición enviada directamente a llama.cpp, la redacción llegó en la respuesta normal. A través de InferenceKey, ese interruptor por petición todavía no pasa: nuestro endpoint lo descarta. Estado: abierto por nuestra parte. Un ajuste del servidor debería desactivar el pensamiento en todas las peticiones, pero no lo hemos probado, y los autores recomiendan mantener el pensamiento activado para agentes.
En InferenceKey, la plataforma no necesitó cambios: un número de versión y un comando de arranque. El despliegue estuvo listo en 303,7 segundos en la 4090, casi todo ese tiempo el worker (el pequeño programa de tu máquina con GPU que recibe órdenes de la plataforma) compilando llama.cpp para esa GPU. En un host de 16 GB con el rendimiento limitado, la misma compilación tardó 19 minutos y 50 segundos.
El modelo y los benchmarks son obra del equipo Nanbeige, los ficheros comprimidos de bartowski y el motor de los mantenedores de llama.cpp. Lo nuestro: el despliegue, las pruebas y el ejemplo del SDK.
A quién le interesa
- Equipos con una tarjeta de 24 GB que quieren un modelo abierto para agentes de programación. Merece la pena probarlo. Contrasta las puntuaciones de los autores con tus propias tareas.
- Equipos con una tarjeta de 16 GB. Usa el fichero de 3 bits entero en la tarjeta, nunca el de 4 bits con un tercio fuera.
- Equipos que ya lo usan como agente. Cuenta con respuestas finales vacías con el pensamiento activado, hasta que ese interruptor pase.
El límite honesto: ejecutamos una petición cada vez con nuestros propios prompts pequeños, llamadas a herramientas sueltas y un solo turno de agente, no un agente trabajando sobre un código real.
La prueba completa
El post de Research tiene la escalera de memoria, cada tiempo medido y el ejemplo del SDK. Lee la prueba completa de Nanbeige4.3-33B en el post de Research.