LFM3-Omni-2B oye, ve y contesta con voz en una tarjeta de 16 GB
El modelo omni de 2B de Liquid AI generó 10 s de respuesta hablada en unos 7 s de GPU, con unos 5 GB de memoria. El servidor rápido aún no habla.
Oír, mirar, pensar y hablar ya caben en unos 5 GB de memoria de GPU. LFM3-Omni-2B, un nuevo modelo abierto de Liquid AI, recibe voz, fotos y vídeo, y responde en texto, con su propia voz o de las dos formas. En una RTX A5000 de 24 GB de nuestra nube, una respuesta hablada de 10 segundos costó unos 7 segundos de GPU. Una tarjeta real de 16 GB, la RTX 2000 Ada, dio los mismos resultados sin ir más lenta. Para un equipo que despliega sus propios modelos, eso significa todas las etapas de un asistente de voz en una sola tarjeta pequeña que puedes tener en propiedad o alquilar. Ya puedes construir sobre él con un backend propio que ejecuta el código del propio modelo. Antes, dos pegas. El servidor de código abierto rápido para él, SGLang, solo escribe texto, y su soporte todavía no está publicado. Y la licencia prohíbe el uso comercial en cuanto tu facturación anual llega a 10 millones de dólares.
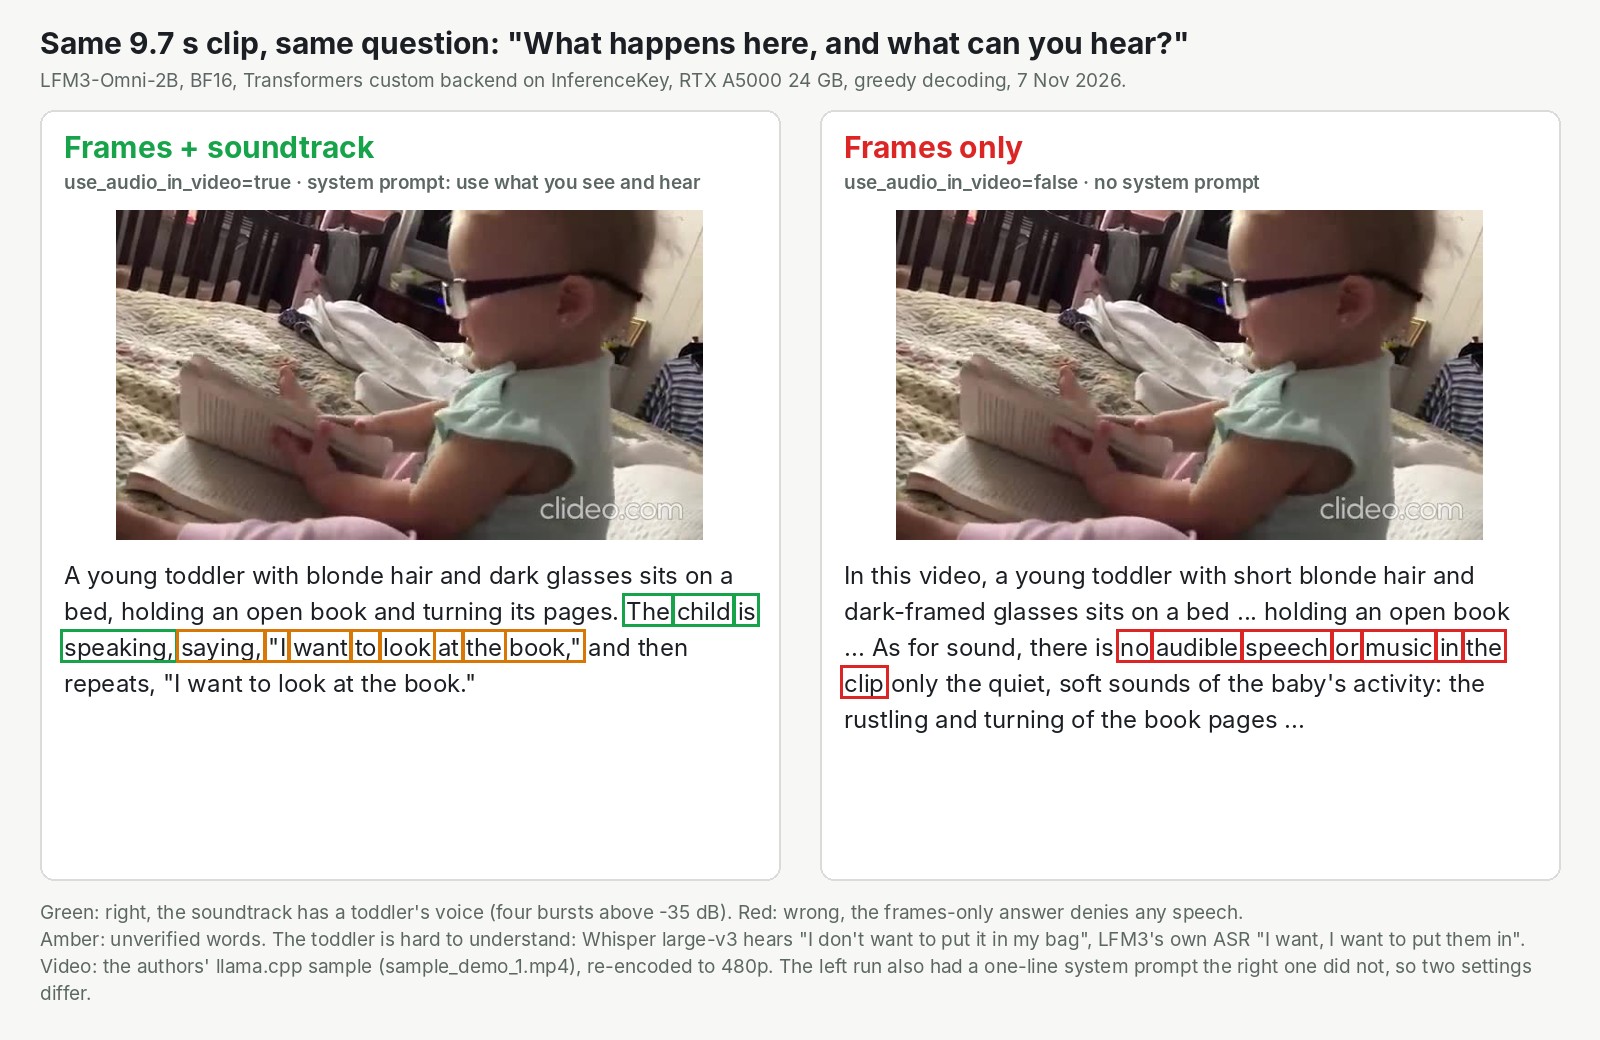
El mismo clip y la misma pregunta escrita. Con la banda sonora, el modelo oye a un niño hablar; solo con los fotogramas, dice que el clip está en silencio. La ejecución con sonido llevaba además una instrucción de una línea para que usara lo que ve y oye, así que cambiaron dos ajustes, no uno.
Cuatro tareas en un solo juego de pesos de 4,5 GB
Un asistente de voz suele ser un relevo de cuatro modelos: uno oye, otro mira, otro piensa y otro habla. La model card de Liquid AI dice que este "replaces a separate ASR model, vision-language model, LLM and TTS model".
Está construido sobre LFM3-1.7B, el nuevo modelo de lenguaje pequeño de Liquid AI, con un lector de imágenes, un lector de sonido y una parte que convierte su salida en audio. Según la lista de Liquid AI, habla 19 combinaciones de idioma y acento; probamos inglés y español. El anuncio de LFM3 tiene fecha del 27 de octubre, y vimos el modelo en el vídeo de noticias de AI Search.
Lo que hizo con él una sola tarjeta pequeña
Ejecutamos el modelo completo, sin comprimir, a través de InferenceKey en dos tarjetas: la A5000 para la prueba principal y la RTX 2000 Ada, una tarjeta de estación de trabajo de 70 vatios, en una máquina recién creada. Cada respuesta hablada tardó menos en generarse que en reproducirse.
| Lo que pedimos | Tiempo de GPU (A5000 / tarjeta de 16 GB) |
|---|---|
| Pregunta hablada sobre la montaña más alta de África, respuesta con voz (unos 10 s de habla) | 7,4 s / 6,6 s |
| Cartel de un concierto más una pregunta hablada sobre cuándo y dónde | 0,84 s / 0,93 s |
| Petición hablada de poner el volumen a 30, con una herramienta de volumen | 0,56 s / 0,45 s |
Lo del cartel salió bien: "The concert starts at 7:30 PM, and it is located at Pier 9 Warehouse, 410 Bay Street." La petición de volumen volvió como set_volume({"volume": 30}), una orden que una aplicación puede ejecutar.
Quien llamaba esperó más que la GPU. Una respuesta de 10 segundos le llegó al cabo de 8 a 10 segundos, porque nuestro montaje envía el audio como un solo fichero al final. Dentro del servidor, el primer trozo de voz estaba listo entre 0,2 y 0,5 segundos después, así que el streaming podría recortar esa espera. No lo construimos ni lo probamos.
En memoria, el modelo necesita unos 5 GB libres para voz, fotos y clips cortos, y unos 6 GB para un vídeo de un minuto. Cuando limitamos su memoria por software en la tarjeta grande, todo pasó con 4,8 GB y el vídeo de 10 segundos se quedó sin memoria con 4,7 GB.
Dónde falla: números y palabras mal pronunciadas
Los datos sencillos salieron bien. Le preguntamos por voz diez veces la altura del Kilimanjaro: acertó los metros nueve veces y falló los pies en la mayoría de las ejecuciones. Un asistente de voz que lee números en alto necesita una comprobación, o una herramienta, para las conversiones.
En el clip del niño, citó que el niño decía "I want to look at the book". No pudimos verificarlo. Whisper, un reconocedor de voz aparte, oyó otra cosa, y lo mismo el propio modelo cuando solo le pedimos que transcribiera. Toma las palabras citadas de un audio poco claro como una suposición.
El servidor rápido escribe cuatro veces más deprisa, y no puede hablar
Este es el muro con el que te toparás primero. La documentación de Liquid AI da un comando de SGLang de una línea, pero la versión publicada de SGLang (0.5.23) no soporta este modelo y se cayó al arrancar en nuestra tarjeta. El arreglo es un cambio propuesto, #46858 de tugot17, todavía abierto el día de la prueba. Compilado a mano, escribió texto unas cuatro veces más deprisa con respuestas idénticas: 158 trozos de palabra por segundo frente a 38 a 40. Solo devuelve texto.
Así que para la voz escribimos un backend propio: un fichero corto de Python que subes a InferenceKey, que instala sus dependencias en tu máquina con GPU y le envía las peticiones. Un solo backend en una sola GPU sirvió voz, fotos, vídeo y órdenes desde una sola dirección. Estuvo listo 46 segundos después de pedirlo en la A5000, y 59,5 segundos en la máquina nueva de 16 GB.
El modelo, sus benchmarks y los clips de ejemplo son obra de Liquid AI; el soporte en SGLang, de tugot17; la relectura independiente de cada grabación, de Whisper. Lo nuestro: el backend, el despliegue en dos tarjetas, las pruebas y el ejemplo del SDK.
A quién le interesa
- Equipos que construyen un asistente de voz en su propio hardware. Merece la pena construir sobre él, con una comprobación de los números que lee en alto. Tal como lo probamos, quien llama espera a la respuesta entera.
- Equipos que necesitan texto rápido para mucho tráfico. Todavía no. Espera a la versión publicada de SGLang.
- Equipos con una tarjeta de menos de 16 GB. Los límites de memoria dicen que bastan unos 5 GB libres, pero no probamos ninguna tarjeta real tan pequeña.
- Empresas con 10 millones de dólares o más de facturación anual. Habla con Liquid AI sobre otras condiciones antes del primer despliegue.
El límite honesto: una petición cada vez, con nuestras propias entradas cortas, sin ninguna persona valorando la voz y sin compararlo con una cadena de cuatro modelos pequeños separados en la misma tarjeta.
La prueba completa
El post de Research tiene cada tiempo medido, la escalera de memoria, la propia voz del modelo y el ejemplo del SDK. Lee la prueba completa de LFM3-Omni-2B en el post de Research.